

Android には、効率的な SQL データベースである SQLite の組み込みサポートが用意されています。データの増加に伴ってアプリの速度と予測可能性を維持するには、以下のベスト プラクティスに沿ってアプリのパフォーマンスを最適化してください。これらのベスト プラクティスを使用すると、再現とトラブルシューティングが難しいパフォーマンスの問題が発生する可能性も低くなります。
パフォーマンスを改善するには、次のパフォーマンス原則に従います。
読み取り対象の行数と列数を減らす: 必要なデータのみを取得するようにクエリを最適化します。データ取得量が過剰になるとパフォーマンスに影響する可能性があるため、データベースから読み取られるデータの量は最小限に抑えてください。
SQLite エンジンに処理を push する: SQL クエリ内で計算、フィルタリング、並べ替えを行います。SQLite のクエリエンジンを使用すると、パフォーマンスが大幅に向上する場合があります。
データベース スキーマを変更する: SQLite で効率的なクエリプランとデータ表現を作成できるようにデータベース スキーマを設計します。テーブルを適切にインデックス登録し、テーブル構造を最適化してパフォーマンスを改善します。
また、利用可能なトラブルシューティング ツールを使用して、最適化が必要な領域を特定できるように SQLite データベースのパフォーマンスを測定することもできます。
Jetpack Room ライブラリを使用することをおすすめします。
パフォーマンスを重視してデータベースを構成する
このセクションの手順に沿って、SQLite でパフォーマンスを最適化するためにデータベースを構成します。
write-ahead log 書き込みを有効にする
SQLite は、ログに追加することによってミューテーションを実装し、場合によってはデータベースに圧縮します。これは、write-ahead log 書き込み(WAL)と呼ばれます。
ATTACH DATABASE を使用している場合を除き、WAL を有効にします。
PRAGMA journal_mode=WAL を自分で実行するのではなく、フレームワークを介して WAL を有効にします。Room では、低 RAM デバイス以外のデバイスで WAL がデフォルトで有効になります。Room を使用しない場合は、次のいずれかを使用します。
enableWriteAheadLoggingメソッドENABLE_WRITE_AHEAD_LOGGINGオープンフラグSQLiteOpenHelperのsetWriteAheadLoggingEnabledメソッド
フレームワークは、データベースが WAL を使用していることを認識すると、読み取りを書き込みと同時に実行できるように接続プールを開き、次のセクションで説明する WAL 同期モードを適用します。PRAGMA journal_mode=WAL を自分で実行した場合でも、フレームワークはデータベースをロールバック ジャーナル データベースとして扱います。単一の接続を使用し、commit はデフォルトの FULL 同期モードを維持します。
同期モードを緩和する
SQLite には、同期モードを制御するオプションがあります。FULL モードでは、データが確実にディスクに届くようにすべての commit で fsync が発行されます。これにより、データの耐久性は向上しますが、commit は低速になります。WAL を使用すると、NORMAL モードは commit ごとに同期せず、データベースを破損から保護します。
フレームワークを介して WAL を有効にすると、Android はデバイスのデフォルトの WAL 同期モードを適用します。これは、Android 9 以降の AOSP では NORMAL です。デバイス メーカーはこのデフォルトを変更できます。WAL を使用しないデータベースはデフォルトで FULL になります。データベースで NORMAL が使用されるようにするには、データベースを開くときに設定します。
// When opening the database
val params = SQLiteDatabase.OpenParams.Builder()
    .addOpenFlags(SQLiteDatabase.ENABLE_WRITE_AHEAD_LOGGING)
    // SYNC_MODE_NORMAL is available in API level 33 and higher.
    // On API levels 28 to 32, pass "NORMAL" instead.
    .setSynchronousMode(SQLiteDatabase.SYNC_MODE_NORMAL)
    .build()
// With SQLiteOpenHelper, call setOpenParams(params) in your constructor.

// Or: after having opened the database
db.execSQL("PRAGMA synchronous = NORMAL")
この設定では、データがディスクに保存される前に commit が返される場合があります。停電やカーネル パニックなどが原因で、デバイスがシャットダウンすると、commit されたデータが失われる可能性があります。ただし、ロギングが原因でデータベースが破損することはありません。
アプリのクラッシュのみが発生した状態では、データはディスクに届きます。ほとんどのアプリでは、この設定により、機材に費用を投じることなくパフォーマンスを改善できます。
接続とメモリを管理する
開いているデータベース接続はすべて、SQLite メモリ(ページ キャッシュ、ルックアサイド アロケータ、コンパイル済みステートメントのキャッシュ)を保持します。データベース ファイル ページもカーネル ページ キャッシュに保持されます。このセクションの方法に沿って、クエリの速度を低下させることなく、このメモリを管理してください。
各データベースを 1 回開く
プロセス全体でデータベース ファイルごとに 1 つの SQLiteOpenHelper または RoomDatabase インスタンスを使用します(シングルトンにするなど)。各インスタンスには独自の接続プール、ページ キャッシュ、ステートメント キャッシュがあり、同じファイルを開く 2 つのインスタンスはこれらを共有できません。あるベンチマークでは、同じファイルを開く 2 つのヘルパーを 1 つに統合したところ、SQLite ページ キャッシュ メモリがほぼ半分になり、p95 クエリ レイテンシが半分以下になりました。
重複するインスタンスを見つけるには、dumpsys dbinfo で、複数の Connection pool for 見出しの下に同じデータベース パスがあるかどうかを確認します。
スキーマの変更をオープン コールバックから除外する
SQLiteOpenHelper の onOpen コールバックは、データベースが開くたびに実行されます。RoomDatabase.Callback の onOpen コールバックも同様です。CREATE TABLE IF NOT EXISTS や CREATE INDEX IF NOT EXISTS などのステートメントを onCreate と onUpgrade、または Room の移行に配置します。onOpen で setVersion を呼び出さないでください。SQLiteOpenHelper はすでに onCreate と onUpgrade の後にバージョンを設定しているためです。スキーマがすでに存在する場合でも、これらのステートメントは開くたびに実行され、setVersion はデータベース ファイルに書き込みます。
準備済みステートメント キャッシュのサイズを設定する
Android は、接続ごとにコンパイルされたステートメントをキャッシュに保存します。キャッシュにはデフォルトで 25 個のステートメントが保持されます。setMaxSqlCacheSize を使用すると、MAX_SQL_CACHE_SIZE(100)まで増やすことができます。データベースがホットパスで 25 を超える個別のステートメントを実行すると、キャッシュがスラッシングされ、SQLite は同じステートメントを何度もコンパイルします。
まず、クエリをパラメータ化します。すべての文字列が新しいステートメントであるため、文字列連結で構築された SQL にはキャッシュ サイズが役立ちません。次に、dumpsys meminfo の POOL STATS でステートメント キャッシュのキャッシュ ヒットとミスを確認します。たとえば、そのセクションのサンプル出力の phenotype.db データベースには、147,921 件のヒットと 89,616 件のミスがあり、ミス率は 38% です。このようなデータベースでキャッシュ サイズを増やすと、ミスをほぼすべて排除できます。キャッシュに保存された各ステートメントは、数キロバイトのメモリを使用します。
キャッシュ サイズを増やすには、SQLiteOpenHelper サブクラスで onConfigure をオーバーライドします。
override fun onConfigure(db: SQLiteDatabase) {
    db.setMaxSqlCacheSize(SQLiteDatabase.MAX_SQL_CACHE_SIZE)
}
Room を使用する場合は、RoomDatabase.Callback の onOpen コールバックで SupportSQLiteDatabase の同じメソッドを呼び出します。
アイドル状態のデータベースを閉じ、ビジー状態のデータベースを開いたままにする
開いているデータベースは、アイドル状態でも接続、キャッシュ、ファイル記述子を保持します。あるベンチマークでは、WAL モードで開いたままのアイドル状態の Room データベースが、約 678 KB の SQLite ページ キャッシュ メモリと 5 つのファイル記述子を保持していました。データベースをたまにしか使用しない場合(1 日 1 回の同期時など)は、使用後にデータベースを閉じます。
アイドル状態のデータベースを安全に閉じるには、次のガイドラインに沿って操作します。
- Room では、試験運用版 API である
setAutoCloseTimeoutを使用して、アイドル状態のデータベースを閉じることができます。Room は、次のアクセス時にデータベースを再度開き、onOpenコールバックを再度実行するため、接続構成をそこに配置します。 SQLiteOpenHelperとSQLiteDatabase.OpenParams.BuilderのsetIdleConnectionTimeoutメソッドは使用しないでください。これらは、PRAGMAステートメントで適用した設定を復元せずに接続を閉じるため、API レベル 29 で非推奨になりました。- 数秒ごとにクエリを実行するデータベースは閉じないでください。タイムアウトがクエリ間のギャップよりも短いと、データベースが繰り返し閉じられ、再度開かれます。これにより、ページ キャッシュとステートメント キャッシュが毎回破棄され、次のクエリが遅くなります。
SQLite メモリを考慮する
SQLite のメモリは特定が困難な場合があります。SQLite ページ キャッシュとステートメント キャッシュは、ネイティブ ヒープ割り当てです。しかし、Android では SQLite のメモリマップド I/O がデフォルトで有効になっていないため、SQLite は通常のファイル読み取りでデータベース ファイルを読み取り、カーネルがキャッシュするファイルの内容はマップされていないファイルページになります。dumpsys meminfo のアプリの PSS にはカウントされません。cgroup v2 メモリ アカウンティングを使用するデバイスでは、カーネルは引き続きこれらのページをアプリのメモリ cgroup に課金します。この隠れたフットプリントを減らすには、インデックスを使用して読み取るページ数を減らし、必要な行と列のみを読み取ります。不要なデータベースを閉じると、SQLite キャッシュも解放されます。
効率的なテーブル スキーマを定義する
パフォーマンスを最適化し、データの消費を最小限に抑えるには、効率的なテーブル スキーマを定義します。SQLite を使用すると、効率的なクエリプランとデータが作成され、データをすばやく取得できます。このセクションでは、テーブル スキーマの作成に関するベスト プラクティスについて説明します。
INTEGER PRIMARY KEY について検討する
この例では、次のようにテーブルを定義してデータを入力します。
CREATE TABLE Customers(
  id INTEGER,
  name TEXT,
  city TEXT
);
INSERT INTO Customers Values(456, 'John Lennon', 'Liverpool, England');
INSERT INTO Customers Values(123, 'Michael Jackson', 'Gary, IN');
INSERT INTO Customers Values(789, 'Dolly Parton', 'Sevier County, TN');
テーブル出力は次のとおりです。
| rowid | id | name | city |
|---|---|---|---|
| 1 | 456 | ジョン・レノン | リバプール(イギリス) |
| 2 | 123 | マイケル・ジャクソン | インディアナ州ゲーリー |
| 3 | 789 | ドリー パートン | テネシー州セビア郡 |
rowid 列は広告掲載オーダーを保持するインデックスです。rowid でフィルタリングされるクエリは高速 B ツリー検索として実装されますが、id でフィルタリングされるクエリは低速なテーブル スキャンです。
id によるルックアップを行う場合は、rowid 列の保存を回避することでストレージ内のデータ量が削減され、データベース全体で高速化を実現できます。
CREATE TABLE Customers(
  id INTEGER PRIMARY KEY,
  name TEXT,
  city TEXT
);
この結果、テーブルは次のようになります。
| id | name | city |
|---|---|---|
| 123 | マイケル・ジャクソン | インディアナ州ゲーリー |
| 456 | ジョン・レノン | リバプール(イギリス) |
| 789 | ドリー パートン | テネシー州セビア郡 |
rowid 列を保存する必要はないため、id クエリは高速です。テーブルは広告掲載オーダーではなく id に基づいて並べ替えられる状態になっている点に留意してください。
インデックスによりクエリを高速化する
SQLite はインデックスを使用してクエリを高速化します。テーブルにインデックスがある場合に、列のフィルタリング(WHERE)、並べ替え(ORDER BY)、または集計(GROUP BY)を行うと、クエリが高速化されます。
前の例では、city でフィルタするには、テーブル全体をスキャンする必要があります。
SELECT id, name
WHERE city = 'London, England';
多くの都市に関するクエリがあるアプリの場合は、インデックスでそれらのクエリを高速化できます。
CREATE INDEX city_index ON Customers(city);
インデックスは、追加のテーブルとして実装され、インデックス列で並べ替えて rowid にマッピングされます。
| city | rowid |
|---|---|
| インディアナ州ゲーリー | 2 |
| リバプール(イギリス) | 1 |
| テネシー州セビア郡 | 3 |
city 列が元のテーブルとインデックスの両方に存在するようになったため、ストレージ費用が 2 倍になりました。インデックスを使用しているため、ストレージを追加すれば、クエリを高速化できるというメリットが得られます。ただし、クエリ パフォーマンスの改善につながらないストレージ費用の支払いが発生しないように、使用していないインデックスは保持しないでください。
複数列インデックスを作成する
クエリで複数の列を組み合わせる場合は、複数列インデックスを作成してクエリを十分に高速化できます。外側の列でインデックスを使用して、内部検索をリニアスキャンとして行うこともできます。
たとえば、次のクエリがあるとします。
SELECT id, name
WHERE city = 'London, England'
ORDER BY city, name
クエリで指定されているのと同じ順序で、複数列インデックスを使用してクエリを高速化できます。
CREATE INDEX city_name_index ON Customers(city, name);
ただし、city にのみインデックスがある場合は、外部の順序付けは高速化されますが、内部の順序付けにはリニアスキャンが必要です。
プレフィックスによる問い合わせにも対応しています。たとえば、ON Customers (city, name) インデックスは city によってフィルタリング、並べ替え、グループ化を高速化することもできます。これは、複数列インデックスのインデックス テーブルは、指定されたインデックスによって指定された順序で並べ替えられるためです。
WITHOUT ROWID について検討する
デフォルトでは、SQLite はテーブルの rowid 列を作成します。ここで、rowid は暗黙的な INTEGER PRIMARY KEY AUTOINCREMENT です。すでに INTEGER PRIMARY KEY という列がある場合、この列は rowid のエイリアスになります。
INTEGER 以外の主キーまたは列の複合を持つテーブルの場合は、WITHOUT ROWID を検討してください。
サイズの小さなデータを BLOB として保存し、サイズの大きなデータをファイルとして保存する
連絡先の画像や写真などのサムネイルにサイズの大きなデータを関連付ける場合は、対象のデータを BLOB 列またはファイルに保存し、パスを列に保存します。
ファイルは通常 4 KB 単位で切り上げられます。非常にサイズの小さなファイルでは、丸め誤差が大きい場合は、BLOB としてデータベースに保存することで効率が改善されます。SQLite はファイル システム呼び出しを最小限に抑え、基盤となるファイル システムよりも高速になる場合があります。
クエリのパフォーマンスを向上させる
応答時間を最小限に抑え、処理効率を最大化することで、SQLite のクエリ パフォーマンスを向上させる際のおすすめの方法を以下に示します。
必要な行のみを読み取る
フィルタを使用すると、期間、場所、名前などの特定の条件を指定して結果を絞り込めます。上限を使用して、表示される結果の数を制御できます。
db.rawQuery("""
    SELECT name
    FROM Customers
    LIMIT 10;
    """.trimIndent(),
    null
).use { cursor ->
    while (cursor.moveToNext()) {
        // Process cursor data
    }
}
必要な列のみを読み取る
不要な列を選択すると、クエリの処理速度が低下し、リソースが浪費される可能性があるため回避する必要があります。代わりに、使用されている列のみを選択してください。
次の例では、id、name、phone を選択します。
// This is not the most efficient way of doing this.
// See the following example for a better approach.

db.rawQuery(
    """
    SELECT id, name, phone
    FROM customers;
    """.trimIndent(),
    null
).use { cursor ->
    while (cursor.moveToNext()) {
        val name = cursor.getString(1)
        // Further processing
    }
}
必要であるのは name 列のみです。
db.rawQuery("""
    SELECT name
    FROM Customers;
    """.trimIndent(),
    null
).use { cursor ->
    while (cursor.moveToNext()) {
        val name = cursor.getString(0)
        // Further processing
    }
}
クエリをパラメータ化する
クエリ文字列には、次のように、ランタイム時にのみ認識されるパラメータが含まれている場合があります。
fun getNameById(id: Long): String?
    db.rawQuery(
        "SELECT name FROM customers WHERE id=$id", null
    ).use { cursor ->
        return if (cursor.moveToFirst()) {
            cursor.getString(0)
        } else {
            null
        }
    }
}
上記のコードでは、すべてのクエリが異なる文字列を構築するため、ステートメント キャッシュのメリットを享受できません。各呼び出しでは、実行前に SQLite でコンパイルする必要があります。代わりに、id 引数をパラメータに置き換えて、値を selectionArgs にバインドできます。
fun getNameById(id: Long): String? {
    db.rawQuery(
        """
          SELECT name
          FROM customers
          WHERE id=?
        """.trimIndent(), arrayOf(id.toString())
    ).use { cursor ->
        return if (cursor.moveToFirst()) {
            cursor.getString(0)
        } else {
            null
        }
    }
}
これで、クエリを 1 回コンパイルしてキャッシュに保存できるようになりました。コンパイルされたクエリは、getNameById(long) の異なる呼び出し間で再利用されます。
コードではなく SQL で反復処理する
SQL クエリを反復処理して個々の結果を返すプログラム ループではなく、ターゲットとなるすべての結果を返す単一のクエリを使用します。プログラムによるループは、単一の SQL クエリよりも約 1,000 倍遅くなります。
一意の値に DISTINCT を使用する
DISTINCT キーワードを使用すると、処理する必要のあるデータ量が削減され、クエリのパフォーマンスを向上させることができます。たとえば、列から一意の値のみを返す場合は、DISTINCT を使用します。
db.rawQuery("""
    SELECT DISTINCT name
    FROM Customers;
    """.trimIndent(),
    null
).use { cursor ->
    while (cursor.moveToNext()) {
        // Only iterate over distinct names in Kotlin
        // Process distinct name
    }
}
可能な限り集計関数を使用する
行データのない集計結果には、集計関数を使用します。たとえば次のコードでは、一致する行が 1 つ以上あるかどうかを確認します。
// This is not the most efficient way of doing this.
// See the following example for a better approach.

db.rawQuery("""
    SELECT id, name
    FROM Customers
    WHERE city = 'Paris';
    """.trimIndent(),
    null
).use { cursor ->
    if (cursor.moveToFirst()) {
        // At least one customer from Paris
        // Handle found
    } else {
        // No customers from Paris
        // Handle not found
}
最初の行のみを取得するには、EXISTS() を使用して、一致する行が存在しない場合は 0 を返し、1 つ以上の行が一致する場合は 1 を返すようにできます。
db.rawQuery("""
    SELECT EXISTS (
        SELECT null
        FROM Customers
        WHERE city = 'Paris';
    );
    """.trimIndent(),
    null
).use { cursor ->
    if (cursor.moveToFirst() && cursor.getInt(0) == 1) {
        // At least one customer from Paris
        // Handle found
    } else {
        // No customers from Paris
        // Handle not found
    }
}
アプリコードで SQLite 集計関数を使用します。
COUNT: 列に含まれる行数をカウントします。SUM: すべての数値を列に追加します。MINまたはMAX: 最小値または最大値を指定します。数値列、DATE型、テキスト型で機能します。AVG: 平均数値を見つけます。GROUP_CONCAT: 文字列を必要に応じて区切り文字を使用して連結します。
Cursor.getCount() ではなく COUNT() を使用する
次の例では、Cursor.getCount() 関数がデータベースからすべての行を読み取り、すべての行値を返します。
// This is not the most efficient way of doing this.
// See the following example for a better approach.

db.rawQuery("""
    SELECT id
    FROM Customers;
    """.trimIndent(),
    null
).use { cursor ->
    val count = cursor.getCount()
    // Use count
}
COUNT() を使用すると、データベースはカウントのみを返します。
db.rawQuery("""
    SELECT COUNT(*)
    FROM Customers;
    """.trimIndent(),
    null
).use { cursor ->
    cursor.moveToFirst()
    val count = cursor.getInt(0)
    // Use count
}
コードではなくクエリをネストする
SQL はコンポーザブルであり、サブクエリ、結合、外部キー制約をサポートしています。アプリコードを使用せずに、あるクエリの結果を別のクエリで使用できます。これにより、SQLite からデータをコピーすることが必要な場合が少なくなり、データベース エンジンでクエリを最適化できます。
次の例では、顧客が最も多い都市を調べるクエリを実行し、結果を別のクエリで使用して、その都市のすべての顧客を検索できます。
// This is not the most efficient way of doing this.
// See the following example for a better approach.

db.rawQuery("""
    SELECT city
    FROM Customers
    GROUP BY city
    ORDER BY COUNT(*) DESC
    LIMIT 1;
    """.trimIndent(),
    null
).use { cursor ->
    if (cursor.moveToFirst()) {
        val topCity = cursor.getString(0)
        db.rawQuery("""
            SELECT name, city
            FROM Customers
            WHERE city = ?;
        """.trimIndent(),
        arrayOf(topCity)).use { innerCursor ->
            while (innerCursor.moveToNext()) {
                // Process inner cursor data
            }
        }
    }
}
上に示した例の半分の時間で結果を取得するには、ネストされたステートメントで単一の SQL クエリを使用します。
db.rawQuery("""
    SELECT name, city
    FROM Customers
    WHERE city IN (
        SELECT city
        FROM Customers
        GROUP BY city
        ORDER BY COUNT (*) DESC
        LIMIT 1;
    );
    """.trimIndent(),
    null
).use { cursor ->
    if (cursor.moveToNext()) {
        // Process cursor data
    }
}
SQL で一意性を確認する
テーブル内で特定の列の値が一意でない限り、行を挿入する必要がない場合は、該当する一意性を列の制約として適用した方が効率的です。
次の例では、挿入される行を検証するために 1 つのクエリを実行し、実際に挿入するために別のクエリを実行します。
// This is not the most efficient way of doing this.
// See the following example for a better approach.

db.rawQuery(
    """
    SELECT EXISTS (
        SELECT null
        FROM customers
        WHERE username = ?
    );
    """.trimIndent(),
    arrayOf(customer.username)
).use { cursor ->
    if (cursor.moveToFirst() && cursor.getInt(0) == 1) {
        throw AddCustomerException(customer)
    }
}
db.execSQL(
    "INSERT INTO customers VALUES (?, ?, ?)",
    arrayOf(
        customer.id.toString(),
        customer.name,
        customer.username
    )
)
Kotlin の一意の制約を確認する代わりに、テーブルを定義するときに SQL で確認できます。
CREATE TABLE Customers(
  id INTEGER PRIMARY KEY,
  name TEXT,
  username TEXT UNIQUE
);
SQLite は以下に示すのと同じことを行います。
CREATE TABLE Customers(...);
CREATE UNIQUE INDEX CustomersUsername ON Customers(username);
これで、行を挿入して、SQLite で制約を確認できるようになりました。
try {
    db.execSQL(
        "INSERT INTO Customers VALUES (?, ?, ?)",
        arrayOf(customer.id.toString(), customer.name, customer.username)
    )
} catch(e: SQLiteConstraintException) {
    throw AddCustomerException(customer, e)
}
SQLite は、複数の列を持つ一意のインデックスをサポートしています。
CREATE TABLE table(...);
CREATE UNIQUE INDEX unique_table ON table(column1, column2, ...);
SQLite は制約を Kotlin コードよりも高速かつ、より少ないオーバーヘッドで検証します。アプリのコードではなく SQLite を使用することをおすすめします。
1 つのトランザクションで複数の挿入をバッチ処理する
1 つのトランザクションで複数のオペレーションが commit されるため、効率だけでなく正確性も向上します。データの整合性を向上させ、パフォーマンスを高速化するには、一括挿入を使用します。
db.beginTransaction()
try {
    customers.forEach { customer ->
        db.execSQL(
            "INSERT INTO Customers VALUES (?, ?, ?)",
            arrayOf(customer.id.toString(), customer.name, "customerValue")
        )
    }
    db.setTransactionSuccessful()
} finally {
    db.endTransaction()
}
明示的なトランザクションの外部では、各書き込みは独自の暗黙的なトランザクションで実行され、FULL 同期モードの fsync を含む commit の全費用を支払います。バッチ処理では、このコストが 1 回で済むため、バッチ書き込みの速度が 1 桁以上向上します。
トラブルシューティング ツールを使用する
SQLite には、パフォーマンス測定に活用できる次のトラブルシューティング ツールが用意されています。
SQLite のインタラクティブなプロンプトを使用する
マシンで SQLite を実行して、クエリを実行して学習します。Android プラットフォームのバージョンによって、使用される SQLite のリビジョンが異なります。Android 搭載デバイスと同じエンジンを使用するには、adb shell を使用して、ターゲット デバイスで sqlite3 を実行します。
SQLite でクエリを計測するように指示できます。
sqlite> .timer on
sqlite> SELECT ...
Run Time: real ... user ... sys ...
EXPLAIN QUERY PLAN
SQLite に、クエリに応答する方法について指示するには、EXPLAIN QUERY PLAN を使用します。
sqlite> EXPLAIN QUERY PLAN
SELECT id, name
FROM Customers
WHERE city = 'Paris';
QUERY PLAN
`--SCAN Customers
前述の例では、パリのすべての顧客を見つけるために、インデックスを使用しないフルテーブル スキャンが必要です。これを線形複雑性といいます。SQLite はすべての行を読み取り、パリの顧客に一致する行のみを保持する必要があります。これを解決するには、インデックスを追加します。
sqlite> CREATE INDEX Idx1 ON Customers(city);
sqlite> EXPLAIN QUERY PLAN
SELECT id, name
FROM Customers
WHERE city = 'Paris';
QUERY PLAN
`--SEARCH test USING INDEX Idx1 (city=?
インタラクティブ シェルを使用している場合は、常にクエリプランについて説明するように SQLite に指示できます。
sqlite> .eqp on
詳細については、クエリ プランニングをご覧ください。
SQLite Analyzer
SQLite には、パフォーマンスのトラブルシューティングに使用できる追加情報をダンプする sqlite3_analyzer コマンドライン インターフェース(CLI)が用意されています。インストールするには、SQLite のダウンロード ページにアクセスします。
adb pull を使用すると、分析用にデータベース ファイルをターゲット デバイスからワークステーションにダウンロードできます。
adb pull /data/data/<app_package_name>/databases/<db_name>.db
SQLite ブラウザ
SQLite ダウンロード ページで、GUI ツールである SQLite ブラウザをインストールすることもできます。
Android のロギング
Android は、SQLite クエリを計測し、ログに記録します。
# Enable query time logging
$ adb shell setprop log.tag.SQLiteTime VERBOSE
# Disable query time logging
$ adb shell setprop log.tag.SQLiteTime ERROR
Android 13 以降では、遅いオペレーションのみをログに記録することもできます。しきい値をミリ秒単位で設定し、アプリを再起動してログタグを読み取ります。
$ adb shell setprop log.tag.SQLiteSlowQueries VERBOSE
$ adb shell setprop db.log.slow_query_threshold 100
$ adb shell am force-stop <package-name>
低速なオペレーションは、SQLiteConnection タグの下に、所要時間、SQL、データベース パスとともに logcat に表示されます。1 つのアプリのしきい値を設定するには、db.log.slow_query_threshold.<uid> を使用します。ここで、<uid> はアプリの UID です。
Perfetto トレース
Perfetto を構成するときに、database atrace カテゴリを追加して、トレースに SQLite オペレーションを含めます。SQL の実行中に各スレッドが何を行っているかを確認するには、スケジューラ イベントも追加します。
data_sources {
  config {
    name: "linux.ftrace"
    ftrace_config {
      ftrace_events: "sched/sched_switch"
      ftrace_events: "sched/sched_waking"
      ftrace_events: "sched/sched_blocked_reason"
      atrace_categories: "database"
    }
  }
}
Android は、各データベース オペレーションを、オペレーションとその SQL にちなんで名付けられたスライス(executeForCursorWindow SELECT * FROM message WHERE body LIKE ? など)としてトレースします。SQL は ? プレースホルダを保持し、256 文字に切り捨てられます。バインド引数は含まれません。オペレーションには、open、close、prepare、execute、executeFor バリアントがあります。prepare スライスは、ステートメント キャッシュがミスしたことを意味するものではありません。
トラックのレイアウトは Android のバージョンによって異なります。
- Android 17 以降では、各接続に
SQLiteConnection-という名前のアプリプロセスに非同期トラックがあり、その後に接続番号が続きます。トランザクションはTRANSACTION-EXCLUSIVE、TRANSACTION-IMMEDIATE、TRANSACTION-DEFERREDスライスとして表示され、その中で実行されたステートメントがネストされます。オペレーションを実行するスレッドは、すべてのトランザクションとトランザクション外のすべてのステートメントについて、スレッドトラックでSTART-とEND-のインスタント イベントも取得します。これらのイベントの名前は、接続トラック名(-SQLiteConnection-0など)で終わります。 - Android 16 以前では、個別の SQL ステートメントごとにアプリプロセスに独自の非同期トラックがあり、トランザクションはトレースされません。
接続番号はデータベースごとに 0 から再開されるため、プロセス内のすべてのデータベースのプライマリ接続は SQLiteConnection-0 トラックを共有します。アプリで複数のデータベースを同時に使用する場合は、スレッドトラックの START- イベントと END- イベントを使用して、所要時間を測定します。
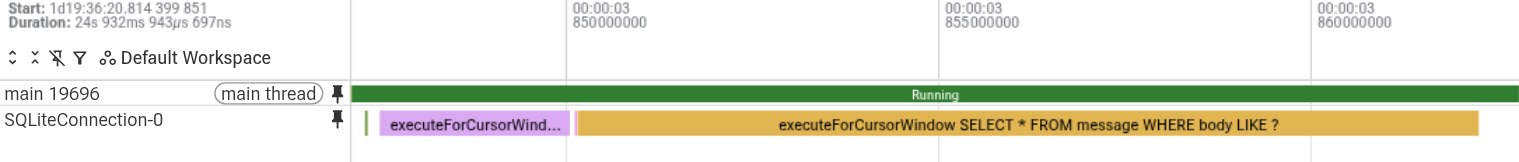
図 1. Android 17 のメインスレッドでのテーブルのフルスキャン。
これらのスライスは、Perfetto UI の PerfettoSQL または trace_processor で分析できます。次のクエリは、各プロセスで最も頻繁に実行される SQLite オペレーションを検索します。このクエリは、すべての Android バージョンで機能します。
INCLUDE PERFETTO MODULE slices.with_context;

SELECT process_name, name AS operation, COUNT(*) AS count
FROM process_slice
WHERE name GLOB 'open *' OR name GLOB 'close *'
  OR name GLOB 'prepare *' OR name GLOB 'execute*'
  OR name GLOB 'TRANSACTION-*'
GROUP BY process_name, name
ORDER BY count DESC
LIMIT 10;
次のクエリは、Android 17 以降のメインスレッドで 1 ミリ秒以上かかった SQLite オペレーションを一覧表示します。
INCLUDE PERFETTO MODULE slices.with_context;

WITH marks AS (
  SELECT process_name, utid, is_main_thread, ts, name,
    LEAD(ts) OVER (PARTITION BY utid ORDER BY ts) AS end_ts,
    LEAD(name) OVER (PARTITION BY utid ORDER BY ts) AS end_name
  FROM thread_slice
  WHERE name GLOB 'START-*' OR name GLOB 'END-*'
)
SELECT process_name, ts, ROUND((end_ts - ts) / 1e6, 1) AS dur_ms,
  substr(name, 7) AS operation
FROM marks
WHERE name GLOB 'START-*'
  AND end_name = 'END-' || substr(name, 7)
  AND is_main_thread
  AND end_ts - ts > 1e6
ORDER BY dur_ms DESC
LIMIT 10;
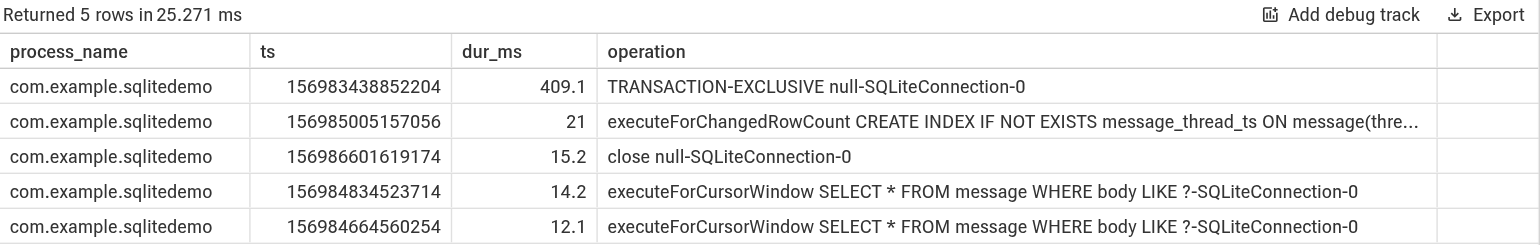
図 2. メインスレッドで 1 ミリ秒を超える SQLite オペレーション。
次のクエリは、Android 17 以降で、明示的なトランザクションの外部に書き込みを行うスレッドを検索します。この場合、すべての書き込みが独自の commit の費用を支払います。
INCLUDE PERFETTO MODULE slices.with_context;

WITH ops AS (
  SELECT process_name, thread_name, utid, name,
    upper(ltrim(substr(name, instr(name, ' ') + 1))) AS sql
  FROM thread_slice
  WHERE name GLOB 'START-*'
)
SELECT process_name, thread_name,
  SUM(name GLOB 'START-TRANSACTION-*') AS transactions,
  SUM(name GLOB 'START-execute*' AND (sql GLOB 'INSERT *'
    OR sql GLOB 'UPDATE *' OR sql GLOB 'DELETE *' OR sql GLOB 'REPLACE *'))
    AS autocommit_writes
FROM ops
GROUP BY utid
HAVING autocommit_writes > 0
ORDER BY autocommit_writes DESC
LIMIT 10;
dumpsys meminfo
adb shell dumpsys meminfo <package-name> は、アプリのメモリ使用量に関連する統計情報を出力します。これには、DATABASES セクションの SQLite の詳細も含まれます。たとえば、次の出力は、デベロッパーのデバイスで adb shell dumpsys meminfo com.google.android.gms.persistent を実行した結果です。
DATABASES
      pgsz     dbsz   Lookaside(b) cache hits cache misses cache size  Dbname
PER CONNECTION STATS
         4       52             45     8    41     6  /data/user/10/com.google.android.gms/databases/gaia-discovery
         4        8                    0     0     0    (attached) temp
         4       52             56     5    23     6  /data/user/10/com.google.android.gms/databases/gaia-discovery (1)
         4      252             95   233   124    12  /data/user_de/10/com.google.android.gms/databases/phenotype.db
         4        8                    0     0     0    (attached) temp
         4      252             17     0    17     1  /data/user_de/10/com.google.android.gms/databases/phenotype.db (1)
         4     9280            105 103169 69805    25  /data/user/10/com.google.android.gms/databases/phenotype.db
         4       20                    0     0     0    (attached) temp
         4     9280            108 13877  6394    25  /data/user/10/com.google.android.gms/databases/phenotype.db (2)
         4        8                    0     0     0    (attached) temp
         4     9280            105 12548  5519    25  /data/user/10/com.google.android.gms/databases/phenotype.db (3)
         4        8                    0     0     0    (attached) temp
         4     9280            107 18328  7886    25  /data/user/10/com.google.android.gms/databases/phenotype.db (1)
         4        8                    0     0     0    (attached) temp
         4       36             51   156    29     5  /data/user/10/com.google.android.gms/databases/mobstore_gc_db_v0
         4       36             97    47    27    10  /data/user/10/com.google.android.gms/databases/context_feature_default.db
         4       36             56     3    16     4  /data/user/10/com.google.android.gms/databases/context_feature_default.db (2)
         4      300             40  2111    24     5  /data/user/10/com.google.android.gms/databases/gservices.db
         4      300             39     3    17     4  /data/user/10/com.google.android.gms/databases/gservices.db (1)
         4       20             17     0    14     1  /data/user/10/com.google.android.gms/databases/gms.notifications.db
         4       20             33     1    15     2  /data/user/10/com.google.android.gms/databases/gms.notifications.db (1)
         4      120             40   143   163     4  /data/user/10/com.google.android.gms/databases/android_pay
         4      120            123    86    32    19  /data/user/10/com.google.android.gms/databases/android_pay (1)
         4       28             33     4    17     3  /data/user/10/com.google.android.gms/databases/googlesettings.db
POOL STATS
     cache hits  cache misses    cache size  Dbname
             13            68            81  /data/user/10/com.google.android.gms/databases/gaia-discovery
            233           145           378  /data/user_de/10/com.google.android.gms/databases/phenotype.db
         147921         89616        237537  /data/user/10/com.google.android.gms/databases/phenotype.db
            156            30           186  /data/user/10/com.google.android.gms/databases/mobstore_gc_db_v0
             50            57           107  /data/user/10/com.google.android.gms/databases/context_feature_default.db
           2114            43          2157  /data/user/10/com.google.android.gms/databases/gservices.db
              1            31            32  /data/user/10/com.google.android.gms/databases/gms.notifications.db
            229           197           426  /data/user/10/com.google.android.gms/databases/android_pay
              4            18            22  /data/user/10/com.google.android.gms/databases/googlesettings.db
Android 14 以降では、例に示す PER CONNECTION STATS テーブルと POOL STATS テーブルが出力されます。Android 13 以前では、接続ごとのテーブルのみが出力され、キャッシュ統計情報は hits/misses/size として 1 つの cache 列に結合されます。
[PER CONNECTION STATS] には、次の情報が表示されます。
pgsz: 1 つのデータベース ページのサイズ(KB 単位)。dbsz: データベース ファイル全体のサイズ(KB 単位)。Lookaside(b): 接続で使用されるルックアサイド メモリ スロットの数。ヘッダーに(b)がありますが、これはバイト数ではなくスロット数です。cache hits、cache misses、cache size: 接続のプリペアド ステートメント キャッシュの統計情報。これらの値は、データベース ページではなく、コンパイルされた SQL ステートメントをカウントします。Dbname: データベース ファイルのパス。同じデータベースへの追加接続には、(1)のように、かっこで囲まれた番号が付加されます。WAL を使用すると、データベースに複数の接続を設定して、読み取りを並列で実行できます。
POOL STATS には、各接続プールのプリペアド ステートメント キャッシュの統計情報が表示されます。
cache hits: : SQLite は、準備済みステートメントをキャッシュに保存し、クエリの実行時に 再利用を試みます。これにより、SQL ステートメントのコンパイルにかかる労力とメモリを節約できます。これは、ステートメント キャッシュ ヒットの数です。cache misses: ステートメント キャッシュミスの数。cache size: Android 16 QPR2 以降では、キャッシュ内のプリペアド ステートメントの数。プールのアイドル接続全体で合計されます。Android 14 から Android 16 QPR1 では、この値はヒット数とミス数の合計であり、キャッシュ サイズを表すものではありません。
これらの統計情報を使用して、修正する内容を決定します。
- ミス率が高いということは、SQLite が同じステートメントを繰り返しコンパイルしていることを意味します。まず、文字列連結で構築された SQL を探し、パラメータ化します。クエリがすでにパラメータ化されていて、接続ごとの
cache sizeが上限の 25 に達している場合は、キャッシュ サイズを増やします。 (1)形式の接尾辞なしで複数回表示されるデータベース パスは、アプリが同じファイルを 2 回開いたことを意味します。各データベースを 1 回開きます。- アプリがほとんど使用しないデータベースでも、開いている間はメモリを保持します。完了したら閉じます。
dumpsys dbinfo
adb shell dumpsys dbinfo <package-name> は、アプリ内のすべての接続プールの状態を出力します。-v を追加すると、各接続のプリペアド ステートメント キャッシュ内のステートメントも一覧表示されます。次の出力例は Android 17 のもので、パスと長い行が短縮されています。
** Database info for pid 2705 [com.example.app] **
Connection pool for /data/user/0/com.example.app/databases/settings.db:
  Open: true
  Max connections: 4
  Total execution time (ms): 4963
  Total statements executed: 231239
  Average time per statement (ms): 0
  Configuration: openFlags=805306368, ..., journalMode=WAL, syncMode=NORMAL
  IsReadOnlyDatabase: false
  Available primary connection:
    <none>
  Available non-primary connections:
    <none>
  Acquired connections:
    <none>
  Connection waiters:
    <none>
Connection pool for /data/user/0/com.example.app/databases/events.db:
  Open: true
  Max connections: 1
  Total execution time (ms): 842
  Total statements executed: 840
  Average time per statement (ms): 1
  Configuration: openFlags=268435456, ..., journalMode=TRUNCATE, syncMode=FULL
  IsReadOnlyDatabase: false
  Available primary connection:
    Connection #0:
      isPrimaryConnection: true
      onlyAllowReadOnlyOperations: false
      totalLongOperations: 0
      Most recently executed operations:
        0: [10-26 04:22:32.133] executeForChangedRowCount took 0ms -
           succeeded, sql="DELETE FROM params WHERE app_id=?", path=...
        1: [10-26 04:22:32.133] prepare took 0ms - succeeded,
           sql="DELETE FROM params WHERE app_id=?", path=...
        ...
次の内容を確認します。
Configuration: プールのジャーナル モードと同期モード。Android 13 以降では、この行に、プラットフォームのデフォルトなど、フレームワークが適用したモードが表示されます。この例では、events.dbはFULL同期モードでロールバック ジャーナルを使用するため、すべての commit は完全な同期を待機します。この行には、ユーザーが自分で実行するPRAGMAステートメントは反映されません。Max connections: 書き込み可能なデータベースの値が 1 の場合、フレームワークはデータベースが WAL モードであると見なさないため、読み取りと書き込みで単一の接続を共有します。Total execution time、Total statements executed、Average time per statement: Android 13 以降で使用できます。これらを使用して、最もビジーなデータベースを見つけます。Most recently executed operations: 各接続の最後の 20 件のオペレーション(期間と SQL を含む)。同じクエリがループで実行されている、トランザクション外で多数の書き込みが連続して行われているなどのパターンを探します。Android 15 QPR1 以降では、このリストに明示的なトランザクションも含まれます。totalLongOperationsとOperations exceeding 2000ms: Android 15 QPR1 以降で使用できます。2 秒以上かかったオペレーションとトランザクションの数が表示され、そのうちの最後の 10 件が一覧表示されます。Acquired connectionsとConnection waiters: 使用中の接続と、接続を待機しているスレッド。ウェイターは、他の書き込みをブロックする長い書き込みトランザクションなどの競合を示します。Prepared statement cache:-vで印刷されます。リテラル値のみが異なる多くのエントリは、文字列連結で構築された SQL を指します。- 複数の
Connection pool for見出しの下に同じパスがある場合は、アプリが同じファイルを 2 回開いたことを意味します。
参考情報
コンテンツを閲覧する
あなたへのおすすめ
- 注: JavaScript がオフになっている場合はリンクテキストが表示されます
- 継続的インテグレーションでベンチマークを実行する
- フリーズしたフレーム
- Macrobenchmark を使用せずにベースライン プロファイルを作成して測定する