

Gdy zbierzesz wiele logów czasu za pomocą ProfilingManager, analizowanie ich pojedynczo w celu znalezienia problemów z wydajnością staje się niepraktyczne. Analiza logów czasu zbiorczo umożliwia jednoczesne wysyłanie zapytań do zbioru danych logów czasu w celu:
- rozpoznawać typowe spadki wydajności,
- obliczać rozkłady statystyczne (np. czas oczekiwania w 50, 90 i 99 centylu);
- znajdować wzorce w kilku logach czasu,
- Znajdź ślady odstające, aby zrozumieć i debugować problemy z wydajnością.
W tej sekcji pokazujemy, jak używać procesora śladów wsadowych Perfetto w Pythonie do analizowania danych dotyczących uruchamiania w zestawie śladów przechowywanych lokalnie i znajdowania śladów odstających w celu przeprowadzenia dokładniejszej analizy.
Projektowanie zapytania
Pierwszym krokiem do przeprowadzenia analizy zbiorczej jest utworzenie zapytania PerfettoSQL.
W tej sekcji przedstawiamy przykładowe zapytanie, które mierzy czas oczekiwania na uruchomienie aplikacji.
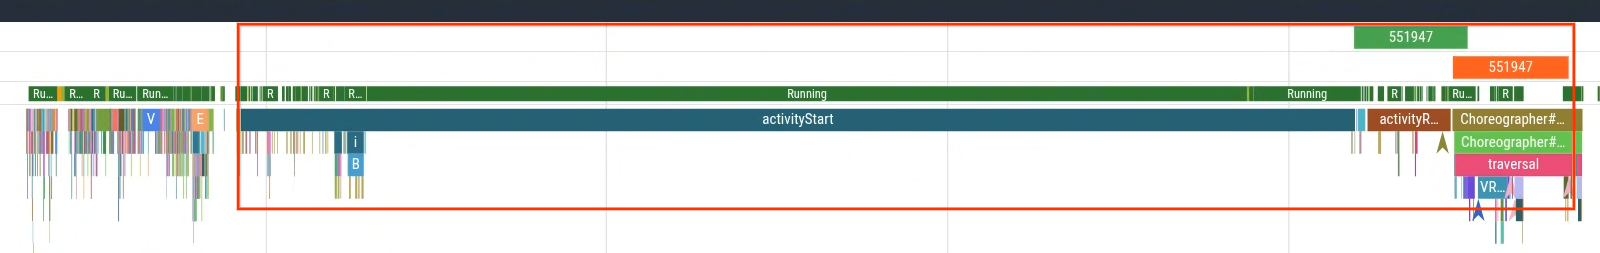
Możesz zmierzyć czas od activityStart do wygenerowania pierwszej klatki (pierwszego wystąpienia wycinka Choreographer#doFrame), aby zmierzyć czas oczekiwania na uruchomienie aplikacji, który jest pod jej kontrolą. Rysunek 1 przedstawia sekcję, do której należy wysłać zapytanie.
CREATE OR REPLACE PERFETTO FUNCTION find_slices(pattern STRING) RETURNS
TABLE (name STRING, ts LONG, dur LONG) AS
SELECT name,ts,dur FROM slice WHERE name GLOB $pattern;

CREATE OR REPLACE PERFETTO FUNCTION generate_start_to_end_slices(startSlicePattern STRING, endSlicePattern STRING, inclusive BOOL) RETURNS
TABLE(name STRING, ts LONG, dur LONG) AS
SELECT name, ts, MIN(startToEndDur) as dur
FROM
  (SELECT S.name as name, S.ts as ts, E.ts + IIF($inclusive, E.dur, 0) - S.ts as startToEndDur
  FROM find_slices($startSlicePattern) as S CROSS JOIN find_slices($endSlicePattern) as E
  WHERE startToEndDur > 0)
GROUP BY name, ts;

SELECT ts,name,dur from generate_start_to_end_slices('activityStart','*Choreographer#doFrame [0-9]*', true)
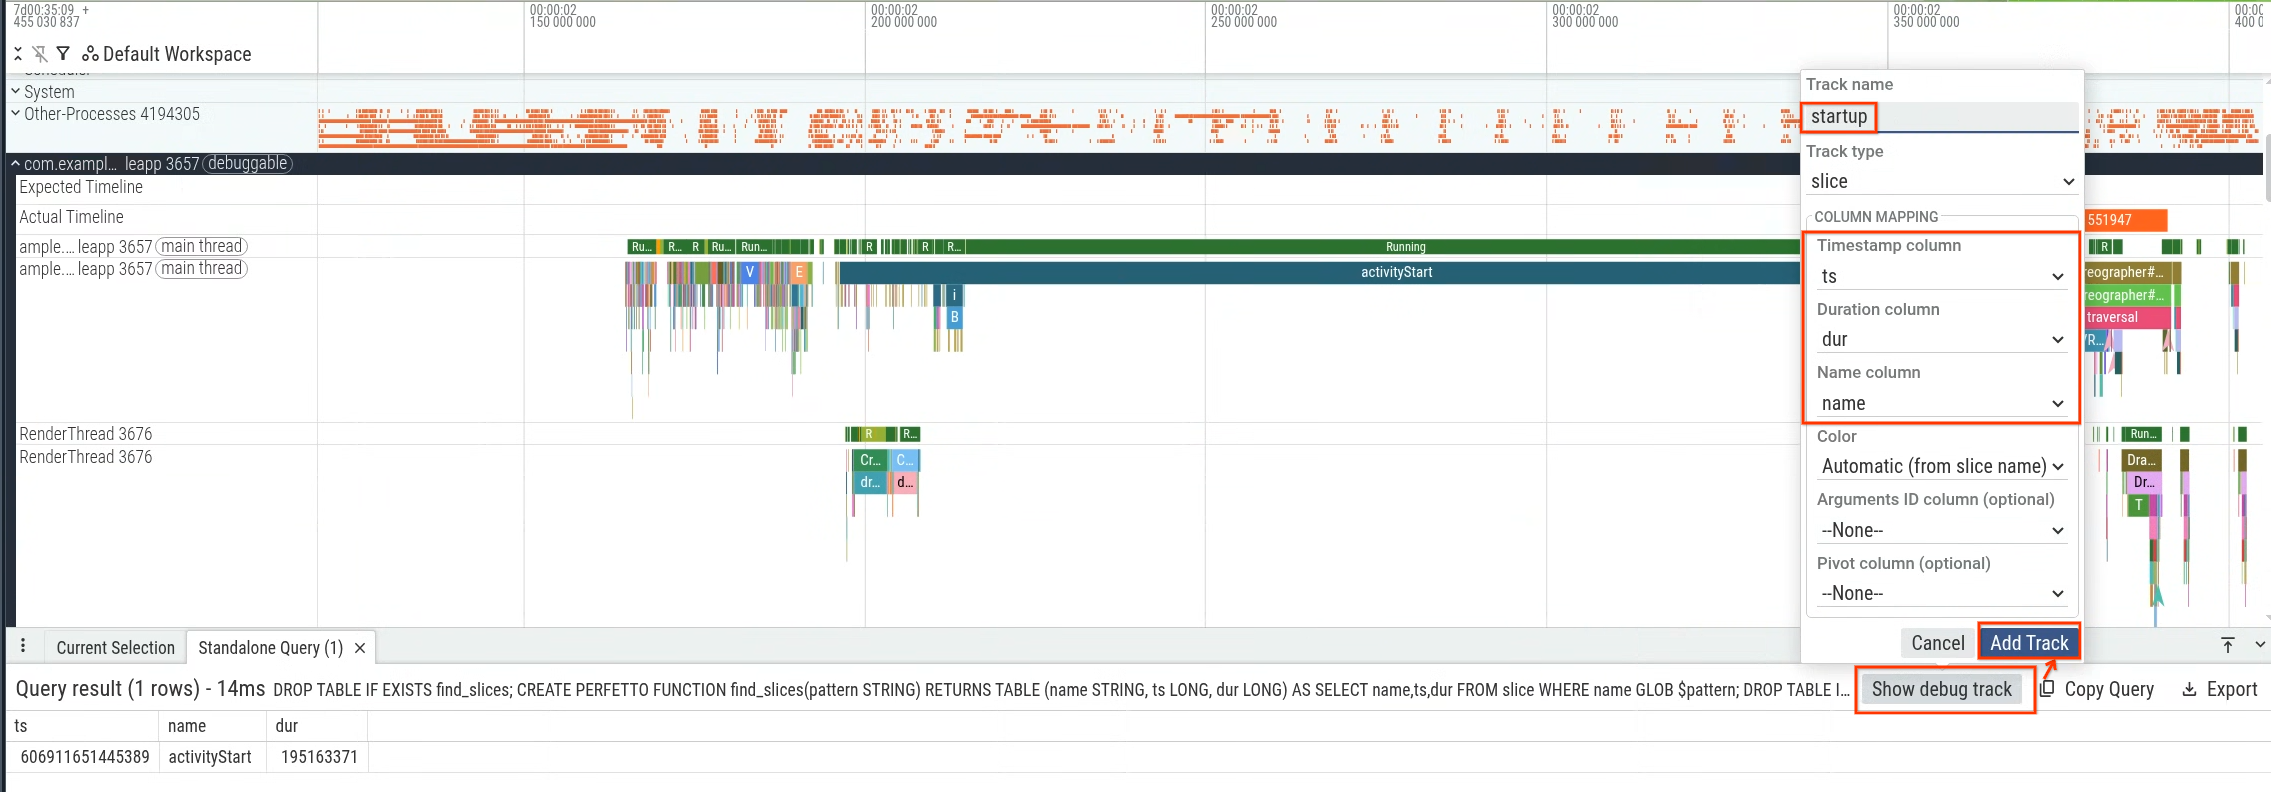
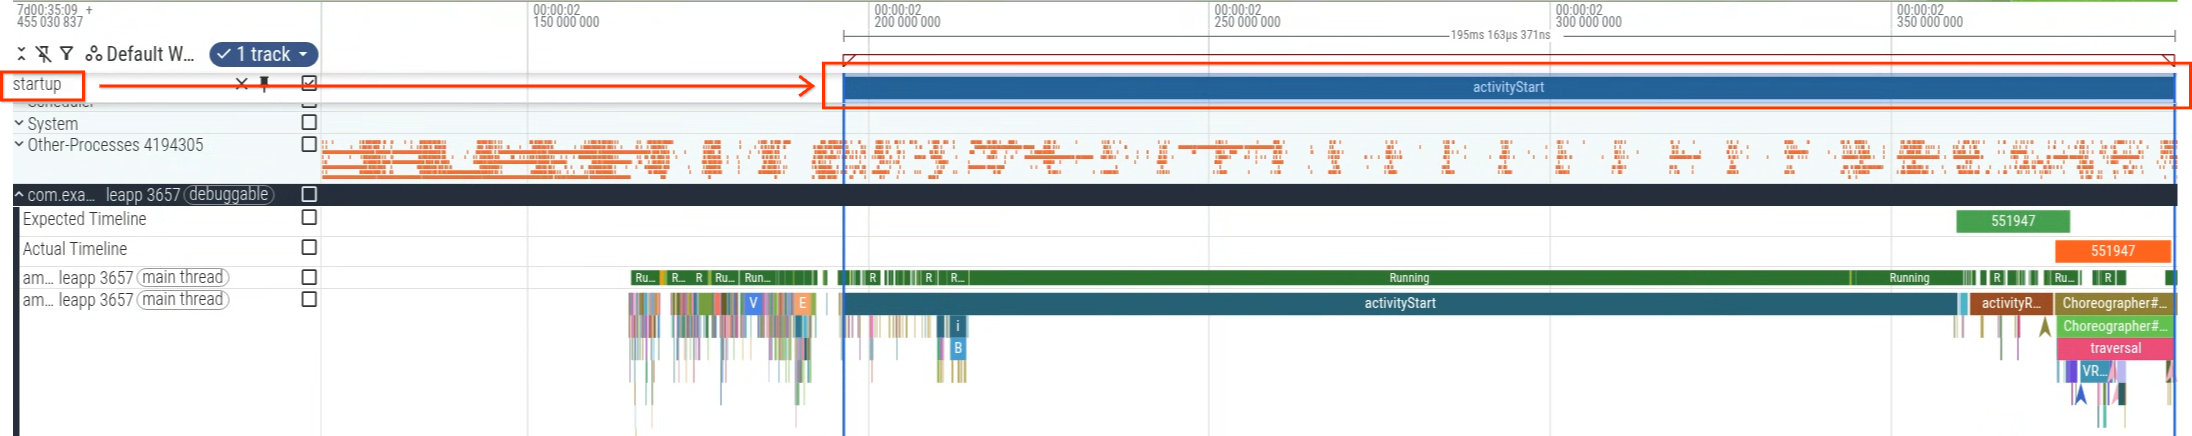
Możesz wykonać zapytanie w interfejsie Perfetto, a następnie użyć wyników zapytania do wygenerowania ścieżki debugowania (rysunek 2) i wizualizacji jej na osi czasu (rysunek 3).
Konfigurowanie środowiska Pythona
Zainstaluj Pythona na komputerze lokalnym i wymagane biblioteki:
pip install perfetto pandas plotly
Tworzenie skryptu do zbiorczej analizy logów czasu
Ten przykładowy skrypt wykonuje zapytanie w wielu logach czasu za pomocą interfejsu Perfetto Python BatchTraceProcessor.
from perfetto.batch_trace_processor import BatchTraceProcessor
import glob
import plotly.express as px

# Collect all trace files in the local directory
traces = glob.glob('*.perfetto-trace')

if not traces:
    print("No .perfetto-trace files found in the current directory.")
    exit(1)

if __name__ == '__main__':
    # Process all traces in parallel to aggregate metrics across runs
    with BatchTraceProcessor(traces) as btp:
        query = """
        CREATE OR REPLACE PERFETTO FUNCTION find_slices(pattern STRING) RETURNS
        TABLE (name STRING, ts LONG, dur LONG) AS
        SELECT name,ts,dur FROM slice WHERE name GLOB $pattern;

        CREATE OR REPLACE PERFETTO FUNCTION generate_start_to_end_slices(startSlicePattern STRING, endSlicePattern STRING, inclusive BOOL) RETURNS
        TABLE(name STRING, ts LONG, dur LONG) AS
        SELECT name, ts, MIN(startToEndDur) as dur
        FROM
          (SELECT S.name as name, S.ts as ts, E.ts + IIF($inclusive, E.dur, 0) - S.ts as startToEndDur
          FROM find_slices($startSlicePattern) as S CROSS JOIN find_slices($endSlicePattern) as E
          WHERE startToEndDur > 0)
        GROUP BY name, ts;

        SELECT ts,name,dur / 1000000 as dur_ms from generate_start_to_end_slices('activityStart','*Choreographer#doFrame [0-9]*', true)
        """
        df = btp.query_and_flatten(query)
        # Plot the distribution of startup times, tracking trace file paths on
        # hover
        violin = px.violin(df, x='dur_ms', hover_data='_path', title='startup time', points='all')
        violin.show()
Zrozumienie skryptu
Gdy uruchomisz skrypt w Pythonie, wykona on te działania:
- Skrypt wyszukuje w katalogu lokalnym wszystkie logi Perfetto z przyrostkiem
.perfetto-tracei używa ich jako logów źródłowych do analizy. - Uruchamia zapytanie o zbiorcze śledzenie, które oblicza podzbiór czasu uruchamiania odpowiadający czasowi od wycinka śledzenia
activityStartdo pierwszej klatki wygenerowanej przez aplikację. - Przedstawia czas oczekiwania w milisekundach za pomocą wykresu skrzypcowego, aby zwizualizować rozkład czasów uruchamiania.
Interpretowanie wyników
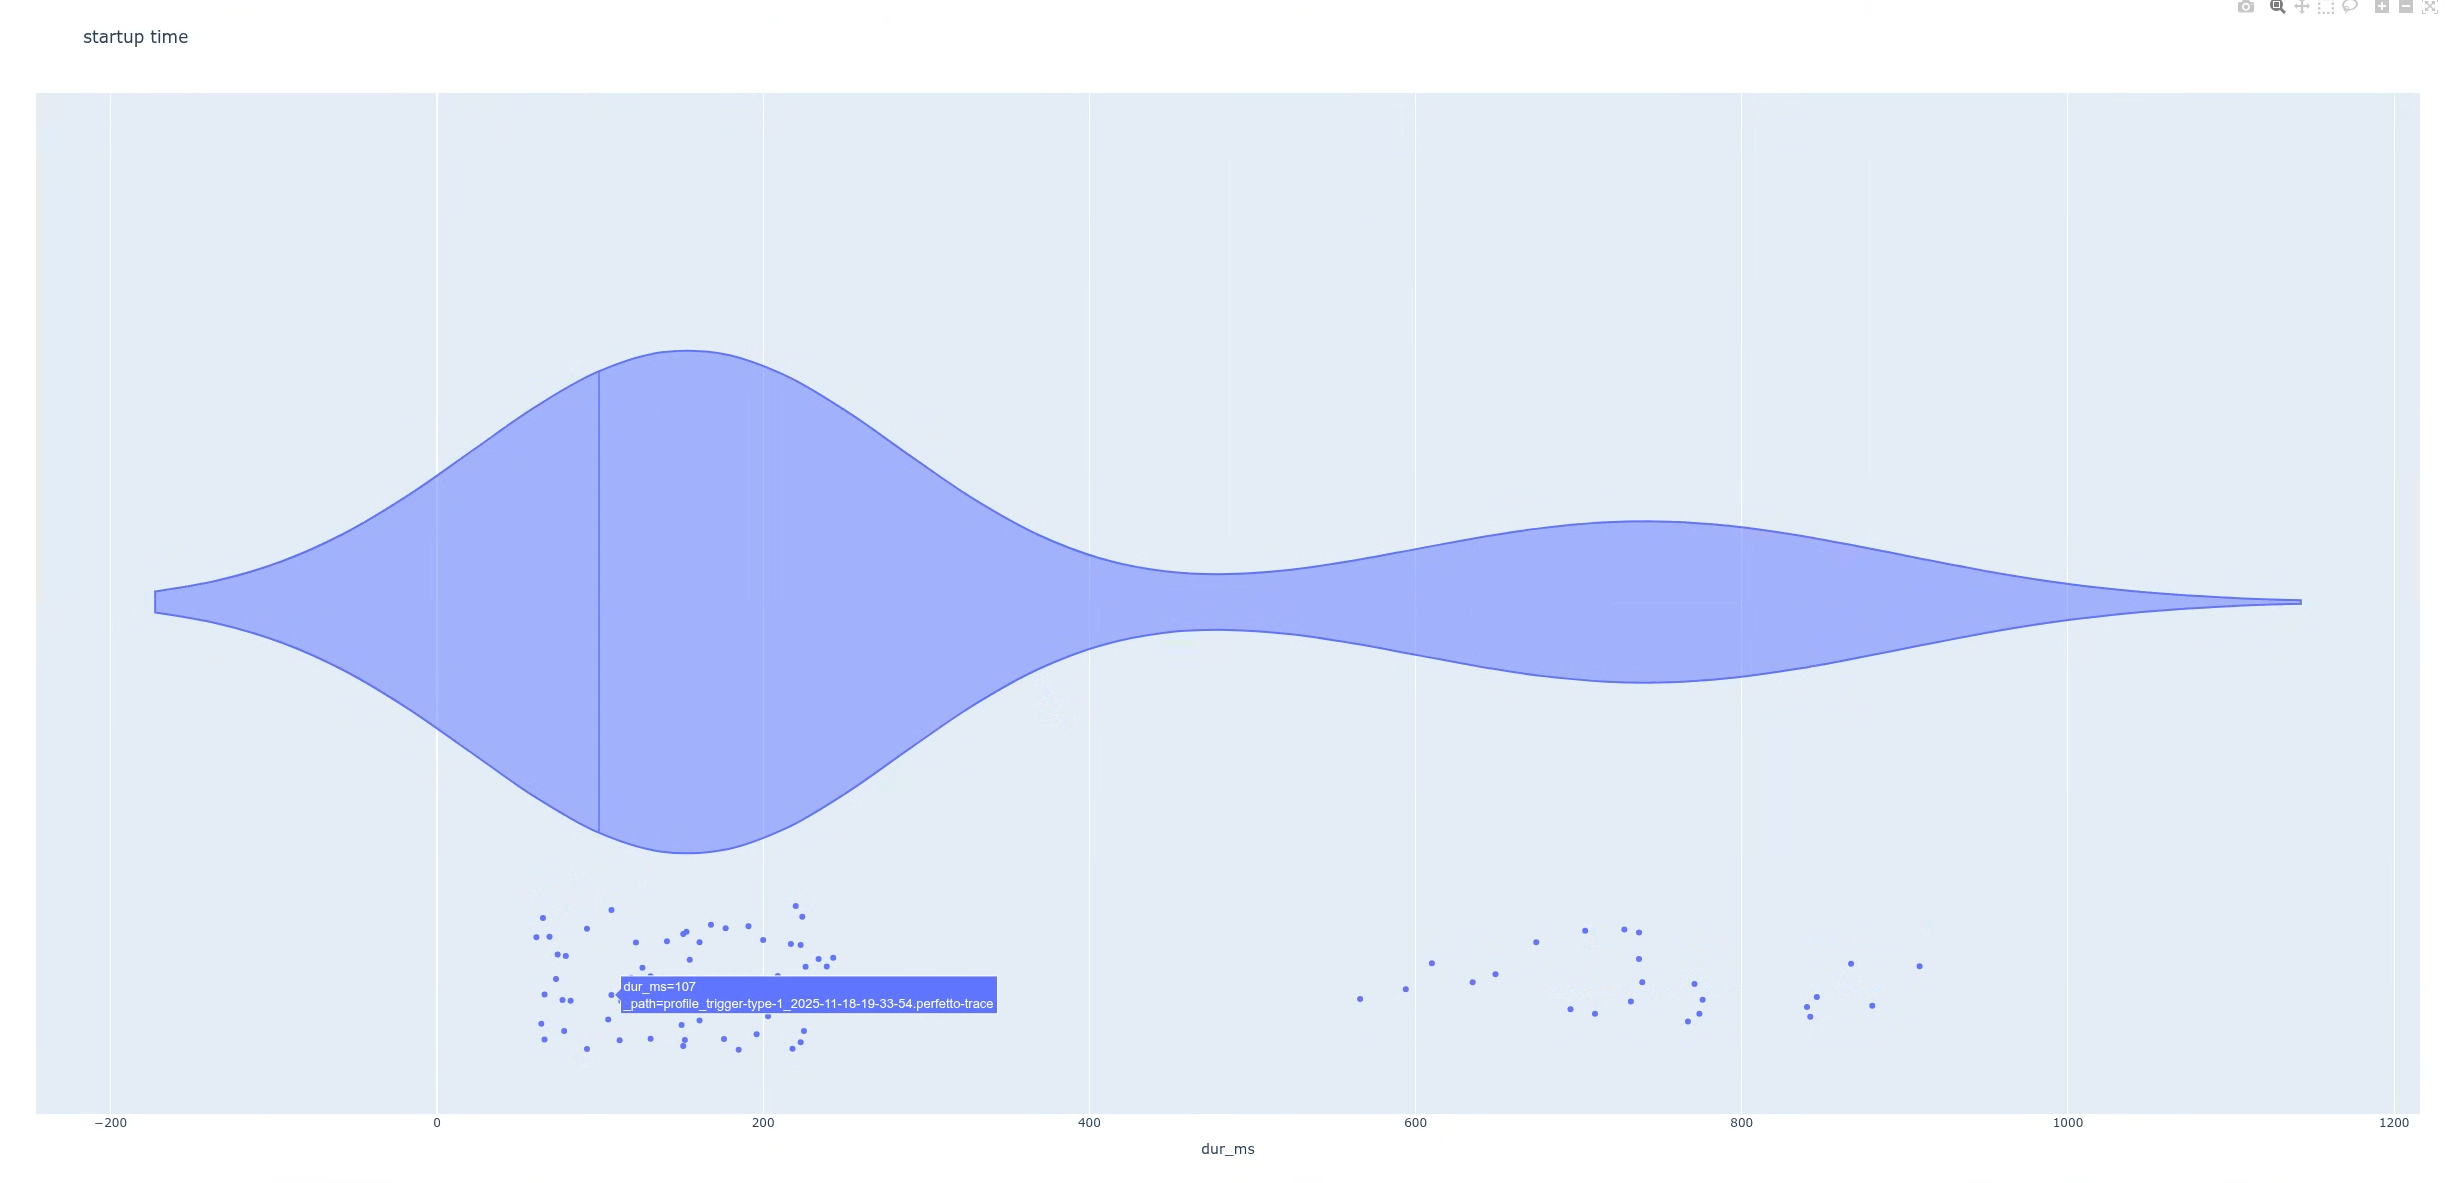
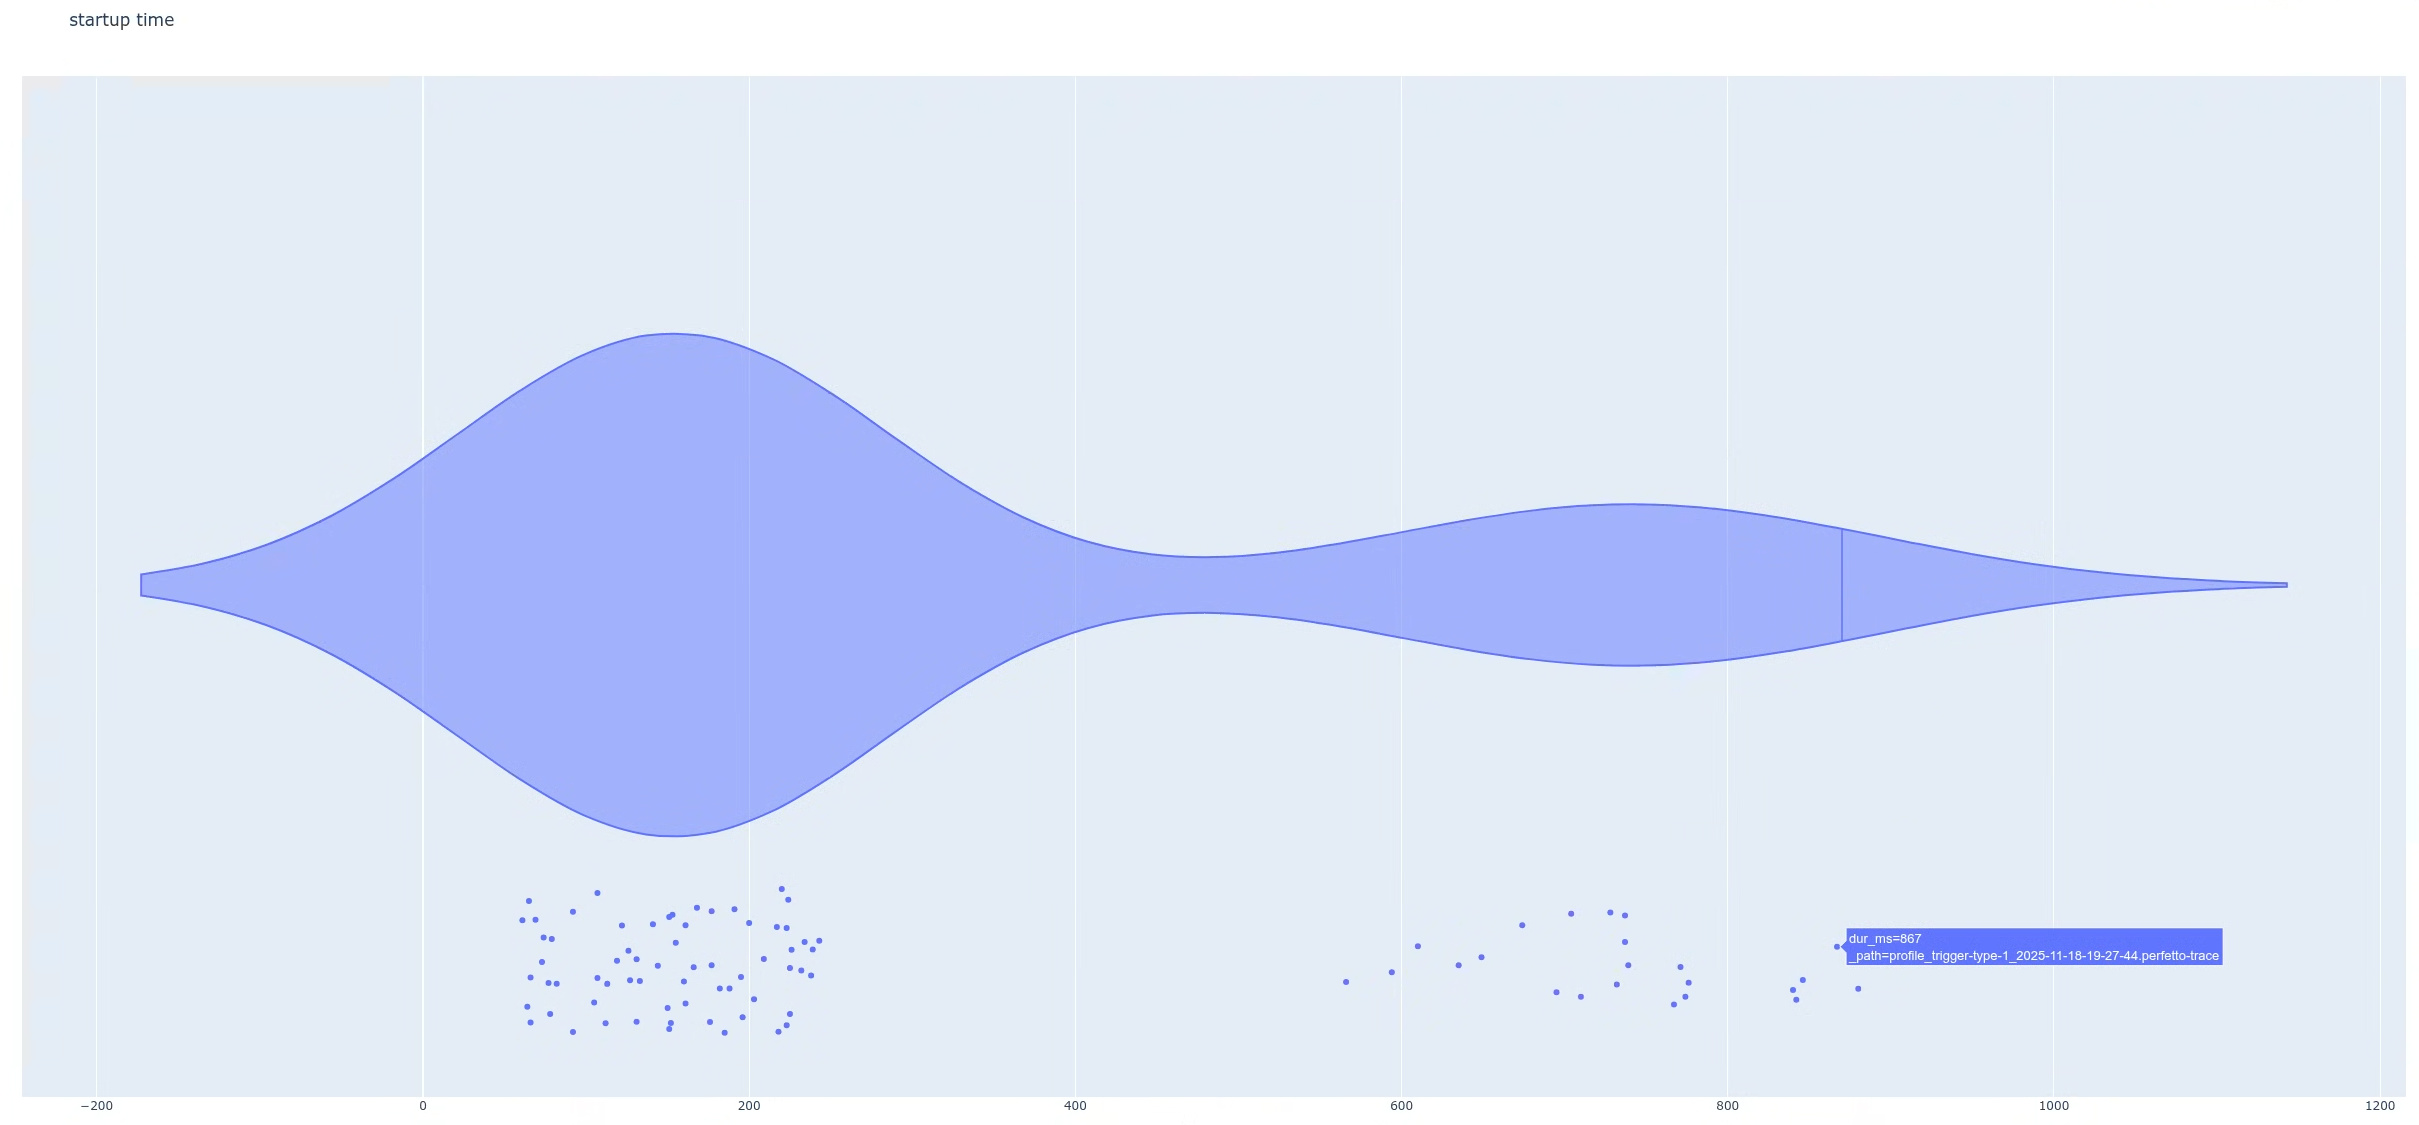
Po wykonaniu skryptu zostanie wygenerowany wykres. W tym przypadku wykres pokazuje rozkład bimodalny z 2 wyraźnymi szczytami (rysunek 4).
Następnie znajdź różnicę między tymi 2 populacjami. Dzięki temu możesz dokładniej przeanalizować poszczególne logi czasu oczekiwania. W tym przykładzie wykres jest skonfigurowany tak, że po najechaniu kursorem na punkty danych (opóźnienia) można zidentyfikować nazwy plików logów czasu oczekiwania. Następnie możesz otworzyć jeden ze logów czasu oczekiwania, który należy do grupy o wysokim czasie oczekiwania.
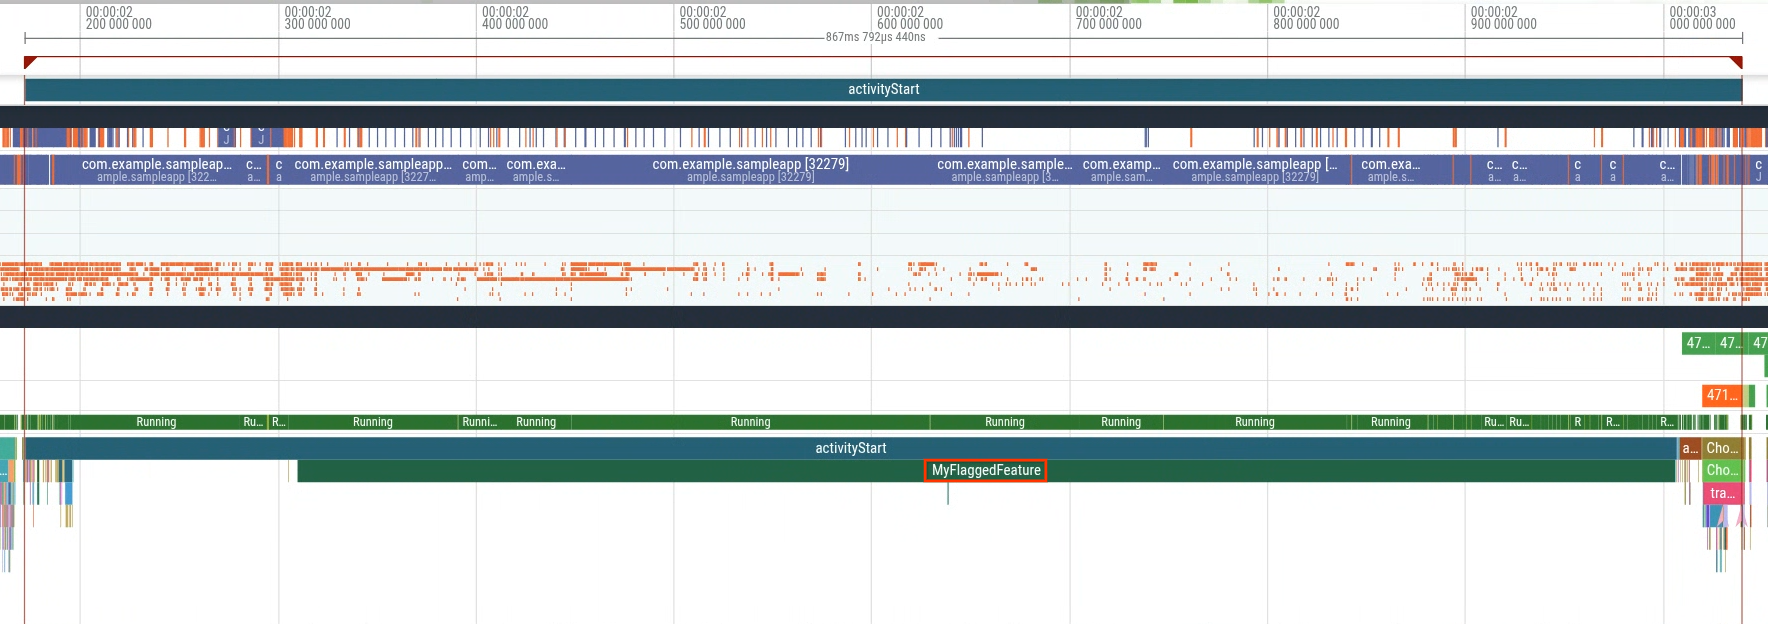
Gdy otworzysz log czasu z grupy o wysokim opóźnieniu (rysunek 5), zobaczysz dodatkowy wycinek o nazwie MyFlaggedFeature, który jest uruchamiany podczas uruchamiania (rysunek 6).
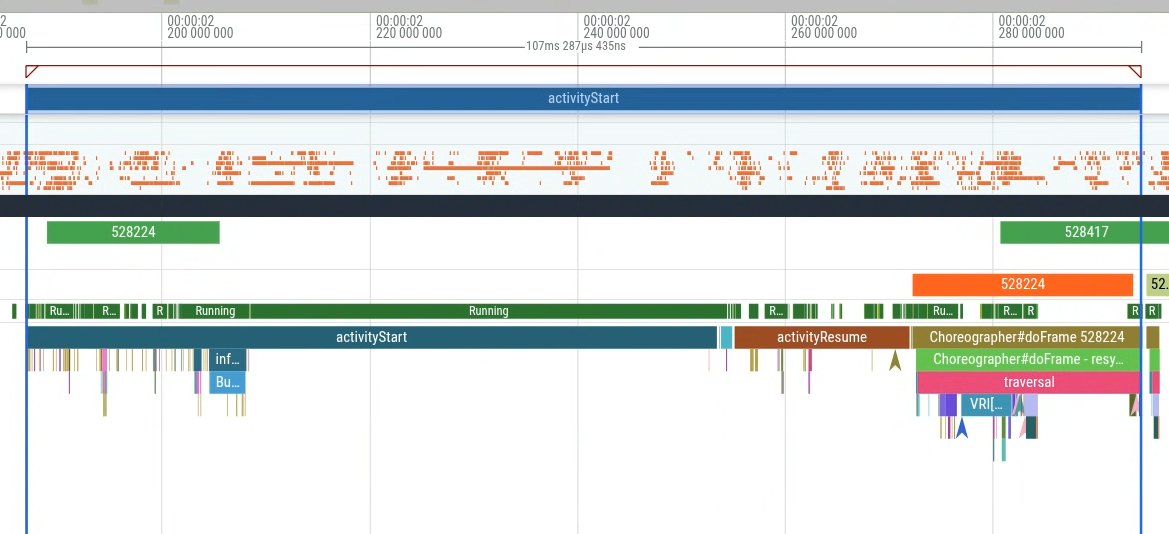
Z kolei wybranie śladu z populacji o mniejszym opóźnieniu (szczyt po lewej stronie) potwierdza brak tego samego wycinka (rysunek 7). To porównanie wskazuje, że regresję wywołuje konkretna flaga funkcji, która jest włączona dla podzbioru użytkowników.
Ten przykład pokazuje jeden z wielu sposobów korzystania z analizy logów czasu oczekiwania zbiorczo. Inne przypadki użycia obejmują wyodrębnianie statystyk z pola w celu oceny wpływu, wykrywanie regresji i inne.