

Liberar un objeto en el código de tu app o cerrar un flujo temporal no siempre devuelve la RAM física al sistema operativo. Los asignadores nativos personalizados, los entornos de ejecución con recolección de elementos no utilizados y las tablas hash de direccionamiento abierto suelen retener áreas de memoria virtual que permanecen respaldadas por páginas físicas mucho después de que desaparecen los datos lógicos que contienen. Del mismo modo, leer o asignar en la memoria archivos de recursos grandes propaga la caché de páginas del kernel, que permanece cargada en el grupo de control de memoria (memcg) de tu app.
En esta página, se explica cómo usar las llamadas al sistema madvise y posix_fadvise para
devolver páginas anónimas y respaldadas por archivos sin usar al SO, mientras se mantienen intactas las reservas de direcciones virtuales
y los descriptores de archivos, y cómo verificar el impacto
en adb shell y Perfetto.
Por qué la desasignación lógica retiene la RAM física
El kernel de Linux hace un seguimiento de la memoria física con la granularidad de las páginas de hardware,
que son de 4 KB o 16 KB en dispositivos Android. Cuando un
proceso reserva una región de espacio de direcciones virtuales con mmap, el kernel
crea un área de memoria virtual (VMA) sin asignar RAM física. El kernel
asigna y cobra una página física solo cuando el proceso accede por primera vez a esa
página. Para la memoria anónima, una primera lectura asigna una página cero compartida, por lo que solo una
escritura asigna RAM.
Una vez que se produce un error de página en la RAM, el kernel no sabe si los bytes dentro de esa página aún representan objetos activos en el entorno de ejecución de tu app. Existen dos patrones comunes que mantienen las páginas físicas residentes después de que tu app deja de usarlas:
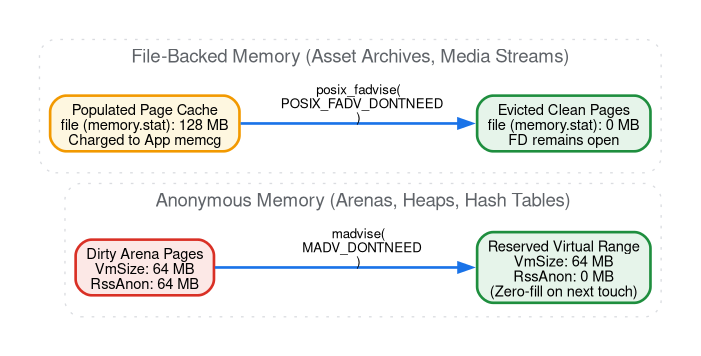
- Arenas y grupos anónimos: Los asignadores nativos personalizados (como los asignadores de slab, grupo o arena de marcos), los entornos de ejecución administrados con espacios de montón que no se mueven y las tablas hash grandes reservan rangos de direcciones virtuales contiguos con
mmapusandoMAP_PRIVATE | MAP_ANONYMOUS. Cuando tu app restablece una arena, libera un bloque de vuelta a un grupo personalizado o borra una tabla hash poniendo a cero sus metadatos, las páginas subyacentes permanecen sucias. Sin una sugerencia explícita para el kernel, esas páginas siguen contando para el tamaño del conjunto residente (RSS) y el tamaño del conjunto proporcional (PSS) anónimos de tu proceso, y su cargo de cgroup dememory.current. Cuando hay presión de memoria, el kernel los comprime en ZRAM, donde siguen ocupando espacio de intercambio que se carga amemory.swap.current. - Caché de páginas respaldada por archivos de la transmisión de recursos: Cuando tu app lee paquetes de recursos grandes, archivos de nivel, contenedores de contenido multimedia o modelos de aprendizaje automático con
read,preadommaprespaldado por archivos, el kernel almacena en caché cada página leída en la caché de páginas y carga esas páginas en el contadorfiledel archivomemory.statdel cgroup de tu proceso. Si tu app descomprime o copia ese recurso en un búfer de tiempo de ejecución anónimo o lo sube a la GPU, mantener las páginas de archivos sin procesar en la caché de páginas duplica el recurso en la RAM.
Publica páginas anónimas
La llamada al sistema madvise le da al kernel un consejo sobre cómo tu proceso espera
usar un rango de direcciones virtuales. Para las asignaciones anónimas privadas (MAP_PRIVATE |
MAP_ANONYMOUS), pasar MADV_DONTNEED indica al kernel que descarte de inmediato las páginas físicas y las entradas de ZRAM intercambiadas que respaldan el rango alineado con la página especificado.
Después de madvise con MADV_DONTNEED, se devuelve lo siguiente:
- El rango de direcciones virtuales permanece reservado y válido en el espacio de direcciones de tu proceso (
VmSizeno cambia), por lo que los punteros y los límites de la arena permanecen intactos sin llamar amunmapni ammap. - Se desasignan y liberan de inmediato las páginas físicas, lo que reduce
RssAnon,Pss, el contadoranonenmemory.statymemory.swap.currentpara las páginas que estaban en ZRAM. - Cualquier lectura o escritura posterior en una dirección de ese rango genera un error en una página nueva rellena con ceros a pedido.
| Marca de consejo | Asignación de segmentación | Comportamiento del kernel en Android |
|---|---|---|
MADV_DONTNEED |
Privado anónimo (MAP_PRIVATE | MAP_ANONYMOUS) |
Descarta de inmediato las páginas físicas y las ranuras de intercambio de ZRAM. Los accesos posteriores generan errores en las páginas completadas con ceros. Disminución determinística en RssAnon y memory.current. |
MADV_DONTNEED |
Respaldado por archivos (MAP_PRIVATE o MAP_SHARED) |
Anula la asignación de páginas de las tablas de páginas del proceso (caídas de RssFile). Se descartan las páginas privadas de copia en escritura en una asignación MAP_PRIVATE, por lo que se pierden las modificaciones y el siguiente acceso vuelve a leer el
archivo. Las páginas de MAP_SHARED modificadas se vuelven a escribir en el almacenamiento más adelante. Las páginas limpias permanecen en la caché de páginas hasta que se expulsan. |
MADV_FREE |
Privado anónimo (MAP_PRIVATE | MAP_ANONYMOUS) |
Marca las páginas como reutilizables de forma diferida. El kernel conserva las páginas en
RssAnon si no hay presión de memoria y las recupera solo
cuando se ejecuta la recuperación global o de memcg. |
MADV_WILLNEED |
Anónimo respaldado por archivos o intercambiado | Inicia la lectura anticipada asíncrona para las asignaciones respaldadas por archivos o vuelve a leer las páginas anónimas intercambiadas de ZRAM a la caché de intercambio con anticipación. |
Alinea los rangos interiores con el tamaño de página del entorno de ejecución
madvise opera en páginas completas. Requiere una dirección de inicio alineada con la página y redondea la longitud hasta el siguiente límite de página. Si liberas un intervalo dentro de una
arena compartida en la que los bytes vecinos aún contienen objetos activos, redondear el rango
hacia afuera puede anular las asignaciones activas que comparten las páginas de límite.
Siempre consulta el tamaño de página del entorno de ejecución con sysconf(_SC_PAGESIZE) para admitir dispositivos con páginas de 4 KB y 16 KB, y redondea la dirección de inicio interior hasta el siguiente límite de página y la dirección de finalización interior hasta el límite de página anterior. Para obtener más orientación sobre los asignadores independientes del tamaño de página, consulta Optimiza los asignadores de memoria personalizados.
#include <sys/mman.h>
#include <unistd.h>
#include <cstdint>
// Reclaims physical pages strictly inside [region_start, region_start + length)
// without disturbing live objects on partially occupied boundary pages.
void ReleaseUnusedArenaSpan(void* region_start, size_t length) {
const uintptr_t page_size = static_cast<uintptr_t>(sysconf(_SC_PAGESIZE));
const uintptr_t page_mask = ~(page_size - 1);
const uintptr_t raw_start = reinterpret_cast<uintptr_t>(region_start);
const uintptr_t raw_end = raw_start + length;
// Round start UP and end DOWN so only fully unused pages are discarded.
const uintptr_t aligned_start = (raw_start + page_size - 1) & page_mask;
const uintptr_t aligned_end = raw_end & page_mask;
if (aligned_end > aligned_start) {
madvise(reinterpret_cast<void*>(aligned_start),
aligned_end - aligned_start,
MADV_DONTNEED);
}
}
Cuando crees asignaciones anónimas personalizadas con mmap, etiqueta el VMA con prctl
con PR_SET_VMA_ANON_NAME para que puedas hacer un seguimiento de su residencia por nombre en
showmap y /proc/<pid>/smaps. dumpsys
meminfo cuenta las regiones anónimas con nombres personalizados en Unknown.
Algunos kernels más antiguos mantienen un puntero al nombre en lugar de copiarlo, por lo que se pasa una
cadena que sigue siendo válida durante el ciclo de vida de la asignación, como una cadena
literal:
#include <sys/mman.h>
#include <sys/prctl.h>
#ifndef PR_SET_VMA
#define PR_SET_VMA 0x53564d41
#define PR_SET_VMA_ANON_NAME 0
#endif
void* ReserveNamedArena(size_t capacity_bytes, const char* arena_name) {
void* ptr = mmap(nullptr, capacity_bytes, PROT_READ | PROT_WRITE,
MAP_PRIVATE | MAP_ANONYMOUS, -1, 0);
if (ptr != MAP_FAILED) {
prctl(PR_SET_VMA, PR_SET_VMA_ANON_NAME,
reinterpret_cast<unsigned long>(ptr), capacity_bytes,
reinterpret_cast<unsigned long>(arena_name));
}
return ptr;
}
Expulsa páginas de caché de archivos
Cuando tu app lee datos de un descriptor de archivo, el kernel almacena en caché las páginas del archivo en la caché de páginas para anticipar lecturas futuras. Si bien esto acelera los accesos repetidos a archivos de configuración pequeños o bibliotecas compartidas, funciona en tu contra cuando transmites archivos de recursos grandes, paquetes de texturas o fragmentos de audio y video que se analizan una vez y se almacenan en formato decodificado en otro lugar.
La llamada al sistema posix_fadvise permite que tu app informe al kernel sobre su patrón de acceso a archivos esperado en un descriptor de archivo abierto:
POSIX_FADV_DONTNEED: Indica al kernel que no se accederá al rango de bytes especificado en el futuro cercano. El kernel expulsa de inmediato las páginas almacenadas en caché limpias y sin asignar en ese rango alineado con la página de la caché de páginas, lo que reduce el contadorfileenmemory.staty el cargomemory.currentde tu cgroup.POSIX_FADV_SEQUENTIAL: Duplica la ventana de lectura anticipada del kernel para el descriptor de archivo, lo que mejora la capacidad de procesamiento cuando se transmite un archivo grande de principio a fin. Combina esto conPOSIX_FADV_DONTNEEDen los fragmentos finales a medida que los consumes para que el espacio de la caché de la página se mantenga limitado a una pequeña ventana deslizante.POSIX_FADV_RANDOM: Inhabilita la lectura anticipada especulativa del kernel en el descriptor de archivo. Usa esta opción cuando realices búsquedas dispersas y no contiguas por desplazamiento de bytes en un archivo grande o en un archivo de base de datos para que cada lectura pequeña no extraiga páginas adyacentes sin usar en la caché de páginas. En el caso de los archivos asignados a la memoria, llama amadviseconMADV_RANDOMen la asignación.
En el siguiente ejemplo, se transmite un archivo de recursos grande en fragmentos, lo que habilita la lectura anticipada secuencial por adelantado y expulsa cada intervalo alineado con la página procesado de la caché de páginas:
#include <fcntl.h>
#include <unistd.h>
#include <cstdint>
#include <vector>

void StreamAssetArchive(int fd, size_t total_size) {
  const size_t page_size = static_cast<size_t>(sysconf(_SC_PAGESIZE));
  constexpr size_t kChunkSize = 4 * 1024 * 1024;  // 4 MB streaming window
  std::vector<uint8_t> buffer(kChunkSize);

  // Hint sequential access so the kernel prefetches upcoming chunks.
  posix_fadvise(fd, 0, total_size, POSIX_FADV_SEQUENTIAL);

  off_t offset = 0;
  while (offset < static_cast<off_t>(total_size)) {
    ssize_t bytes_read = pread(fd, buffer.data(), buffer.size(), offset);
    if (bytes_read <= 0) break;

    // Decode or upload buffer[0 .. bytes_read) into runtime structures here.

    // Evict full pages that have been completely consumed.
    const size_t aligned_len =
        (static_cast<size_t>(bytes_read) / page_size) * page_size;
    if (aligned_len > 0) {
      posix_fadvise(fd, offset, static_cast<off_t>(aligned_len),
                    POSIX_FADV_DONTNEED);
    }
    offset += bytes_read;
  }
}
Recupera regiones de mmap respaldadas por archivos
Si tu app asigna memoria a un archivo de recursos grande con mmap en lugar de leerlo con pread, llamar a posix_fadvise solo con POSIX_FADV_DONTNEED no expulsa las páginas que aún están asignadas en las tablas de páginas de tu proceso. Para descartar un
intervalo consumido de una asignación de archivos de solo lectura sin anular la asignación de toda la VMA, haz lo siguiente:
- Llama a
madvise(addr, length, MADV_DONTNEED)en el rango de direcciones virtuales asignadas para desasignar esas páginas de las tablas de páginas de tu proceso (disminuciones deRssFile). - Llama a
posix_fadvise(fd, offset, length, POSIX_FADV_DONTNEED)en el desplazamiento de archivo correspondiente para que el kernel también expulse las páginas limpias sin asignar de la caché de páginas (fileenmemory.statdescartes).
Sigue los lineamientos de consejos para páginas
Aplica estas prácticas cuando integres madvise y posix_fadvise en asignadores, cargadores de recursos y controladores de ciclo de vida:
- Agrupa llamadas en lotes en regiones generales: Cada llamada
madvisetoma el bloqueo del mapa de memoria de tu proceso (mmap_lock), recorre las tablas de páginas y, luego, invalida las entradas del búfer de búsqueda de traducción (TLB) coincidentes en otros núcleos de CPU (con instrucciones de mantenimiento de TLB de transmisión en Arm y de interrupciones entre procesadores en x86). No llames amadviseen cada desasignación pequeña. Combina los intervalos libres y avisa al kernel en fragmentos de 64 KB a 1 MB o más, o bien limpia los intervalos libres durante los límites de fotogramas y las transiciones en segundo plano (onStopyTRIM_MEMORY_UI_HIDDEN). - Recupera la capacidad vacía en tablas hash y grupos: Cuando se borra una tabla hash, un grupo de objetos o un búfer de etapa de pruebas de gran tamaño después de una transición de escena o una sincronización de datos, reduce su asignación de respaldo o emite
MADV_DONTNEEDen todo el array de respaldo borrado. Si mantienes una tabla de direccionamiento abierto de 32 MB asignada con lápidas, se cargarán los 32 MB de páginas físicas a tu proceso. - Vacía los datos de archivos sucios antes de expulsarlos:
POSIX_FADV_DONTNEEDsolo expulsa las páginas de caché de páginas limpias. Si tu app escribe un archivo temporal o de caché grande que no volverá a leer de inmediato, llama afdatasyncantes deposix_fadvise(fd, 0, 0, POSIX_FADV_DONTNEED)para que las páginas modificadas se escriban en el almacenamiento y, luego, se quiten de la RAM. - No expulses código ni recursos compartidos de uso frecuente: Evita llamar a
POSIX_FADV_DONTNEEDen DEX, ODEX, VDEX, bibliotecas compartidas (.so) o recursos de IU a los que se accede de forma reiterada. Expulsar páginas de código o recursos activos fuerza fallas de almacenamiento síncronas que detienen los subprocesos y aumentan la presión de E/S, como lo informa la información de detención por presión (PSI).
Verifica la recuperación de páginas en la shell
Verifica que madvise y posix_fadvise reclamen la RAM física con showmap
y los archivos de contabilización de cgroup v2 de tu app.
Inspecciona el tamaño virtual en comparación con el físico con showmap
Cuando asignas un nombre a un espacio anónimo con PR_SET_VMA_ANON_NAME, showmap muestra tanto su reserva virtual (virtual size) como sus páginas físicas residentes (RSS y PSS). El siguiente resultado de muestra proviene de la app de ejemplo MemoryLab en el AOSP, que asigna el nombre memorylab-arena a su espacio. Reemplaza com.example.app
y memorylab-arena por el nombre de tu paquete y el nombre de la arena. Antes de llamar a madvise con MADV_DONTNEED en un espacio de 64 MB tocado, ejecuta lo siguiente:
adb shell "showmap \$(pidof com.example.app) | grep -E '^ +virtual|^ +size|memorylab-arena' | head -3"
 virtual                     shared   shared  private  private                   Anon      Shmem     File      Shared   Private
    size      RSS      PSS    clean    dirty    clean    dirty     swap  swapPSS HugePages PmdMapped PmdMapped Hugetlb  Hugetlb    Locked    # object
   65536    65536    65536        0        0        0    65536        0        0         0         0         0        0        0        0    1 [anon:memorylab-arena]
Después de llamar a madvise(arena_ptr, 64 * 1024 * 1024, MADV_DONTNEED), vuelve a ejecutar showmap:
 virtual                     shared   shared  private  private                   Anon      Shmem     File      Shared   Private
    size      RSS      PSS    clean    dirty    clean    dirty     swap  swapPSS HugePages PmdMapped PmdMapped Hugetlb  Hugetlb    Locked    # object
   65536        0        0        0        0        0        0        0        0         0         0         0        0        0        0    1 [anon:memorylab-arena]
El virtual size se mantiene en 65536 KB (64 MB), lo que confirma que el rango de direcciones virtuales aún está reservado, mientras que RSS, PSS y private dirty bajan a 0 KB.
Inspecciona memory.current y memory.stat de cgroup
Para verificar la recuperación de páginas anónimas y la expulsión de la caché de páginas no asignadas
(que no aparece en las tablas de páginas de procesos si se lee con pread), inspecciona el
directorio cgroup v2 del proceso. En Android, cada proceso de la app tiene su propio cgroup (como /sys/fs/cgroup/apps/uid_<UID>/pid_<PID>/, según el dispositivo).
El siguiente comando busca el directorio de la línea 0:: de
/proc/<PID>/cgroup y, luego, imprime los contadores:
adb shell '
  PID=$(pidof com.example.app)
  CG=/sys/fs/cgroup$(sed -n "s/^0:://p" /proc/$PID/cgroup)
  echo "memory.current: $(cat $CG/memory.current)"
  echo "memory.swap.current: $(cat $CG/memory.swap.current)"
  grep -E "^(anon|file) " $CG/memory.stat
'
Antes de liberar un espacio anónimo de 64 MB y expulsar un archivo de recursos asignado a la memoria de 128 MB de la caché de páginas, haz lo siguiente:
memory.current: 242962432
memory.swap.current: 16633856
anon 100671488
file 140009472
Inmediatamente después de llamar a madvise con MADV_DONTNEED en la arena y en la asignación de archivos de recursos, y, luego, a posix_fadvise con POSIX_FADV_DONTNEED en el descriptor de archivos de recursos:
memory.current: 41766912
memory.swap.current: 16502784
anon 33722368
file 5914624
anon disminuye en 64 MB y file disminuye en 128 MB, lo que reduce memory.current en alrededor de 192 MB sin cerrar el descriptor de archivo ni desasignar el espacio de direcciones virtuales de la arena. memory.swap.current apenas cambia, ya que casi ninguna de las páginas de arena se intercambió a ZRAM. Tus valores dependen del dispositivo y de la cantidad de archivos que el kernel ya expulsó por su cuenta. Para obtener más información sobre cómo el kernel cobra y reclama
memoria por cgroup, consulta Recuperación de memoria: expulsión e intercambio.
Cómo analizar la recuperación de páginas en Perfetto
Perfetto te permite correlacionar las llamadas a madvise y posix_fadvise con los contadores de la tabla de páginas y la caché de páginas del kernel en un cronograma unificado.
Cómo registrar un seguimiento
Captura un registro con linux.process_stats para los contadores de procesos periódicos y linux.ftrace para los eventos de RSS y de caché de páginas en tiempo real, y, luego, envíalo a tu computadora:
adb shell perfetto -c - --txt -o /data/misc/perfetto-traces/page_advice.perfetto-trace <<EOF
buffers: {
    size_kb: 65536
    fill_policy: RING_BUFFER
}
data_sources: {
    config {
        name: "linux.process_stats"
        process_stats_config {
            scan_all_processes_on_start: true
            proc_stats_poll_ms: 100
        }
    }
}
data_sources: {
    config {
        name: "linux.ftrace"
        ftrace_config {
            ftrace_events: "kmem/rss_stat"
            ftrace_events: "filemap/mm_filemap_add_to_page_cache"
            ftrace_events: "filemap/mm_filemap_delete_from_page_cache"
        }
    }
}
duration_ms: 20000
EOF
adb pull /data/misc/perfetto-traces/page_advice.perfetto-trace
Inspecciona pistas en la IU de Perfetto
Abre el registro en la IU de Perfetto, expande el grupo de procesos de tu app y fija las siguientes pistas de contadores para que permanezcan en la parte superior de la línea de tiempo:
mem.virt: Se mantiene estable en las llamadas aMADV_DONTNEED, lo que confirma que la reserva de dirección virtual (mmap) no cambia.mem.rss.anon: Disminuye de forma abrupta en la marca de tiempo exacta en la que tu app llama amadviseconMADV_DONTNEEDen arenas anónimas sucias o regiones del montón.mem.rss.file: Disminuye cuando tu app llama amadviseconMADV_DONTNEEDen una región demmaprespaldada por archivos, acompañada de una ráfaga de eventos ftrace demm_filemap_delete_from_page_cachecuandoposix_fadviseconPOSIX_FADV_DONTNEEDexpulsa las páginas limpias de la caché de páginas.mem.swap: Se descarta cuandoMADV_DONTNEEDdescarta páginas anónimas que se habían comprimido previamente en ZRAM.
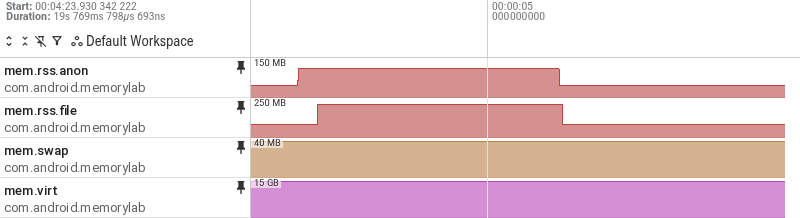
En la figura 2, se muestran estas pistas para la app de ejemplo de MemoryLab. Para explorar la misma vista, abre el registro de ejemplo en la IU de Perfetto.
Consulta el uso máximo y final de memoria con PerfettoSQL
Ejecuta la siguiente consulta de PerfettoSQL en la IU de Perfetto (pestaña Query (SQL)) para comparar los valores máximos y finales de mem.virt, mem.rss.anon, mem.rss.file y mem.swap para tu proceso de destino:
WITH counters AS (
  SELECT t.name AS counter_name, c.ts, c.value
  FROM counter c
  JOIN process_counter_track t ON c.track_id = t.id
  JOIN process p USING (upid)
  WHERE p.name = 'com.example.app'
    AND t.name IN ('mem.virt', 'mem.rss.anon', 'mem.rss.file', 'mem.swap')
)
SELECT
  counter_name,
  CAST(MAX(value) / 1048576 AS INT) AS peak_mb,
  CAST((
    SELECT value FROM counters AS last
    WHERE last.counter_name = counters.counter_name
    ORDER BY ts DESC LIMIT 1
  ) / 1048576 AS INT) AS final_mb
FROM counters
GROUP BY counter_name
ORDER BY counter_name;
Resultado de muestra para el seguimiento de la Figura 2:
counter_name  peak_mb  final_mb
mem.rss.anon      111        48
mem.rss.file      212        84
mem.swap           36        36
mem.virt        13952     13952
mem.rss.anon disminuye en 63 MB y mem.rss.file disminuye en 128 MB desde sus picos, mientras que mem.virt termina en su pico porque las reservas virtuales no se modifican.
Cómo resolver páginas expulsadas a archivos
Los eventos mm_filemap_add_to_page_cache y mm_filemap_delete_from_page_cache
identifican los archivos por número de inodo (i_ino) en lugar de por ruta de acceso. Para confirmar
que las páginas expulsadas pertenecen al archivo que indicaste, cuenta las expulsiones por
inodo:
SELECT
  EXTRACT_ARG(arg_set_id, 'i_ino') AS inode,
  COUNT(*) AS evicted_pages
FROM ftrace_event
WHERE name = 'mm_filemap_delete_from_page_cache'
GROUP BY inode
ORDER BY evicted_pages DESC
LIMIT 5;
Resultado de muestra para el seguimiento de la Figura 2:
inode     evicted_pages
9761              35781
76792192            767
126                 668
0                   612
11587712            514
Mientras el dispositivo que grabó el seguimiento aún esté conectado, resuelve cada inodo en una ruta de acceso. Los números de inodo son únicos solo dentro de un sistema de archivos, por lo que debes limitar la búsqueda al sistema de archivos que contiene los datos de tu app:
INODE=<inode from the query>
adb shell "find /data -xdev -inum $INODE 2>/dev/null"
Resultado de ejemplo para el inodo 9761:
/data/user/0/com.android.memorylab/files/asset_pack.bin
/data/data/com.android.memorylab/files/asset_pack.bin
Ambas rutas de acceso hacen referencia al mismo archivo, ya que /data/user/0 y /data/data son dos nombres para el mismo directorio de datos de la app. El recuento de expulsiones del archivo de recursos (35,781 páginas) es mayor que el archivo en sí (32,768 páginas de 4 KB), ya que kswapd ya había expulsado parte del archivo bajo presión de memoria antes de que la app lo volviera a leer y llamara a posix_fadvise.
Para obtener una secuencia de comandos que resuelva muchos inodos a la vez, consulta Resuelve fallas en inodos y, luego, en archivos.
← Interacción entre kswapd y lmkd | ↑ Arriba | Proceso en segundo plano optimizado →