

Die Android Neural Networks API (NNAPI) ist eine Android-C-API, die für rechenintensive Vorgänge für maschinelles Lernen auf Android-Geräten entwickelt wurde. Die NNAPI bietet eine grundlegende Funktionalität für übergeordnete Frameworks für maschinelles Lernen wie TensorFlow Lite und Caffe2, mit denen neuronale Netzwerke erstellt und trainiert werden. Die API ist auf allen Android-Geräten mit Android 8.1 (API-Level 27) oder höher verfügbar, wurde aber in Android 15 eingestellt.
Die NNAPI unterstützt die Inferenz, indem Daten von Android-Geräten auf zuvor trainierte, vom Entwickler definierte Modelle angewendet werden. Beispiele für Inferenzen sind das Klassifizieren von Bildern, das Vorhersagen des Nutzerverhaltens und das Auswählen geeigneter Antworten auf eine Suchanfrage.
Die Inferenz auf dem Gerät bietet viele Vorteile:
- Latenz: Sie müssen keine Anfrage über eine Netzwerkverbindung senden und auf eine Antwort warten. Dies kann beispielsweise für Videoanwendungen, die aufeinanderfolgende Frames von einer Kamera verarbeiten, von entscheidender Bedeutung sein.
- Verfügbarkeit: Die Anwendung wird auch außerhalb der Netzwerkabdeckung ausgeführt.
- Geschwindigkeit: Neue Hardware, die speziell für die Verarbeitung neuronaler Netzwerke entwickelt wurde, bietet eine deutlich schnellere Berechnung als eine CPU für allgemeine Zwecke allein.
- Datenschutz: Die Daten bleiben auf dem Android-Gerät.
- Kosten: Es ist keine Serverfarm erforderlich, wenn alle Berechnungen auf dem Android-Gerät ausgeführt werden.
Es gibt auch einige Nachteile, die Entwickler berücksichtigen sollten:
- Systemauslastung: Die Auswertung neuronaler Netzwerke erfordert viel Rechenleistung, was den Akkuverbrauch erhöhen kann. Wenn der Akkuzustand für Ihre App ein Problem darstellt, sollten Sie ihn im Auge behalten, insbesondere bei lang andauernden Berechnungen.
- Anwendungsgröße: Achten Sie auf die Größe Ihrer Modelle. Modelle können mehrere Megabyte Speicherplatz belegen. Wenn das Einbinden großer Modelle in Ihr APK Ihre Nutzer übermäßig beeinträchtigen würde, sollten Sie die Modelle nach der App-Installation herunterladen, kleinere Modelle verwenden oder Ihre Berechnungen in der Cloud ausführen. Die NNAPI bietet keine Funktionen zum Ausführen von Modellen in der Cloud.
Ein Beispiel für die Verwendung der NNAPI finden Sie im Beispiel für die Android Neural Networks API.
Informationen zur Neural Networks API-Laufzeit
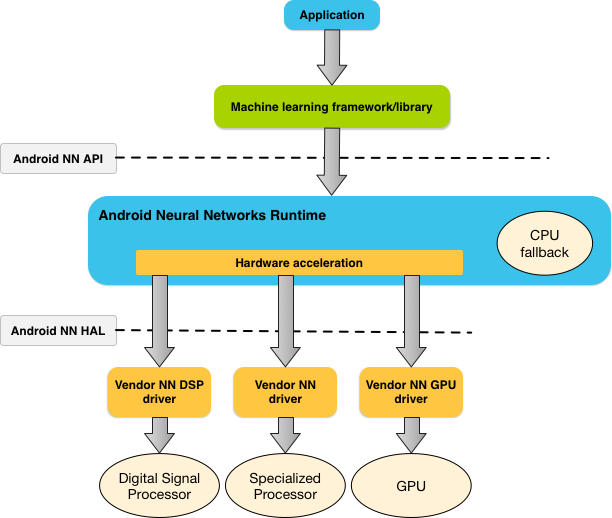
Die NNAPI ist für den Aufruf durch Bibliotheken, Frameworks und Tools für maschinelles Lernen gedacht, mit denen Entwickler ihre Modelle außerhalb des Geräts trainieren und auf Android-Geräten bereitstellen können. Apps verwenden die NNAPI in der Regel nicht direkt, sondern nutzen stattdessen übergeordnete Frameworks für maschinelles Lernen. Diese Frameworks können wiederum die NNAPI verwenden, um hardwarebeschleunigte Inferenzvorgänge auf unterstützten Geräten auszuführen.
Basierend auf den Anforderungen einer App und den Hardwarefunktionen eines Android-Geräts kann die Laufzeit des neuronalen Netzwerks von Android die Rechenlast effizient auf die verfügbaren On-Device-Prozessoren verteilen, einschließlich dedizierter Hardware für neuronale Netzwerke, Grafikprozessoren (GPUs) und digitaler Signalprozessoren (DSPs).
Bei Android-Geräten ohne speziellen Herstellertreiber führt die NNAPI-Laufzeit die Anfragen auf der CPU aus.
Abbildung 1 zeigt die allgemeine Systemarchitektur für die NNAPI.
Programmiermodell der Neural Networks API
Wenn Sie Berechnungen mit der NNAPI ausführen möchten, müssen Sie zuerst einen gerichteten Graphen erstellen, der die auszuführenden Berechnungen definiert. Dieser Berechnungsgraf bildet zusammen mit Ihren Eingabedaten (z. B. den Gewichtungen und Verzerrungen, die von einem Framework für maschinelles Lernen übergeben werden) das Modell für die NNAPI-Laufzeitbewertung.
Die NNAPI verwendet vier Hauptabstraktionen:
- Modell: Ein Berechnungsgraph mathematischer Operationen und der konstanten Werte, die durch einen Trainingsprozess gelernt wurden. Diese Vorgänge sind spezifisch für neuronale Netzwerke. Dazu gehören die zweidimensionale (2D) Faltung, die logistische (Sigmoid) Aktivierung, die rektifizierte lineare (ReLU) Aktivierung und mehr. Das Erstellen eines Modells ist ein synchroner Vorgang.
Nachdem sie erstellt wurde, kann sie in verschiedenen Threads und Kompilationen wiederverwendet werden.
In der NNAPI wird ein Modell als
ANeuralNetworksModel-Instanz dargestellt. - Kompilierung: Stellt eine Konfiguration zum Kompilieren eines NNAPI-Modells in Code auf niedrigerer Ebene dar. Das Erstellen einer Kompilierung ist ein synchroner Vorgang. Nachdem sie erstellt wurde, kann sie in verschiedenen Threads und Ausführungen wiederverwendet werden. In der NNAPI wird jede Kompilierung als
ANeuralNetworksCompilation-Instanz dargestellt. - Arbeitsspeicher: Stellt den gemeinsamen Arbeitsspeicher, im Arbeitsspeicher abgebildete Dateien und ähnliche Arbeitsspeicherpuffer dar. Durch die Verwendung eines Arbeitsspeicherpuffers kann die NNAPI-Laufzeit Daten effizienter an Treiber übertragen. Eine App erstellt in der Regel einen gemeinsam genutzten Speicherpuffer, der alle Tensoren enthält, die zum Definieren eines Modells erforderlich sind. Sie können auch Arbeitsspeicherpuffer verwenden, um die Eingaben und Ausgaben für eine Ausführungsinstanz zu speichern. In der NNAPI wird jeder Arbeitsspeicherpuffer als
ANeuralNetworksMemory-Instanz dargestellt. Ausführung: Schnittstelle zum Anwenden eines NNAPI-Modells auf eine Reihe von Eingaben und zum Erfassen der Ergebnisse. Die Ausführung kann synchron oder asynchron erfolgen.
Bei der asynchronen Ausführung können mehrere Threads auf dieselbe Ausführung warten. Wenn diese Ausführung abgeschlossen ist, werden alle Threads freigegeben.
In der NNAPI wird jede Ausführung als
ANeuralNetworksExecution-Instanz dargestellt.
Abbildung 2 zeigt den grundlegenden Programmierablauf.
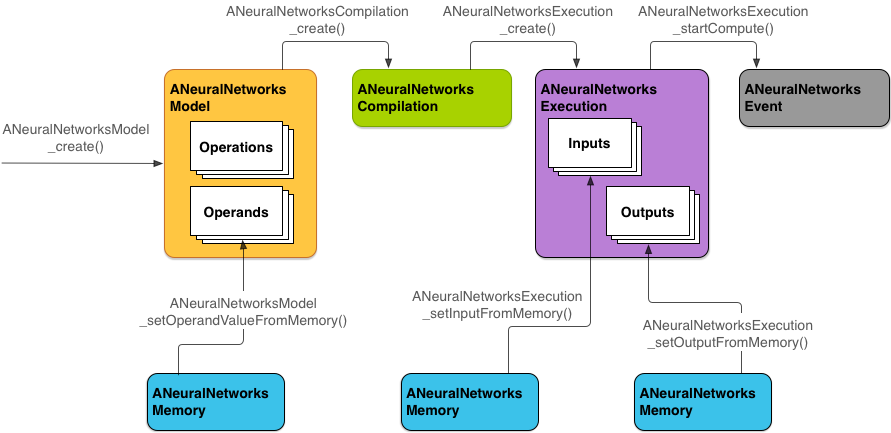
Im Rest dieses Abschnitts werden die Schritte zum Einrichten des NNAPI-Modells für die Berechnung, zum Kompilieren des Modells und zum Ausführen des kompilierten Modells beschrieben.
Zugriff auf Trainingsdaten gewähren
Ihre trainierten Gewichtungen und Bias-Daten sind wahrscheinlich in einer Datei gespeichert. Damit die NNAPI-Laufzeit effizient auf diese Daten zugreifen kann, erstellen Sie eine ANeuralNetworksMemory-Instanz. Rufen Sie dazu die Funktion ANeuralNetworksMemory_createFromFd() auf und übergeben Sie den Dateideskriptor der geöffneten Datendatei. Außerdem geben Sie Speicherschutz-Flags und einen Offset an, an dem der freigegebene Speicherbereich in der Datei beginnt.
// Create a memory buffer from the file that contains the trained data
ANeuralNetworksMemory* mem1 = NULL;
int fd = open("training_data", O_RDONLY);
ANeuralNetworksMemory_createFromFd(file_size, PROT_READ, fd, 0, &mem1);
In diesem Beispiel verwenden wir zwar nur eine ANeuralNetworksMemory-Instanz für alle unsere Gewichtungen, es ist jedoch möglich, mehrere ANeuralNetworksMemory-Instanzen für mehrere Dateien zu verwenden.
Native Hardwarepuffer verwenden
Sie können native Hardwarepuffer für Modelleingaben, ‑ausgaben und konstante Operandenwerte verwenden. In bestimmten Fällen kann ein NNAPI-Beschleuniger auf AHardwareBuffer-Objekte zugreifen, ohne dass der Treiber die Daten kopieren muss. AHardwareBuffer hat viele verschiedene Konfigurationen und nicht jeder NNAPI-Beschleuniger unterstützt alle diese Konfigurationen. Aufgrund dieser Einschränkung sollten Sie die in der Referenzdokumentation zu ANeuralNetworksMemory_createFromAHardwareBuffer aufgeführten Einschränkungen beachten und vorab auf Zielgeräten testen, ob Kompilierungen und Ausführungen, die AHardwareBuffer verwenden, wie erwartet funktionieren. Verwenden Sie dazu die Gerätezuweisung, um den Beschleuniger anzugeben.
Damit die NNAPI-Laufzeit auf ein AHardwareBuffer-Objekt zugreifen kann, erstellen Sie eine ANeuralNetworksMemory-Instanz. Rufen Sie dazu die Funktion ANeuralNetworksMemory_createFromAHardwareBuffer auf und übergeben Sie das AHardwareBuffer-Objekt, wie im folgenden Codebeispiel gezeigt:
// Configure and create AHardwareBuffer object
AHardwareBuffer_Desc desc = ...
AHardwareBuffer* ahwb = nullptr;
AHardwareBuffer_allocate(&desc, &ahwb);

// Create ANeuralNetworksMemory from AHardwareBuffer
ANeuralNetworksMemory* mem2 = NULL;
ANeuralNetworksMemory_createFromAHardwareBuffer(ahwb, &mem2);
Wenn NNAPI nicht mehr auf das AHardwareBuffer-Objekt zugreifen muss, wird die entsprechende ANeuralNetworksMemory-Instanz freigegeben:
ANeuralNetworksMemory_free(mem2);
Hinweis:
- Sie können
AHardwareBuffernur für den gesamten Puffer verwenden. Sie können es nicht mit einemARect-Parameter verwenden. - Die NNAPI-Laufzeit leert den Zwischenspeicher nicht. Sie müssen dafür sorgen, dass die Eingabe- und Ausgabepuffer zugänglich sind, bevor Sie die Ausführung planen.
- Dateideskriptoren für Synchronisierungs-Fences werden nicht unterstützt.
- Bei einem
AHardwareBuffermit anbieterspezifischen Formaten und Nutzungsbits ist es Sache der Anbieterimplementierung, zu bestimmen, ob der Client oder der Treiber für das Leeren des Caches verantwortlich ist.
Modell
Ein Modell ist die grundlegende Berechnungseinheit in der NNAPI. Jedes Modell wird durch einen oder mehrere Operanden und Vorgänge definiert.
Operanden
Operanden sind Datenobjekte, die zum Definieren des Graphen verwendet werden. Dazu gehören die Ein- und Ausgaben des Modells, die Zwischenknoten, die die Daten enthalten, die von einem Vorgang zum anderen fließen, und die Konstanten, die an diese Vorgänge übergeben werden.
Es gibt zwei Arten von Operanden, die NNAPI-Modellen hinzugefügt werden können: Skalare und Tensoren.
Ein Skalar stellt einen einzelnen Wert dar. NNAPI unterstützt skalare Werte in den Formaten boolesch, 16-Bit-Gleitkommazahl, 32-Bit-Gleitkommazahl, 32-Bit-Ganzzahl und vorzeichenlose 32-Bit-Ganzzahl.
Die meisten Vorgänge in der NNAPI umfassen Tensoren. Tensoren sind n-dimensionale Arrays. NNAPI unterstützt Tensoren mit 16-Bit-Gleitkomma-, 32-Bit-Gleitkomma-, 8-Bit-quantisierten, 16-Bit-quantisierten, 32-Bit-Ganzzahl- und 8-Bit-booleschen Werten.
Abbildung 3 zeigt beispielsweise ein Modell mit zwei Vorgängen: einer Addition, gefolgt von einer Multiplikation. Das Modell nimmt einen Eingabetensor und erzeugt einen Ausgabetensor.
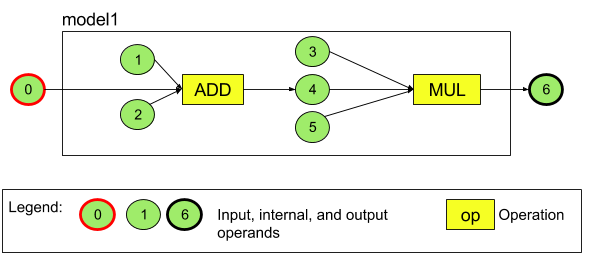
Das Modell oben hat sieben Operanden. Diese Operanden werden implizit durch den Index der Reihenfolge identifiziert, in der sie dem Modell hinzugefügt werden. Der erste hinzugefügte Operand hat den Index 0, der zweite den Index 1 usw. Die Operanden 1, 2, 3 und 5 sind konstante Operanden.
Die Reihenfolge, in der Sie die Operanden hinzufügen, spielt keine Rolle. Der Operand für die Modellausgabe könnte beispielsweise der erste hinzugefügte Operand sein. Wichtig ist, dass Sie den richtigen Indexwert verwenden, wenn Sie auf einen Operanden verweisen.
Operanden haben Typen. Diese werden angegeben, wenn sie dem Modell hinzugefügt werden.
Ein Operand kann nicht sowohl als Eingabe als auch als Ausgabe eines Modells verwendet werden.
Jeder Operand muss entweder eine Modelleingabe, eine Konstante oder der Ausgabeoperand von genau einem Vorgang sein.
Weitere Informationen zur Verwendung von Operanden finden Sie unter Weitere Informationen zu Operanden.
Vorgänge
Ein Vorgang gibt die auszuführenden Berechnungen an. Jeder Vorgang besteht aus den folgenden Elementen:
- einen Vorgangstyp (z. B. Addition, Multiplikation, Faltung),
- eine Liste der Indexe der Operanden, die der Vorgang für die Eingabe verwendet, und
- Eine Liste der Indexe der Operanden, die der Vorgang für die Ausgabe verwendet.
Die Reihenfolge in diesen Listen ist wichtig. Die erwarteten Ein- und Ausgaben für jeden Vorgangstyp finden Sie in der NNAPI API-Referenz.
Sie müssen die Operanden, die ein Vorgang verbraucht oder erzeugt, dem Modell hinzufügen, bevor Sie den Vorgang hinzufügen.
Die Reihenfolge, in der Sie Vorgänge hinzufügen, spielt keine Rolle. Die NNAPI verwendet die Abhängigkeiten, die durch das Berechnungsdiagramm von Operanden und Vorgängen festgelegt werden, um die Reihenfolge zu bestimmen, in der Vorgänge ausgeführt werden.
Die von der NNAPI unterstützten Vorgänge sind in der folgenden Tabelle zusammengefasst:
Bekanntes Problem in API-Level 28: Wenn ANEURALNETWORKS_TENSOR_QUANT8_ASYMM-Tensoren an den ANEURALNETWORKS_PAD-Vorgang übergeben werden, der unter Android 9 (API-Level 28) und höher verfügbar ist, stimmt die Ausgabe von NNAPI möglicherweise nicht mit der Ausgabe von übergeordneten Frameworks für maschinelles Lernen wie TensorFlow Lite überein. Stattdessen sollten Sie nur ANEURALNETWORKS_TENSOR_FLOAT32 übergeben.
Das Problem wurde in Android 10 (API-Level 29) und höher behoben.
Modelle erstellen
Im folgenden Beispiel erstellen wir das Modell mit zwei Vorgängen aus Abbildung 3.
So erstellen Sie das Modell:
Rufen Sie die Funktion
ANeuralNetworksModel_create()auf, um ein leeres Modell zu definieren.ANeuralNetworksModel* model = NULL; ANeuralNetworksModel_create(&model);
Fügen Sie die Operanden Ihrem Modell hinzu, indem Sie
ANeuralNetworks_addOperand()aufrufen. Ihre Datentypen werden mit der DatenstrukturANeuralNetworksOperandTypedefiniert.// In our example, all our tensors are matrices of dimension [3][4] ANeuralNetworksOperandType tensor3x4Type; tensor3x4Type.type = ANEURALNETWORKS_TENSOR_FLOAT32; tensor3x4Type.scale = 0.f; // These fields are used for quantized tensors tensor3x4Type.zeroPoint = 0; // These fields are used for quantized tensors tensor3x4Type.dimensionCount = 2; uint32_t dims[2] = {3, 4}; tensor3x4Type.dimensions = dims;
// We also specify operands that are activation function specifiers ANeuralNetworksOperandType activationType; activationType.type = ANEURALNETWORKS_INT32; activationType.scale = 0.f; activationType.zeroPoint = 0; activationType.dimensionCount = 0; activationType.dimensions = NULL;
// Now we add the seven operands, in the same order defined in the diagram ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 0 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 1 ANeuralNetworksModel_addOperand(model, &activationType); // operand 2 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 3 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 4 ANeuralNetworksModel_addOperand(model, &activationType); // operand 5 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 6Verwenden Sie für Operanden mit konstanten Werten, z. B. Gewichtungen und Biases, die Ihre Anwendung aus einem Trainingsprozess erhält, die Funktionen
ANeuralNetworksModel_setOperandValue()undANeuralNetworksModel_setOperandValueFromMemory().Im folgenden Beispiel legen wir konstante Werte aus der Trainingsdatendatei fest, die dem Arbeitsspeicherpuffer entsprechen, den wir unter Zugriff auf Trainingsdaten gewähren erstellt haben.
// In our example, operands 1 and 3 are constant tensors whose values were
// established during the training process
const int sizeOfTensor = 3 * 4 * 4;    // The formula for size calculation is dim0 * dim1 * elementSize
ANeuralNetworksModel_setOperandValueFromMemory(model, 1, mem1, 0, sizeOfTensor);
ANeuralNetworksModel_setOperandValueFromMemory(model, 3, mem1, sizeOfTensor, sizeOfTensor);


// We set the values of the activation operands, in our example operands 2 and 5
int32_t noneValue = ANEURALNETWORKS_FUSED_NONE;
ANeuralNetworksModel_setOperandValue(model, 2, &noneValue, sizeof(noneValue));
ANeuralNetworksModel_setOperandValue(model, 5, &noneValue, sizeof(noneValue));
Fügen Sie für jeden Vorgang im gerichteten Graphen, den Sie berechnen möchten, den Vorgang Ihrem Modell hinzu, indem Sie die Funktion
ANeuralNetworksModel_addOperation()aufrufen.Ihre App muss für diesen Aufruf die folgenden Parameter angeben:
- den Vorgangstyp
- die Anzahl der Eingabewerte
- das Array der Indexe für Eingabeoperanden
- die Anzahl der Ausgabewerte
- das Array der Indexe für Ausgabeoperanden
Ein Operand kann nicht sowohl für die Eingabe als auch für die Ausgabe desselben Vorgangs verwendet werden.
// We have two operations in our example
// The first consumes operands 1, 0, 2, and produces operand 4
uint32_t addInputIndexes[3] = {1, 0, 2};
uint32_t addOutputIndexes[1] = {4};
ANeuralNetworksModel_addOperation(model, ANEURALNETWORKS_ADD, 3, addInputIndexes, 1, addOutputIndexes);


// The second consumes operands 3, 4, 5, and produces operand 6
uint32_t multInputIndexes[3] = {3, 4, 5};
uint32_t multOutputIndexes[1] = {6};
ANeuralNetworksModel_addOperation(model, ANEURALNETWORKS_MUL, 3, multInputIndexes, 1, multOutputIndexes);
Rufen Sie die Funktion
ANeuralNetworksModel_identifyInputsAndOutputs()auf, um festzulegen, welche Operanden das Modell als Eingaben und Ausgaben behandeln soll.// Our model has one input (0) and one output (6) uint32_t modelInputIndexes[1] = {0}; uint32_t modelOutputIndexes[1] = {6}; ANeuralNetworksModel_identifyInputsAndOutputs(model, 1, modelInputIndexes, 1 modelOutputIndexes);
Optional können Sie angeben, ob
ANEURALNETWORKS_TENSOR_FLOAT32mit einem Bereich oder einer Genauigkeit berechnet werden darf, die so niedrig ist wie die des IEEE 754-16-Bit-Gleitkommaformats. Rufen Sie dazuANeuralNetworksModel_relaxComputationFloat32toFloat16()auf.Rufen Sie
ANeuralNetworksModel_finish()auf, um die Definition des Modells abzuschließen. Wenn keine Fehler auftreten, gibt diese Funktion den ErgebniscodeANEURALNETWORKS_NO_ERRORzurück.ANeuralNetworksModel_finish(model);
Nachdem Sie ein Modell erstellt haben, können Sie es beliebig oft kompilieren und jede Kompilierung beliebig oft ausführen.
Kontrollfluss
So binden Sie den Kontrollfluss in ein NNAPI-Modell ein:
Erstellen Sie die entsprechenden Ausführungs-Untergraphen (
then- undelse-Untergraphen für eineIF-Anweisung,condition- undbody-Untergraphen für eineWHILE-Schleife) als eigenständigeANeuralNetworksModel*-Modelle:ANeuralNetworksModel* thenModel = makeThenModel(); ANeuralNetworksModel* elseModel = makeElseModel();
Erstellen Sie Operanden, die auf diese Modelle innerhalb des Modells verweisen, das den Kontrollfluss enthält:
ANeuralNetworksOperandType modelType = {
    .type = ANEURALNETWORKS_MODEL,
};
ANeuralNetworksModel_addOperand(model, &modelType);  // kThenOperandIndex
ANeuralNetworksModel_addOperand(model, &modelType);  // kElseOperandIndex
ANeuralNetworksModel_setOperandValueFromModel(model, kThenOperandIndex, &thenModel);
ANeuralNetworksModel_setOperandValueFromModel(model, kElseOperandIndex, &elseModel);
Fügen Sie den Kontrollflussvorgang hinzu:
uint32_t inputs[] = {kConditionOperandIndex,
                     kThenOperandIndex,
                     kElseOperandIndex,
                     kInput1, kInput2, kInput3};
uint32_t outputs[] = {kOutput1, kOutput2};
ANeuralNetworksModel_addOperation(model, ANEURALNETWORKS_IF,
                                  std::size(inputs), inputs,
                                  std::size(output), outputs);
Compilation
Im Kompilierungsschritt wird festgelegt, auf welchen Prozessoren Ihr Modell ausgeführt wird, und die entsprechenden Treiber werden aufgefordert, sich auf die Ausführung vorzubereiten. Dazu kann die Generierung von Maschinencode gehören, der für die Prozessoren spezifisch ist, auf denen Ihr Modell ausgeführt wird.
So kompilieren Sie ein Modell:
Rufen Sie die Funktion
ANeuralNetworksCompilation_create()auf, um eine neue Kompilierungsinstanz zu erstellen.// Compile the model ANeuralNetworksCompilation* compilation; ANeuralNetworksCompilation_create(model, &compilation);
Optional können Sie die Gerätezuweisung verwenden, um explizit auszuwählen, auf welchen Geräten die Ausführung erfolgen soll.
Sie können optional beeinflussen, wie die Laufzeit zwischen Akkuverbrauch und Ausführungsgeschwindigkeit abwägt. Rufen Sie dazu
ANeuralNetworksCompilation_setPreference()auf.// Ask to optimize for low power consumption ANeuralNetworksCompilation_setPreference(compilation, ANEURALNETWORKS_PREFER_LOW_POWER);
Sie können unter anderem folgende Einstellungen festlegen:
ANEURALNETWORKS_PREFER_LOW_POWER: Die Ausführung sollte so erfolgen, dass der Akkuverbrauch minimiert wird. Dies ist für Kompilierungen, die häufig ausgeführt werden, wünschenswert.ANEURALNETWORKS_PREFER_FAST_SINGLE_ANSWER: Es wird bevorzugt, so schnell wie möglich eine einzelne Antwort zurückzugeben, auch wenn dies zu einem höheren Stromverbrauch führt. Das ist die Standardeinstellung.ANEURALNETWORKS_PREFER_SUSTAINED_SPEED: Bevorzugt die Maximierung des Durchsatzes aufeinanderfolgender Frames, z. B. bei der Verarbeitung aufeinanderfolgender Frames, die von der Kamera stammen.
Optional können Sie das Kompilierungs-Caching einrichten, indem Sie
ANeuralNetworksCompilation_setCachingaufrufen.// Set up compilation caching ANeuralNetworksCompilation_setCaching(compilation, cacheDir, token);
Verwenden Sie
getCodeCacheDir()fürcacheDir. Die angegebenetokenmuss für jedes Modell innerhalb der Anwendung eindeutig sein.Schließen Sie die Kompilierungsdefinition ab, indem Sie
ANeuralNetworksCompilation_finish()aufrufen. Wenn keine Fehler auftreten, gibt diese Funktion den ErgebniscodeANEURALNETWORKS_NO_ERRORzurück.ANeuralNetworksCompilation_finish(compilation);
Geräteerkennung und -zuweisung
Auf Android-Geräten mit Android 10 (API-Level 29) und höher bietet die NNAPI Funktionen, mit denen Bibliotheken und Apps für Frameworks für maschinelles Lernen Informationen zu den verfügbaren Geräten abrufen und Geräte für die Ausführung angeben können. Durch die Bereitstellung von Informationen zu den verfügbaren Geräten können Apps die genaue Version der auf einem Gerät gefundenen Treiber abrufen, um bekannte Inkompatibilitäten zu vermeiden. Wenn Apps die Möglichkeit haben, anzugeben, welche Geräte verschiedene Abschnitte eines Modells ausführen sollen, können sie für das Android-Gerät optimiert werden, auf dem sie bereitgestellt werden.
Geräteerkennung
Verwenden Sie ANeuralNetworks_getDeviceCount, um die Anzahl der verfügbaren Geräte abzurufen. Verwenden Sie für jedes Gerät ANeuralNetworks_getDevice, um eine ANeuralNetworksDevice-Instanz auf einen Verweis auf dieses Gerät festzulegen.
Sobald Sie eine Gerätereferenz haben, können Sie mit den folgenden Funktionen zusätzliche Informationen zu diesem Gerät abrufen:
ANeuralNetworksDevice_getFeatureLevelANeuralNetworksDevice_getNameANeuralNetworksDevice_getTypeANeuralNetworksDevice_getVersion
Gerätezuweisung
Mit ANeuralNetworksModel_getSupportedOperationsForDevices können Sie herausfinden, welche Vorgänge eines Modells auf bestimmten Geräten ausgeführt werden können.
Wenn Sie festlegen möchten, welche Beschleuniger für die Ausführung verwendet werden sollen, rufen Sie ANeuralNetworksCompilation_createForDevices anstelle von ANeuralNetworksCompilation_create auf.
Verwenden Sie das resultierende ANeuralNetworksCompilation-Objekt wie gewohnt.
Die Funktion gibt einen Fehler zurück, wenn das bereitgestellte Modell Vorgänge enthält, die von den ausgewählten Geräten nicht unterstützt werden.
Wenn mehrere Geräte angegeben sind, ist die Laufzeit für die Verteilung der Arbeit auf die Geräte verantwortlich.
Ähnlich wie bei anderen Geräten wird die NNAPI-CPU-Implementierung durch ein ANeuralNetworksDevice mit dem Namen nnapi-reference und dem Typ ANEURALNETWORKS_DEVICE_TYPE_CPU dargestellt. Beim Aufrufen von ANeuralNetworksCompilation_createForDevices wird die CPU-Implementierung nicht verwendet, um die Fehlerfälle für die Modellkompilierung und -ausführung zu verarbeiten.
Es liegt in der Verantwortung einer Anwendung, ein Modell in Untermodelle zu partitionieren, die auf den angegebenen Geräten ausgeführt werden können. Anwendungen, die keine manuelle Partitionierung erfordern, sollten weiterhin die einfachere ANeuralNetworksCompilation_create aufrufen, um alle verfügbaren Geräte (einschließlich der CPU) zur Beschleunigung des Modells zu verwenden. Wenn das Modell von den mit ANeuralNetworksCompilation_createForDevices angegebenen Geräten nicht vollständig unterstützt werden kann, wird ANEURALNETWORKS_BAD_DATA zurückgegeben.
Modellpartitionierung
Wenn mehrere Geräte für das Modell verfügbar sind, verteilt die NNAPI-Laufzeit die Arbeit auf die Geräte. Wenn beispielsweise mehr als ein Gerät für ANeuralNetworksCompilation_createForDevices angegeben wurde, werden alle angegebenen Geräte bei der Zuweisung der Arbeit berücksichtigt. Wenn das CPU-Gerät nicht in der Liste enthalten ist, wird die CPU-Ausführung deaktiviert. Wenn Sie ANeuralNetworksCompilation_create verwenden, werden alle verfügbaren Geräte berücksichtigt, einschließlich der CPU.
Die Verteilung erfolgt, indem für jeden Vorgang im Modell aus der Liste der verfügbaren Geräte das Gerät ausgewählt wird, das den Vorgang unterstützt und die beste Leistung bietet, d.h. die schnellste Ausführungszeit oder den niedrigsten Stromverbrauch, je nach der vom Client angegebenen Ausführungspräferenz. Dieser Partitionierungsalgorithmus berücksichtigt keine möglichen Ineffizienzen, die durch die E/A zwischen den verschiedenen Prozessoren verursacht werden. Wenn Sie also mehrere Prozessoren angeben (entweder explizit mit ANeuralNetworksCompilation_createForDevices oder implizit mit ANeuralNetworksCompilation_create), ist es wichtig, ein Profil der resultierenden Anwendung zu erstellen.
Wenn Sie wissen möchten, wie Ihr Modell von NNAPI partitioniert wurde, suchen Sie in den Android-Logs nach einer Nachricht (auf INFO-Ebene mit dem Tag ExecutionPlan):
ModelBuilder::findBestDeviceForEachOperation(op-name): device-index
op-name ist der beschreibende Name des Vorgangs im Diagramm und device-index ist der Index des Kandidatengeräts in der Liste der Geräte.
Diese Liste ist die Eingabe für ANeuralNetworksCompilation_createForDevices oder, wenn Sie ANeuralNetworksCompilation_createForDevices verwenden, die Liste der Geräte, die zurückgegeben wird, wenn Sie mit ANeuralNetworks_getDeviceCount und ANeuralNetworks_getDevice alle Geräte durchgehen.
Die Nachricht (auf INFO-Ebene mit dem Tag ExecutionPlan):
ModelBuilder::partitionTheWork: only one best device: device-name
Diese Meldung weist darauf hin, dass der gesamte Graph auf dem Gerät device-name beschleunigt wurde.
Ausführung
Im Ausführungsschritt wird das Modell auf eine Reihe von Eingaben angewendet und die Berechnungsausgaben werden in einem oder mehreren Nutzerpuffern oder Speicherbereichen gespeichert, die von Ihrer App zugewiesen wurden.
So führen Sie ein kompiliertes Modell aus:
Rufen Sie die Funktion
ANeuralNetworksExecution_create()auf, um eine neue Ausführungsinstanz zu erstellen.// Run the compiled model against a set of inputs ANeuralNetworksExecution* run1 = NULL; ANeuralNetworksExecution_create(compilation, &run1);
Geben Sie an, wo Ihre Anwendung die Eingabewerte für die Berechnung liest. Ihre App kann Eingabewerte entweder aus einem Nutzerpuffer oder einem zugewiesenen Speicherplatz lesen, indem sie
ANeuralNetworksExecution_setInput()bzw.ANeuralNetworksExecution_setInputFromMemory()aufruft.// Set the single input to our sample model. Since it is small, we won't use a memory buffer float32 myInput[3][4] = { ...the data... }; ANeuralNetworksExecution_setInput(run1, 0, NULL, myInput, sizeof(myInput));
Geben Sie an, wo Ihre Anwendung die Ausgabewerte schreibt. Ihre App kann Ausgabewerte entweder in einen Nutzerpuffer oder in einen zugewiesenen Speicherbereich schreiben, indem sie
ANeuralNetworksExecution_setOutput()bzw.ANeuralNetworksExecution_setOutputFromMemory()aufruft.// Set the output float32 myOutput[3][4]; ANeuralNetworksExecution_setOutput(run1, 0, NULL, myOutput, sizeof(myOutput));
Planen Sie den Start der Ausführung, indem Sie die Funktion
ANeuralNetworksExecution_startCompute()aufrufen. Wenn keine Fehler auftreten, gibt diese Funktion den ErgebniscodeANEURALNETWORKS_NO_ERRORzurück.// Starts the work. The work proceeds asynchronously ANeuralNetworksEvent* run1_end = NULL; ANeuralNetworksExecution_startCompute(run1, &run1_end);
Rufen Sie die Funktion
ANeuralNetworksEvent_wait()auf, um auf den Abschluss der Ausführung zu warten. Wenn die Ausführung erfolgreich war, gibt diese Funktion den ErgebniscodeANEURALNETWORKS_NO_ERRORzurück. Das Warten kann in einem anderen Thread als dem, der die Ausführung startet, erfolgen.// For our example, we have no other work to do and will just wait for the completion ANeuralNetworksEvent_wait(run1_end); ANeuralNetworksEvent_free(run1_end); ANeuralNetworksExecution_free(run1);
Optional können Sie eine andere Gruppe von Eingaben auf das kompilierte Modell anwenden, indem Sie dieselbe Kompilierungsinstanz verwenden, um eine neue
ANeuralNetworksExecution-Instanz zu erstellen.// Apply the compiled model to a different set of inputs ANeuralNetworksExecution* run2; ANeuralNetworksExecution_create(compilation, &run2); ANeuralNetworksExecution_setInput(run2, ...); ANeuralNetworksExecution_setOutput(run2, ...); ANeuralNetworksEvent* run2_end = NULL; ANeuralNetworksExecution_startCompute(run2, &run2_end); ANeuralNetworksEvent_wait(run2_end); ANeuralNetworksEvent_free(run2_end); ANeuralNetworksExecution_free(run2);
Synchrone Ausführung
Bei der asynchronen Ausführung wird Zeit für das Erstellen und Synchronisieren von Threads aufgewendet. Darüber hinaus kann die Latenz stark variieren. Die längsten Verzögerungen können bis zu 500 Mikrosekunden zwischen dem Zeitpunkt, an dem ein Thread benachrichtigt oder geweckt wird, und dem Zeitpunkt, an dem er schließlich an einen CPU-Kern gebunden wird, betragen.
Um die Latenz zu verbessern, können Sie stattdessen eine Anwendung anweisen, einen synchronen Inferenzaufruf an die Laufzeit zu senden. Dieser Aufruf wird erst zurückgegeben, wenn eine Inferenz abgeschlossen ist, und nicht, wenn eine Inferenz gestartet wurde. Anstatt ANeuralNetworksExecution_startCompute für einen asynchronen Inferenzaufruf an die Laufzeit aufzurufen, ruft die Anwendung ANeuralNetworksExecution_compute auf, um einen synchronen Aufruf an die Laufzeit zu senden. Ein Aufruf von ANeuralNetworksExecution_compute akzeptiert kein ANeuralNetworksEvent und ist nicht mit einem Aufruf von ANeuralNetworksEvent_wait gekoppelt.
Burst-Ausführungen
Auf Android-Geräten mit Android 10 (API-Level 29) und höher unterstützt die NNAPI Burst-Ausführungen über das Objekt ANeuralNetworksBurst. Burst-Ausführungen sind eine Abfolge von Ausführungen derselben Kompilierung, die in schneller Folge auftreten, z. B. bei der Verarbeitung von Frames einer Kameraaufnahme oder aufeinanderfolgenden Audio-Samples. Die Verwendung von ANeuralNetworksBurst-Objekten kann zu schnelleren Ausführungen führen, da sie Beschleunigern signalisieren, dass Ressourcen zwischen Ausführungen wiederverwendet werden können und dass Beschleuniger während des Bursts in einem Hochleistungszustand bleiben sollten.
ANeuralNetworksBurst führt nur eine kleine Änderung im normalen Ausführungspfad ein. Sie erstellen ein Burst-Objekt mit ANeuralNetworksBurst_create, wie im folgenden Code-Snippet gezeigt:
// Create burst object to be reused across a sequence of executions
ANeuralNetworksBurst* burst = NULL;
ANeuralNetworksBurst_create(compilation, &burst);
Burst-Ausführungen sind synchron. Anstatt jedoch ANeuralNetworksExecution_compute für jede Inferenz zu verwenden, koppeln Sie die verschiedenen ANeuralNetworksExecution-Objekte mit demselben ANeuralNetworksBurst in Aufrufen der Funktion ANeuralNetworksExecution_burstCompute.
// Create and configure first execution object
// ...

// Execute using the burst object
ANeuralNetworksExecution_burstCompute(execution1, burst);

// Use results of first execution and free the execution object
// ...

// Create and configure second execution object
// ...

// Execute using the same burst object
ANeuralNetworksExecution_burstCompute(execution2, burst);

// Use results of second execution and free the execution object
// ...
Das Objekt ANeuralNetworksBurst wird mit ANeuralNetworksBurst_free freigegeben, wenn es nicht mehr benötigt wird.
// Cleanup
ANeuralNetworksBurst_free(burst);
Asynchrone Befehlswarteschlangen und Fenced Execution
In Android 11 und höher unterstützt die NNAPI eine zusätzliche Möglichkeit, die asynchrone Ausführung über die Methode ANeuralNetworksExecution_startComputeWithDependencies() zu planen. Wenn Sie diese Methode verwenden, wartet die Ausführung, bis alle abhängigen Ereignisse signalisiert wurden, bevor die Auswertung gestartet wird. Sobald die Ausführung abgeschlossen ist und die Ausgaben bereit sind, wird das zurückgegebene Ereignis signalisiert.
Je nachdem, welche Geräte die Ausführung übernehmen, kann das Ereignis durch einen Synchronisierungs-Fence unterstützt werden. Sie müssen ANeuralNetworksEvent_wait() aufrufen, um auf das Ereignis zu warten und die von der Ausführung verwendeten Ressourcen wiederherzustellen. Sie können Synchronisierungs-Fences mit ANeuralNetworksEvent_createFromSyncFenceFd() in ein Ereignisobjekt importieren und mit ANeuralNetworksEvent_getSyncFenceFd() aus einem Ereignisobjekt exportieren.
Dynamisch dimensionierte Ausgaben
Wenn Sie Modelle unterstützen möchten, bei denen die Größe der Ausgabe von den Eingabedaten abhängt, d. h. die Größe kann nicht zum Zeitpunkt der Modellausführung bestimmt werden, verwenden Sie ANeuralNetworksExecution_getOutputOperandRank und ANeuralNetworksExecution_getOutputOperandDimensions.
Das folgende Codebeispiel zeigt, wie das geht:
// Get the rank of the output
uint32_t myOutputRank = 0;
ANeuralNetworksExecution_getOutputOperandRank(run1, 0, &myOutputRank);

// Get the dimensions of the output
std::vector<uint32_t> myOutputDimensions(myOutputRank);
ANeuralNetworksExecution_getOutputOperandDimensions(run1, 0, myOutputDimensions.data());
Bereinigen
Im Bereinigungsschritt werden die internen Ressourcen freigegeben, die für die Berechnung verwendet wurden.
// Cleanup
ANeuralNetworksCompilation_free(compilation);
ANeuralNetworksModel_free(model);
ANeuralNetworksMemory_free(mem1);
Fehlerverwaltung und CPU-Fallback
Wenn bei der Partitionierung ein Fehler auftritt, ein Treiber ein (Teil eines) Modell(s) nicht kompilieren kann oder ein Treiber ein kompiliertes (Teil eines) Modell(s) nicht ausführen kann, greift die NNAPI möglicherweise auf ihre eigene CPU-Implementierung der Vorgänge zurück.
Wenn der NNAPI-Client optimierte Versionen des Vorgangs enthält (z. B. TFLite), kann es vorteilhaft sein, das CPU-Fallback zu deaktivieren und die Fehler mit der optimierten Vorgangsimplementierung des Clients zu beheben.
Wenn die Kompilierung in Android 10 mit ANeuralNetworksCompilation_createForDevices durchgeführt wird, wird der CPU-Fallback deaktiviert.
In Android P wird die NNAPI-Ausführung auf die CPU zurückgesetzt, wenn die Ausführung auf dem Treiber fehlschlägt.
Dies gilt auch für Android 10, wenn ANeuralNetworksCompilation_create anstelle von ANeuralNetworksCompilation_createForDevices verwendet wird.
Bei der ersten Ausführung wird für diese einzelne Partition ein Fallback durchgeführt. Wenn dies immer noch fehlschlägt, wird das gesamte Modell auf der CPU noch einmal ausgeführt.
Wenn die Partitionierung oder Kompilierung fehlschlägt, wird das gesamte Modell auf der CPU ausgeführt.
In einigen Fällen werden bestimmte Vorgänge auf der CPU nicht unterstützt. In solchen Situationen schlägt die Kompilierung oder Ausführung fehl, anstatt dass ein Fallback erfolgt.
Auch nach dem Deaktivieren des CPU-Fallbacks kann es im Modell noch Vorgänge geben, die auf der CPU geplant sind. Wenn die CPU in der Liste der Prozessoren enthalten ist, die für ANeuralNetworksCompilation_createForDevices bereitgestellt werden, und entweder der einzige Prozessor ist, der diese Vorgänge unterstützt, oder der Prozessor ist, der die beste Leistung für diese Vorgänge bietet, wird sie als primärer Executor (kein Fallback) ausgewählt.
Wenn Sie sicherstellen möchten, dass keine CPU-Ausführung stattfindet, verwenden Sie ANeuralNetworksCompilation_createForDevices und schließen Sie die nnapi-reference aus der Liste der Geräte aus.
Ab Android P ist es möglich, den Fallback zur Ausführungszeit in DEBUG-Builds zu deaktivieren, indem die Property debug.nn.partition auf 2 gesetzt wird.
Speicherdomains
In Android 11 und höher unterstützt die NNAPI Speicherdomains, die Allocator-Schnittstellen für opake Speicher bereitstellen. So können Anwendungen geräteeigene Speicher über Ausführungen hinweg übergeben, sodass die NNAPI bei aufeinanderfolgenden Ausführungen auf demselben Treiber Daten nicht unnötig kopiert oder transformiert.
Die Funktion „Speicherdomain“ ist für Tensoren gedacht, die hauptsächlich intern im Treiber verwendet werden und nicht häufig auf der Clientseite abgerufen werden müssen. Beispiele für solche Tensoren sind die Zustandstensoren in Sequenzmodellen. Verwenden Sie für Tensoren, die auf der Clientseite häufigen CPU-Zugriff erfordern, stattdessen gemeinsam genutzte Arbeitsspeicherpools.
So weisen Sie einen opaken Speicher zu:
Rufen Sie die Funktion
ANeuralNetworksMemoryDesc_create()auf, um einen neuen Speicherdeskriptor zu erstellen:// Create a memory descriptor ANeuralNetworksMemoryDesc* desc; ANeuralNetworksMemoryDesc_create(&desc);
Geben Sie alle vorgesehenen Eingabe- und Ausgaberollen an, indem Sie
ANeuralNetworksMemoryDesc_addInputRole()undANeuralNetworksMemoryDesc_addOutputRole()aufrufen.// Specify that the memory may be used as the first input and the first output // of the compilation ANeuralNetworksMemoryDesc_addInputRole(desc, compilation, 0, 1.0f); ANeuralNetworksMemoryDesc_addOutputRole(desc, compilation, 0, 1.0f);
Optional können Sie die Speicherdimensionen durch Aufrufen von
ANeuralNetworksMemoryDesc_setDimensions()angeben.// Specify the memory dimensions uint32_t dims[] = {3, 4}; ANeuralNetworksMemoryDesc_setDimensions(desc, 2, dims);
Schließen Sie die Deskriptordefinition ab, indem Sie
ANeuralNetworksMemoryDesc_finish()aufrufen.ANeuralNetworksMemoryDesc_finish(desc);
Weisen Sie so viele Speicher zu, wie Sie benötigen, indem Sie den Deskriptor an
ANeuralNetworksMemory_createFromDesc()übergeben.// Allocate two opaque memories with the descriptor ANeuralNetworksMemory* opaqueMem; ANeuralNetworksMemory_createFromDesc(desc, &opaqueMem);
Geben Sie den Speicherdeskriptor zurück, wenn Sie ihn nicht mehr benötigen.
ANeuralNetworksMemoryDesc_free(desc);
Der Client darf das erstellte ANeuralNetworksMemory-Objekt nur mit ANeuralNetworksExecution_setInputFromMemory() oder ANeuralNetworksExecution_setOutputFromMemory() gemäß den im ANeuralNetworksMemoryDesc-Objekt angegebenen Rollen verwenden. Die Argumente „offset“ und „length“ müssen auf 0 gesetzt werden, was bedeutet, dass der gesamte Speicher verwendet wird. Der Client kann den Inhalt des Speichers auch explizit mit ANeuralNetworksMemory_copy() festlegen oder extrahieren.
Sie können opake Speicher mit Rollen mit nicht spezifizierten Dimensionen oder Rängen erstellen.
In diesem Fall schlägt die Speichererstellung möglicherweise mit dem Status ANEURALNETWORKS_OP_FAILED fehl, wenn sie vom zugrunde liegenden Treiber nicht unterstützt wird. Der Client sollte eine Fallback-Logik implementieren, indem er einen ausreichend großen Puffer zuweist, der von Ashmem oder dem BLOB-Modus AHardwareBuffer unterstützt wird.
Wenn die NNAPI nicht mehr auf das opake Speicherobjekt zugreifen muss, deallokiere die entsprechende ANeuralNetworksMemory-Instanz:
ANeuralNetworksMemory_free(opaqueMem);
Messung der Leistung
Sie können die Leistung Ihrer Anwendung bewerten, indem Sie die Ausführungszeit messen oder ein Profil erstellen.
Ausführungszeit
Wenn Sie die Gesamtausführungszeit über die Laufzeit ermitteln möchten, können Sie die API für die synchrone Ausführung verwenden und die für den Aufruf benötigte Zeit messen. Wenn Sie die Gesamtausführungszeit über eine niedrigere Ebene des Software-Stacks ermitteln möchten, können Sie ANeuralNetworksExecution_setMeasureTiming und ANeuralNetworksExecution_getDuration verwenden, um Folgendes zu erhalten:
- Ausführungszeit auf einem Beschleuniger (nicht im Treiber, der auf dem Hostprozessor ausgeführt wird).
- Ausführungszeit im Treiber, einschließlich der Zeit auf dem Beschleuniger.
Die Ausführungszeit im Treiber schließt Overhead wie den der Laufzeit selbst und den IPC aus, der für die Kommunikation der Laufzeit mit dem Treiber erforderlich ist.
Diese APIs messen die Dauer zwischen den Ereignissen „Arbeit eingereicht“ und „Arbeit abgeschlossen“ und nicht die Zeit, die ein Treiber oder Beschleuniger für die Inferenz aufwendet, die möglicherweise durch Kontextwechsel unterbrochen wird.
Wenn beispielsweise Inferenz 1 beginnt, der Treiber dann die Arbeit beendet, um Inferenz 2 auszuführen, und dann Inferenz 1 fortsetzt und abschließt, umfasst die Ausführungszeit für Inferenz 1 die Zeit, in der die Arbeit beendet wurde, um Inferenz 2 auszuführen.
Diese Zeitinformationen können für eine Produktionsbereitstellung einer Anwendung nützlich sein, um Telemetriedaten für die Offlinenutzung zu erfassen. Anhand der Zeitdaten können Sie die App so anpassen, dass sie eine höhere Leistung erzielt.
Beachten Sie Folgendes, wenn Sie diese Funktion verwenden:
- Das Erfassen von Zeitinformationen kann sich auf die Leistung auswirken.
- Nur ein Treiber kann die Zeit berechnen, die er selbst oder der Beschleuniger benötigt, ohne die Zeit, die in der NNAPI-Laufzeit und in der IPC verbracht wird.
- Sie können diese APIs nur mit einem
ANeuralNetworksExecutionverwenden, der mitANeuralNetworksCompilation_createForDevicesmitnumDevices = 1erstellt wurde. - Es ist kein Treiber erforderlich, um Zeitinformationen melden zu können.
Anwendung mit Android Systrace profilieren
Ab Android 10 generiert die NNAPI automatisch systrace-Ereignisse, mit denen Sie ein Profil Ihrer Anwendung erstellen können.
Die NNAPI-Quelle enthält das Dienstprogramm parse_systrace, mit dem die von Ihrer Anwendung generierten Systrace-Ereignisse verarbeitet und eine Tabellenansicht generiert werden kann. Diese zeigt die Zeit, die in den verschiedenen Phasen des Modell-Lebenszyklus (Instanziierung, Vorbereitung, Kompilierung, Ausführung und Beendigung) und in den verschiedenen Layern der Anwendungen verbracht wurde. Die Ebenen, in die Ihre Anwendung aufgeteilt ist, sind:
Application: der HauptanwendungscodeRuntime: NNAPI-LaufzeitIPC: Die Interprozesskommunikation zwischen der NNAPI-Laufzeit und dem TreibercodeDriver: der Beschleunigertreiberprozess.
Profildaten generieren
Angenommen, Sie haben den AOSP-Quellbaum unter $ANDROID_BUILD_TOP ausgecheckt und verwenden das TFLite-Beispiel für die Bildklassifizierung als Zielanwendung. Dann können Sie die NNAPI-Profilierungsdaten mit den folgenden Schritten generieren:
- Starten Sie Android Systrace mit dem folgenden Befehl:
$ANDROID_BUILD_TOP/external/chromium-trace/systrace.py -o trace.html -a org.tensorflow.lite.examples.classification nnapi hal freq sched idle load binder_driver
Der Parameter -o trace.html gibt an, dass die Traces in trace.html geschrieben werden. Wenn Sie ein Profil für Ihre eigene Anwendung erstellen, müssen Sie org.tensorflow.lite.examples.classification durch den in Ihrem App-Manifest angegebenen Prozessnamen ersetzen.
Dadurch wird eine Ihrer Shell-Konsolen belegt. Führen Sie den Befehl nicht im Hintergrund aus, da er interaktiv auf die Beendigung eines enter wartet.
- Nachdem der Systrace-Collector gestartet wurde, starten Sie Ihre App und führen Sie den Benchmark-Test aus.
In unserem Fall können Sie die App Image Classification über Android Studio oder direkt über die Benutzeroberfläche Ihres Test-Smartphones starten, wenn die App bereits installiert ist. Wenn Sie NNAPI-Daten generieren möchten, müssen Sie die App so konfigurieren, dass sie NNAPI verwendet. Wählen Sie dazu im Dialogfeld für die App-Konfiguration NNAPI als Zielgerät aus.
Wenn der Test abgeschlossen ist, beenden Sie den Systrace, indem Sie im Konsolenterminal, das seit Schritt 1 aktiv ist,
enterdrücken.Führen Sie das Dienstprogramm
systrace_parseraus, um kumulative Statistiken zu generieren:
$ANDROID_BUILD_TOP/frameworks/ml/nn/tools/systrace_parser/parse_systrace.py --total-times trace.html
Der Parser akzeptiert die folgenden Parameter:
- --total-times: Zeigt die Gesamtzeit an, die in einer Ebene verbracht wurde, einschließlich der Zeit, die auf die Ausführung eines Aufrufs einer zugrunde liegenden Ebene gewartet wurde.
- --print-detail: Gibt alle Ereignisse aus, die von systrace erfasst wurden.
- --per-execution: Gibt nur die Ausführung und ihre Unterphasen (als Zeiten pro Ausführung) anstelle von Statistiken für alle Phasen aus.
- --json: Erzeugt die Ausgabe im JSON-Format.
Hier ein Beispiel für die Ausgabe:
===========================================================================================================================================
NNAPI timing summary (total time, ms wall-clock)                                                      Execution
                                                           ----------------------------------------------------
              Initialization   Preparation   Compilation           I/O       Compute      Results     Ex. total   Termination        Total
              --------------   -----------   -----------   -----------  ------------  -----------   -----------   -----------   ----------
Application              n/a         19.06       1789.25           n/a           n/a         6.70         21.37           n/a      1831.17*
Runtime                    -         18.60       1787.48          2.93         11.37         0.12         14.42          1.32      1821.81
IPC                     1.77             -       1781.36          0.02          8.86            -          8.88             -      1792.01
Driver                  1.04             -       1779.21           n/a           n/a          n/a          7.70             -      1787.95

Total                   1.77*        19.06*      1789.25*         2.93*        11.74*        6.70*        21.37*         1.32*     1831.17*
===========================================================================================================================================
* This total ignores missing (n/a) values and thus is not necessarily consistent with the rest of the numbers
Der Parser schlägt möglicherweise fehl, wenn die erfassten Ereignisse keinen vollständigen Anwendungstrace darstellen. Insbesondere kann es fehlschlagen, wenn systrace-Ereignisse, die das Ende eines Abschnitts markieren, im Trace ohne ein zugehöriges Abschnittsstartereignis vorhanden sind. Dies geschieht in der Regel, wenn beim Starten des Systrace-Collectors einige Ereignisse aus einer vorherigen Profilerstellungssitzung generiert werden. In diesem Fall müssen Sie die Profilerstellung noch einmal ausführen.
Statistiken für Ihren Anwendungscode zur systrace_parser-Ausgabe hinzufügen
Die Anwendung „parse_systrace“ basiert auf der integrierten Android-Funktion „systrace“. Sie können Traces für bestimmte Vorgänge in Ihrer App mit der Systrace API (für Java, für native Anwendungen) mit benutzerdefinierten Ereignisnamen hinzufügen.
Wenn Sie Ihre benutzerdefinierten Ereignisse mit Phasen des Anwendungslebenszyklus verknüpfen möchten, stellen Sie dem Ereignisnamen einen der folgenden Strings voran:
[NN_LA_PI]: Ereignis auf Anwendungsebene für die Initialisierung[NN_LA_PP]: Ereignis auf Anwendungsebene für die Vorbereitung[NN_LA_PC]: Ereignis auf Anwendungsebene für die Kompilierung[NN_LA_PE]: Ereignis auf Anwendungsebene für die Ausführung
Hier ist ein Beispiel dafür, wie Sie den Beispielcode für die TFLite-Bildklassifizierung ändern können, indem Sie einen runInferenceModel-Abschnitt für die Execution-Phase und die Application-Ebene hinzufügen, die einen weiteren Abschnitt preprocessBitmap enthält, der in NNAPI-Traces nicht berücksichtigt wird. Der Abschnitt runInferenceModel ist Teil der Systrace-Ereignisse, die vom NNAPI-Systrace-Parser verarbeitet werden:
Kotlin
/** Runs inference and returns the classification results. */ fun recognizeImage(bitmap: Bitmap): List{ // This section won’t appear in the NNAPI systrace analysis Trace.beginSection("preprocessBitmap") convertBitmapToByteBuffer(bitmap) Trace.endSection() // Run the inference call. // Add this method in to NNAPI systrace analysis. Trace.beginSection("[NN_LA_PE]runInferenceModel") long startTime = SystemClock.uptimeMillis() runInference() long endTime = SystemClock.uptimeMillis() Trace.endSection() ... return recognitions }
Java
/** Runs inference and returns the classification results. */ public ListrecognizeImage(final Bitmap bitmap) { // This section won’t appear in the NNAPI systrace analysis Trace.beginSection("preprocessBitmap"); convertBitmapToByteBuffer(bitmap); Trace.endSection(); // Run the inference call. // Add this method in to NNAPI systrace analysis. Trace.beginSection("[NN_LA_PE]runInferenceModel"); long startTime = SystemClock.uptimeMillis(); runInference(); long endTime = SystemClock.uptimeMillis(); Trace.endSection(); ... Trace.endSection(); return recognitions; }
Dienstqualität
In Android 11 und höher ermöglicht die NNAPI eine bessere Dienstqualität (QoS), da eine Anwendung die relativen Prioritäten ihrer Modelle, die maximale Zeit, die für die Vorbereitung eines bestimmten Modells erwartet wird, und die maximale Zeit, die für die Durchführung einer bestimmten Berechnung erwartet wird, angeben kann. Mit Android 11 werden außerdem zusätzliche NNAPI-Ergebniscodes eingeführt, mit denen Anwendungen Fehler wie verpasste Ausführungsfristen erkennen können.
Priorität einer Arbeitslast festlegen
Wenn Sie die Priorität einer NNAPI-Arbeitslast festlegen möchten, rufen Sie ANeuralNetworksCompilation_setPriority() auf, bevor Sie ANeuralNetworksCompilation_finish() aufrufen.
Fristen festlegen
Anwendungen können Fristen sowohl für die Modellkompilierung als auch für die Inferenz festlegen.
- Rufen Sie
ANeuralNetworksCompilation_setTimeout()auf, bevor SieANeuralNetworksCompilation_finish()aufrufen, um das Zeitlimit für die Kompilierung festzulegen. - Wenn Sie das Inferenz-Zeitlimit festlegen möchten, rufen Sie
ANeuralNetworksExecution_setTimeout()auf, bevor Sie mit der Kompilierung beginnen.
Weitere Informationen zu Operanden
Im folgenden Abschnitt werden erweiterte Themen zur Verwendung von Operanden behandelt.
Quantisierte Tensoren
Ein quantisierter Tensor ist eine kompakte Möglichkeit, ein n-dimensionales Array von Gleitkommawerten darzustellen.
NNAPI unterstützt asymmetrische quantisierte 8-Bit-Tensoren. Bei diesen Tensoren wird der Wert jeder Zelle durch eine 8-Bit-Ganzzahl dargestellt. Dem Tensor sind ein Skalierungs- und ein Nullpunktwert zugeordnet. Diese werden verwendet, um die 8-Bit-Ganzzahlen in die dargestellten Gleitkommawerte umzuwandeln.
Die Formel lautet:
(cellValue - zeroPoint) * scale
Dabei ist der zeroPoint-Wert eine 32-Bit-Ganzzahl und die Skala ein 32-Bit-Gleitkommawert.
Im Vergleich zu Tensoren mit 32-Bit-Gleitkommawerten haben 8-Bit-quantisierte Tensoren zwei Vorteile:
- Ihre Anwendung ist kleiner, da die trainierten Gewichtungen ein Viertel der Größe von 32-Bit-Tensoren einnehmen.
- Berechnungen können oft schneller ausgeführt werden. Das liegt daran, dass weniger Daten aus dem Speicher abgerufen werden müssen, und an der Effizienz von Prozessoren wie DSPs bei der Ganzzahlmathematik.
Es ist zwar möglich, ein Gleitkommamodell in ein quantisiertes Modell umzuwandeln, aber unsere Erfahrung hat gezeigt, dass bessere Ergebnisse erzielt werden, wenn ein quantisiertes Modell direkt trainiert wird. Im Grunde lernt das neuronale Netzwerk, die erhöhte Granularität der einzelnen Werte auszugleichen. Für jeden quantisierten Tensor werden die Werte für „scale“ und „zeroPoint“ während des Trainingsprozesses bestimmt.
In der NNAPI definieren Sie quantisierte Tensortypen, indem Sie das Typfeld der Datenstruktur ANeuralNetworksOperandType auf ANEURALNETWORKS_TENSOR_QUANT8_ASYMM setzen.
Außerdem geben Sie den Skalierungs- und Nullpunktwert des Tensors in dieser Datenstruktur an.
Zusätzlich zu asymmetrischen quantisierten 8-Bit-Tensoren unterstützt die NNAPI Folgendes:
ANEURALNETWORKS_TENSOR_QUANT8_SYMM_PER_CHANNEL, mit dem Sie Gewichtungen fürCONV/DEPTHWISE_CONV/TRANSPOSED_CONV-Vorgänge darstellen können.ANEURALNETWORKS_TENSOR_QUANT16_ASYMM, die Sie für den internen Status vonQUANTIZED_16BIT_LSTMverwenden können.ANEURALNETWORKS_TENSOR_QUANT8_SYMM, die als Eingabe fürANEURALNETWORKS_DEQUANTIZEverwendet werden kann.
Optionale Operanden
Einige Vorgänge wie ANEURALNETWORKS_LSH_PROJECTION verwenden optionale Operanden. Wenn Sie im Modell angeben möchten, dass der optionale Operand weggelassen wird, rufen Sie die Funktion ANeuralNetworksModel_setOperandValue() auf und übergeben Sie NULL für den Zwischenspeicher und 0 für die Länge.
Wenn die Entscheidung, ob der Operand vorhanden ist oder nicht, bei jeder Ausführung variiert, geben Sie an, dass der Operand weggelassen wird. Verwenden Sie dazu die Funktionen ANeuralNetworksExecution_setInput() oder ANeuralNetworksExecution_setOutput() und übergeben Sie NULL für den Puffer und 0 für die Länge.
Tensoren mit unbekanntem Rang
Mit Android 9 (API-Level 28) wurden Modelloperanden mit unbekannten Dimensionen, aber bekanntem Rang (Anzahl der Dimensionen) eingeführt. Mit Android 10 (API-Level 29) wurden Tensoren mit unbekanntem Rang eingeführt, wie in ANeuralNetworksOperandType gezeigt.
NNAPI-Benchmark
Der NNAPI-Benchmark ist im AOSP unter platform/test/mlts/benchmark (Benchmark-App) und platform/test/mlts/models (Modelle und Datasets) verfügbar.
Der Benchmark bewertet die Latenz und Genauigkeit und vergleicht die Treiber mit derselben Arbeit, die mit Tensorflow Lite auf der CPU für dieselben Modelle und Datasets ausgeführt wird.
So verwenden Sie den Benchmark:
Verbinden Sie ein Android-Zielgerät mit Ihrem Computer, öffnen Sie ein Terminalfenster und prüfen Sie, ob das Gerät über adb erreichbar ist.
Wenn mehr als ein Android-Gerät verbunden ist, exportieren Sie die Umgebungsvariable
ANDROID_SERIALdes Zielgeräts.Wechsle zum Android-Quellverzeichnis auf oberster Ebene.
Führen Sie folgende Befehle aus:
lunch aosp_arm-userdebug # Or aosp_arm64-userdebug if available
./test/mlts/benchmark/build_and_run_benchmark.sh
Am Ende eines Benchmark-Laufs werden die Ergebnisse als HTML-Seite angezeigt, die an
xdg-openübergeben wird.
NNAPI-Logs
Die NNAPI generiert nützliche Diagnoseinformationen in den Systemprotokollen. Analysieren Sie die Logs mit dem Dienstprogramm logcat.
Aktiviere das ausführliche NNAPI-Logging für bestimmte Phasen oder Komponenten, indem du die Property debug.nn.vlog (mit adb shell) auf die folgende Liste von Werten setzt, die durch Leerzeichen, Doppelpunkte oder Kommas getrennt sind:
model: Modellerstellungcompilation: Generierung des Modellausführungsplans und Kompilierungexecution: Modellausführungcpuexe: Ausführung von Vorgängen mit der NNAPI-CPU-Implementierungmanager: NNAPI-Erweiterungen, verfügbare Schnittstellen und Informationen zu Funktionenalloder1: Alle oben genannten Elemente
Wenn Sie beispielsweise das vollständige ausführliche Logging aktivieren möchten, verwenden Sie den Befehl adb shell setprop debug.nn.vlog all. Verwenden Sie den Befehl adb shell setprop debug.nn.vlog '""', um das ausführliche Logging zu deaktivieren.
Wenn das ausführliche Logging aktiviert ist, werden Logeinträge auf INFO-Ebene mit einem Tag generiert, das auf den Phasen- oder Komponentennamen festgelegt ist.
Neben den von debug.nn.vlog gesteuerten Nachrichten stellen NNAPI-API-Komponenten weitere Logeinträge auf verschiedenen Ebenen bereit, die jeweils ein bestimmtes Log-Tag verwenden.
Wenn Sie eine Liste der Komponenten abrufen möchten, suchen Sie im Quellbaum mit dem folgenden Ausdruck:
grep -R 'define LOG_TAG' | awk -F '"' '{print $2}' | sort -u | egrep -v "Sample|FileTag|test"
Dieser Ausdruck gibt derzeit die folgenden Tags zurück:
- BurstBuilder
- Callbacks
- CompilationBuilder
- CpuExecutor
- ExecutionBuilder
- ExecutionBurstController
- ExecutionBurstServer
- ExecutionPlan
- FibonacciDriver
- GraphDump
- IndexedShapeWrapper
- IonWatcher
- Manager
- Arbeitsspeicher
- MemoryUtils
- MetaModel
- ModelArgumentInfo
- ModelBuilder
- NeuralNetworks
- OperationResolver
- Vorgänge
- OperationsUtils
- PackageInfo
- TokenHasher
- TypeManager
- Utils
- ValidateHal
- VersionedInterfaces
Mit der Umgebungsvariable ANDROID_LOG_TAGS können Sie die Ebene der von logcat angezeigten Logeinträge steuern.
Wenn Sie alle NNAPI-Logeinträge anzeigen und alle anderen deaktivieren möchten, legen Sie für ANDROID_LOG_TAGS Folgendes fest:
BurstBuilder:V Callbacks:V CompilationBuilder:V CpuExecutor:V ExecutionBuilder:V ExecutionBurstController:V ExecutionBurstServer:V ExecutionPlan:V FibonacciDriver:V GraphDump:V IndexedShapeWrapper:V IonWatcher:V Manager:V MemoryUtils:V Memory:V MetaModel:V ModelArgumentInfo:V ModelBuilder:V NeuralNetworks:V OperationResolver:V OperationsUtils:V Operations:V PackageInfo:V TokenHasher:V TypeManager:V Utils:V ValidateHal:V VersionedInterfaces:V *:S.
Sie können ANDROID_LOG_TAGS mit dem folgenden Befehl festlegen:
export ANDROID_LOG_TAGS=$(grep -R 'define LOG_TAG' | awk -F '"' '{ print $2 ":V" }' | sort -u | egrep -v "Sample|FileTag|test" | xargs echo -n; echo ' *:S')
Dies ist nur ein Filter, der auf logcat angewendet wird. Sie müssen die Property debug.nn.vlog auf all setzen, um ausführliche Protokollinformationen zu generieren.