

記述するコード自体がメモリ使用の一種です。アプリケーションのすべてのクラス、メソッド、文字列定数は、実行時に RAM に読み込まれる必要があります。アプリケーションのコードベースが大きいほど、存在するために消費するメモリも多くなります。
ファイル バックアップ メモリとデマンド ページング
Android は、mmap を使用して .apk(.oat ファイルや .so ファイルなど)から実行可能コードを読み込みます。これは、コードがファイル バックアップされていることを意味します。
重要な点として、Android はデマンド ページングを使用します。アプリの起動時に、カーネルは APK 全体をすぐに RAM に読み込みません。代わりに、ファイルがプロセスの仮想アドレス空間にマッピングされるだけです。アプリの実行中に CPU が新しい関数にジャンプすると、「ページフォルト」がトリガーされます。カーネルはスレッドを一時停止し、その特定の 4 KB のコードページをストレージから物理 RAM に読み取り、実行を再開します。

つまり、パッケージ化はするものの、実行しないコードは、コードページ自体に物理メモリを使用しません。ただし、未使用のライブラリは APK の全体的なサイズを増やし、コードが存在することを知るために読み取る必要がある、システムの内部メタデータ(DEX インデックスやクラス記述子など)で使用されるメモリを大幅に増やす可能性があります。さらに、多くのライブラリには静的イニシャライザが含まれているか、アプリの起動時に依存関係注入フレームワークによってアクセスされるため、結局 RAM にページングされます。
ページの削除と速度低下
ファイル バックアップ メモリはストレージから常に再読み取りできるため、カーネルはこれらのページを「クリーン」と見なします。システムでメモリ不足が発生すると、カーネルはこれらのクリーンコードページを RAM から削除(ドロップ)して、他の処理のための空き領域を確保します。
アプリが後でそのコードを再度実行する必要がある場合、CPU はフォールトし、カーネルはストレージからページを再読み取りする必要があります。アプリのコードが多いほど、コードが削除される可能性が高くなります。ユーザーが他のアプリを使用した後に肥大化したアプリに戻ると、CPU がストレージからコードがページングされるのを待機して常に停止するため、ランダムなジャンクや速度低下が発生します。
ページフォルトのコスト: デバイスのストレージ速度(UFS と eMMC)とカーネルの状態によって大きく異なりますが、メジャー ページフォルト(ストレージから 4 KB を読み取る)のコストは 0.5 ~ 5 ミリ秒になる可能性があります。起動パスが最適化されていないコードの 500 ページに及ぶ場合、アプリの起動時間に数百ミリ秒の純粋な I/O レイテンシが簡単に発生する可能性があります。
Compiler Explorer でコードサイズを調べる
Java または Kotlin コードがネイティブ マシンコード(つまりメモリ バイト)にどのように変換されるかを直感的に理解するには、Compiler Explorer を使用します。
Android のサポートは Godbolt に直接組み込まれています。これにより、Android ツールチェーン(D8、R8、dex2oat)のさまざまな部分がソースコードをどのように変換するかを確認できます。
Android で Compiler Explorer を使用する方法
- godbolt.org に移動します。
- 言語プルダウン(左上)から [Android Java] または [Android Kotlin] を選択します。
- コンパイラ プルダウン(コードペインの右上)で、さまざまなツールを選択できます。
d8: Dalvik バイトコード(.dex)を表示します。これは元のコードに最も近い表現であり、読みやすくなっています。r8: R8 オプティマイザーがバイトコードを縮小して最適化する方法を示します。dex2oat: デバイスで実際に実行される最終的な ARM64 マシンコードを表示します。ここで、実際のメモリへの影響(命令あたり 4 バイト)を確認できます。dex2oatはさまざまな ISA をターゲットにできますが、モバイル デバイスでは ARM64 が最も一般的です。
- ソースと出力のハイライト表示: コード行にカーソルを合わせると、対応するバイトコードまたはマシンコードの命令がハイライト表示され、特定のステートメントの影響を簡単に追跡できます。
- 最適化パイプライン: 分解ビューで、[新規追加...] をクリックできます。-> Opt Pipeline。これにより、コンパイラが実行する内部ステップを確認できます。最終的な ARM64 マシンコードに変換される前に、各ステージ(「インライナー(前)」と「インライナー(後)」のステップなど)で 内部表現(IR)がどのように変換されるかを確認できます。

メモリにとって重要な理由
ARM64 ISA を対象とする dex2oat 出力に表示されるすべての命令は、アプリの実行可能ファイル(.odex または .oat)で 4 バイトを占有します。
さまざまな言語機能を利用するコードを入力して、コンパイラの出力を確認してみます。
- 配列アクセスとリスト イテレータ:
int[]に対するシンプルな配列ループは、約 10 個の命令(約 40 バイト)にコンパイルされる可能性があります。Listに対する foreach ループは、暗黙的にIteratorを使用します。メソッド呼び出し(hasNext()、next())の追加とイテレータ オブジェクト自体の割り当てにより、30 ~ 40 個の命令(約 160 バイト)になる可能性があります。- R8 最適化: 適切な条件(
ListがArrayListであることが証明された場合など)では、R8 オプティマイザーが foreach ループを単純なインデックス付きループに変換し、イテレータのオーバーヘッドを排除して、コードサイズと実行時のメモリチャーンを削減できます。
- 仮想メソッド呼び出し: オブジェクトのクラスを読み込み、
vtableでメソッドを見つけてから、分岐します。通常、これには 4 ~ 5 個の命令(約 20 バイト)が必要です。 - 直接呼び出し/静的呼び出し: 多くの場合、単一の
bl(リンク付き分岐)命令(4 バイト)に変換されます。 - Kotlin ラムダ: 匿名クラス全体と追加のブリッジ メソッドを生成し、単純な関数ブロックに対して数百バイトのコードとメタデータのオーバーヘッドを追加する可能性があります。
Compiler Explorer を使用すると、高度な言語機能(Kotlin ラムダ、ストリーム API、ジェネリクスの多用など)がアプリの最終的なコンパイル サイズにどのように影響するか、また、R8 などのオプティマイザーが言語抽象化のコストをどのように軽減できるかを確認できます。このツールは、アプリの設計と実装において、情報に基づいたトレードオフを行うのに役立ちます。
一般的に、アプリのコードが複雑になるほど、メモリ使用量が増加します。逆に、コードが単純な場合や、R8 によって単純化されたコードの場合、CPU 命令やストレージと RAM のバイト数として表現されるサイズが小さくなります。
meminfo と showmap を使用してコードの影響を測定する
標準の Android メモリツールを使用すると、アプリのコードが消費しているメモリの量を確認できます。
dumpsys meminfo
adb shell dumpsys meminfo <package> を実行すると、[アプリの概要] セクションの [コード] カテゴリに、コード関連のメモリの概要が表示されます。
 App Summary
                       Pss(KB)
                        ------
           Java Heap:     3244
         Native Heap:     5412
                Code:    24512  # <--- Sum of .so, .dex, .oat, .art, etc.
showmap
より詳細なビューを表示するには、showmap を使用します。特定のファイルからメモリにマッピングされているリージョンを明らかにします。
adb shell showmap $(pidof <package>) | grep -E "\.oat|\.odex|\.dex|\.apk"
アプリケーションのコンパイル済みコードのエントリが表示されます。
   size      RSS      PSS    clean    dirty    clean    dirty     swap  swapPSS object
------- -------- -------- -------- -------- -------- -------- -------- -------- ----------------
  12288     8192     8192     8192        0        0        0        0        0 /data/app/.../base.odex
不要なコードと R8
実行されるメソッドはすべてメモリを消費するため、不要な初期化や未使用のライブラリを含む「肥大化した」アプリは、起動パフォーマンスとベースラインのメモリ使用量に大きな影響を与える可能性があります。
そのため、R8(ProGuard)などのツールが重要になります。R8 は、アプリケーションのバイトコードを分析し、呼び出されることのないクラスやメソッドを削除します(「デッドコードの削除」)。
ハンズオン演習: ブロートのコスト
コードサイズの影響を示すために、300 個の生成されたクラス(それぞれ 500 個のメソッドを含む)を含むアプリの 2 つのビルドを比較するテストを考えてみましょう。
- CodeBloat(最適化されていない): 生成されたすべてのクラスと固有の文字列を含む、標準の最適化されていないビルド。
- CodeBloatOptimized: 同じソースコードですが、R8 圧縮を有効にしてコンパイルされています。
1. 事前(AOT)コンパイル
ファイル バックアップ メモリの影響を最大化するため、cmd package compile ツールを使用して、アプリを事前(AOT)コンパイルして .oat ファイルにします。
adb shell cmd package compile -m speed -f com.android.codebloat
adb shell cmd package compile -m speed -f com.android.codebloat.optimized
これは合成例です。通常、アプリは speed-profile コンパイル モードを使用します(下記を参照)。
2. リリースして比較する
システムがストレージからコードを読み取る必要がある真のコールド スタートを確認するため、各アプリを起動する前にカーネルのページ キャッシュをドロップします。これには root アクセスが必要です。
最適化されていないアプリを起動します。
adb shell am force-stop com.android.codebloat
# Drop page cache to ensure the start is truly cold
adb shell "echo 3 > /proc/sys/vm/drop_caches"
adb shell am start -W -n com.android.codebloat/.MainActivity
sleep 5 # Wait for the background thread to load classes
adb shell dumpsys meminfo -s com.android.codebloat
最適化されたアプリについても同じ操作を行います。
adb shell am force-stop com.android.codebloat.optimized
# Drop page cache to ensure the start is truly cold
adb shell "echo 3 > /proc/sys/vm/drop_caches"
adb shell am start -W -n com.android.codebloat.optimized/com.android.codebloat.MainActivity
sleep 5
adb shell dumpsys meminfo -s com.android.codebloat.optimized
結果
App Summary セクションの [コード] 行を見ると、大きな違いがあることがわかります。
- 最適化されていない
Code: 約 30,000 KB(30 MB) - 最適化済み
Code: 約 2,000 KB(2 MB)
R8 は、これらのクラス内の 500 個のメソッドが実際には有用な処理を行っていないと判断したため(doSomething() メソッドは method0() を呼び出すだけで、結果は無視される)、最終的な APK から人工的に生成されたコードのほぼすべてを取り除きました。
3. Perfetto で影響を確認する
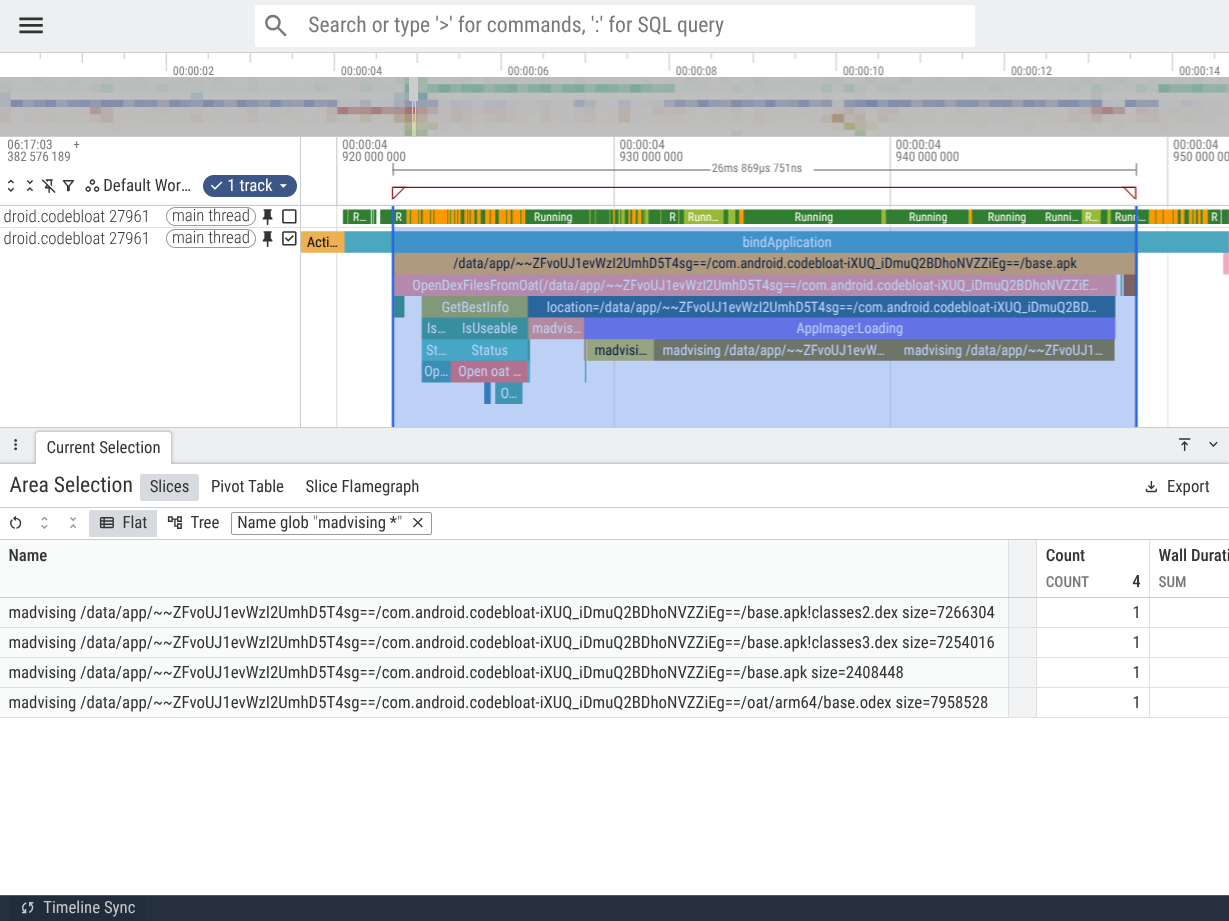
コードの肥大化の影響は、アプリケーションの初期読み込みフェーズで顕著に現れます。具体的には、メインスレッドの bindApplication スライスと、madvising で始まるネストされたスライスを探します。これは、システムが APK とそのコンパイル済みコード(.odex)からファイルを読み込む準備をしていることを示します。
インタラクティブなコールド スタートでは、システムは mmap() と madvise() のコードと、アプリの読み込みと実行に必要なこれらのファイルからのその他のデータを読み込みます。madvising スライスの「size=」の後の値は、読み込む必要のあるデータの量を示します。アプリのコードのプリフェッチは、アプリの起動を高速化するために行われます。
この比較から、肥大化したアプリではストレージから RAM に読み込む必要のあるアプリコードの量がはるかに多く、アプリの起動が遅くなる原因となる期間が長くなっていることがわかります。また、肥大化したアプリの起動のトレースには、肥大化したアプリが 1 つの DEX ファイルに収まらなかったために「スピル」せざるを得なかったセカンダリ DEX ファイル(classes2.dex、classes3.dex)を読み込むスライスが表示されます。
比較(Google Pixel 10a でのコールド スタート)
| 指標 | 最適化なし(CodeBloat) | 最適化(CodeBloatOptimized) |
|---|---|---|
base.odex madvise サイズ |
~ 7.9 MB(2.0 ミリ秒) | ~ 16 KB(0.003 ミリ秒) |
base.apk madvise サイズ |
~ 2.4 MB(2.4 ミリ秒) | 約 4 KB(0.001 ミリ秒) |
classes2.dex madvise サイズ |
約 7.3 MB(8.6 ミリ秒) | なし |
classes3.dex madvise サイズ |
~ 7.3 MB(8.0 ミリ秒) | なし |
合計 madvising 期間 |
約 21 ミリ秒 | ~0.004 ms |
最適化されていないアプリの読み込みパフォーマンス
アプリの読み込みパフォーマンスの最適化

コードの肥大化の影響は、アプリのサイズ、ユーザーのデバイスの特性、システム負荷によって異なります。
読み込み分析用の PerfettoSQL
次のクエリを使用すると、トレースからこれらの指標を抽出できます。
1. アプリの起動時間
これは、アプリの Activity が起動してから、Activity が最初のフレームを描画するまでの時間を示します。
INCLUDE PERFETTO MODULE android.startup.startups;

SELECT package, dur, startup_type
FROM android_startups
WHERE package LIKE 'com.android.codebloat%';
アプリのさまざまな起動状態の理解を参照してください。
アプリの起動時間は、このガイドで説明した以外の多くの要因に影響されます。
2. madvising のサイズと期間を抽出する
このクエリは、前述の madvising 部分を拡大します。
INCLUDE PERFETTO MODULE slices.with_context;

SELECT
  name,
  dur/1e6 AS dur_ms
FROM thread_slice
WHERE process_name LIKE 'com.android.codebloat%'
  AND name LIKE 'madvising %';
3. メインスレッドの状態の内訳(状態ごとの合計時間)
このクエリは、アプリのメインスレッドがさまざまな状態で費やした時間を示します。
SELECT
  p.name AS process_name,
  state,
  sum(dur)/1e6 AS total_dur_ms
FROM thread_state ts
JOIN thread t USING (utid)
JOIN process p USING (upid)
WHERE p.name LIKE 'com.android.codebloat%'
  AND t.is_main_thread = 1
GROUP BY p.name, state;
クエリを絞り込んで、アプリの起動時間中のメインスレッドの状態のみを確認できます。
INCLUDE PERFETTO MODULE android.startup.startups;

SELECT
  p.name AS process_name,
  ts.state,
  -- Calculate only the duration that falls within the startup window
  SUM(
    MAX(0,
      MIN(ts.ts + ts.dur, s.ts + s.dur) - MAX(ts.ts, s.ts)
    )
  ) / 1e6 AS startup_dur_ms
FROM thread_state ts
JOIN thread t USING (utid)
JOIN process p USING (upid)
-- Join on the package name to align thread states with the correct startup
JOIN android_startups s ON s.package = p.name
WHERE p.name LIKE 'com.android.codebloat%'
  AND t.is_main_thread = 1
  -- Only select thread states that overlap with the startup interval
  AND ts.ts + ts.dur > s.ts
  AND ts.ts < s.ts + s.dur
GROUP BY 1, 2
ORDER BY startup_dur_ms DESC;
これにより、次のような興味深い問題が明らかになることがあります。
- Runnable(R)に費やされた時間が長いが、Running ではない: これは、CPU 競合によってアプリの起動が遅延したことを示します。つまり、他のスレッド(他のアプリのスレッドの可能性あり)が CPU を占有しているため、アプリのメインスレッドを実行できませんでした。
- 割り込み可能なスリープ(D)に費やされた時間が長い: 通常、アプリの起動を遅らせている I/O の遅延またはメモリ不足を示します。
- スリープ(S)に費やされた時間が長い: メインスレッドが他のスレッドの処理を待機していたことを意味します。これは、アプリの起動パスでロック競合が発生していることを示している場合があります(つまり、メインスレッドが、アプリ内の別のスレッドによって占有されている排他リソースでブロックされています)。
4. 最大ファイル バックアップ メモリ(RSS ファイル)
この指標は、アプリが起動時に読み込むコードとデータの量とよく相関します。「肥大化」したアプリほど、この数値が高くなり、システムにメモリ不足が発生します。このようなプレッシャーにより、システムが割り当てリクエストの処理に苦労したり、アプリの起動に集中する CPU 時間を他のプロセスからのメモリの再利用に転用して、起動中のアプリの緊急のニーズを満たそうとしたりするため、アプリの起動が遅れる可能性があります。
SELECT
  p.name AS process_name,
  max(c.value)/1024.0/1024.0 AS max_rss_file_mb
FROM counter c
JOIN process_counter_track t ON c.track_id = t.id
JOIN process p USING (upid)
WHERE p.name LIKE 'com.android.codebloat%'
  AND t.name = 'mem.rss.file'
GROUP BY p.name;
ART のコンパイル モードとメモリ
Android ランタイム(ART)は、コンパイラ フィルタとも呼ばれる複数の異なるモードのいずれかで、アプリケーション コードをコンパイルできます。選択したコンパイラ フィルタは、アプリのメモリ使用量に直接影響します。
verify: ART はバイトコードの検証のみを行います。AOT コンパイルは実行されません。コードは インタープリタを介して実行されるか、JIT コンパイラによって実行時にコンパイルされます。- メモリへの影響: ディスク上のサイズが最小。ネイティブ コードのメモリ使用量は
JIT Cache(匿名ダーティ メモリ)にプッシュされます。
- メモリへの影響: ディスク上のサイズが最小。ネイティブ コードのメモリ使用量は
speed: ART はすべてのメソッドの完全な AOT コンパイルを実行します。- メモリへの影響: 最大の
.odexサイズ。ファイル バックアップ(クリーン)メモリの使用量を最大化します。
- メモリへの影響: 最大の
speed-profile: ART は、JIT プロファイルで「ホット」とマークされたメソッドのみをコンパイルします。- メモリへの影響: バランスの取れたアプローチ。最も重要なコードのみが AOT コンパイルされます。
最も一般的なフィルタは speed-profile で、ユーザーアプリのインストール時に使用されます。これはシステム プロパティ pm.dexopt.install と pm.dexopt.bg-dexopt で構成され、通常は build/make/target/product/runtime_libart.mk で設定されます。
一部のシステムアプリは speed コンパイルを使用し、システム イメージのビルド時にもコンパイルされます。verify は通常、開発ユースケースでのみ使用されます。
| ユースケース | 一般的なコンパイラ フィルタ |
|---|---|
| 開発 | verify |
| システム イメージ | speed |
| ユーザーアプリ | speed-profile |
ハンズオン演習: コンパイル モードとメモリ
CodeBloat アプリを使用すると、これらのフィルタがメモリに与える影響を確認できます。これらの測定結果を再現するには:
- アプリを強制的にターゲット モードに再コンパイルします。
- アプリを強制停止してコールド スタートします。
- バックグラウンド スレッドがクラスのタッチを完了するまで待ちます(logcat を監視するか、5 秒待ちます)。
adb shell dumpsys meminfo com.android.codebloatを実行します。
モード: verify(AOT なし)
adb shell cmd package compile -m verify -f com.android.codebloat
adb shell am force-stop com.android.codebloat
adb shell am start -W -n com.android.codebloat/.MainActivity
sleep 5
adb shell dumpsys meminfo com.android.codebloat
verify モードでは、アプリの概要に次の情報が表示されます。* コード PSS: 約 8,000 KB * Dalvik その他(JIT): 約 25,000 KB
AOT でコンパイルされるコードがないため、ランタイムはホットメソッドを JIT キャッシュに JIT コンパイルする必要があります。これは、ダーティな匿名メモリ(Dalvik
Other)として表示されます。
モード: speed(完全 AOT)
adb shell cmd package compile -m speed -f com.android.codebloat
adb shell am force-stop com.android.codebloat
adb shell am start -W -n com.android.codebloat/.MainActivity
sleep 5
adb shell dumpsys meminfo com.android.codebloat
speed モードでは、結果は大幅に変化します。* Code PSS: 約 24,000 KB *
Dalvik Other(JIT): 約 5,000 KB
アプリケーションのコードが .odex ファイルからクリーンなファイル バックアップ メモリとしてマッピングされるようになりました。これにより、JIT キャッシュへの負荷が軽減され、メモリがダーティ RAM として「スタック」するのではなく、負荷がかかった状態で削除対象になります。
モード: speed-profile(選択的 AOT)
最新のアプリは baseline.prof ベースライン プロファイルをバンドルする場合があります。ART はこれを使用して、高速でメモリ効率の高い起動に必要なコードのみを選択的にコンパイルします。
この演習では、アプリの起動クラスを一覧表示するベースライン プロファイルを作成します。ただし、実際には、コンパイラはアプリストアなどの外部ソースからプロファイル(「クラウド プロファイル」)を受け取ることもあります。これにより、デベロッパーが生成したベースライン プロファイルをバンドルしたかどうかに関係なく、アプリのクラウドソースの JIT プロファイルを提供できます。
オンデバイス プロファイルの生成と使用
speed-profile の影響を確認するには、デバイスで独自のプロファイルを生成します。
リセットして開始:
adb shell am force-stop com.android.codebloatインタラクト: アプリを起動し、起動シーケンスを実行します。
Dump Profile:
adb shell kill -s SIGUSR1 $(pidof com.android.codebloat)(これにより、アプリは現在のプロファイルをディスクに書き込みます)。
プロファイルをインストール:
adb shell cp /data/misc/profiles/cur/0/com.android.codebloat/primary.prof \ /data/misc/profiles/ref/com.android.codebloat/primary.profコンパイル:
adb shell cmd package compile -m speed-profile -f com.android.codebloat
再度起動すると、バランスが取れていることがわかります。コード PSS は speed よりも小さくなります(約 16,000 KB など)。これは、「ホット」な起動メソッドのみがコンパイルされ、残りのメソッドは実際に使用された場合にのみインタープリタまたは JIT によって処理されるためです。
参照:
コンパイル済みコードの詳細
ART が生成する命令を正確に確認したい場合は、art/DISASSEMBLY_GUIDE.md を参照してください。
このガイドでは、次の使用方法について詳しく説明します。
oatdump: 既存の.odexファイル内の ARM64 命令を確認します。dex2oat: 詳細なデバッグフラグを使用してコンパイルをシミュレートします。
演習: コードのインライン化
コンパイル済みコードが予期せず大きくなる理由の 1 つは、メソッドのインライン化です。コンパイラは、頻繁に呼び出される小さなメソッドの本体を呼び出し元に直接コピーすることを決定する場合があります。
CodeBloat アプリでは、生成されたすべてのクラスの doSomething() メソッドは method0() を呼び出すだけです。speed モードでコンパイルすると、ART の最適化コンパイラは method0() を doSomething() にインライン化する可能性が高くなります。
演習: デバイスの oatdump を使用して、以下を確認します。
# 1. Find the path to the application's APK and compiled .odex file
adb shell pm path com.android.codebloat
# Output: package:/data/app/~~.../base.apk

adb shell "dumpsys package com.android.codebloat | grep 'location is' | head -n 1"
# Example output: [location is /data/app/~~.../oat/arm64/base.odex]

# 2. Run oatdump (substituting the correct path to base.odex)
adb shell oatdump --oat-file=/data/app/~~.../oat/arm64/base.odex \
                  --class-filter=com.android.codebloat.GeneratedClass0
出力で doSomething メソッドを探します。インライン化された場合は、method0 をターゲットとする bl 命令ではなく、長い文字列定数を直接 doSomething 内に読み込む命令が表示されます。
最適化(CFG)を可視化する
コンパイラがメソッドをインライン化することを決定した正確なタイミングを確認するには、制御フロー グラフ(CFG)を生成します。これは、コードがターゲット ISA(ARM64 など)に変換されるまで、コンパイラの中間表現(IR)に対するすべての変換を含む、最適化パイプラインのすべての段階でのコードの状態を示します。
ダンプフラグで
dex2oatを実行する:--verbose-methodsフラグを使用して、出力を特定の方法に制限します。そうしないと、大きなアプリの.cfgファイルが数ギガバイトにまで増大する可能性があります。# Substitution of actual paths required: adb shell dex2oat64 --dex-file=/data/app/~~.../base.apk \ --oat-file=/data/local/tmp/dump.odex \ --compiler-filter=speed \ --dump-cfg=/data/local/tmp/codebloat.cfg \ --verbose-methods=doSomethingPull and View:
.cfgファイルをワークステーションにプルし、IR Hydra で開きます。インライナーを見つける: IR Hydra でコンパイル アーティファクトを読み込み、
doSomethingを検索します。インライナー パスの前後の表現を比較します。method0からの命令が呼び出し元に統合されると、グラフが拡大されます。
または、Compiler Explorer の Opt Pipeline ツール(上記のセクションで説明)を使用して、同様のコードを入力すると、インライナー パスで同様の変換が実行されます。
演習: volatile フィールドとメモリバリア
MemoryLab アプリでは、mGarbageSink フィールドが volatile とマークされています。これにより、コンパイラがガベージ割り当てを最適化して削除しないようにします。
public volatile byte[] mGarbageSink;
ARM64 の逆アセンブリでは、このフィールドへのすべてのストアに メモリバリア(dmb ish)が伴うか、ロード取得/ストア リリース命令(ldar/stlr)が使用されていることがわかります。これにより、スレッドの可視性が確保されますが、すべてのアクセスにいくつかの追加命令が追加されるため、通常のフィールドと比較してコードサイズがわずかに増加します。
演習: 分解されたコードでフィールド アクセスと関連するメモリバリアを見つけます。
演習: 暗黙的な一時停止チェック
generateAllocationChurn のようなループを逆アセンブルすると、ループ本体の最後に奇妙な命令があることに気づきます。
ldr x21, [x21]
これは暗黙的な一時停止チェックです。ART はこれを使用して、ガベージ コレクタがスレッドを安全に一時停止できるようにします。レジスタ x21 は通常、それ自体を指します。GC がスレッドを一時停止する必要がある場合、そのメモリ位置を「汚染」します。次にスレッドが ldr を実行すると、障害がトリガーされます。ランタイムは障害をキャッチし、スレッドを一時停止状態に移行するために使用します。
このパターンはすべてのループとすべてのメソッドの先頭で繰り返され、アプリケーションのコードサイズの合計に影響します。
演習: メソッドの逆アセンブリで暗黙的な一時停止チェックをすべて見つけ、元のソースコードと関連付けてみてください。