

Android Neural Networks API (NNAPI) হল একটি Android C API যা Android ডিভাইসে মেশিন লার্নিংয়ের জন্য কম্পিউটেশনাল ইনটেনসিভ অপারেশন চালানোর জন্য ডিজাইন করা হয়েছে। NNAPI-কে এমনভাবে ডিজাইন করা হয়েছে যাতে এটি TensorFlow Lite ও Caffe2-এর মতো উচ্চ-স্তরের মেশিন লার্নিং ফ্রেমওয়ার্কের জন্য কার্যকারিতার একটি বেস লেয়ার প্রদান করতে পারে, যা নিউরাল নেটওয়ার্ক তৈরি ও প্রশিক্ষণ দেয়। Android 8.1 (API লেভেল ২৭) বা তার পরবর্তী যেকোনও ভার্সনে রান করা সব Android ডিভাইসে API উপলভ্য, তবে Android 15-এ এটি বন্ধ করে দেওয়া হয়েছে।
NNAPI, Android ডিভাইস থেকে ডেটা আগে থেকে প্রশিক্ষিত, ডেভেলপার-নির্ধারিত মডেলে প্রয়োগ করে অনুমান করতে সাহায্য করে। ইনফারেন্সিংয়ের উদাহরণের মধ্যে রয়েছে ছবি শ্রেণীবদ্ধ করা, ব্যবহারকারীর আচরণ অনুমান করা এবং সার্চ কোয়েরির জন্য উপযুক্ত উত্তর বেছে নেওয়া।
অন-ডিভাইস ইনফারেন্সিংয়ের অনেক সুবিধা আছে:
- লেটেন্সি: আপনাকে নেটওয়ার্ক কানেকশনের মাধ্যমে অনুরোধ পাঠাতে এবং উত্তরের জন্য অপেক্ষা করতে হবে না। যেমন, ভিডিও অ্যাপ্লিকেশনের জন্য এটি গুরুত্বপূর্ণ হতে পারে যা ক্যামেরা থেকে আসা পরপর ফ্রেম প্রসেস করে।
- উপলভ্যতা: নেটওয়ার্ক কভারেজের বাইরে থাকলেও অ্যাপ্লিকেশনটি কাজ করে।
- স্পিড: নিউরাল নেটওয়ার্ক প্রসেসিংয়ের জন্য নির্দিষ্ট নতুন হার্ডওয়্যার সাধারণ-উদ্দেশ্যে ব্যবহৃত CPU-এর তুলনায় অনেক দ্রুত গণনা করে।
- গোপনীয়তা: ডেটা Android ডিভাইস থেকে সরানো হয় না।
- খরচ: Android ডিভাইসে সব গণনা করা হলে, কোনও সার্ভার ফার্মের প্রয়োজন হয় না।
এছাড়াও, ডেভেলপারকে কিছু বিষয় মাথায় রাখতে হবে:
- সিস্টেমের ব্যবহার: নিউরাল নেটওয়ার্ক মূল্যায়ন করার জন্য অনেক কম্পিউটেশন প্রয়োজন হয়, যার ফলে ব্যাটারির চার্জ বেশি খরচ হতে পারে। আপনার অ্যাপের ক্ষেত্রে ব্যাটারির আয়ু নিয়ে কোনও সমস্যা থাকলে, বিশেষ করে দীর্ঘ সময় ধরে চলা কম্পিউটেশনের ক্ষেত্রে, ব্যাটারির আয়ু মনিটর করার কথা বিবেচনা করা উচিত।
- অ্যাপ্লিকেশনের সাইজ: আপনার মডেলের সাইজের দিকে মনোযোগ দিন। মডেলগুলি একাধিক মেগাবাইট জায়গা নিতে পারে। আপনার APK-তে বড় মডেল বান্ডেল করলে ব্যবহারকারীদের উপর অযথা প্রভাব পড়তে পারে, তাই অ্যাপ ইনস্টল করার পরে মডেল ডাউনলোড করার কথা বিবেচনা করতে পারেন, ছোট মডেল ব্যবহার করতে পারেন অথবা ক্লাউডে আপনার কম্পিউটেশন চালাতে পারেন। NNAPI ক্লাউডে মডেল চালানোর জন্য কার্যকারিতা প্রদান করে না।
NNAPI কীভাবে ব্যবহার করতে হয় তার একটি উদাহরণ দেখতে Android Neural Networks API স্যাম্পেল দেখুন।
Neural Networks API রানটাইম সম্পর্কে বোঝা
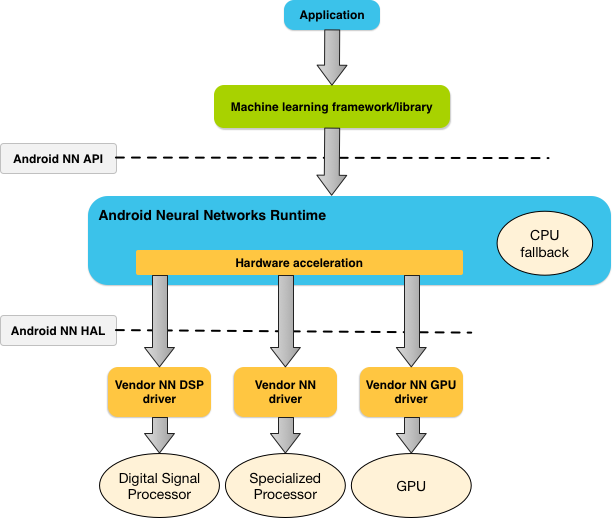
NNAPI-কে মেশিন লার্নিং লাইব্রেরি, ফ্রেমওয়ার্ক ও টুলের মাধ্যমে কল করা হয়, যার সাহায্যে ডেভেলপাররা তাদের মডেল অফ-ডিভাইস ট্রেনিং দিতে এবং Android ডিভাইসে ডিপ্লয় করতে পারেন। অ্যাপ সাধারণত সরাসরি NNAPI ব্যবহার করে না, পরিবর্তে উচ্চ-লেভেলের মেশিন লার্নিং ফ্রেমওয়ার্ক ব্যবহার করে। এই ফ্রেমওয়ার্কগুলি পরিবর্তে NNAPI ব্যবহার করে কাজ করে এমন ডিভাইসে হার্ডওয়্যার-অ্যাক্সিলারেটেড ইনফারেন্স অপারেশন করতে পারে।
Android ডিভাইসে অ্যাপের প্রয়োজনীয়তা ও হার্ডওয়্যার ক্ষমতার উপর ভিত্তি করে, Android-এর নিউরাল নেটওয়ার্ক রানটাইম, ডিভাইসে উপলভ্য প্রসেসর জুড়ে কম্পিউটেশন ওয়ার্কলোড দক্ষতার সাথে ডিস্ট্রিবিউট করতে পারে, এর মধ্যে ডেডিকেটেড নিউরাল নেটওয়ার্ক হার্ডওয়্যার, গ্রাফিক্স প্রসেসিং ইউনিট (GPU) ও ডিজিটাল সিগন্যাল প্রসেসর (DSP) অন্তর্ভুক্ত।
Android ডিভাইসে বিশেষ ভেন্ডর ড্রাইভার না থাকলে, NNAPI রানটাইম CPU-তে অনুরোধ কার্যকর করে।
১ নম্বর ছবিতে NNAPI-এর হাই-লেভেল সিস্টেম আর্কিটেকচার দেখানো হয়েছে।
Neural Networks API প্রোগ্রামিং মডেল
NNAPI ব্যবহার করে কম্পিউটেশন করতে, আপনাকে প্রথমে একটি ডিরেক্টেড গ্রাফ তৈরি করতে হবে যা কম্পিউটেশনকে সংজ্ঞায়িত করে। এই কম্পিউটেশন গ্রাফ, আপনার ইনপুট ডেটার সাথে (যেমন, মেশিন লার্নিং ফ্রেমওয়ার্ক থেকে পাস করা ওয়েট ও বায়াস) যুক্ত হয়ে NNAPI রানটাইম মূল্যায়নের জন্য মডেল তৈরি করে।
NNAPI চারটি প্রধান অ্যাবস্ট্রাকশন ব্যবহার করে:
- মডেল: গাণিতিক অপারেশন এবং ট্রেনিং প্রসেসের মাধ্যমে শেখা ধ্রুবক মানের একটি কম্পিউটেশন গ্রাফ। এইসব অপারেশন নিউরাল নেটওয়ার্কের
জন্য নির্দিষ্ট। এর মধ্যে ২-ডাইমেনশনাল (2D)
কনভোলিউশন,
লজিস্টিক
(সিগময়েড)
অ্যাক্টিভেশন,
রেক্টিফায়েড লিনিয়ার
(ReLU) অ্যাক্টিভেশন এবং আরও অনেক কিছু অন্তর্ভুক্ত। মডেল তৈরি করা একটি সিঙ্ক্রোনাস অপারেশন।
এটি তৈরি করা হয়ে গেলে, থ্রেড ও কম্পাইলেশন জুড়ে এটি আবার ব্যবহার করা যাবে।
NNAPI-তে, একটি মডেলকে
ANeuralNetworksModelইনস্ট্যান্স হিসেবে দেখানো হয়। - কম্পাইলেশন: NNAPI মডেলকে লোয়ার-লেভেল কোডে কম্পাইল করার জন্য কনফিগারেশনকে দেখায়। কম্পাইলেশন তৈরি করা হল একটি সিঙ্ক্রোনাস অপারেশন। একবার
সফলভাবে তৈরি করা হলে, এটি থ্রেড এবং এক্সিকিউশন জুড়ে আবার ব্যবহার করা যেতে পারে। NNAPI-তে, প্রতিটি কম্পাইলেশনকে একটি
ANeuralNetworksCompilationইনস্ট্যান্স হিসেবে দেখানো হয়। - মেমরি: শেয়ার করা মেমরি, মেমরি ম্যাপ করা ফাইল এবং একই ধরনের মেমরি
বাফারকে বোঝায়। মেমরি বাফার ব্যবহার করলে NNAPI রানটাইম আরও দক্ষতার সাথে ড্রাইভারদের কাছে ডেটা ট্রান্সফার করতে পারে। একটি অ্যাপ সাধারণত একটি শেয়ার্ড মেমরি বাফার তৈরি করে যা
একটি মডেল সংজ্ঞায়িত করার জন্য প্রয়োজনীয় প্রতিটি টেনসর ধারণ করে। এছাড়াও, আপনি এক্সিকিউশন ইনস্ট্যান্সের জন্য ইনপুট ও আউটপুট স্টোর করতে
মেমরি বাফার ব্যবহার করতে পারেন। NNAPI-তে,
প্রতিটি মেমরি বাফারকে
ANeuralNetworksMemoryইনস্ট্যান্স হিসেবে দেখানো হয়। এক্সিকিউশন: ইনপুটের সেটে NNAPI মডেল প্রয়োগ করা এবং ফলাফল সংগ্রহ করার ইন্টারফেস। সিঙ্ক্রোনাস বা অ্যাসিঙ্ক্রোনাস পদ্ধতিতে এক্সিকিউশন করা যেতে পারে।
অ্যাসিঙ্ক্রোনাস এক্সিকিউশনের জন্য, একাধিক থ্রেড একই এক্সিকিউশনের জন্য অপেক্ষা করতে পারে। এই এক্সিকিউশন সম্পূর্ণ হলে, সব থ্রেড রিলিজ করা হয়।
NNAPI-তে, প্রতিটি এক্সিকিউশনকে একটি
ANeuralNetworksExecutionইনস্ট্যান্স হিসেবে দেখানো হয়।
ছবি ২-এ বেসিক প্রোগ্রামিং ফ্লো দেখানো হয়েছে।
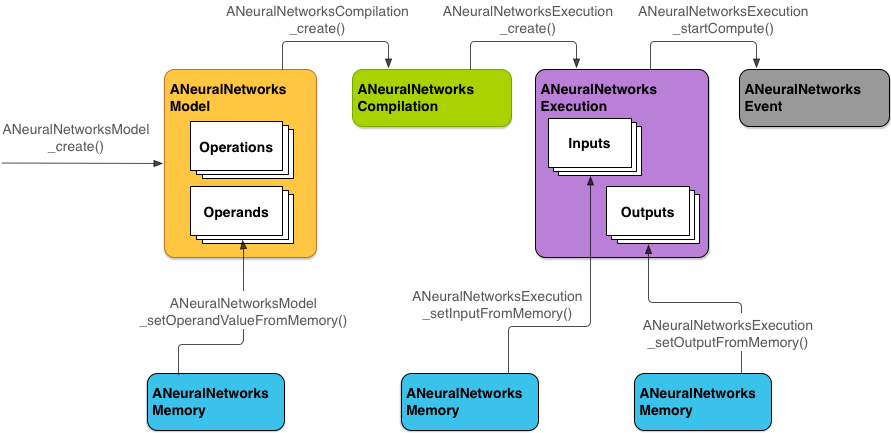
এই বিভাগের বাকি অংশে আপনার NNAPI মডেল সেট-আপ করার ধাপগুলি বর্ণনা করা হয়েছে গণনা সম্পাদন, মডেল কম্পাইল এবং কম্পাইল করা মডেল কার্যকর করা।
ট্রেনিং ডেটায় অ্যাক্সেস প্রদান করা
আপনার ট্রেনিংপ্রাপ্ত ওয়েট ও পক্ষপাত ডেটা সম্ভবত কোনও ফাইলে স্টোর করা থাকে। NNAPI রানটাইমকে
এই ডেটায় দক্ষ অ্যাক্সেস প্রদান করতে, ANeuralNetworksMemory_createFromFd()
ফাংশন কল করে এবং খোলা ডেটা ফাইলের ফাইল ডেসক্রিপ্টরে পাস করে একটি
ANeuralNetworksMemory
ইনস্ট্যান্স তৈরি করুন। এছাড়াও, আপনি
মেমরি সুরক্ষা ফ্ল্যাগ এবং একটি অফসেট নির্দিষ্ট করেন যেখানে শেয়ার করা মেমরি অঞ্চল
ফাইলে শুরু হয়।
// Create a memory buffer from the file that contains the trained data
ANeuralNetworksMemory* mem1 = NULL;
int fd = open("training_data", O_RDONLY);
ANeuralNetworksMemory_createFromFd(file_size, PROT_READ, fd, 0, &mem1);
যদিও এই উদাহরণে আমরা সব ওয়েটের জন্য শুধুমাত্র একটি
ANeuralNetworksMemory
ইনস্ট্যান্স ব্যবহার করি, একাধিক ফাইলের জন্য একাধিক
ANeuralNetworksMemory ইনস্ট্যান্স ব্যবহার করা সম্ভব।
নেটিভ হার্ডওয়্যার বাফার ব্যবহার করুন
মডেল ইনপুট, আউটপুট এবং কনস্ট্যান্ট অপারেন্ড ভ্যালুর জন্য
আপনি নেটিভ হার্ডওয়্যার বাফার ব্যবহার করতে পারবেন। কিছু ক্ষেত্রে, ড্রাইভারের ডেটা কপি করার প্রয়োজন ছাড়াই
NNAPI অ্যাক্সিলারেটর
AHardwareBuffer
অবজেক্ট অ্যাক্সেস করতে পারে। AHardwareBuffer-এর অনেক
বিভিন্ন কনফিগারেশন আছে এবং প্রতিটি NNAPI অ্যাক্সিলারেটর এইসব কনফিগারেশনের সবকটি
সমর্থন নাও করতে পারে। এই সীমাবদ্ধতার কারণে, ANeuralNetworksMemory_createFromAHardwareBuffer রেফারেন্স ডকুমেন্টেশনে
তালিকাভুক্ত সীমাবদ্ধতাগুলি দেখুন
এবং টার্গেট ডিভাইসে সময়ের আগেই পরীক্ষা করুন যাতে AHardwareBuffer ব্যবহার করে কম্পাইলেশন এবং এক্সিকিউশন
প্রত্যাশিতভাবে কাজ করে, এক্সিলারেটর নির্দিষ্ট করতে
ডিভাইস অ্যাসাইনমেন্ট ব্যবহার করুন।
NNAPI রানটাইমকে AHardwareBuffer অবজেক্ট অ্যাক্সেস করার অনুমতি দিতে, ANeuralNetworksMemory_createFromAHardwareBuffer ফাংশন কল করে এবং
AHardwareBuffer অবজেক্ট পাস করে একটি
ANeuralNetworksMemory
ইনস্ট্যান্স তৈরি করুন, যেমনটি নিম্নলিখিত কোড স্যাম্পেলে দেখানো হয়েছে:
// Configure and create AHardwareBuffer object
AHardwareBuffer_Desc desc = ...
AHardwareBuffer* ahwb = nullptr;
AHardwareBuffer_allocate(&desc, &ahwb);

// Create ANeuralNetworksMemory from AHardwareBuffer
ANeuralNetworksMemory* mem2 = NULL;
ANeuralNetworksMemory_createFromAHardwareBuffer(ahwb, &mem2);
NNAPI-এর যখন আর AHardwareBuffer অবজেক্ট অ্যাক্সেস করার প্রয়োজন হবে না, তখন সংশ্লিষ্ট ANeuralNetworksMemory ইনস্ট্যান্স ফ্রি করে দিন:
ANeuralNetworksMemory_free(mem2);
মনে রাখবেন:
- আপনি
AHardwareBufferশুধুমাত্র সম্পূর্ণ বাফারের জন্য ব্যবহার করতে পারবেন; আপনি এটিARectপ্যারামিটারের সাথে ব্যবহার করতে পারবেন না। - NNAPI রানটাইম বাফার ফ্লাশ করবে না। এক্সিকিউশন শিডিউল করার আগে আপনাকে নিশ্চিত করতে হবে যে ইনপুট এবং আউটপুট বাফারগুলি অ্যাক্সেসযোগ্য।
- সিঙ্ক ফেন্স ফাইল ডেসক্রিপটরের জন্য কোনও সহায়তা নেই।
- ভেন্ডর-নির্দিষ্ট ফর্ম্যাট এবং ব্যবহার বিট সহ
AHardwareBuffer-এর জন্য, ক্যাশে ফ্লাশ করার জন্য ক্লায়েন্ট বা ড্রাইভার দায়ী কিনা তা নির্ধারণ করা ভেন্ডর প্রয়োগের উপর নির্ভর করে।
মডেল
NNAPI-তে কম্পিউটেশনের মৌলিক ইউনিট হল মডেল। প্রতিটি মডেল এক বা একাধিক অপারেন্ড এবং অপারেশন দ্বারা সংজ্ঞায়িত করা হয়।
অপারেন্ড
অপারেন্ড হল ডেটা অবজেক্ট যা গ্রাফ সংজ্ঞায়িত করতে ব্যবহৃত হয়। এর মধ্যে মডেলের ইনপুট ও আউটপুট, ইন্টারমিডিয়েট নোড যাতে এক অপারেশন থেকে অন্য অপারেশনে প্রবাহিত ডেটা থাকে এবং এইসব অপারেশনে পাস করা কনস্ট্যান্ট অন্তর্ভুক্ত।
NNAPI মডেলে দুই ধরনের অপারেন্ড যোগ করা যেতে পারে: স্কেলার এবং টেনসর।
স্কেলার একটি একক মানকে প্রতিনিধিত্ব করে। NNAPI বুলিয়ান, ১৬-বিট ফ্লোটিং পয়েন্ট, ৩২-বিট ফ্লোটিং পয়েন্ট, ৩২-বিট ইন্টিজার এবং আনসাইনড ৩২-বিট ইন্টিজার ফর্ম্যাটে স্কেলার ভ্যালু সাপোর্ট করে।
NNAPI-তে বেশিরভাগ অপারেশনে টেনসর থাকে। টেনসর হল n-ডাইমেনশনাল অ্যারে। NNAPI-তে ১৬-বিট ফ্লোটিং পয়েন্ট, ৩২-বিট ফ্লোটিং পয়েন্ট, ৮-বিট কোয়ান্টাইজড, ১৬-বিট কোয়ান্টাইজড, ৩২-বিট ইন্টিজার ও ৮-বিট বুলিয়ান ভ্যালু সহ টেনসর কাজ করে।
যেমন, চিত্র ৩-এ এমন একটি মডেল দেখানো হয়েছে যাতে দুটি অপারেশন রয়েছে: একটি যোগ এবং তারপরে একটি গুণ। মডেলটি একটি ইনপুট টেনসর নেয় এবং একটি আউটপুট টেনসর তৈরি করে।
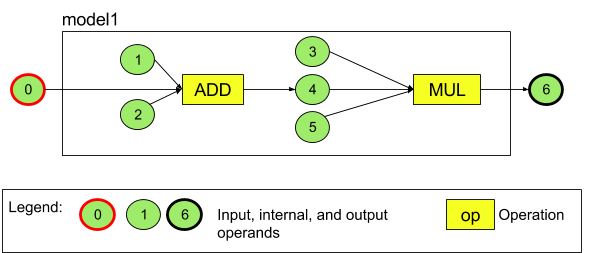
উপরের মডেলে সাতটি অপারেন্ড আছে। এইসব অপারেন্ডকে মডেলে যোগ করার ক্রমের ইন্ডেক্স অনুযায়ী অপ্রত্যক্ষভাবে শনাক্ত করা হয়। প্রথম যোগ করা অপারেন্ডের ইন্ডেক্স হল ০, দ্বিতীয়টির ইন্ডেক্স হল ১ এবং এইভাবে চলতে থাকে। ১, ২, ৩ ও ৫ হল কনস্ট্যান্ট অপারেন্ড।
আপনি যে ক্রমে অপারেন্ড যোগ করেন তা গুরুত্বপূর্ণ নয়। যেমন, মডেল আউটপুট অপারেন্ড প্রথম যোগ করা হতে পারে। গুরুত্বপূর্ণ বিষয় হল, অপারেন্ড উল্লেখ করার সময় সঠিক ইন্ডেক্স ভ্যালু ব্যবহার করা।
অপারেন্ডের ধরন আছে। মডেলে যোগ করার সময় এগুলি উল্লেখ করা হয়।
কোনও অপারেন্ডকে মডেলের ইনপুট এবং আউটপুট, দুটির জন্যই ব্যবহার করা যাবে না।
প্রতিটি অপারেন্ডকে অবশ্যই একটি মডেল ইনপুট, একটি ধ্রুবক বা ঠিক একটি অপারেশনের আউটপুট অপারেন্ড হতে হবে।
অপারেন্ড ব্যবহার করার বিষয়ে আরও তথ্যের জন্য, অপারেন্ড সম্পর্কে আরও তথ্য দেখুন।
অপারেশন
একটি অপারেশন কোন গণনা করতে হবে তা নির্দিষ্ট করে। প্রতিটি অপারেশনে এইসব এলিমেন্ট থাকে:
- অপারেশনের ধরন (যেমন, যোগ, গুণ, কনভোলিউশন),
- ইনপুটের জন্য অপারেশন ব্যবহার করে এমন অপারেন্ডের ইন্ডেক্সের তালিকা এবং
- অপারেন্ডের ইনডেক্সের তালিকা যা অপারেশন আউটপুটের জন্য ব্যবহার করে।
এইসব তালিকার ক্রম গুরুত্বপূর্ণ; প্রতিটি অপারেশন ধরনের প্রত্যাশিত ইনপুট ও আউটপুটের জন্য NNAPI API রেফারেন্স দেখুন।
অপারেশন যোগ করার আগে, অপারেশন যে অপারেন্ড ব্যবহার বা তৈরি করে তা আপনাকে মডেলে যোগ করতে হবে।
আপনি কোন ক্রমে অপারেশন যোগ করছেন তা গুরুত্বপূর্ণ নয়। অপারেশনগুলি যে ক্রমে কার্যকর করা হয় তা নির্ধারণ করতে NNAPI অপারেন্ড এবং অপারেশনের কম্পিউটেশন গ্রাফ দ্বারা প্রতিষ্ঠিত নির্ভরতার উপর নির্ভর করে।
NNAPI যেসব অপারেশন সাপোর্ট করে সেগুলি নিচের টেবিলে সংক্ষেপে দেওয়া হল:
API লেভেল ২৮-এ পরিচিত সমস্যা:
ANEURALNETWORKS_TENSOR_QUANT8_ASYMM
অপারেশনে
ANEURALNETWORKS_PAD
টেনসর পাস করার সময়, যা Android 9 (API লেভেল ২৮) এবং তার পরবর্তী ভার্সনে উপলভ্য, NNAPI থেকে পাওয়া আউটপুট, TensorFlow Lite-এর মতো উচ্চ-লেভেলের মেশিন লার্নিং ফ্রেমওয়ার্ক থেকে পাওয়া আউটপুটের সাথে নাও মিলতে পারে। এর পরিবর্তে
আপনাকে শুধু
ANEURALNETWORKS_TENSOR_FLOAT32 পাস করতে হবে।
Android 10 (API লেভেল ২৯) এবং তার পরবর্তী ভার্সনে এই সমস্যার সমাধান করা হয়েছে।
মডেল তৈরি করুন
নিম্নলিখিত উদাহরণে, আমরা দুটি-অপারেশন মডেল তৈরি করি যা ছবি ৩-এ পাওয়া যায়।
মডেল তৈরি করতে, এই ধাপগুলি অনুসরণ করুন:
একটি খালি মডেল সংজ্ঞায়িত করতে
ANeuralNetworksModel_create()ফাংশন কল করুন।ANeuralNetworksModel* model = NULL; ANeuralNetworksModel_create(&model);
ANeuralNetworks_addOperand()কল করে আপনার মডেলে অপারেন্ড যোগ করুন।ANeuralNetworksOperandTypeডেটা স্ট্রাকচার ব্যবহার করে সেগুলির ডেটার ধরন নির্ধারণ করা হয়।// In our example, all our tensors are matrices of dimension [3][4] ANeuralNetworksOperandType tensor3x4Type; tensor3x4Type.type = ANEURALNETWORKS_TENSOR_FLOAT32; tensor3x4Type.scale = 0.f; // These fields are used for quantized tensors tensor3x4Type.zeroPoint = 0; // These fields are used for quantized tensors tensor3x4Type.dimensionCount = 2; uint32_t dims[2] = {3, 4}; tensor3x4Type.dimensions = dims;
// We also specify operands that are activation function specifiers ANeuralNetworksOperandType activationType; activationType.type = ANEURALNETWORKS_INT32; activationType.scale = 0.f; activationType.zeroPoint = 0; activationType.dimensionCount = 0; activationType.dimensions = NULL;
// Now we add the seven operands, in the same order defined in the diagram ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 0 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 1 ANeuralNetworksModel_addOperand(model, &activationType); // operand 2 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 3 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 4 ANeuralNetworksModel_addOperand(model, &activationType); // operand 5 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 6ধ্রুবক মান আছে এমন অপারেন্ডের জন্য, যেমন আপনার অ্যাপ ট্রেনিং প্রসেস থেকে যে ওয়েট ও বায়াস পায়, সেগুলির ক্ষেত্রে
ANeuralNetworksModel_setOperandValue()এবংANeuralNetworksModel_setOperandValueFromMemory()ফাংশন ব্যবহার করুন।নিচের উদাহরণে, আমরা ট্রেনিং ডেটায় অ্যাক্সেস দিন-এ তৈরি করা মেমরি বাফারের সাথে সম্পর্কিত ট্রেনিং ডেটা ফাইল থেকে কনস্ট্যান্ট ভ্যালু সেট করি।
// In our example, operands 1 and 3 are constant tensors whose values were
// established during the training process
const int sizeOfTensor = 3 * 4 * 4;    // The formula for size calculation is dim0 * dim1 * elementSize
ANeuralNetworksModel_setOperandValueFromMemory(model, 1, mem1, 0, sizeOfTensor);
ANeuralNetworksModel_setOperandValueFromMemory(model, 3, mem1, sizeOfTensor, sizeOfTensor);


// We set the values of the activation operands, in our example operands 2 and 5
int32_t noneValue = ANEURALNETWORKS_FUSED_NONE;
ANeuralNetworksModel_setOperandValue(model, 2, &noneValue, sizeof(noneValue));
ANeuralNetworksModel_setOperandValue(model, 5, &noneValue, sizeof(noneValue));
আপনি গণনা করতে চান এমন নির্দেশিত গ্রাফের প্রতিটি অপারেশনের জন্য,
ANeuralNetworksModel_addOperation()ফাংশন কল করে আপনার মডেলে অপারেশন যোগ করুন।এই কলের প্যারামিটার হিসেবে, আপনার অ্যাপকে অবশ্যই এগুলি প্রদান করতে হবে:
- অপারেশনের ধরন
- ইনপুট ভ্যালুর সংখ্যা
- ইনপুট অপারেন্ডের জন্য ইনডেক্সের অ্যারে
- আউটপুট ভ্যালুর সংখ্যা
- আউটপুট অপারেন্ডের জন্য ইন্ডেক্সের অ্যারে
মনে রাখবেন, একই অপারেশনের ইনপুট ও আউটপুট, দুটির জন্যই অপারেন্ড ব্যবহার করা যাবে না।
// We have two operations in our example // The first consumes operands 1, 0, 2, and produces operand 4 uint32_t addInputIndexes[3] = {1, 0, 2}; uint32_t addOutputIndexes[1] = {4}; ANeuralNetworksModel_addOperation(model, ANEURALNETWORKS_ADD, 3, addInputIndexes, 1, addOutputIndexes);
// The second consumes operands 3, 4, 5, and produces operand 6 uint32_t multInputIndexes[3] = {3, 4, 5}; uint32_t multOutputIndexes[1] = {6}; ANeuralNetworksModel_addOperation(model, ANEURALNETWORKS_MUL, 3, multInputIndexes, 1, multOutputIndexes);ANeuralNetworksModel_identifyInputsAndOutputs()ফাংশন কল করে মডেলের কোন অপারেন্ডকে ইনপুট ও আউটপুট হিসেবে বিবেচনা করা উচিত তা শনাক্ত করুন।// Our model has one input (0) and one output (6) uint32_t modelInputIndexes[1] = {0}; uint32_t modelOutputIndexes[1] = {6}; ANeuralNetworksModel_identifyInputsAndOutputs(model, 1, modelInputIndexes, 1 modelOutputIndexes);
বিকল্প হিসেবে,
ANeuralNetworksModel_relaxComputationFloat32toFloat16()কল করে IEEE 754 ১৬-বিট ফ্লোটিং-পয়েন্ট ফর্ম্যাটের মতো কম রেঞ্জ বা প্রিসিশন সহANEURALNETWORKS_TENSOR_FLOAT32হিসাব করার অনুমতি দেওয়া হবে কিনা তা নির্দিষ্ট করুন।আপনার মডেলের সংজ্ঞা চূড়ান্ত করতে
ANeuralNetworksModel_finish()কল করুন। কোনও সমস্যা না থাকলে, এই ফাংশনটিANEURALNETWORKS_NO_ERROR-এর ফলাফল কোড দেখায়।ANeuralNetworksModel_finish(model);
আপনি কোনও মডেল তৈরি করার পরে, এটি যতবার খুশি কম্পাইল করতে এবং প্রতিটি কম্পাইলেশন যতবার খুশি এক্সিকিউট করতে পারবেন।
কন্ট্রোল ফ্লো
NNAPI মডেলে কন্ট্রোল ফ্লো অন্তর্ভুক্ত করতে, নিম্নলিখিতগুলি করুন:
স্ট্যান্ডঅ্যালোন
ANeuralNetworksModel*মডেল হিসেবে সংশ্লিষ্ট এক্সিকিউশন সাবগ্রাফ (IFস্টেটমেন্টের জন্যthenএবংelseসাবগ্রাফ,WHILEলুপের জন্যconditionএবংbodyসাবগ্রাফ) তৈরি করুন:ANeuralNetworksModel* thenModel = makeThenModel(); ANeuralNetworksModel* elseModel = makeElseModel();
কন্ট্রোল ফ্লো সহ মডেলের মধ্যে সেইসব মডেলকে রেফার করে এমন অপারেন্ড তৈরি করুন:
ANeuralNetworksOperandType modelType = {
    .type = ANEURALNETWORKS_MODEL,
};
ANeuralNetworksModel_addOperand(model, &modelType);  // kThenOperandIndex
ANeuralNetworksModel_addOperand(model, &modelType);  // kElseOperandIndex
ANeuralNetworksModel_setOperandValueFromModel(model, kThenOperandIndex, &thenModel);
ANeuralNetworksModel_setOperandValueFromModel(model, kElseOperandIndex, &elseModel);
কন্ট্রোল ফ্লো অপারেশন যোগ করুন:
uint32_t inputs[] = {kConditionOperandIndex,
                     kThenOperandIndex,
                     kElseOperandIndex,
                     kInput1, kInput2, kInput3};
uint32_t outputs[] = {kOutput1, kOutput2};
ANeuralNetworksModel_addOperation(model, ANEURALNETWORKS_IF,
                                  std::size(inputs), inputs,
                                  std::size(output), outputs);
সংকলন
কম্পাইলেশন স্টেপ নির্ধারণ করে যে কোন প্রসেসরে আপনার মডেল এক্সিকিউট করা হবে এবং সংশ্লিষ্ট ড্রাইভারকে এটি এক্সিকিউট করার জন্য প্রস্তুত হতে বলে। এর মধ্যে আপনার মডেল যে প্রসেসরে রান করবে তার জন্য নির্দিষ্ট মেশিন কোড তৈরি করা অন্তর্ভুক্ত থাকতে পারে।
মডেল কম্পাইল করতে, এই ধাপগুলি অনুসরণ করুন:
নতুন কম্পাইলেশন ইনস্ট্যান্স তৈরি করতে
ANeuralNetworksCompilation_create()ফাংশন কল করুন।// Compile the model ANeuralNetworksCompilation* compilation; ANeuralNetworksCompilation_create(model, &compilation);
বিকল্প হিসেবে, কোন ডিভাইসে এক্সিকিউট করতে হবে তা স্পষ্টভাবে বেছে নিতে আপনি ডিভাইস অ্যাসাইনমেন্ট ব্যবহার করতে পারেন।
রানটাইম কীভাবে ব্যাটারির পাওয়ার ব্যবহার ও এক্সিকিউশন স্পিডের মধ্যে ট্রেড-অফ করে তা আপনি ঐচ্ছিকভাবে প্রভাবিত করতে পারেন। আপনি
ANeuralNetworksCompilation_setPreference()নম্বরে কল করে এটি করতে পারবেন।// Ask to optimize for low power consumption ANeuralNetworksCompilation_setPreference(compilation, ANEURALNETWORKS_PREFER_LOW_POWER);
আপনি যেসব পছন্দ নির্দিষ্ট করতে পারেন তার মধ্যে রয়েছে:
ANEURALNETWORKS_PREFER_LOW_POWER: এমনভাবে এক্সিকিউট করতে পছন্দ করে যাতে ব্যাটারির চার্জ কম খরচ হয়। এটি প্রায়শই কার্যকর করা হয় এমন সংকলনের জন্য বাঞ্ছনীয়।ANEURALNETWORKS_PREFER_FAST_SINGLE_ANSWER: যত দ্রুত সম্ভব একটি উত্তর দিতে পছন্দ করে, এমনকি এর ফলে আরও বেশি বিদ্যুৎ খরচ হলেও। এটি ডিফল্ট বিকল্প।ANEURALNETWORKS_PREFER_SUSTAINED_SPEED: পরপর ফ্রেমের থ্রুপুট বাড়ানোকে অগ্রাধিকার দেয়, যেমন ক্যামেরা থেকে আসা পরপর ফ্রেম প্রসেস করার সময়।
আপনি চাইলে
ANeuralNetworksCompilation_setCachingকল করে কম্পাইলেশন ক্যাশিং সেট-আপ করতে পারেন।// Set up compilation caching ANeuralNetworksCompilation_setCaching(compilation, cacheDir, token);
cacheDir-এর জন্যgetCodeCacheDir()ব্যবহার করুন। অ্যাপ্লিকেশনের মধ্যে প্রতিটি মডেলের জন্য নির্দিষ্ট করাtokenঅনন্য হতে হবে।ANeuralNetworksCompilation_finish()কল করে কম্পাইলেশন সংজ্ঞা চূড়ান্ত করুন। কোনও সমস্যা না থাকলে, এই ফাংশনANEURALNETWORKS_NO_ERROR-এর ফলাফল কোড দেখায়।ANeuralNetworksCompilation_finish(compilation);
ডিভাইস ডিসকভারি ও অ্যাসাইনমেন্ট
Android 10 (API লেভেল ২৯) এবং তার পরবর্তী যেকোনও ভার্সনে চলা Android ডিভাইসে, NNAPI এমন ফাংশন প্রদান করে যা মেশিন লার্নিং ফ্রেমওয়ার্ক লাইব্রেরি এবং অ্যাপকে উপলভ্য ডিভাইস সম্পর্কে তথ্য পেতে এবং এক্সিকিউশনের জন্য ব্যবহার করা হবে এমন ডিভাইস নির্দিষ্ট করতে দেয়। উপলভ্য ডিভাইস সম্পর্কে তথ্য প্রদান করলে, অ্যাপগুলি ডিভাইসে পাওয়া ড্রাইভারের সঠিক ভার্সন পেতে পারে, যাতে পরিচিত অসঙ্গতি এড়ানো যায়। অ্যাপকে এই ক্ষমতা দেওয়ার মাধ্যমে যে কোন ডিভাইসকে মডেলের বিভিন্ন বিভাগ এক্সিকিউট করতে হবে, অ্যাপকে সেই Android ডিভাইসের জন্য অপ্টিমাইজ করা যেতে পারে যেখানে সেগুলি ডেপ্লয় করা হয়েছে।
ডিভাইস খুঁজে পাওয়া
উপলভ্য ডিভাইসের সংখ্যা জানতে
ANeuralNetworks_getDeviceCount
ব্যবহার করুন। প্রতিটি ডিভাইসের জন্য, ANeuralNetworks_getDevice
ব্যবহার করে সেই ডিভাইসের রেফারেন্সে একটি ANeuralNetworksDevice ইনস্ট্যান্স সেট করুন।
ডিভাইস রেফারেন্স পাওয়ার পরে, নিম্নলিখিত ফাংশন ব্যবহার করে আপনি সেই ডিভাইস সম্পর্কে অতিরিক্ত তথ্য খুঁজে পেতে পারেন:
ANeuralNetworksDevice_getFeatureLevelANeuralNetworksDevice_getNameANeuralNetworksDevice_getTypeANeuralNetworksDevice_getVersion
ডিভাইস অ্যাসাইনমেন্ট
নির্দিষ্ট ডিভাইসে কোনও মডেলের কোন অপারেশন চালানো যেতে পারে তা জানতে
ANeuralNetworksModel_getSupportedOperationsForDevices
ব্যবহার করুন।
এক্সিকিউশনের জন্য কোন অ্যাক্সিলারেটর ব্যবহার করতে হবে তা নিয়ন্ত্রণ করতে, ANeuralNetworksCompilation_create-এর পরিবর্তে
ANeuralNetworksCompilation_createForDevices
কল করুন।
ফলাফল হিসেবে পাওয়া ANeuralNetworksCompilation অবজেক্টটি স্বাভাবিকভাবে ব্যবহার করুন।
প্রদান করা মডেলে এমন অপারেশন থাকলে ফাংশনটি একটি ত্রুটি দেখায় যা
বেছে নেওয়া ডিভাইসে কাজ করে না।
একাধিক ডিভাইস উল্লেখ করা থাকলে, রানটাইম বিভিন্ন ডিভাইসে কাজ বন্টন করার জন্য দায়ী থাকে।
অন্যান্য ডিভাইসের মতো, NNAPI CPU ইমপ্লিমেন্টেশনকে ANeuralNetworksDevice দ্বারা দেখানো হয়, যার নাম হল nnapi-reference এবং ধরন হল
ANEURALNETWORKS_DEVICE_TYPE_CPU। ANeuralNetworksCompilation_createForDevices কল করার সময়, মডেল কম্পাইলেশন ও এক্সিকিউশনের ক্ষেত্রে ব্যর্থতা ম্যানেজ করার জন্য CPU ইমপ্লিমেন্টেশন
ব্যবহার করা হয় না।
একটি মডেলকে সাব-মডেলে ভাগ করার দায়িত্ব একটি অ্যাপ্লিকেশনের, যা
নির্দিষ্ট ডিভাইসে চলতে পারে। যেসব অ্যাপ্লিকেশনে ম্যানুয়ালি পার্টিশন করার প্রয়োজন নেই, সেগুলি
মডেলের গতি বাড়াতে উপলভ্য সব ডিভাইস (CPU সহ) ব্যবহার করার জন্য
ANeuralNetworksCompilation_create
কল করা চালিয়ে যেতে হবে। ANeuralNetworksCompilation_createForDevices ব্যবহার করে আপনার উল্লেখ করা ডিভাইসে মডেলটি সম্পূর্ণভাবে কাজ না করলে,
ANEURALNETWORKS_BAD_DATA
রিটার্ন করা হয়।
মডেল পার্টিশনিং
মডেলের জন্য একাধিক ডিভাইস উপলভ্য থাকলে, NNAPI রানটাইম
ডিভাইস জুড়ে কাজ ডিস্ট্রিবিউট করে। যেমন, ANeuralNetworksCompilation_createForDevices-কে একাধিক ডিভাইস দেওয়া হলে, কাজ বরাদ্দ করার সময় নির্দিষ্ট করা সবকটি
ডিভাইস বিবেচনা করা হবে। মনে রাখবেন, CPU ডিভাইস
তালিকায় না থাকলে, CPU এক্সিকিউশন বন্ধ হয়ে যাবে। ANeuralNetworksCompilation_create ব্যবহার করার সময়
CPU সহ উপলভ্য সব ডিভাইস বিবেচনা করা হবে।
মডেলের প্রতিটি অপারেশনের জন্য উপলভ্য ডিভাইসের তালিকা থেকে বেছে নিয়ে ডিস্ট্রিবিউশন করা হয়।
অপারেশনটি সাপোর্ট করে এবং সেরা পারফর্ম্যান্স প্রদান করে এমন ডিভাইস বেছে নেওয়া হয়।
অর্থাৎ, ক্লায়েন্টের উল্লেখ করা এক্সিকিউশন সংক্রান্ত পছন্দের উপর নির্ভর করে সবচেয়ে দ্রুত এক্সিকিউশন টাইম বা
সবচেয়ে কম পাওয়ার খরচ করে এমন ডিভাইস বেছে নেওয়া হয়। এই পার্টিশনিং অ্যালগরিদম বিভিন্ন প্রসেসরের মধ্যে IO-এর কারণে সম্ভাব্য অদক্ষতার জন্য দায়ী নয়, তাই একাধিক প্রসেসর নির্দিষ্ট করার সময় (ANeuralNetworksCompilation_createForDevices ব্যবহার করার সময় স্পষ্টভাবে বা ANeuralNetworksCompilation_create ব্যবহার করে পরোক্ষভাবে) ফলস্বরূপ অ্যাপ্লিকেশনটি প্রোফাইল করা গুরুত্বপূর্ণ।
NNAPI কীভাবে আপনার মডেলকে পার্টিশন করেছে তা বুঝতে, Android লগ থেকে একটি মেসেজ (ExecutionPlan ট্যাগ সহ INFO লেভেলে) চেক করুন:
ModelBuilder::findBestDeviceForEachOperation(op-name): device-index
op-name হল গ্রাফে অপারেশনের বর্ণনামূলক নাম এবং
device-index হল ডিভাইসের তালিকায় সম্ভাব্য ডিভাইসের ইন্ডেক্স।
এই তালিকাটি হল ANeuralNetworksCompilation_createForDevices-এ প্রদান করা ইনপুট
অথবা, ANeuralNetworksCompilation_createForDevices ব্যবহার করলে, ANeuralNetworks_getDeviceCount এবং
ANeuralNetworks_getDevice ব্যবহার করে সব ডিভাইসের উপর পুনরাবৃত্তি করার সময় ফেরত আসা ডিভাইসের তালিকা।
মেসেজ (ExecutionPlan ট্যাগ সহ INFO লেভেলে):
ModelBuilder::partitionTheWork: only one best device: device-name
এই মেসেজ থেকে বোঝা যায় যে ডিভাইসে পুরো গ্রাফের গতি বাড়ানো হয়েছে
device-name.
এক্সিকিউশন
এক্সিকিউশন ধাপটি ইনপুটের একটি সেটে মডেলটি প্রয়োগ করে এবং কম্পিউটেশন আউটপুটগুলি এক বা একাধিক ব্যবহারকারী বাফার বা মেমরি স্পেসে স্টোর করে যা আপনার অ্যাপ বরাদ্দ করেছে।
কম্পাইল করা মডেল এক্সিকিউট করতে, এই ধাপগুলি অনুসরণ করুন:
নতুন এক্সিকিউশন ইনস্ট্যান্স তৈরি করতে
ANeuralNetworksExecution_create()ফাংশন কল করুন।// Run the compiled model against a set of inputs ANeuralNetworksExecution* run1 = NULL; ANeuralNetworksExecution_create(compilation, &run1);
আপনার অ্যাপ গণনার জন্য ইনপুট ভ্যালু কোথা থেকে পড়ে তা উল্লেখ করুন। আপনার অ্যাপ যথাক্রমে
ANeuralNetworksExecution_setInput()বাANeuralNetworksExecution_setInputFromMemory()কল করার মাধ্যমে ব্যবহারকারীর বাফার বা বরাদ্দ করা মেমরি স্পেস থেকে ইনপুট ভ্যালু পড়তে পারে।// Set the single input to our sample model. Since it is small, we won't use a memory buffer float32 myInput[3][4] = { ...the data... }; ANeuralNetworksExecution_setInput(run1, 0, NULL, myInput, sizeof(myInput));
আপনার অ্যাপ কোথায় আউটপুট ভ্যালু লিখবে তা নির্দিষ্ট করুন। আপনার অ্যাপ, যথাক্রমে
ANeuralNetworksExecution_setOutput()বাANeuralNetworksExecution_setOutputFromMemory()কল করে, ব্যবহারকারীর বাফার বা বরাদ্দ করা মেমরি স্পেসে আউটপুট ভ্যালু লিখতে পারে।// Set the output float32 myOutput[3][4]; ANeuralNetworksExecution_setOutput(run1, 0, NULL, myOutput, sizeof(myOutput));
ANeuralNetworksExecution_startCompute()ফাংশন কল করে, এক্সিকিউশন শুরু করার শিডিউল করুন। কোনও সমস্যা না থাকলে, এই ফাংশনANEURALNETWORKS_NO_ERROR-এর ফলাফল কোড দেখায়।// Starts the work. The work proceeds asynchronously ANeuralNetworksEvent* run1_end = NULL; ANeuralNetworksExecution_startCompute(run1, &run1_end);
এক্সিকিউশন সম্পূর্ণ হওয়ার জন্য অপেক্ষা করতে
ANeuralNetworksEvent_wait()ফাংশন কল করুন। এক্সিকিউশন সফল হলে, এই ফাংশনটিANEURALNETWORKS_NO_ERROR-এর একটি ফলাফল কোড রিটার্ন করে। যে থ্রেড এক্সিকিউশন শুরু করছে, তার থেকে আলাদা থ্রেডে অপেক্ষা করা যেতে পারে।// For our example, we have no other work to do and will just wait for the completion ANeuralNetworksEvent_wait(run1_end); ANeuralNetworksEvent_free(run1_end); ANeuralNetworksExecution_free(run1);
বিকল্প হিসেবে, আপনি নতুন
ANeuralNetworksExecutionইনস্ট্যান্স তৈরি করতে একই কম্পাইলেশন ইনস্ট্যান্স ব্যবহার করে কম্পাইল করা মডেলে ইনপুটের অন্য সেট প্রয়োগ করতে পারেন।// Apply the compiled model to a different set of inputs ANeuralNetworksExecution* run2; ANeuralNetworksExecution_create(compilation, &run2); ANeuralNetworksExecution_setInput(run2, ...); ANeuralNetworksExecution_setOutput(run2, ...); ANeuralNetworksEvent* run2_end = NULL; ANeuralNetworksExecution_startCompute(run2, &run2_end); ANeuralNetworksEvent_wait(run2_end); ANeuralNetworksEvent_free(run2_end); ANeuralNetworksExecution_free(run2);
সিঙ্ক্রোনাস এক্সিকিউশন
অ্যাসিঙ্ক্রোনাস এক্সিকিউশন থ্রেড স্পন ও সিঙ্ক করতে সময় নেয়। এছাড়াও, লেটেন্সি অনেক বেশি পরিবর্তনশীল হতে পারে, যেখানে থ্রেডকে বিজ্ঞপ্তি দেওয়া বা জাগিয়ে তোলা এবং অবশেষে এটি সিপিইউ কোরের সাথে বাউন্ড হওয়ার মধ্যে সবচেয়ে দীর্ঘ বিলম্ব ৫০০ মাইক্রোসেকেন্ড পর্যন্ত পৌঁছাতে পারে।
লেটেন্সি উন্নত করতে, আপনি রানটাইমে সিঙ্ক্রোনাস ইনফারেন্স কল করার জন্য কোনও অ্যাপ্লিকেশনকে নির্দেশ দিতে পারেন। ইনফারেন্স শুরু হওয়ার পরে নয়, বরং ইনফারেন্স সম্পূর্ণ হওয়ার পরেই
কলটি রিটার্ন করবে। রানটাইমে
অ্যাসিঙ্ক্রোনাস ইনফারেন্স কলের জন্য
ANeuralNetworksExecution_startCompute
কল করার পরিবর্তে, রানটাইমে সিঙ্ক্রোনাস কল করার জন্য অ্যাপ্লিকেশনটি
ANeuralNetworksExecution_compute
কল করে। ANeuralNetworksExecution_compute-এ করা কল
ANeuralNetworksEvent-এ করা কলের সাথে পেয়ার করা হয় না এবং
ANeuralNetworksEvent_wait-এ করা কলের সাথে পেয়ার করা হয় না।
বার্স্ট এক্সিকিউশন
Android ১০ (API লেভেল ২৯) এবং তার পরবর্তী ভার্সনে চলা Android ডিভাইসে, NNAPI
ANeuralNetworksBurst
অবজেক্টের মাধ্যমে বার্স্ট এক্সিকিউশন সাপোর্ট করে। বার্স্ট এক্সিকিউশন হল একই কম্পাইলেশনের এক্সিকিউশনের একটি ক্রম
যা দ্রুত একের পর এক ঘটে, যেমন ক্যামেরার ক্যাপচার বা পরপর অডিও স্যাম্পেলের ফ্রেমে কাজ করা। ANeuralNetworksBurst অবজেক্ট ব্যবহার করলে
আরও দ্রুত এক্সিকিউশন হতে পারে, কারণ এগুলি অ্যাক্সিলারেটরকে ইঙ্গিত দেয় যে এক্সিকিউশনের মধ্যে রিসোর্স
আবার ব্যবহার করা যেতে পারে এবং বার্স্টের সময় অ্যাক্সিলারেটরকে
হাই-পারফর্ম্যান্স স্টেটে থাকতে হবে।
ANeuralNetworksBurst সাধারণ এক্সিকিউশন পাথে শুধুমাত্র একটি ছোট পরিবর্তন
করে। আপনি
ANeuralNetworksBurst_create
ব্যবহার করে একটি বার্স্ট অবজেক্ট তৈরি করেন,
যেমনটি নিম্নলিখিত কোড স্নিপেটে দেখানো হয়েছে:
// Create burst object to be reused across a sequence of executions
ANeuralNetworksBurst* burst = NULL;
ANeuralNetworksBurst_create(compilation, &burst);
বার্স্ট এক্সিকিউশন সিঙ্ক্রোনাস হয়। তবে, প্রতিটি ইনফারেন্স পারফর্ম করার জন্য
ANeuralNetworksExecution_compute
ব্যবহার করার পরিবর্তে, আপনি ফাংশন
ANeuralNetworksExecution_burstCompute-এ কল করার সময় একই ANeuralNetworksBurst-এর সাথে বিভিন্ন
ANeuralNetworksExecution
অবজেক্ট পেয়ার করেন।
// Create and configure first execution object
// ...

// Execute using the burst object
ANeuralNetworksExecution_burstCompute(execution1, burst);

// Use results of first execution and free the execution object
// ...

// Create and configure second execution object
// ...

// Execute using the same burst object
ANeuralNetworksExecution_burstCompute(execution2, burst);

// Use results of second execution and free the execution object
// ...
ANeuralNetworksBurst অবজেক্টের আর প্রয়োজন না থাকলে
ANeuralNetworksBurst_free
ব্যবহার করে সেটি ফ্রি করুন।
// Cleanup
ANeuralNetworksBurst_free(burst);
অ্যাসিঙ্ক্রোনাস কমান্ড কিউ এবং ফেন্সড এক্সিকিউশন
Android 11 ও তার পরবর্তী ভার্সনে, NNAPI
ANeuralNetworksExecution_startComputeWithDependencies()
পদ্ধতির মাধ্যমে অ্যাসিঙ্ক্রোনাস এক্সিকিউশন শিডিউল করার অতিরিক্ত উপায় প্রদান করে। আপনি এই পদ্ধতি ব্যবহার করলে, মূল্যায়ন শুরু করার আগে, এক্সিকিউশন সবকটি নির্ভর করা
ইভেন্টের সিগন্যাল পাওয়ার জন্য অপেক্ষা করে। এক্সিকিউশন সম্পূর্ণ হয়ে গেলে এবং আউটপুট ব্যবহার করার জন্য রেডি হয়ে গেলে, রিটার্ন করা ইভেন্ট
সিগন্যাল করা হয়।
কোন ডিভাইস এক্সিকিউশন ম্যানেজ করে তার উপর নির্ভর করে, ইভেন্টটি
সিঙ্ক ফেন্স দ্বারা ব্যাক-আপ করা হতে পারে। ইভেন্টের জন্য অপেক্ষা করতে এবং এক্সিকিউশনের মাধ্যমে ব্যবহৃত রিসোর্স পুনরুদ্ধার করতে
আপনাকে
ANeuralNetworksEvent_wait()
কল করতে হবে। আপনি
ANeuralNetworksEvent_createFromSyncFenceFd() ব্যবহার করে
ইভেন্ট অবজেক্টে সিঙ্ক ফেন্স ইমপোর্ট করতে পারবেন
এবং ANeuralNetworksEvent_getSyncFenceFd() ব্যবহার করে
ইভেন্ট অবজেক্ট থেকে সিঙ্ক ফেন্স এক্সপোর্ট করতে পারবেন।
ডায়নামিক সাইজের আউটপুট
যেসব মডেলে আউটপুটের সাইজ ইনপুট ডেটার উপর নির্ভর করে—অর্থাৎ, মডেল এক্সিকিউশনের সময় সাইজ নির্ধারণ করা যায় না—সেগুলি সাপোর্ট করতে
ANeuralNetworksExecution_getOutputOperandRank
এবং
ANeuralNetworksExecution_getOutputOperandDimensions ব্যবহার করুন।
এটি কীভাবে করতে হয় তা নিম্নলিখিত কোডের স্যাম্পেল থেকে জানতে পারবেন:
// Get the rank of the output
uint32_t myOutputRank = 0;
ANeuralNetworksExecution_getOutputOperandRank(run1, 0, &myOutputRank);

// Get the dimensions of the output
std::vector<uint32_t> myOutputDimensions(myOutputRank);
ANeuralNetworksExecution_getOutputOperandDimensions(run1, 0, myOutputDimensions.data());
মুছুন
ক্লিন-আপ ধাপটি আপনার কম্পিউটেশনের জন্য ব্যবহৃত ইন্টার্নাল রিসোর্স খালি করার কাজটি পরিচালনা করে।
// Cleanup
ANeuralNetworksCompilation_free(compilation);
ANeuralNetworksModel_free(model);
ANeuralNetworksMemory_free(mem1);
সমস্যা ম্যানেজমেন্ট ও সিপিইউ (CPU) ফলব্যাক
পার্টিশন করার সময় কোনও সমস্যা হলে, কোনও ড্রাইভার মডেলের (কোনও অংশ) কম্পাইল করতে না পারলে অথবা কোনও ড্রাইভার কম্পাইল করা মডেলের (কোনও অংশ) এক্সিকিউট করতে না পারলে, NNAPI এক বা একাধিক অপারেশনের জন্য নিজের CPU ইমপ্লিমেন্টেশনে ফিরে যেতে পারে।
NNAPI ক্লায়েন্টে যদি অপারেশনের অপ্টিমাইজ করা ভার্সন থাকে (যেমন, TFLite), তাহলে CPU ফলব্যাক বন্ধ করে দেওয়া এবং ক্লায়েন্টের অপ্টিমাইজ করা অপারেশন ইমপ্লিমেন্টেশনের মাধ্যমে ব্যর্থতা ম্যানেজ করা সুবিধাজনক হতে পারে।
Android 10-এ, ANeuralNetworksCompilation_createForDevices ব্যবহার করে কম্পাইলেশন করা হলে, CPU ফলব্যাক বন্ধ করা হবে।
Android P-তে, ড্রাইভারের উপর এক্সিকিউশন ব্যর্থ হলে NNAPI এক্সিকিউশন CPU-তে ফিরে আসে।
Android 10-এর ক্ষেত্রেও এটি প্রযোজ্য, যখন ANeuralNetworksCompilation_createForDevices-এর পরিবর্তে
ANeuralNetworksCompilation_create ব্যবহার করা হয়।
প্রথম এক্সিকিউশন সেই একটি পার্টিশনের জন্য ফলব্যাক করে এবং যদি তা এখনও ব্যর্থ হয়, তাহলে এটি CPU-তে পুরো মডেলটি আবার চেষ্টা করে।
পার্টিশনিং বা কম্পাইলেশন কাজ না করলে, পুরো মডেলটি CPU-তে চেষ্টা করা হবে।
এমন কিছু পরিস্থিতি আছে যেখানে কিছু অপারেশন CPU-তে কাজ করে না এবং এই ধরনের পরিস্থিতিতে কম্পাইলেশন বা এক্সিকিউশন ব্যর্থ হবে, ফলব্যাক হবে না।
CPU ফলব্যাক বন্ধ করার পরেও, মডেলে এখনও এমন অপারেশন থাকতে পারে
যা CPU-তে শিডিউল করা আছে। CPU যদি ANeuralNetworksCompilation_createForDevices-এ সরবরাহ করা প্রসেসরের তালিকায় থাকে এবং
সেটি যদি একমাত্র প্রসেসর হয় যা এইসব অপারেশনকে সাপোর্ট করে অথবা
সেটি যদি এমন প্রসেসর হয় যা এইসব অপারেশনের জন্য সেরা পারফর্ম্যান্সের দাবি করে,
তাহলে এটিকে প্রাথমিক (নন-ফলব্যাক) এক্সিকিউটর হিসেবে বেছে নেওয়া হবে।
কোনও CPU এক্সিকিউশন যাতে না হয় তা নিশ্চিত করতে, ডিভাইসের তালিকা থেকে nnapi-reference বাদ দেওয়ার সময়
ANeuralNetworksCompilation_createForDevices ব্যবহার করুন।
Android P থেকে শুরু করে, debug.nn.partition প্রপার্টি ২-এ সেট করে
DEBUG বিল্ডে এক্সিকিউশনের সময় ফলব্যাক বন্ধ করা সম্ভব।
মেমরি ডোমেন
Android 11 এবং তার পরবর্তী ভার্সনে, NNAPI মেমরি ডোমেনকে সাপোর্ট করে যা অস্বচ্ছ মেমরির জন্য অ্যালোকেটর ইন্টারফেস প্রদান করে। এটি অ্যাপ্লিকেশনকে এক্সিকিউশন জুড়ে ডিভাইস-নেটিভ মেমরি পাস করার অনুমতি দেয়, যাতে একই ড্রাইভারের উপর পরপর এক্সিকিউশন করার সময় NNAPI অপ্রয়োজনীয়ভাবে ডেটা কপি বা ট্রান্সফর্ম না করে।
মেমরি ডোমেন ফিচারটি এমন টেনসরের জন্য তৈরি করা হয়েছে যা বেশিরভাগ ক্ষেত্রে ড্রাইভারের ইন্টার্নাল এবং ক্লায়েন্ট সাইডে ঘন ঘন অ্যাক্সেসের প্রয়োজন হয় না। এই ধরনের টেনসরের উদাহরণের মধ্যে সিকোয়েন্স মডেলে স্টেট টেনসর অন্তর্ভুক্ত। ক্লায়েন্ট সাইডে যেসব টেন্সরের জন্য ঘন ঘন সিপিইউ অ্যাক্সেস প্রয়োজন, সেগুলির জন্য শেয়ার করা মেমরি পুল ব্যবহার করুন।
একটি অস্বচ্ছ মেমরি বরাদ্দ করতে, নিম্নলিখিত ধাপগুলি সম্পাদন করুন:
নতুন মেমরি ডেসক্রিপ্টর তৈরি করতে
ANeuralNetworksMemoryDesc_create()ফাংশন কল করুন:// Create a memory descriptor ANeuralNetworksMemoryDesc* desc; ANeuralNetworksMemoryDesc_create(&desc);
ANeuralNetworksMemoryDesc_addInputRole()এবংANeuralNetworksMemoryDesc_addOutputRole()কল করে সব ইনপুট ও আউটপুট রোল নির্দিষ্ট করুন।// Specify that the memory may be used as the first input and the first output // of the compilation ANeuralNetworksMemoryDesc_addInputRole(desc, compilation, 0, 1.0f); ANeuralNetworksMemoryDesc_addOutputRole(desc, compilation, 0, 1.0f);
ঐচ্ছিকভাবে,
ANeuralNetworksMemoryDesc_setDimensions()কল করে মেমরি ডাইমেনশন নির্দিষ্ট করুন।// Specify the memory dimensions uint32_t dims[] = {3, 4}; ANeuralNetworksMemoryDesc_setDimensions(desc, 2, dims);
ANeuralNetworksMemoryDesc_finish()কল করে ডেসক্রিপ্টরের সংজ্ঞা চূড়ান্ত করুন।ANeuralNetworksMemoryDesc_finish(desc);
ANeuralNetworksMemory_createFromDesc()-এ ডিসক্রিপ্টর পাস করে আপনার প্রয়োজন অনুযায়ী মেমরি বরাদ্দ করুন।// Allocate two opaque memories with the descriptor ANeuralNetworksMemory* opaqueMem; ANeuralNetworksMemory_createFromDesc(desc, &opaqueMem);
মেমরি ডেসক্রিপ্টরের আর প্রয়োজন না থাকলে সেটি খালি করুন।
ANeuralNetworksMemoryDesc_free(desc);
ক্লায়েন্ট শুধু ANeuralNetworksMemory অবজেক্টের সাথে
ANeuralNetworksExecution_setInputFromMemory() বা
ANeuralNetworksExecution_setOutputFromMemory() ব্যবহার করতে পারবেন, যা ANeuralNetworksMemoryDesc অবজেক্টে
উল্লেখ করা ভূমিকা অনুযায়ী হবে। অফসেট এবং দৈর্ঘ্য
আর্গুমেন্ট অবশ্যই 0-তে সেট করতে হবে, যা নির্দেশ করে যে পুরো মেমরি ব্যবহার করা হয়েছে। এছাড়াও, ক্লায়েন্ট
ANeuralNetworksMemory_copy() ব্যবহার করে
মেমরির কন্টেন্ট স্পষ্টভাবে সেট বা এক্সট্র্যাক্ট করতে পারে।
আপনি অনির্দিষ্ট ডাইমেনশন বা র্যাঙ্কের ভূমিকা সহ অস্বচ্ছ মেমরি তৈরি করতে পারেন।
সেই ক্ষেত্রে, মেমরি তৈরি করার প্রসেস ব্যর্থ হতে পারে এবং
ANEURALNETWORKS_OP_FAILED স্ট্যাটাস দেখানো হতে পারে, যদি এটি অন্তর্নিহিত
ড্রাইভার দ্বারা সমর্থিত না হয়। Ashmem বা BLOB-মোড AHardwareBuffer দ্বারা ব্যাক-আপ করা যথেষ্ট বড় বাফার বরাদ্দ করে ক্লায়েন্টকে ফলব্যাক লজিক প্রয়োগ করতে উৎসাহিত করা হয়।
NNAPI-এর যখন আর ওপেকের মেমরি অবজেক্ট অ্যাক্সেস করার প্রয়োজন হবে না, তখন সংশ্লিষ্ট
ANeuralNetworksMemory ইনস্ট্যান্স ফ্রি করুন:
ANeuralNetworksMemory_free(opaqueMem);
পারফরম্যান্স পরিমাপ করা
আপনি এক্সিকিউশন টাইম পরিমাপ করে বা প্রোফাইলিংয়ের মাধ্যমে আপনার অ্যাপের পারফর্ম্যান্স মূল্যায়ন করতে পারেন।
এক্সিকিউশনের সময়
রানটাইমের মাধ্যমে মোট এক্সিকিউশন টাইম নির্ধারণ করতে চাইলে, আপনি
সিঙ্ক্রোনাস এক্সিকিউশন API ব্যবহার করতে এবং কলের মাধ্যমে নেওয়া সময় পরিমাপ করতে পারবেন। আপনি যখন
সফ্টওয়্যার স্ট্যাকের নিম্ন স্তরের মাধ্যমে মোট এক্সিকিউশন টাইম নির্ধারণ করতে চান, তখন আপনি
ANeuralNetworksExecution_setMeasureTiming
এবং
ANeuralNetworksExecution_getDuration
ব্যবহার করে এগুলি পেতে পারেন:
- অ্যাক্সিলারেটরে এক্সিকিউশন টাইম (ড্রাইভারের ক্ষেত্রে নয়, যা হোস্ট প্রসেসরে চলে)।
- ড্রাইভারের এক্সিকিউশন টাইম, এর মধ্যে অ্যাক্সিলারেটরের সময় অন্তর্ভুক্ত।
ড্রাইভারের এক্সিকিউশন টাইমে রানটাইমের মতো ওভারহেড এবং রানটাইমের জন্য ড্রাইভারের সাথে যোগাযোগ করার জন্য প্রয়োজনীয় IPC অন্তর্ভুক্ত থাকে না।
এই APIগুলি জমা দেওয়া কাজ এবং সম্পূর্ণ হওয়া কাজের ইভেন্টের মধ্যেকার সময়কাল পরিমাপ করে, ড্রাইভার বা অ্যাক্সিলারেটর ইনফারেন্স পারফর্ম করার জন্য যে সময় ব্যয় করে তা নয়, সম্ভবত কনটেক্সট সুইচিংয়ের মাধ্যমে বাধাগ্রস্ত হয়।
যেমন, ইনফারেন্স ১ শুরু হওয়ার পরে, ইনফারেন্স ২ পারফর্ম করার জন্য ড্রাইভার কাজ বন্ধ করে দেয়, তারপর ইনফারেন্স ১ আবার শুরু করে সম্পূর্ণ করে, ইনফারেন্স ১-এর এক্সিকিউশন টাইমে ইনফারেন্স ২ পারফর্ম করার জন্য কাজ বন্ধ থাকার সময়ও অন্তর্ভুক্ত থাকবে।
অফলাইনে ব্যবহারের জন্য টেলিমেট্রি সংগ্রহ করতে, কোনও অ্যাপ্লিকেশনের প্রোডাকশন ডেপ্লয়মেন্টের জন্য এই টাইমিং সংক্রান্ত তথ্য উপযোগী হতে পারে। আরও ভালো পারফর্ম্যান্সের জন্য অ্যাপে পরিবর্তন করতে আপনি টাইমিং ডেটা ব্যবহার করতে পারেন।
এই কার্যকারিতা ব্যবহার করার সময়, নিম্নলিখিত বিষয়গুলি মনে রাখবেন:
- সময় সংক্রান্ত তথ্য সংগ্রহ করার জন্য পারফর্ম্যান্সের খরচ হতে পারে।
- NNAPI রানটাইম এবং IPC-তে কাটানো সময় বাদ দিয়ে, শুধুমাত্র একটি ড্রাইভারই নিজের বা অ্যাক্সিলারেটরে কাটানো সময় গণনা করতে সক্ষম।
- আপনি এইসব API শুধুমাত্র
ANeuralNetworksExecution-এর সাথে ব্যবহার করতে পারবেন যাANeuralNetworksCompilation_createForDevices-এর সাথেnumDevices = 1দিয়ে তৈরি করা হয়েছে। - সময়ের তথ্য রিপোর্ট করার জন্য কোনও ড্রাইভারের প্রয়োজন নেই।
Android Systrace-এর মাধ্যমে আপনার অ্যাপ্লিকেশনের প্রোফাইল তৈরি করুন
Android 10 থেকে শুরু করে, NNAPI অটোমেটিক systrace ইভেন্ট তৈরি করে যা আপনি নিজের অ্যাপ্লিকেশনের প্রোফাইল তৈরি করতে ব্যবহার করতে পারেন।
NNAPI সোর্সে একটি parse_systrace ইউটিলিটি থাকে যা আপনার অ্যাপ্লিকেশনের মাধ্যমে তৈরি করা
সিস্ট্রেস ইভেন্ট প্রসেস করে এবং মডেল লাইফসাইকেলের (ইনস্ট্যান্টিয়েশন,
প্রস্তুতি, কম্পাইলেশন এক্সিকিউশন ও টার্মিনেশন) বিভিন্ন পর্যায়ে এবং অ্যাপ্লিকেশনের বিভিন্ন স্তরে
ব্যয় করা সময় দেখিয়ে
একটি টেবিল ভিউ তৈরি করে। আপনার অ্যাপ্লিকেশন যেসব স্তরে বিভক্ত সেগুলি হল:
Application: মূল অ্যাপ্লিকেশন কোডRuntime: NNAPI রানটাইমIPC: NNAPI রানটাইম ও ড্রাইভার কোডের মধ্যে ইন্টার প্রসেস কমিউনিকেশনDriver: অ্যাক্সিলারেটর ড্রাইভার প্রসেস।
প্রোফাইলিং বিশ্লেষণ ডেটা জেনারেট করুন
ধরে নেওয়া যাক যে আপনি $ANDROID_BUILD_TOP-এ AOSP সোর্স ট্রি চেক-আউট করেছেন এবং টার্গেট অ্যাপ্লিকেশন হিসেবে TFLite ইমেজ ক্লাসিফিকেশন উদাহরণ ব্যবহার করছেন, আপনি নিম্নলিখিত ধাপগুলি অনুসরণ করে NNAPI প্রোফাইলিং ডেটা জেনারেট করতে পারবেন:
- নিম্নলিখিত কমান্ডের মাধ্যমে Android সিস্ট্রেস চালু করুন:
$ANDROID_BUILD_TOP/external/chromium-trace/systrace.py -o trace.html -a org.tensorflow.lite.examples.classification nnapi hal freq sched idle load binder_driver
-o trace.html প্যারামিটার থেকে বোঝা যায় যে ট্রেস trace.html-এ
লেখা হবে। নিজের অ্যাপ্লিকেশন প্রোফাইল করার সময় আপনাকে
আপনার অ্যাপ ম্যানিফেস্টে উল্লেখ করা প্রসেসের নাম দিয়ে
org.tensorflow.lite.examples.classification পরিবর্তন করতে হবে।
এটি আপনার একটি শেল কনসোলকে ব্যস্ত রাখবে, ব্যাকগ্রাউন্ডে কমান্ডটি চালাবেন না
কারণ এটি ইন্টার্যাক্টিভভাবে একটি enter বন্ধ হওয়ার জন্য অপেক্ষা করছে।
- সিস্ট্রেস কালেক্টর চালু করার পরে, আপনার অ্যাপ চালু করুন এবং আপনার বেঞ্চমার্ক টেস্ট রান করুন।
আমাদের ক্ষেত্রে, আপনি Android Studio থেকে Image Classification অ্যাপ চালু করতে পারেন অথবা অ্যাপটি আগে থেকেই ইনস্টল করা থাকলে সরাসরি আপনার টেস্ট ফোন UI থেকে চালু করতে পারেন। কিছু NNAPI ডেটা তৈরি করতে, আপনাকে অ্যাপ কনফিগারেশন ডায়ালগে টার্গেট ডিভাইস হিসেবে NNAPI বেছে নিয়ে NNAPI ব্যবহার করার জন্য অ্যাপ কনফিগার করতে হবে।
পরীক্ষা সম্পূর্ণ হয়ে গেলে, ধাপ ১ থেকে চালু থাকা কনসোল টার্মিনালে
enterপ্রেস করে systrace বন্ধ করুন।systrace_parserইউটিলিটি রান করে ক্রমবর্ধমান পরিসংখ্যান জেনারেট করুন:
$ANDROID_BUILD_TOP/frameworks/ml/nn/tools/systrace_parser/parse_systrace.py --total-times trace.html
পার্সার নিম্নলিখিত প্যারামিটার গ্রহণ করে:
- --total-times: একটি লেয়ারে ব্যয় করা মোট সময় দেখায়, যার মধ্যে
অন্তর্নিহিত লেয়ারে কল করার জন্য অপেক্ষা করার সময়ও অন্তর্ভুক্ত
- --print-detail: systrace থেকে সংগ্রহ করা সমস্ত ইভেন্ট প্রিন্ট করে
- --per-execution: সমস্ত পর্যায়ের পরিসংখ্যানের পরিবর্তে শুধুমাত্র এক্সিকিউশন এবং এর সাবফেজগুলি
(প্রতি-এক্সিকিউশন সময় অনুযায়ী) প্রিন্ট করে
- --json: JSON ফর্ম্যাটে আউটপুট তৈরি করে
আউটপুটের একটি উদাহরণ নিচে দেখানো হল:
===========================================================================================================================================
NNAPI timing summary (total time, ms wall-clock)                                                      Execution
                                                           ----------------------------------------------------
              Initialization   Preparation   Compilation           I/O       Compute      Results     Ex. total   Termination        Total
              --------------   -----------   -----------   -----------  ------------  -----------   -----------   -----------   ----------
Application              n/a         19.06       1789.25           n/a           n/a         6.70         21.37           n/a      1831.17*
Runtime                    -         18.60       1787.48          2.93         11.37         0.12         14.42          1.32      1821.81
IPC                     1.77             -       1781.36          0.02          8.86            -          8.88             -      1792.01
Driver                  1.04             -       1779.21           n/a           n/a          n/a          7.70             -      1787.95

Total                   1.77*        19.06*      1789.25*         2.93*        11.74*        6.70*        21.37*         1.32*     1831.17*
===========================================================================================================================================
* This total ignores missing (n/a) values and thus is not necessarily consistent with the rest of the numbers
সংগ্রহ করা ইভেন্ট সম্পূর্ণ অ্যাপ্লিকেশন ট্রেস না দেখালে পার্সার কাজ নাও করতে পারে। বিশেষ করে, কোনও বিভাগের শেষ চিহ্নিত করার জন্য তৈরি করা systrace ইভেন্ট, সংশ্লিষ্ট বিভাগের শুরু চিহ্নিত করার ইভেন্ট ছাড়াই ট্রেসে উপস্থিত থাকলে, এটি ব্যর্থ হতে পারে। আপনি সিস্ট্রেস কালেক্টর চালু করার সময় আগের প্রোফাইলিং সেশন থেকে কিছু ইভেন্ট জেনারেট করা হলে সাধারণত এটি ঘটে। এই ক্ষেত্রে আপনাকে আবার প্রোফাইলিং করতে হবে।
systrace_parser আউটপুটে আপনার অ্যাপ্লিকেশন কোডের জন্য পরিসংখ্যান যোগ করুন
parse_systrace অ্যাপ্লিকেশনটি বিল্ট-ইন Android systrace ফাংশনের উপর ভিত্তি করে তৈরি। আপনি কাস্টম ইভেন্টের নাম সহ systrace API (Java-এর জন্য , নেটিভ অ্যাপ্লিকেশনের জন্য ) ব্যবহার করে আপনার অ্যাপে নির্দিষ্ট অপারেশনের জন্য ট্রেস যোগ করতে পারেন।
অ্যাপ্লিকেশন লাইফসাইকেলের ফেজের সাথে আপনার কাস্টম ইভেন্ট যুক্ত করতে, আপনার ইভেন্টের নামের আগে নিম্নলিখিত স্ট্রিংগুলির মধ্যে একটি যোগ করুন:
[NN_LA_PI]: ইনিশিয়ালাইজেশনের জন্য অ্যাপ্লিকেশন লেভেল ইভেন্ট[NN_LA_PP]: প্রস্তুতির জন্য অ্যাপ্লিকেশন লেভেল ইভেন্ট[NN_LA_PC]: কম্পাইলেশনের জন্য অ্যাপ্লিকেশন লেভেল ইভেন্ট[NN_LA_PE]: এক্সিকিউশনের জন্য অ্যাপ্লিকেশন লেভেল ইভেন্ট
এখানে একটি উদাহরণ দেওয়া হল যে কীভাবে আপনি TFLite ইমেজ ক্লাসিফিকেশন উদাহরণ কোড পরিবর্তন করতে পারেন
Execution ফেজের জন্য runInferenceModel বিভাগ এবং
Application লেয়ার যোগ করে যাতে অন্য বিভাগ preprocessBitmap থাকে যা
NNAPI ট্রেসে বিবেচনা করা হবে না। runInferenceModel বিভাগটি
nnapi systrace পার্সার দ্বারা প্রসেস করা systrace ইভেন্টের অংশ হবে:
Kotlin
/** Runs inference and returns the classification results. */ fun recognizeImage(bitmap: Bitmap): List{ // This section won’t appear in the NNAPI systrace analysis Trace.beginSection("preprocessBitmap") convertBitmapToByteBuffer(bitmap) Trace.endSection() // Run the inference call. // Add this method in to NNAPI systrace analysis. Trace.beginSection("[NN_LA_PE]runInferenceModel") long startTime = SystemClock.uptimeMillis() runInference() long endTime = SystemClock.uptimeMillis() Trace.endSection() ... return recognitions }
জাভা
/** Runs inference and returns the classification results. */ public ListrecognizeImage(final Bitmap bitmap) { // This section won’t appear in the NNAPI systrace analysis Trace.beginSection("preprocessBitmap"); convertBitmapToByteBuffer(bitmap); Trace.endSection(); // Run the inference call. // Add this method in to NNAPI systrace analysis. Trace.beginSection("[NN_LA_PE]runInferenceModel"); long startTime = SystemClock.uptimeMillis(); runInference(); long endTime = SystemClock.uptimeMillis(); Trace.endSection(); ... Trace.endSection(); return recognitions; }
পরিষেবার কোয়ালিটি
Android 11 এবং তার পরবর্তী ভার্সনে, NNAPI আরও ভালো কোয়ালিটির পরিষেবা (QoS) প্রদান করে। এটি কোনও অ্যাপ্লিকেশনকে তার মডেলের আপেক্ষিক অগ্রাধিকার, কোনও নির্দিষ্ট মডেল প্রস্তুত করতে প্রত্যাশিত সর্বোচ্চ সময় এবং কোনও নির্দিষ্ট গণনা সম্পূর্ণ করতে প্রত্যাশিত সর্বোচ্চ সময় নির্দেশ করার অনুমতি দেয়। Android 11-এ অতিরিক্ত NNAPI ফলাফল কোড রয়েছে যা অ্যাপ্লিকেশনকে এক্সিকিউশন ডেডলাইন মিস করার মতো ব্যর্থতা বুঝতে সাহায্য করে।
ওয়ার্কলোডের প্রায়োরিটি সেট করা
NNAPI ওয়ার্কলোডের প্রায়োরিটি সেট করতে, ANeuralNetworksCompilation_finish() কল করার আগে
ANeuralNetworksCompilation_setPriority()
কল করুন।
ডেডলাইন সেট করুন
অ্যাপ্লিকেশন, মডেল কম্পাইলেশন ও ইনফারেন্স, দুটির জন্যই সময়সীমা সেট করতে পারে।
- কম্পাইলেশন টাইমআউট সেট করতে,
ANeuralNetworksCompilation_finish()কল করার আগেANeuralNetworksCompilation_setTimeout()কল করুন। - ইনফারেন্স টাইমআউট সেট করতে, কম্পাইলেশন শুরু করার আগে
ANeuralNetworksExecution_setTimeout()কল করুন।
অপারেন্ড সম্পর্কে আরও তথ্য
নিচের বিভাগে অপারেন্ড ব্যবহার করার বিষয়ে উন্নত বিষয়গুলি কভার করা হয়েছে।
কোয়ান্টাইজড টেনসর
কোয়ান্টাইজড টেনসর হল ফ্লোটিং পয়েন্ট ভ্যালুর n-ডাইমেনশনাল অ্যারে দেখানোর একটি কম্প্যাক্ট উপায়।
NNAPI ৮-বিট অ্যাসিমেট্রিক কোয়ান্টাইজড টেনসর সাপোর্ট করে। এইসব টেনসরের জন্য, প্রতিটি সেলের ভ্যালু ৮-বিট ইন্টিজার দ্বারা দেখানো হয়। টেনসরের সাথে যুক্ত হল একটি স্কেল এবং একটি জিরো পয়েন্ট ভ্যালু। এগুলি ৮-বিট ইন্টিজারকে ফ্লোটিং পয়েন্ট ভ্যালুতে কনভার্ট করতে ব্যবহার করা হয়, যা এখানে দেখানো হচ্ছে।
ফর্মুলাটি হল:
(cellValue - zeroPoint) * scale
যেখানে zeroPoint ভ্যালু হল ৩২-বিট পূর্ণসংখ্যা এবং স্কেল হল ৩২-বিট ফ্লোটিং পয়েন্ট ভ্যালু।
৩২-বিট ফ্লোটিং পয়েন্ট ভ্যালুর টেন্সরের তুলনায়, ৮-বিট কোয়ান্টাইজড টেন্সরের দুটি সুবিধা আছে:
- আপনার অ্যাপ্লিকেশনটি ছোট, কারণ প্রশিক্ষিত ওজনগুলি ৩২-বিট টেনসরের আকারের এক চতুর্থাংশ নেয়।
- কম্পিউটেশন প্রায়শই আরও দ্রুত এক্সিকিউট করা যায়। এর কারণ হল মেমরি থেকে কম পরিমাণ ডেটা ফেচ করতে হয় এবং DSP-এর মতো প্রসেসর পূর্ণসংখ্যার গণিত দক্ষতার সাথে করতে পারে।
ফ্লোটিং পয়েন্ট মডেলকে কোয়ান্টাইজড মডেলে পরিবর্তন করা সম্ভব হলেও, আমাদের অভিজ্ঞতা থেকে দেখা গেছে যে কোয়ান্টাইজড মডেলকে সরাসরি ট্রেনিং দিলে আরও ভালো ফলাফল পাওয়া যায়। কার্যত, নিউরাল নেটওয়ার্ক প্রতিটি ভ্যালুর বর্ধিত গ্র্যানুলারিটির জন্য ক্ষতিপূরণ করতে শেখে। প্রতিটি কোয়ান্টাইজড টেনসরের জন্য, ট্রেনিং প্রসেসের সময় স্কেল এবং zeroPoint ভ্যালু নির্ধারণ করা হয়।
NNAPI-তে, আপনি
ANeuralNetworksOperandType
ডেটা স্ট্রাকচারের ধরন ফিল্ডকে
ANEURALNETWORKS_TENSOR_QUANT8_ASYMM-এ সেট করে কোয়ান্টাইজড টেনসর ধরন সংজ্ঞায়িত করেন।
এছাড়াও, আপনি সেই ডেটা স্ট্রাকচারে টেনসরের স্কেল এবং zeroPoint ভ্যালু নির্দিষ্ট করেন।
৮-বিট অ্যাসিমেট্রিক কোয়ান্টাইজড টেনসর ছাড়াও, NNAPI-তে নিম্নলিখিতগুলি কাজ করে:
ANEURALNETWORKS_TENSOR_QUANT8_SYMM_PER_CHANNELযা আপনিCONV/DEPTHWISE_CONV/TRANSPOSED_CONVঅপারেশনে ওয়েট দেখানোর জন্য ব্যবহার করতে পারবেন।ANEURALNETWORKS_TENSOR_QUANT16_ASYMMযা আপনিQUANTIZED_16BIT_LSTM-এর ইন্টার্নাল স্টেট হিসেবে ব্যবহার করতে পারবেন।ANEURALNETWORKS_TENSOR_QUANT8_SYMMযাANEURALNETWORKS_DEQUANTIZE-এর ইনপুট হতে পারে।
ঐচ্ছিক অপারেন্ড
ANEURALNETWORKS_LSH_PROJECTION-এর মতো
কিছু অপারেশন,
ঐচ্ছিক অপারেন্ড নেয়। মডেলে ঐচ্ছিক অপারেন্ড বাদ দেওয়া হয়েছে তা বোঝাতে, ANeuralNetworksModel_setOperandValue()
ফাংশন কল করুন, বাফারের জন্য NULL এবং দৈর্ঘ্যের জন্য 0 পাস করুন।
প্রতিটি এক্সিকিউশনের জন্য অপারেন্ড উপস্থিত আছে কিনা সেই সংক্রান্ত সিদ্ধান্ত আলাদা হলে,
আপনি ANeuralNetworksExecution_setInput()
বা
ANeuralNetworksExecution_setOutput()
ফাংশন ব্যবহার করে, বাফারের জন্য NULL এবং দৈর্ঘ্যের জন্য 0 পাস করে, অপারেন্ড বাদ দেওয়া হয়েছে বলে উল্লেখ করেন।
অজানা র্যাঙ্কের টেনসর
Android 9 (API লেভেল ২৮) অজানা ডাইমেনশন কিন্তু জানা র্যাঙ্ক (ডাইমেনশনের সংখ্যা) সহ মডেল অপারেন্ড পরিচয় করিয়ে দিয়েছে। Android ১০ (API লেভেল ২৯) অজানা র্যাঙ্কের টেনসর পরিচয় করিয়ে দেয়, যেমন ANeuralNetworksOperandType-এ দেখানো হয়েছে।
NNAPI বেঞ্চমার্ক
NNAPI বেঞ্চমার্ক AOSP-তে platform/test/mlts/benchmark
(বেঞ্চমার্ক অ্যাপ) এবং platform/test/mlts/models (মডেল ও ডেটাসেট)-এ উপলভ্য।
বেঞ্চমার্ক লেটেন্সি ও নির্ভুলতা মূল্যায়ন করে এবং একই মডেল ও ডেটাসেটের জন্য CPU-তে চলা Tensorflow Lite ব্যবহার করে করা একই কাজের সাথে ড্রাইভারের তুলনা করে।
বেঞ্চমার্ক ব্যবহার করতে, নিম্নলিখিত ধাপগুলি অনুসরণ করুন:
আপনার কম্পিউটারের সাথে টার্গেট Android ডিভাইস কানেক্ট করুন, টার্মিনাল উইন্ডো খুলুন এবং নিশ্চিত করুন যে adb-এর মাধ্যমে ডিভাইসটি অ্যাক্সেস করা যাচ্ছে।
একাধিক Android ডিভাইস কানেক্ট করা থাকলে, টার্গেট ডিভাইস
ANDROID_SERIALএনভায়রনমেন্ট ভেরিয়েবল এক্সপোর্ট করুন।Android-এর টপ-লেভেল সোর্স ডিরেক্টরিতে নেভিগেট করুন।
এই কমান্ডগুলি রান করুন:
lunch aosp_arm-userdebug # Or aosp_arm64-userdebug if available
./test/mlts/benchmark/build_and_run_benchmark.sh
বেঞ্চমার্ক রান শেষ হওয়ার পরে, এর ফলাফল
xdg-open-এ পাস করা HTML পৃষ্ঠা হিসেবে দেখানো হবে।
NNAPI লগ
NNAPI সিস্টেম লগে প্রয়োজনীয় ডায়াগনস্টিক তথ্য তৈরি করে। লগ বিশ্লেষণ করতে, logcat ইউটিলিটি ব্যবহার করুন।
নির্দিষ্ট ফেজ বা কম্পোনেন্টের জন্য ভার্বোস NNAPI লগিং চালু করতে,
debug.nn.vlog প্রপার্টি (adb shell ব্যবহার করে) নিম্নলিখিত ভ্যালুর তালিকায় সেট করুন, যেগুলি স্পেস, কোলন বা কমা দিয়ে আলাদা করা আছে:
model: মডেল বিল্ডিংcompilation: মডেল এক্সিকিউশন প্ল্যান ও কম্পাইলেশন তৈরি করাexecution: মডেল এক্সিকিউশনcpuexe: NNAPI CPU ইমপ্লিমেন্টেশন ব্যবহার করে অপারেশন এক্সিকিউট করাmanager: NNAPI এক্সটেনশন, উপলভ্য ইন্টারফেস এবং ক্ষমতা সম্পর্কিত তথ্যallবা1: উপরের সবকটি উপাদান
যেমন, সম্পূর্ণ ভার্বোস লগিং চালু করতে,
adb shell setprop debug.nn.vlog all কমান্ড ব্যবহার করুন। ভার্বোস লগিং বন্ধ করতে, adb shell setprop debug.nn.vlog '""' কমান্ড ব্যবহার করুন।
চালু করা হলে, ভার্বোস লগিং INFO লেভেলে লগ এন্ট্রি তৈরি করে যার সাথে ফেজ বা কম্পোনেন্টের নাম সেট করা থাকে।
debug.nn.vlog কন্ট্রোল করা মেসেজের পাশাপাশি, NNAPI API কম্পোনেন্ট বিভিন্ন লেভেলে অন্যান্য লগ এন্ট্রি প্রদান করে, যার প্রত্যেকটি একটি নির্দিষ্ট লগ ট্যাগ ব্যবহার করে।
কম্পোনেন্টের তালিকা পেতে, নিম্নলিখিত এক্সপ্রেশন ব্যবহার করে সোর্স ট্রি সার্চ করুন:
grep -R 'define LOG_TAG' | awk -F '"' '{print $2}' | sort -u | egrep -v "Sample|FileTag|test"
এই এক্সপ্রেশন বর্তমানে নিম্নলিখিত ট্যাগগুলি রিটার্ন করে:
- BurstBuilder
- কলব্যাক
- CompilationBuilder
- CpuExecutor
- ExecutionBuilder
- ExecutionBurstController
- ExecutionBurstServer
- ExecutionPlan
- FibonacciDriver
- GraphDump
- IndexedShapeWrapper
- IonWatcher
- ম্যানেজার
- মেমরি
- MemoryUtils
- MetaModel
- ModelArgumentInfo
- ModelBuilder
- NeuralNetworks
- OperationResolver
- অপারেশন
- OperationsUtils
- PackageInfo
- TokenHasher
- TypeManager
- Utils
- ValidateHal
- VersionedInterfaces
logcat-এর দেখানো লগ মেসেজের লেভেল নিয়ন্ত্রণ করতে, এনভায়রনমেন্ট ভেরিয়েবল ANDROID_LOG_TAGS ব্যবহার করুন।
NNAPI লগ মেসেজের সম্পূর্ণ সেট দেখাতে এবং অন্য যেকোনও কিছু বন্ধ করতে, ANDROID_LOG_TAGS-কে নিম্নলিখিত হিসেবে
সেট করুন:
BurstBuilder:V Callbacks:V CompilationBuilder:V CpuExecutor:V ExecutionBuilder:V ExecutionBurstController:V ExecutionBurstServer:V ExecutionPlan:V FibonacciDriver:V GraphDump:V IndexedShapeWrapper:V IonWatcher:V Manager:V MemoryUtils:V Memory:V MetaModel:V ModelArgumentInfo:V ModelBuilder:V NeuralNetworks:V OperationResolver:V OperationsUtils:V Operations:V PackageInfo:V TokenHasher:V TypeManager:V Utils:V ValidateHal:V VersionedInterfaces:V *:S.
আপনি নিম্নলিখিত কমান্ড ব্যবহার করে ANDROID_LOG_TAGS সেট করতে পারবেন:
export ANDROID_LOG_TAGS=$(grep -R 'define LOG_TAG' | awk -F '"' '{ print $2 ":V" }' | sort -u | egrep -v "Sample|FileTag|test" | xargs echo -n; echo ' *:S')
মনে রাখবেন, এটি শুধুমাত্র একটি ফিল্টার যা logcat-এর ক্ষেত্রে প্রযোজ্য। আপনাকে এখনও
ভার্বোস লগ তথ্য তৈরি করতে প্রপার্টি debug.nn.vlog থেকে all-এ সেট করতে হবে।