

Meskipun memori sering kali dianggap sebagai kumpulan penyimpanan tunggal yang seragam, organisasi fisiknya dan cara CPU mengaksesnya memiliki dampak besar pada performa aplikasi. Memahami lokalitas memori adalah kunci untuk menulis kode berperforma tinggi yang menggunakan hierarki cache CPU secara efisien.
Hierarki cache CPU
CPU seluler modern jauh lebih cepat daripada RAM utama sistem (DRAM). Untuk menjembatani kesenjangan performa ini, CPU menggunakan beberapa level memori kecil yang sangat cepat yang disebut cache.
- Cache L1 (Level 1): Yang terkecil dan tercepat (~1 ns). Pada CPU 3 GHz, ini sekitar 3 siklus clock.
- Cache L2 (Level 2): Lebih besar dan sedikit lebih lambat (~3-5 ns, atau ~10-15 siklus).
- Cache L3 (Level 3): Cache terbesar (~10-20 ns, atau ~30-60 siklus).
- Memori Utama (DRAM): Terbesar dan paling lambat (~100 ns+, atau ~300+ siklus).
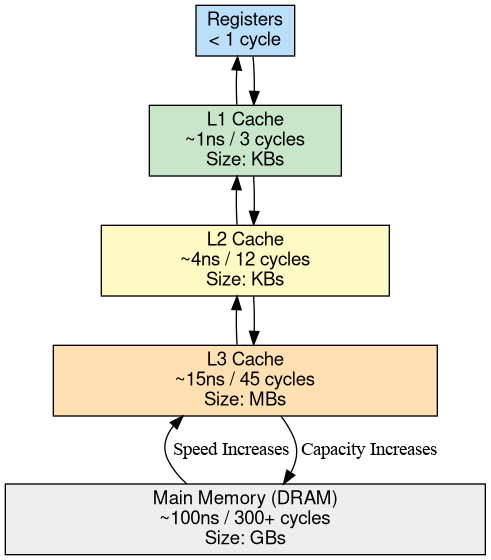
Mengontekstualisasi latensi: biaya jeda
Untuk memahami dampak angka-angka ini, pertimbangkan CPU superskalar modern yang dapat menghentikan 4 hingga 8 petunjuk per siklus clock.
Jika CPU melewatkan semua cache dan harus menunggu 100 ns (300 siklus) untuk pembacaan DRAM:
- Siklus yang Hilang: ~300 siklus.
- Petunjuk "Terbuang" (Wasted): Antara 1.200 dan 2.400 petunjuk yang dapat dieksekusi jika data sudah ada di register lokal atau cache L1.
Jika kode Anda memiliki lokalitas memori yang buruk, CPU tidak selalu sibuk dengan matematika yang kompleks; CPU sering "terhenti", tidak melakukan apa pun selama ribuan setara instruksi sambil menunggu subsistem memori.
Petunjuk per siklus (IPC)
Metrik utama untuk mengukur efisiensi ini adalah Petunjuk Per Siklus (IPC). IPC menunjukkan jumlah petunjuk yang berhasil "dihentikan" (diselesaikan) CPU secara rata-rata selama setiap siklus clock.
- IPC tinggi (misalnya, 3,0 - 5,0): CPU berjalan dengan efisiensi tinggi, kemungkinan menemukan sebagian besar datanya di cache atau register L1/L2.
- IPC rendah (misalnya, < 0,5): CPU mengalami hambatan yang parah. Meskipun CPU berada pada "penggunaan" 100% di monitor sistem, CPU sebenarnya sebagian besar menghabiskan waktu untuk menunggu memori—status yang dikenal sebagai penundaan memori.
Lokalitas memori adalah faktor utama yang menentukan apakah loop intensif data berjalan pada IPC tinggi atau mengalami serangkaian jeda.
Garis cache
CPU tidak memuat byte tunggal dari memori. Sebagai gantinya, mereka memuat blok berukuran tetap yang disebut baris cache, yang biasanya berukuran 64 byte. Saat Anda mengakses satu variabel, CPU akan mengambil seluruh potongan 64 byte yang berisi variabel tersebut ke dalam cache.

TLB (translation lookaside buffer)
Android menggunakan memori virtual. Setiap akses memori memerlukan penerjemahan alamat virtual ke alamat fisik. TLB adalah cache khusus yang menyimpan terjemahan terbaru. TLB miss mengharuskan kernel menelusuri tabel halaman di memori utama, yang merupakan operasi relatif mahal dibandingkan dengan hit TLB.
Profil hardware: Pixel 10 Pro Fold
Untuk latihan berikut, kami menggunakan perangkat hardware Pixel 10 Pro Fold. Perangkat ini dilengkapi SoC Google Tensor G5.
Memeriksa hardware
Untuk memahami subsistem memori, kita pertama-tama memeriksa konfigurasi CPU dan parameter cache.
# Check CPU architecture and core parts
adb shell cat /proc/cpuinfo | grep 'CPU part' | sort -u
# Output:
# CPU part  : 0xd8b
# CPU part  : 0xd8c
# CPU part  : 0xd90

# Check cache line size
adb shell getconf -a | grep CACHE_LINESIZE
# Output:
# LEVEL1_ICACHE_LINESIZE             64
# LEVEL1_DCACHE_LINESIZE             64
Mendekode bagian CPU
Nilai CPU part di /proc/cpuinfo adalah ID heksadesimal untuk core CPU ARM. Untuk SoC Laguna yang ada di Pixel 10 Pro Fold, pemetaan ini adalah:
0xd8b: ARM Cortex-A520 (Inti efisiensi)0xd90: ARM Cortex-A720 (Inti performa)0xd8c: ARM Cortex-X4 (Prime core)
Konfigurasi 4+3+1 ini umum di SoC seluler modern, di mana berbagai cluster dapat memiliki ukuran dan latensi cache yang berbeda.
Jenis lokalitas
Desain software yang efisien bergantung pada dua jenis lokalitas utama:
- Lokalitas Spasial: Jika lokasi memori diakses, lokasi memori di dekatnya kemungkinan akan segera diakses. Traversal array berurutan adalah contoh klasik. Karena CPU memuat seluruh baris cache, mengakses elemen berikutnya dalam array hampir "gratis" jika sudah ada di baris cache.
- Lokalitas Temporal: Jika lokasi memori diakses, lokasi yang sama kemungkinan akan diakses lagi dalam waktu dekat. Algoritma yang baik menggunakan kembali data saat data tersebut masih "aktif" di cache.
Latihan langsung: mengukur lokalitas dengan simpleperf
Dalam latihan ini, kita akan menggunakan simpleperf untuk memantau penghitung performa hardware saat menjalankan dua traversal berbeda dari matriks 256 MB.
- Traversal Baris-utama: Mengakses elemen matriks dalam urutan yang disimpan dalam memori. Hal ini kompatibel dengan cache dan memanfaatkan lokalitas spasial.
- Traversal Column-major: Melompati memori untuk mengakses elemen menurut kolom. Hal ini sering kali melewatkan cache dan TLB, sehingga memaksa CPU untuk berhenti.
1. Menjalankan dengan Simpleperf
Kirim biner, pastikan dapat dieksekusi, dan gunakan simpleperf stat untuk mengukur peristiwa TLB dan cache. Kami menggunakan akhiran :u untuk mengukur peristiwa di ruang pengguna.
Perintah ini memerlukan adb root untuk mengakses penghitung PMU hardware di sebagian besar perangkat.
adb root
adb shell "chmod +x /data/local/tmp/LocalityLab"
Profil Row-major:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab row"
Profil Column-major:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab col"
2. Contoh pengukuran (Pixel 10 Pro Fold)
Hasil berikut diukur pada perangkat hardware Pixel 10 Pro Fold:
| Metrik | Row-major (Mudah) | Column-major (Tidak mudah digunakan) | Perbedaan |
|---|---|---|---|
| Waktu Eksekusi | 0,83 detik | 68,3 detik | ~82x lebih lambat |
| Petunjuk | 5,27 Miliar | 10,20 Miliar | ~1,9x lebih banyak |
| Siklus CPU | 1,20 Miliar | 62,18 Miliar | ~52x lebih banyak |
| Petunjuk Per Siklus (IPC) | 4.40 | 0,16 | Efisiensi 27x lebih rendah |
| Kegagalan Cache Data L1 | 210 Juta | 3.369 Juta | 16x lebih banyak kesalahan |
| dTLB Load Misses | 130 Ribu | 2.888 Juta | 22.000x lebih banyak kesalahan |
3. Analisis hasil
- IPC Crash: Dalam pengujian row-major, CPU mencapai IPC 4,40, yang menunjukkan bahwa CPU menjalankan beberapa petunjuk per siklus secara efisien. Dalam pengujian column-major, IPC turun menjadi 0,16. Artinya, CPU macet 96% dari waktu, menunggu data tiba dari DRAM.
- Hambatan TLB: Perbedaan paling signifikan ada pada dTLB-load-misses. Akses berurutan (baris utama) tetap berada dalam halaman memori yang sama, sehingga menghasilkan sangat sedikit TLB tidak ditemukan. Melompat antar-kolom (berbasis kolom) menyebabkan CPU terus-menerus mereferensikan halaman baru, membebani TLB dan memaksa penelusuran tabel halaman yang mahal.
- Efisiensi Cache: Traversal column-major menghasilkan 16x lebih banyak kegagalan cache L1, sehingga memaksa CPU untuk mengambil data dari L3 atau DRAM yang jauh lebih lambat secara terus-menerus.
Pengamatan: Meskipun kedua traversal melakukan operasi logis yang sama pada data yang sama, traversal column-major lebih lambat lebih dari 80 kali. Perbedaan besar ini sepenuhnya disebabkan oleh cara pola akses berinteraksi dengan realitas fisik subsistem memori CPU.
Pointer chasing dalam struktur data Java dan Kotlin
Meskipun tolok ukur matriks 2D menunjukkan lokalitas spasial dalam array native yang berdekatan, sebagian besar kode aplikasi dan framework Android ditulis dalam Java dan Kotlin. Dalam bahasa terkelola, variabel objek dan elemen koleksi tidak menyimpan objek inline; mereka menyimpan referensi (pointer) ke objek yang dialokasikan heap yang tersebar di seluruh heap ART.
Biaya grafik referensi bertingkat
Pertimbangkan pola umum di aplikasi Android dan layanan sistem: melintasi
kumpulan bertingkat seperti ArrayList objek status, yang masing-masing berisi
ArrayMap atau ArraySet pendengar atau koneksi, yang masing-masing mengarah ke
rekaman status lain.
Meskipun ArrayList, ArrayMap, dan ArraySet menyimpan array Object[] internalnya secara berdekatan, setiap elemen dalam Object[] tersebut tetap merupakan referensi heap. Mendeferensikan rantai seperti
process.services.valueAt(i).connections.valueAt(j).client memerlukan lima
pemuatan memori dependen berurutan:
- Muat
Object[]pendukungservices. - Muat header dan kolom objek
ServiceRecord. - Muat
Object[]pendukungconnections. - Muat objek
ConnectionRecord. - Muat kolom
ProcessRecordtarget.
Karena setiap alamat memori pemuatan bergantung pada nilai yang ditampilkan oleh pemuatan sebelumnya, mesin eksekusi di luar urutan dan pengambil data hardware CPU tidak dapat tumpang-tindih. Jika objek tersebut dialokasikan pada waktu yang berbeda atau dipindahkan ke region yang berbeda selama pengumpulan sampah, setiap hop berisiko mengalami cache L1 atau L2 miss.
Primitif yang di-boxing (ArrayList<Integer>, HashMap<Long, Boolean>) dan lambda generik
memperparah overhead ini: setiap pencarian elemen memerlukan dereferensi
pointer tambahan untuk meng-unbox nilai, dan callback Consumer<T> generik menyisipkan
stub pemeriksaan jenis runtime (CheckCast) yang menambah tekanan
pada cache instruksi (L1-icache).
Mendiagnosis pointer chasing dengan simpleperf
Dalam workload Java dan Kotlin di dunia nyata (seperti proses traversal system_server's
OomAdjuster, grafik referensi layanan, dan penyedia), pointer chasing jarang menurunkan IPC hingga 0,16 seperti pemindaian kolom utama 256 MB sintetis, karena sebagian set kerja cocok di cache L2 atau L3.
Sebagai gantinya, cari tanda tangan karakteristik ini di simpleperf:
- IPC yang tertekan (sekitar 0,6 hingga 0,9): Jauh di bawah lebar penghentian superskalar CPU.
- Penundaan memori backend tinggi (
raw-stall-backend-mem): Sering kali 35% hingga 45% dari semua siklus CPU dihabiskan untuk menunggu pengisian cache data. - Peningkatan
L1-dcache-load-missesdanL1-icache-load-misses: Tingginya rasio cache data yang tidak ditemukan dipasangkan dengan cache instruksi yang tidak ditemukan saat loop traversal aktif melompat di seluruh metode virtual dan stub lambda generik.
Anda dapat mengukur penghitung ini pada proses yang sedang berjalan menggunakan simpleperf stat:
adb shell simpleperf stat \
  -e cpu-cycles:u,instructions:u,raw-stall-backend-mem:u,L1-dcache-load-misses:u,L1-icache-load-misses:u \
  -p $(pidof system_server) --duration 10
Meningkatkan lokalitas dalam kode terkelola
- Ganti koleksi yang dikemas dengan array primitif atau koleksi AndroidX:
Gunakan primitif
IntArray,LongArray,SparseIntArray, atauandroidx.collection(IntList,LongLongMap,ScatterMap) untuk menghilangkan objek wrapper dan menjaga nilai berdekatan di dalam alokasi array tunggal. - Meratakan jalur traversal aktif: Jika loop aktif berulang kali berjalan tiga atau empat lompatan di seluruh grafik objek untuk membaca satu tanda boolean atau bilangan bulat, angkat atau cache status tersebut ke dalam array datar atau bitmask yang diindeks oleh ID padat.
- Hindari pengambilan atau lambda generik dalam loop dalam yang ketat: Gunakan loop
forberindeks standar pada daftarRandomAccess, bukan rantaiforEachatau iterator untuk menghindari alokasi iterator, pengiriman megamorfik, dan overhead pemeriksaan jenis runtime.
← Thread | ↑ Naik | Binding layanan →