

메모리는 단일하고 균일한 스토리지 풀로 생각되는 경우가 많지만, 메모리의 물리적 조직과 CPU가 메모리에 액세스하는 방식은 애플리케이션 성능에 큰 영향을 미칩니다. 메모리 지역성을 이해하는 것은 CPU의 캐시 계층 구조를 효율적으로 사용하는 고성능 코드를 작성하는 데 중요합니다.
CPU 캐시 계층 구조
최신 모바일 CPU는 시스템의 기본 RAM (DRAM)보다 훨씬 빠릅니다. 이러한 성능 격차를 해소하기 위해 CPU는 캐시라고 하는 여러 수준의 작고 매우 빠른 메모리를 사용합니다.
- L1 캐시 (수준 1): 가장 작고 가장 빠릅니다 (~1ns). 3GHz CPU에서는 약 3개의 클럭 사이클입니다.
- L2 캐시 (레벨 2): 더 크고 약간 느림 (~3~5ns 또는 ~10~15사이클).
- L3 캐시 (레벨 3): 가장 큰 캐시 (~10~20ns 또는 ~30~60사이클)입니다.
- 메인 메모리 (DRAM): 가장 크고 느립니다 (~100ns 이상 또는 ~300 사이클 이상).
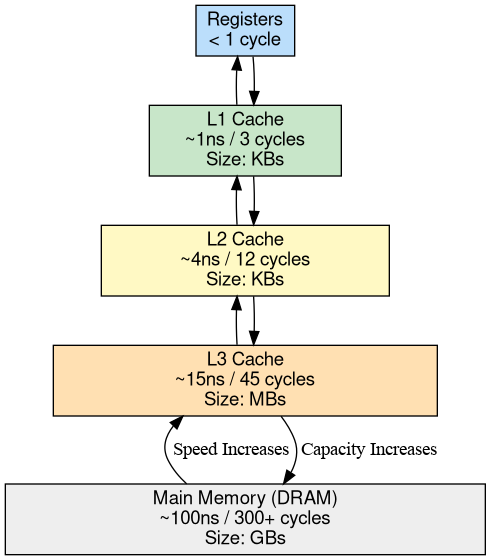
지연 시간의 맥락 파악: 정체의 비용
이러한 숫자의 영향을 이해하려면 클럭 사이클당 4~8개의 명령어를 폐기할 수 있는 최신 슈퍼스칼라 CPU를 고려해 보세요.
CPU가 모든 캐시를 놓치고 DRAM 읽기를 위해 100ns (300사이클)를 기다려야 하는 경우:
- 손실된 주기: 약 300회
- '낭비된' 명령어: 데이터가 이미 로컬 레지스터 또는 L1 캐시에 있는 경우 실행될 수 있는 1,200~2,400개의 명령어입니다.
코드의 메모리 지역성이 좋지 않으면 CPU가 복잡한 수학으로 바쁘지 않습니다. 메모리 하위 시스템을 기다리는 동안 수천 개의 명령어에 해당하는 시간 동안 자주 '정체'되어 유휴 상태로 유지됩니다.
사이클당 명령어 수 (IPC)
이 효율성을 측정하는 주요 측정항목은 사이클당 명령어 수 (IPC)입니다. IPC는 각 클럭 사이클 동안 CPU가 평균적으로 성공적으로 '리타이어' (완료)하는 명령 수를 나타냅니다.
- 높은 IPC (예: 3.0~5.0): CPU가 높은 효율로 실행되고 있으며, L1/L2 캐시 또는 레지스터에서 대부분의 데이터를 찾을 수 있습니다.
- 낮은 IPC (예: < 0.5): CPU에 심각한 병목 현상이 있습니다. CPU가 시스템 모니터에서 100% '사용' 중인 경우에도 실제로는 메모리를 기다리는 데 대부분의 시간을 소비합니다. 이를 메모리 정체라고 합니다.
메모리 지역성은 데이터 집약적 루프가 높은 IPC로 실행되는지 아니면 일련의 정체로 축소되는지를 결정하는 기본 요소입니다.
캐시 라인
CPU는 메모리에서 단일 바이트를 로드하지 않습니다. 대신 일반적으로 64바이트인 캐시 라인이라는 고정 크기 블록을 로드합니다. 단일 변수에 액세스하면 CPU가 변수를 포함하는 전체 64바이트 청크를 캐시로 가져옵니다.

TLB (변환 색인 버퍼)
Android는 가상 메모리를 사용합니다. 모든 메모리 액세스에는 가상 주소를 실제 주소로 변환해야 합니다. TLB는 최근 변환을 저장하는 특수 캐시입니다. TLB 누락이 발생하면 커널이 메인 메모리에서 페이지 테이블을 탐색해야 하므로 TLB 적중과 비교할 때 상대적으로 비용이 많이 드는 작업입니다.
하드웨어 프로필: Pixel 10 Pro Fold
다음 연습에서는 Pixel 10 Pro Fold 하드웨어 기기를 사용했습니다. 이 기기에는 Google Tensor G5 SoC가 탑재되어 있습니다.
하드웨어 쿼리
메모리 하위 시스템을 이해하려면 먼저 CPU 구성과 캐시 매개변수를 살펴봅니다.
# Check CPU architecture and core parts
adb shell cat /proc/cpuinfo | grep 'CPU part' | sort -u
# Output:
# CPU part  : 0xd8b
# CPU part  : 0xd8c
# CPU part  : 0xd90

# Check cache line size
adb shell getconf -a | grep CACHE_LINESIZE
# Output:
# LEVEL1_ICACHE_LINESIZE             64
# LEVEL1_DCACHE_LINESIZE             64
CPU 파트 디코딩
/proc/cpuinfo의 CPU part 값은 ARM CPU 코어의 16진수 식별자입니다. Pixel 10 Pro Fold에 있는 Laguna SoC의 경우 다음과 같이 매핑됩니다.
0xd8b: ARM Cortex-A520 (효율성 코어)0xd90: ARM Cortex-A720 (성능 코어)0xd8c: ARM Cortex-X4 (프라임 코어)
이 4+3+1 구성은 다양한 클러스터가 다양한 캐시 크기와 지연 시간을 가질 수 있는 최신 모바일 SoC에서 흔합니다.
지역 유형
효율적인 소프트웨어 설계는 두 가지 주요 유형의 지역성을 기반으로 합니다.
- 공간적 지역성: 메모리 위치에 액세스하면 근처 메모리 위치에 곧 액세스할 가능성이 높습니다. 순차 배열 순회가 대표적인 예입니다. CPU가 전체 캐시 라인을 로드하므로 배열의 다음 요소가 이미 캐시 라인에 있는 경우 액세스하는 것은 거의 '무료'입니다.
- 시간적 지역성: 메모리 위치에 액세스하면 곧 동일한 위치에 다시 액세스할 가능성이 높습니다. 좋은 알고리즘은 캐시에서 데이터가 아직 '핫'한 동안 데이터를 재사용합니다.
실습: simpleperf로 지역성 측정
이 연습에서는 simpleperf를 사용하여 256MB 행렬의 두 가지 다른 순회를 실행하는 동안 하드웨어 성능 카운터를 모니터링합니다.
- 행 우선 순회: 메모리에 저장된 순서대로 행렬 요소에 액세스합니다. 이는 캐시에 적합하며 공간적 지역성을 활용합니다.
- 열 우선 순회: 열별로 요소에 액세스하기 위해 메모리를 건너뜁니다. 이로 인해 캐시와 TLB가 누락되어 CPU가 정지되는 경우가 많습니다.
1. Simpleperf로 실행
바이너리를 푸시하고 실행 가능한지 확인한 후 simpleperf stat를 사용하여 캐시 및 TLB 이벤트를 측정합니다. 사용자 공간에서 이벤트를 측정하기 위해 :u 접미사를 사용합니다.
이러한 명령어는 대부분의 기기에서 adb root가 하드웨어 PMU 카운터에 액세스해야 합니다.
adb root
adb shell "chmod +x /data/local/tmp/LocalityLab"
프로필 행 우선:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab row"
프로필 열 우선:
adb shell "simpleperf stat -e cpu-cycles:u,instructions:u,cache-misses:u,L1-dcache-load-misses:u,dTLB-load-misses:u /data/local/tmp/LocalityLab col"
2. 샘플 측정 (Pixel 10 Pro Fold)
다음 결과는 Pixel 10 Pro Fold 하드웨어 기기에서 측정되었습니다.
| 측정항목 | 행 우선 (친숙한) | 열 우선 (비우호적) | 차이 |
|---|---|---|---|
| 실행 시간 | 0.83초 | 68.3초 | 약 82배 느림 |
| 안내 | 52억 7천만 | 102억 | 약 1.9배 더 많음 |
| CPU 사이클 | 12억 | 621억 8천만 | 약 52배 더 많음 |
| 사이클당 명령어 수 (IPC) | 4.40 | 0.16 | 효율성 27배 낮음 |
| L1 데이터 캐시 누락 | 2억 1천만 | 33억 6,900만 | 16배 더 많은 미스 |
| dTLB 로드 미스 | 13만 | 28억 8,800만 | 22,000배 더 많은 누락 |
3. 결과 분석
- IPC 비정상 종료: 행 우선 테스트에서 CPU는 IPC 4.40을 달성하여 사이클당 여러 명령어를 효율적으로 실행하고 있음을 나타냅니다. 열 우선 테스트에서는 IPC가 0.16으로 떨어집니다. 이는 CPU가 DRAM에서 데이터가 도착하기를 기다리면서 96% 의 시간 동안 정체된다는 의미입니다.
- TLB 병목 현상: 가장 큰 차이는 dTLB-load-misses에 있습니다. 순차 액세스 (행 우선)는 동일한 메모리 페이지 내에 유지되므로 TLB 누락이 거의 발생하지 않습니다. 열을 가로질러 이동하면(열 우선) CPU가 새 페이지를 지속적으로 참조하여 TLB가 과부하되고 비용이 많이 드는 페이지 테이블 탐색이 강제됩니다.
- 캐시 효율성: 열 우선 순회는 L1 캐시 누락을 16배 더 많이 생성하므로 CPU가 훨씬 느린 L3 또는 DRAM에서 데이터를 지속적으로 가져와야 합니다.
관찰: 두 순회 모두 동일한 데이터에 동일한 논리적 작업을 실행했지만 열 우선 순회는 80배 이상 느렸습니다. 이러한 큰 차이는 액세스 패턴이 CPU의 메모리 하위 시스템의 실제와 상호작용하는 방식에 전적으로 기인합니다.
Java 및 Kotlin 데이터 구조의 포인터 추적
2D 행렬 벤치마크는 연속된 네이티브 배열의 공간적 지역성을 보여주지만 대부분의 Android 애플리케이션 및 프레임워크 코드는 Java 및 Kotlin으로 작성됩니다. 관리 언어에서 객체 변수와 컬렉션 요소는 객체를 인라인으로 저장하지 않습니다. ART 힙에 흩어져 있는 힙 할당 객체에 대한 참조 (포인터)를 저장합니다.
중첩 참조 그래프의 비용
Android 앱 및 시스템 서비스의 일반적인 패턴을 생각해 보세요. 상태 객체의 ArrayList와 같은 중첩된 컬렉션을 순회합니다. 각 컬렉션에는 리스너 또는 연결의 ArrayMap 또는 ArraySet이 포함되어 있으며 각 컬렉션은 다른 상태 레코드를 가리킵니다.
ArrayList, ArrayMap, ArraySet는 내부 Object[] 배열을 연속적으로 저장하지만 해당 Object[]의 각 요소는 여전히 힙 참조입니다. process.services.valueAt(i).connections.valueAt(j).client와 같은 체인을 역참조하려면 다음과 같은 5개의 순차적 종속 메모리 로드가 필요합니다.
Object[]지원services을 로드합니다.ServiceRecord객체 헤더와 필드를 로드합니다.Object[]지원connections을 로드합니다.ConnectionRecord객체를 로드합니다.- 타겟
ProcessRecord필드를 로드합니다.
각 로드의 메모리 주소는 이전 로드에서 반환된 값에 따라 달라지므로 CPU의 비순차적 실행 엔진과 하드웨어 프리페처는 이를 중복할 수 없습니다. 이러한 객체가 서로 다른 시간에 할당되었거나 가비지 컬렉션 중에 서로 다른 리전으로 이동된 경우 각 홉은 L1 또는 L2 캐시 부적중을 초래할 수 있습니다.
박싱된 기본 유형 (ArrayList<Integer>, HashMap<Long, Boolean>)과 일반 람다는 이 오버헤드를 가중시킵니다. 모든 요소 조회에는 값을 언박싱하기 위한 추가 포인터 역참조가 필요하며 일반 Consumer<T> 콜백은 명령 캐시 (L1-icache) 압력을 추가하는 런타임 유형 검사 (CheckCast) 스텁을 삽입합니다.
simpleperf을 사용한 포인터 추적 진단
실제 Java 및 Kotlin 워크로드 (예: system_server의 OomAdjuster 순회 프로세스, 서비스, 제공자 참조 그래프)에서는 작업 세트의 일부가 L2 또는 L3 캐시에 맞기 때문에 포인터 추적이 합성 256MB 열 우선 스캔처럼 IPC를 0.16까지 떨어뜨리는 경우가 거의 없습니다.
대신 simpleperf에서 다음 특성 서명을 찾으세요.
- IPC 감소 (0.6~0.9): CPU의 슈퍼스칼라 폐기 폭보다 훨씬 낮습니다.
- 높은 백엔드 메모리 정지 (
raw-stall-backend-mem): 모든 CPU 사이클의 35~45%가 데이터 캐시 채우기를 기다리는 데 사용됩니다. L1-dcache-load-misses및L1-icache-load-misses상승: 핫 트래버설 루프가 가상 메서드와 일반 람다 스텁 간에 점프할 때 높은 데이터 캐시 부적중률과 명령 캐시 부적중이 쌍을 이룹니다.
실행 중인 프로세스에서 simpleperf stat를 사용하여 이러한 카운터를 측정할 수 있습니다.
adb shell simpleperf stat \
  -e cpu-cycles:u,instructions:u,raw-stall-backend-mem:u,L1-dcache-load-misses:u,L1-icache-load-misses:u \
  -p $(pidof system_server) --duration 10
관리 코드의 지역성 개선
- 박싱된 컬렉션을 기본 배열 또는 AndroidX 컬렉션으로 대체:
IntArray,LongArray,SparseIntArray또는androidx.collection기본 요소 (IntList,LongLongMap,ScatterMap)를 사용하여 래퍼 객체를 제거하고 단일 배열 할당 내에서 값을 연속적으로 유지합니다. - 핫 트래버설 경로 평면화: 핫 루프가 객체 그래프에서 3~4개의 홉을 반복적으로 이동하여 단일 불리언 또는 정수 플래그를 읽는 경우 해당 상태를 밀도 높은 ID로 색인이 지정된 플랫 배열 또는 비트 마스크로 호이스팅하거나 캐시합니다.
- 타이트한 내부 루프에서 람다 캡처 또는 일반 람다 방지:
forEach또는 반복기 체인 대신RandomAccess목록에 표준 색인화된for루프를 사용하여 반복기 할당, 메가모픽 디스패치, 런타임 유형 검사 오버헤드를 방지합니다.