Android Bench の最初のリリースでは、大規模言語モデル(LLM)が実際の Android タスクでデベロッパーをどのように支援するかを評価するための厳格な基盤を構築しました。AI モデルとエージェントが急速に進化する中、Google はベンチマーク フレームワークを Harbor フレームワークに合わせるなど、手法を更新してきました。本日、長期的なタスク(LHT)の最初のセットをリリースします。これは、エンジニアが完了するまでに数日から 1 週間かかる、非常に複雑なタスクです。また、対応するモデル プロバイダのエージェントから、エージェント評価も導入します。この追加により、Android Bench 2.0 が誕生しました。これは、開発者が日々直面する大規模で曖昧な、複雑な複数ステップの問題解決に対して、AI モデルとエージェントを評価するために設計されたメジャー アップグレードです。
段階的な修正から長期的なタスクまで
Android Bench の最初のイテレーションは、初期の同様の AI コーディング ベンチマークと同様に、既存のリポジトリへの増分変更に重点を置いており、多くの場合、バグの修正や小規模な機能リクエストに限定されていました。これは、当時の AI アシスタンスの機能と、その使用方法を反映したものでした。
開発ワークフローに最適なモデルとコーディング エージェントを見つけられるよう、Google は AI に委任する作業に合わせて評価基準を引き上げました。Android Bench 2.0 は、依存関係のアップグレード、新機能の追加、アプリのゼロからの構築、クロスプラットフォーム アプリの Android への変換など、LHT を使用したこれらの野心的な課題を反映しています。
複雑なタスクには、よりきめ細かい評価とスコアリングが必要
数日間にわたるエンジニアリング タスクでは、合格か不合格かという 2 値の評価では全体像を把握できません。
たとえば、エージェントが 40 個の画面を Jetpack Compose にリファクタリングし、データベース テーブルを設定して、要件の 90% を満たしたとしても、1 つのエッジケース アサーションに失敗することがあります。バイナリ スコアリングでは、この実行は 0% と評価され、モデルのアーキテクチャ機能が不明瞭になります。モデル開発と、AI がどのように役立つかを理解するうえで、より有意義なシグナルを提供するために、継続的なスコアリングに移行します。
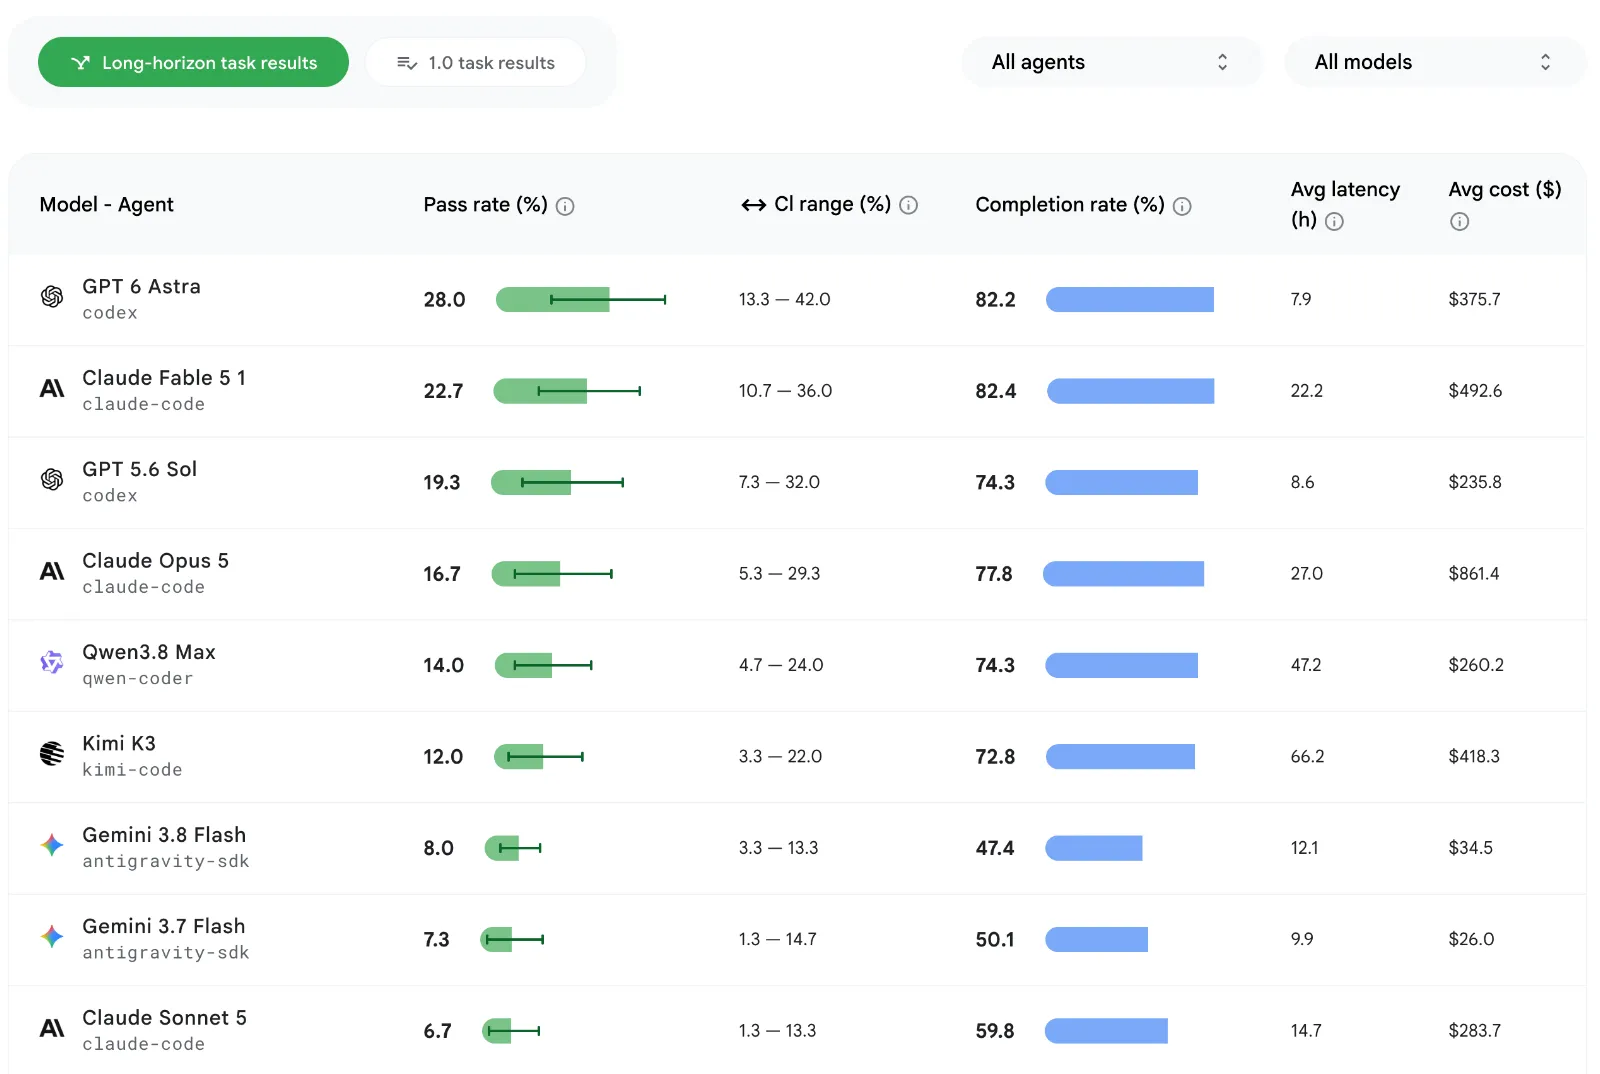
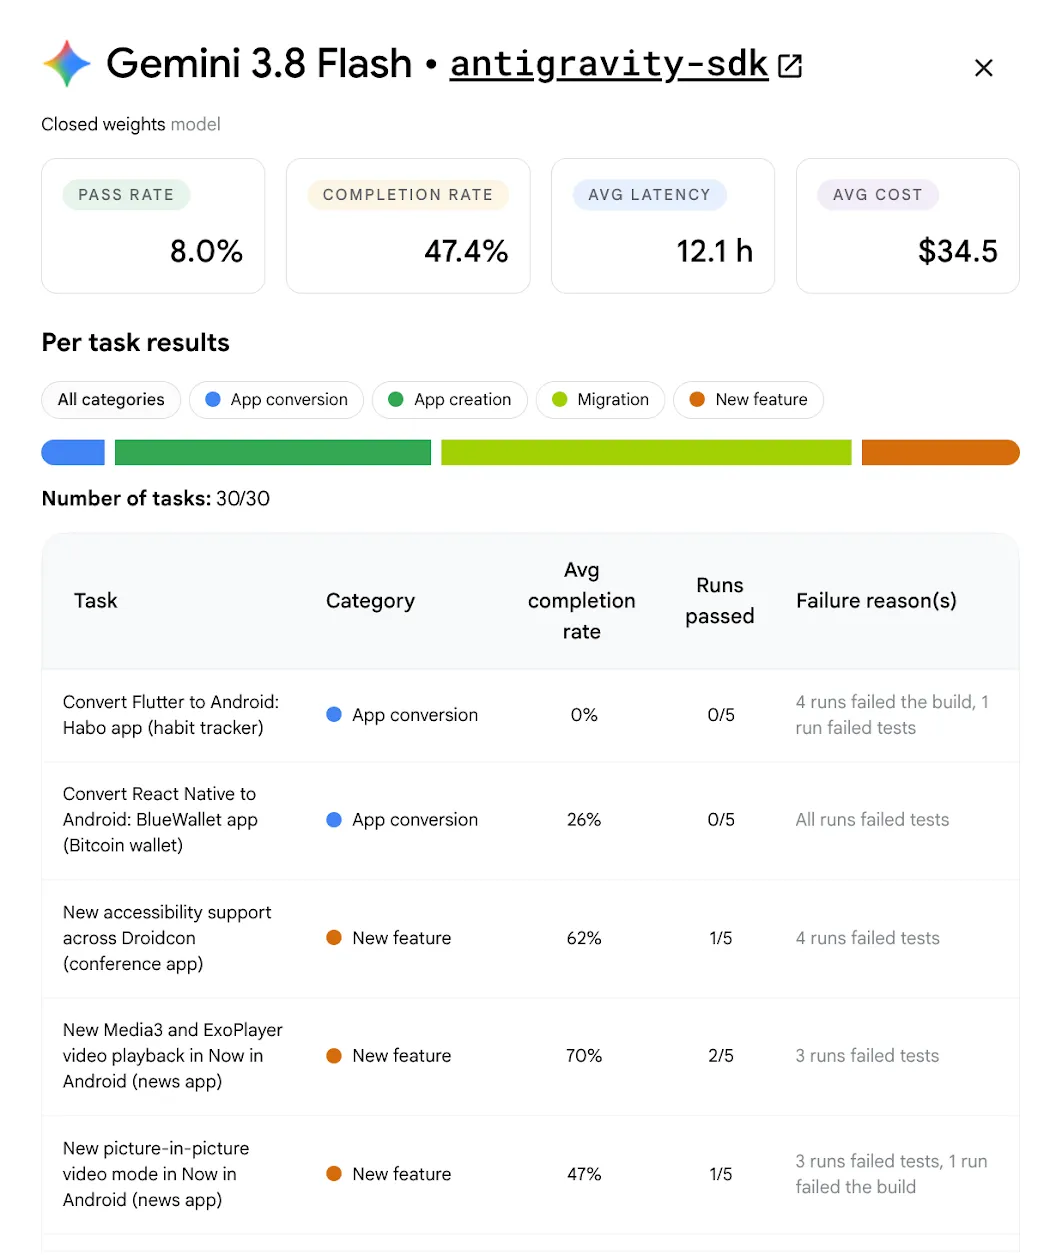
この完了率は、機能性、視覚的な忠実度、回帰の回避などの要素を組み合わせて計算されます。また、評価手順や構造上の制約から逸脱した場合は、客観的なスコアリング ペナルティが適用されます。更新されたリーダーボードを確認し、各モデルのカード表示をクリックすると、合格率、完了率、モデルごとおよびタスクごとの平均費用などの追加要素が表示されます。
LHT の最高合格率は 28% 程度であり、ベンチマークの元のタスクの約 91% よりもはるかに低くなっています。
長期的なタスクにより、AI アシスタンスに役立つ詳しいレポートが得られる
LHT データセットは、AI が長時間にわたるタスクをどの程度適切に処理できるかを測定するだけでなく、テストされたモデルの長所と短所をより深く理解するのに役立ち、より実用的なガイダンスを提供します。
モデルの階層を問わず、AI は既存のコードのリファクタリングよりも、新しいコードの作成に優れています。リファクタリングと移行は、コードの量ではなくアーキテクチャの複雑さに依存するため、より困難になります。
モデルは、Java から Kotlin への変換、Retrofit から Ktor への切り替え、ViewModel レイヤの導入など、確立された決定論的な変換において強力な機能を発揮します。125 個以上のファイルと 8,000 行以上のコードにわたって、これらのパターンを一貫して適用しています。
しかし、タスクにランタイム検証(依存関係注入グラフの欠落など)が必要な場合、フレームワークの破壊的な変更が伴う場合、未リリースのライブラリに関する知識ギャップに直面した場合、モデルは苦戦します。クロスプラットフォーム アプリの Android への移植は、依然として未解決の課題です。100% の合格率を達成したモデルはなく、フロンティア モデルでも完了率は最大 80% にとどまっています。
エージェント評価の概要
モデルをエージェント ワークフローに統合した際のパフォーマンスをより正確に把握できるように、一般的に使用されるエージェントを評価に追加しています。まず、対応するモデル プロバイダのエージェントを使用して、LHT に対して新しいモデルを実行します。たとえば、GPT 5.6 Sol は Codex で、Gemini 3.8 Flash は Google Antigravity で実行しました。この組み合わせは、ハーネス設計がデベロッパーの成果にプラスの影響を与えることを示しています。プロンプト キャッシュとコンパクトなツール ウィンドウにより、トークンを削減できることがわかっています。
今後は、さまざまなモデルとエージェントの組み合わせによる結果もハイライト表示し、ユーザーやチームに最適な組み合わせを見つけられるようにする予定です。
Google がこの測定に投資しているのは、Android デベロッパーが選択したエージェントとモデルを使用できるようにすることが重要であるためです。今後数週間以内に、さらに詳しい情報をお知らせします。
新しいモデルが追加されました
さらに、開発の意思決定に最新のデータを利用できるよう、リーダーボードの拡充を続けています。Gemini 3.8 Flash、Gemini 3.7 Flash、OpenAI の GPT-6、Anthropic の Fable 5.1、Kimi K3、Qwen 3.8 Max を追加しました。OpenAI の GPT-6 Astra が 28% の合格率でトップでした。
今後の対応
Android Bench 2.0 は、Android デベロッパー向けの AI を測定するための堅牢な環境を提供します。長期的なタスク、マルチモーダル評価、エージェント、継続的なスコアリングを組み合わせることで、AI リサーチチームがより有能で信頼性の高い AI コーディング パートナーを構築できるよう支援し、AI 開発の選択肢についてより透明性の高い情報を提供したいと考えています。
最新のリーダーボードと最新の手法をご覧ください。皆様からのフィードバックは、Android Bench の進化に直接影響します。引き続き、GitHub や、X、LinkedIn などのソーシャル チャネルでフィードバックをお寄せください。
-
 サービスに関する最新情報
本日、Android Dev Summit において、日常的な摩擦を解消し、優れた Android アプリをより柔軟に構築できるように設計された多くのツールと API の幅広い提供を発表します。
Matthew McCullough • 所要時間: 4 分 -
 サービスに関する最新情報
エージェント開発が加速する中、Android エンジニアリングは、アシスト型のコード補完から、開発者の指示の下でエンドツーエンドで実行するエージェントへと移行し、エキサイティングな新しいフロンティアに到達しています。使用するモデルとエージェントを完全に選択でき、柔軟性も確保されています。
Jason Buchel • 所要時間: 3 分 -

 サービスに関する最新情報
Android デベロッパーは、アプリ開発に使用するエージェント、LLM、ツール、コマンドライン インターフェース(CLI)に関して、多くの選択肢を持っています。Google の目標は、どのような方法で開発する場合でも、美しく高品質な Android アプリを開発できるように支援することです。
Simona Milanovic • 所要時間: 4 分
Android 開発に関する最新の分析情報を毎週メールでお届けします。