

Android oferuje wbudowaną obsługę SQLite, wydajnej bazy danych SQL. Postępuj zgodnie z tymi sprawdzonymi metodami, aby zoptymalizować wydajność aplikacji i zapewnić jej szybkie i przewidywalne działanie w miarę wzrostu ilości danych. Stosując te sprawdzone metody, zmniejszasz też ryzyko wystąpienia problemów z wydajnością, które są trudne do odtworzenia i rozwiązania.
Aby zwiększyć szybkość działania, postępuj zgodnie z tymi zasadami:
Odczytywanie mniejszej liczby wierszy i kolumn: zoptymalizuj zapytania, aby pobierać tylko niezbędne dane. Zminimalizuj ilość danych odczytywanych z bazy danych, ponieważ pobieranie nadmiernej ilości danych może wpływać na wydajność.
Przenoszenie pracy do mechanizmu SQLite: wykonuj obliczenia, filtrowanie i sortowanie w zapytaniach SQL. Użycie mechanizmu zapytań SQLite może znacznie poprawić wydajność.
Zmodyfikuj schemat bazy danych: zaprojektuj schemat bazy danych, aby ułatwić SQLite tworzenie wydajnych planów zapytań i reprezentacji danych. Prawidłowo indeksuj tabele i optymalizuj ich strukturę, aby zwiększyć wydajność.
Możesz też użyć dostępnych narzędzi do rozwiązywania problemów, aby zmierzyć wydajność bazy danych SQLite i zidentyfikować obszary wymagające optymalizacji.
Zalecamy używanie biblioteki Jetpack Room.
Konfigurowanie bazy danych pod kątem wydajności
Aby skonfigurować bazę danych pod kątem optymalnej wydajności w SQLite, wykonaj czynności opisane w tej sekcji.
Włączanie zapisywania logów z wyprzedzeniem
SQLite implementuje mutacje, dołączając je do logu, który od czasu do czasu kompaktuje do bazy danych. Jest to tzw. zapisywanie logów z wyprzedzeniem (WAL).
Włącz WAL, chyba że używasz ATTACH DATABASE.
Włącz WAL za pomocą platformy, zamiast samodzielnie uruchamiać PRAGMA journal_mode=WAL. Room domyślnie włącza WAL na urządzeniach, które nie mają mało pamięci RAM.
Jeśli nie korzystasz z Room, użyj jednej z tych opcji:
- Metoda
enableWriteAheadLogging - Flaga otwarcia
ENABLE_WRITE_AHEAD_LOGGING - Metoda
setWriteAheadLoggingEnabledwSQLiteOpenHelper
Gdy platforma wie, że baza danych używa WAL, otwiera pulę połączeń, aby odczyty mogły być wykonywane równolegle z zapisem, i stosuje tryb synchroniczny WAL opisany w następnej sekcji. Jeśli samodzielnie uruchomisz PRAGMA journal_mode=WAL, platforma nadal będzie traktować bazę danych jako bazę danych dziennika wycofywania. Używa pojedynczego połączenia, a zatwierdzenia zachowują domyślny tryb synchroniczny FULL.
Złagodzenie trybu synchronizacji
SQLite ma opcję sterowania trybem synchronicznym. W trybie FULL każde zatwierdzenie powoduje wywołanie fsync, aby dane zostały zapisane na dysku. Zwiększa to trwałość danych, ale spowalnia zatwierdzanie. W przypadku WAL tryb NORMAL nie synchronizuje się przy każdym zatwierdzeniu, ale nadal chroni bazę danych przed uszkodzeniem.
Gdy włączysz WAL za pomocą platformy, Android zastosuje domyślny tryb synchroniczny WAL urządzenia, który w AOSP dla Androida 9 i nowszych jest ustawiony na NORMAL.
Producenci urządzeń mogą zmienić to ustawienie domyślne, a bazy danych, które nie używają WAL, domyślnie mają wartość FULL. Aby mieć pewność, że baza danych używa NORMAL, ustaw tę opcję podczas otwierania bazy danych:
// When opening the database
val params = SQLiteDatabase.OpenParams.Builder()
    .addOpenFlags(SQLiteDatabase.ENABLE_WRITE_AHEAD_LOGGING)
    // SYNC_MODE_NORMAL is available in API level 33 and higher.
    // On API levels 28 to 32, pass "NORMAL" instead.
    .setSynchronousMode(SQLiteDatabase.SYNC_MODE_NORMAL)
    .build()
// With SQLiteOpenHelper, call setOpenParams(params) in your constructor.

// Or: after having opened the database
db.execSQL("PRAGMA synchronous = NORMAL")
W tym ustawieniu zatwierdzenie może zostać zwrócone, zanim dane zostaną zapisane na dysku. Jeśli urządzenie zostanie wyłączone, np. z powodu utraty zasilania lub błędu kernel panic, zatwierdzone dane mogą zostać utracone. Jednak dzięki logowaniu baza danych nie jest uszkodzona.
Jeśli awaria dotyczy tylko aplikacji, dane i tak trafią na dysk. W przypadku większości aplikacji to ustawienie zwiększa wydajność bez ponoszenia istotnych kosztów.
Zarządzanie połączeniami i pamięcią
Każde otwarte połączenie z bazą danych zajmuje pamięć SQLite: pamięć podręczną stron, alokator lookaside i pamięć podręczną skompilowanych instrukcji. Strony plików bazy danych pozostają też w pamięci podręcznej stron jądra. Postępuj zgodnie z praktykami opisanymi w tej sekcji, aby kontrolować tę pamięć bez spowalniania zapytań.
Otwórz każdą bazę danych raz.
Używaj pojedynczej instancji SQLiteOpenHelper lub RoomDatabase na plik bazy danych w całym procesie, na przykład przez utworzenie singletonu. Każda instancja ma własną pulę połączeń, pamięć podręczną stron i pamięć podręczną instrukcji, a 2 instancje, które otwierają ten sam plik, nie mogą ich udostępniać. W jednym z testów porównawczych konsolidacja 2 pomocników, którzy otwierali ten sam plik, w jednego pomocnika zmniejszyła pamięć podręczną stron SQLite o prawie połowę i skróciła czas oczekiwania na odpowiedź na zapytanie (95 centyl) o ponad połowę.
Aby znaleźć zduplikowane instancje, sprawdź, czy w pliku dumpsys dbinfo ta sama ścieżka bazy danych nie występuje pod więcej niż jednym nagłówkiem Connection pool for.
Nie wprowadzaj zmian schematu w wywołaniu zwrotnym otwarcia
Wywołanie zwrotne onOpen klasy SQLiteOpenHelper jest uruchamiane za każdym razem, gdy baza danych jest otwierana. Podobnie jest z wywołaniem zwrotnym onOpen klasy RoomDatabase.Callback. Umieść instrukcje takie jak CREATE TABLE IF NOT EXISTS i CREATE INDEX IF NOT EXISTS w onCreate i onUpgrade lub w migracjach Room. Nie wywołuj funkcji setVersion w pliku onOpen, ponieważ funkcja SQLiteOpenHelper ustawia już wersję po funkcjach onCreate i onUpgrade. Nawet jeśli schemat już istnieje, te instrukcje są nadal wykonywane przy każdym otwarciu, a setVersion zapisuje dane w pliku bazy danych.
Określanie rozmiaru pamięci podręcznej przygotowanych instrukcji
Android zapisuje w pamięci podręcznej skompilowane instrukcje dla każdego połączenia. Domyślnie pamięć podręczna przechowuje 25 instrukcji, ale możesz zwiększyć tę liczbę do MAX_SQL_CACHE_SIZE (100) za pomocą setMaxSqlCacheSize. Jeśli baza danych uruchamia więcej niż 25 różnych instrukcji w ścieżkach hot path, pamięć podręczna ulega przepełnieniu, a SQLite wielokrotnie kompiluje te same instrukcje.
Najpierw sparametryzuj zapytania. Żaden rozmiar pamięci podręcznej nie pomoże w przypadku kodu SQL utworzonego za pomocą konkatenacji ciągów znaków, ponieważ każdy ciąg znaków jest nową instrukcją. Następnie sprawdź trafienia i nietrafienia w pamięci podręcznej instrukcji w sekcji POOL STATS w dumpsys meminfo. Na przykład baza danych phenotype.db w przykładowych danych wyjściowych w tej sekcji ma 147 921 trafień i 89 616 chybień, co daje 38% chybień. Zwiększenie rozmiaru pamięci podręcznej w bazie danych takiej jak ta może wyeliminować prawie wszystkie chybienia. Każda instrukcja w pamięci podręcznej zajmuje kilka kilobajtów pamięci.
Aby zwiększyć rozmiar pamięci podręcznej, zastąp onConfigure w podklasie SQLiteOpenHelper:
override fun onConfigure(db: SQLiteDatabase) {
    db.setMaxSqlCacheSize(SQLiteDatabase.MAX_SQL_CACHE_SIZE)
}
Jeśli używasz Room, wywołaj tę samą metodę na SupportSQLiteDatabase w wywołaniu zwrotnym onOpen obiektu RoomDatabase.Callback.
Zamykanie nieaktywnych baz danych, ale pozostawianie otwartych aktywnych baz danych
Otwarta baza danych zachowuje połączenia, pamięć podręczną i deskryptory plików nawet wtedy, gdy jest nieaktywna. W jednym z testów porównawczych nieaktywna baza danych Room w trybie WAL, która pozostała otwarta, zajmowała około 678 KB pamięci podręcznej strony SQLite i 5 deskryptorów plików. Jeśli używasz bazy danych tylko sporadycznie, na przykład podczas codziennej synchronizacji, zamknij ją po zakończeniu.
Aby bezpiecznie zamknąć nieaktywne bazy danych, postępuj zgodnie z tymi wskazówkami:
- Room może zamknąć nieaktywną bazę danych za pomocą
setAutoCloseTimeout, który jest eksperymentalnym interfejsem API. Room ponownie otworzy bazę danych przy następnym dostępie i ponownie uruchomi wywołanie zwrotneonOpen, więc umieść tam konfigurację połączenia. - Unikaj metod
setIdleConnectionTimeoutinterfejsówSQLiteOpenHelperiSQLiteDatabase.OpenParams.Builder. Są one wycofane na poziomie interfejsu API 29, ponieważ zamykają połączenia bez przywracania ustawień zastosowanych za pomocą instrukcjiPRAGMA. - Nie zamykaj bazy danych, do której wysyłasz zapytania co kilka sekund. Limit czasu krótszy niż odstęp między zapytaniami powoduje wielokrotne zamykanie i ponowne otwieranie bazy danych, co za każdym razem powoduje odrzucenie pamięci podręcznej stron i instrukcji, a następne zapytanie jest wolniejsze.
Uwzględnianie pamięci SQLite
Pamięć SQLite może być trudna do wykrycia. Pamięć podręczna stron SQLite i pamięć podręczna instrukcji to natywne alokacje sterty. Android nie włącza jednak domyślnie operacji wejścia/wyjścia mapowanych na pamięć w SQLite, więc SQLite odczytuje pliki bazy danych za pomocą zwykłych odczytów plików, a zawartość plików, którą jądro zapisuje w pamięci podręcznej, to niezmapowane strony plików. Nie są one wliczane do wyniku PSS aplikacji w dumpsys meminfo. Na urządzeniach, które korzystają z rozliczania pamięci cgroup v2, jądro nadal obciąża tymi stronami grupę cgroup pamięci aplikacji. Aby zmniejszyć ten ukryty ślad, odczytuj mniej stron, używając indeksów i odczytując tylko potrzebne wiersze i kolumny. Zamknięcie niepotrzebnych baz danych zwalnia też ich pamięć podręczną SQLite.
Definiowanie wydajnych schematów tabel
Aby zoptymalizować wydajność i zminimalizować wykorzystanie danych, zdefiniuj wydajny schemat tabeli. SQLite tworzy wydajne plany zapytań i dane, co przyspiesza pobieranie danych. W tej sekcji znajdziesz sprawdzone metody tworzenia schematów tabel.
Rozważ kategorię INTEGER PRIMARY KEY.
W tym przykładzie zdefiniuj i wypełnij tabelę w następujący sposób:
CREATE TABLE Customers(
  id INTEGER,
  name TEXT,
  city TEXT
);
INSERT INTO Customers Values(456, 'John Lennon', 'Liverpool, England');
INSERT INTO Customers Values(123, 'Michael Jackson', 'Gary, IN');
INSERT INTO Customers Values(789, 'Dolly Parton', 'Sevier County, TN');
Tabela wyjściowa wygląda tak:
| rowid | id | nazwa | miasto |
|---|---|---|---|
| 1 | 456 | John Lennon | Liverpool, Anglia |
| 2 | 123 | Michael Jackson | Gary, Indiana |
| 3 | 789 | Dolly Parton | Hrabstwo Sevier, Tennessee |
Kolumna rowid to indeks, który zachowuje kolejność wstawiania. Zapytania, które filtrują według rowid, są implementowane jako szybkie wyszukiwanie w B-drzewie, ale zapytania, które filtrują według id, są powolnym skanowaniem tabeli.
Jeśli planujesz wyszukiwanie według id, możesz uniknąć przechowywania kolumny rowid, aby zmniejszyć ilość danych w pamięci i przyspieszyć działanie bazy danych:
CREATE TABLE Customers(
  id INTEGER PRIMARY KEY,
  name TEXT,
  city TEXT
);
Tabela wygląda teraz tak:
| id | nazwa | miasto |
|---|---|---|
| 123 | Michael Jackson | Gary, Indiana |
| 456 | John Lennon | Liverpool, Anglia |
| 789 | Dolly Parton | Hrabstwo Sevier, Tennessee |
Ponieważ nie musisz przechowywać kolumny rowid, zapytania id są szybkie. Zwróć uwagę, że tabela jest teraz posortowana według id, a nie zamówienia reklamowego.
Przyspieszanie zapytań za pomocą indeksów
SQLite używa indeksów, aby przyspieszyć zapytania. Jeśli tabela ma indeks dla kolumny, zapytanie jest przyspieszane podczas filtrowania (WHERE), sortowania (ORDER BY) lub agregowania (GROUP BY) kolumny.
W poprzednim przykładzie filtrowanie według city wymaga skanowania całej tabeli:
SELECT id, name
WHERE city = 'London, England';
W przypadku aplikacji z dużą liczbą zapytań o miasta możesz przyspieszyć te zapytania za pomocą indeksu:
CREATE INDEX city_index ON Customers(city);
Indeks jest implementowany jako dodatkowa tabela posortowana według kolumny indeksu i zmapowana na rowid:
| miasto | rowid |
|---|---|
| Gary, Indiana | 2 |
| Liverpool, Anglia | 1 |
| Hrabstwo Sevier, Tennessee | 3 |
Zwróć uwagę, że koszt przechowywania kolumny city jest teraz podwójny, ponieważ znajduje się ona zarówno w pierwotnej tabeli, jak i w indeksie. Ponieważ używasz indeksu, koszt dodatkowego miejsca na dane jest wart korzyści, jaką dają szybsze zapytania.
Nie utrzymuj jednak indeksu, którego nie używasz, aby uniknąć płacenia za przechowywanie danych bez zwiększenia wydajności zapytań.
Tworzenie indeksów wielokolumnowych
Jeśli zapytania łączą wiele kolumn, możesz utworzyć indeksy wielokolumnowe, aby w pełni przyspieszyć zapytanie. Możesz też użyć indeksu w kolumnie zewnętrznej i pozwolić na wyszukiwanie wewnętrzne w formie skanowania liniowego.
Na przykład w przypadku tego zapytania:
SELECT id, name
WHERE city = 'London, England'
ORDER BY city, name
Możesz przyspieszyć zapytanie za pomocą indeksu wielokolumnowego w tej samej kolejności, co w zapytaniu:
CREATE INDEX city_name_index ON Customers(city, name);
Jeśli jednak masz indeks tylko w polu city, przyspieszone jest tylko sortowanie zewnętrzne, a sortowanie wewnętrzne wymaga skanowania liniowego.
Działa to również w przypadku zapytań z prefiksami. Na przykład indeks ON Customers (city, name) przyspiesza też filtrowanie, porządkowanie i grupowanie według city, ponieważ tabela indeksu wielokolumnowego jest uporządkowana według podanych indeksów w podanej kolejności.
Rozważ kategorię WITHOUT ROWID.
Domyślnie SQLite tworzy kolumnę rowid dla tabeli, gdzie rowid jest niejawnym INTEGER PRIMARY KEY AUTOINCREMENT. Jeśli masz już kolumnę INTEGER PRIMARY KEY, ta kolumna stanie się aliasem kolumny rowid.
W przypadku tabel, które mają klucz podstawowy inny niż INTEGER lub złożony z kolumn, rozważ użycie WITHOUT ROWID.
Przechowuj małe dane jako BLOB, a duże dane jako plik
Jeśli chcesz powiązać z wierszem duże dane, takie jak miniatura obrazu lub zdjęcie kontaktu, możesz zapisać je w kolumnie BLOB lub w pliku, a następnie zapisać ścieżkę w kolumnie.
Rozmiary plików są zwykle zaokrąglane w górę do wielokrotności 4 KB. W przypadku bardzo małych plików, w których błąd zaokrąglenia jest znaczący, bardziej efektywne jest przechowywanie ich w bazie danych jako BLOB. SQLite minimalizuje wywołania systemu plików i w niektórych przypadkach jest szybszy niż bazowy system plików.
Zwiększanie wydajności zapytań
Aby zwiększyć wydajność zapytań w SQLite, postępuj zgodnie z tymi sprawdzonymi metodami, które pozwalają zminimalizować czas odpowiedzi i zmaksymalizować wydajność przetwarzania.
Odczytywanie tylko potrzebnych wierszy
Filtry umożliwiają zawężenie wyników przez określenie pewnych kryteriów, takich jak zakres dat, lokalizacja lub nazwa. Limity pozwalają kontrolować liczbę wyświetlanych wyników:
db.rawQuery("""
    SELECT name
    FROM Customers
    LIMIT 10;
    """.trimIndent(),
    null
).use { cursor ->
    while (cursor.moveToNext()) {
        // Process cursor data
    }
}
Odczytywanie tylko potrzebnych kolumn
Unikaj wybierania niepotrzebnych kolumn, które mogą spowolnić zapytania i marnować zasoby. Zamiast tego wybieraj tylko te kolumny, które są używane.
W tym przykładzie wybierasz id, name i phone:
// This is not the most efficient way of doing this.
// See the following example for a better approach.

db.rawQuery(
    """
    SELECT id, name, phone
    FROM customers;
    """.trimIndent(),
    null
).use { cursor ->
    while (cursor.moveToNext()) {
        val name = cursor.getString(1)
        // Further processing
    }
}
Potrzebujesz jednak tylko kolumny name:
db.rawQuery("""
    SELECT name
    FROM Customers;
    """.trimIndent(),
    null
).use { cursor ->
    while (cursor.moveToNext()) {
        val name = cursor.getString(0)
        // Further processing
    }
}
Parametryzowanie zapytań
Ciąg zapytania może zawierać parametr, który jest znany tylko w czasie działania, na przykład:
fun getNameById(id: Long): String?
    db.rawQuery(
        "SELECT name FROM customers WHERE id=$id", null
    ).use { cursor ->
        return if (cursor.moveToFirst()) {
            cursor.getString(0)
        } else {
            null
        }
    }
}
W poprzednim kodzie każde zapytanie tworzy inny ciąg znaków, więc nie korzysta z pamięci podręcznej instrukcji. Każde wywołanie wymaga od SQLite skompilowania go przed wykonaniem. Zamiast tego możesz zastąpić argument id parametrem i powiązać wartość z selectionArgs:
fun getNameById(id: Long): String? {
    db.rawQuery(
        """
          SELECT name
          FROM customers
          WHERE id=?
        """.trimIndent(), arrayOf(id.toString())
    ).use { cursor ->
        return if (cursor.moveToFirst()) {
            cursor.getString(0)
        } else {
            null
        }
    }
}
Teraz zapytanie można skompilować raz i zapisać w pamięci podręcznej. Skompilowane zapytanie jest używane ponownie między różnymi wywołaniami funkcji getNameById(long).
Iteruj w SQL, a nie w kodzie
Użyj pojedynczego zapytania, które zwraca wszystkie wyniki, zamiast pętli programowej iterującej zapytania SQL w celu zwrócenia poszczególnych wyników. Pętla programowa jest około 1000 razy wolniejsza niż pojedyncze zapytanie SQL.
Używanie DISTINCT w przypadku unikalnych wartości
Użycie słowa kluczowego DISTINCT może poprawić wydajność zapytań, ponieważ zmniejsza ilość danych, które muszą zostać przetworzone. Jeśli na przykład chcesz zwrócić tylko unikalne wartości z kolumny, użyj DISTINCT:
db.rawQuery("""
    SELECT DISTINCT name
    FROM Customers;
    """.trimIndent(),
    null
).use { cursor ->
    while (cursor.moveToNext()) {
        // Only iterate over distinct names in Kotlin
        // Process distinct name
    }
}
W miarę możliwości używaj funkcji agregujących
Używaj funkcji agregujących, aby uzyskiwać wyniki zbiorcze bez danych wierszy. Na przykład ten kod sprawdza, czy istnieje co najmniej 1 pasujący wiersz:
// This is not the most efficient way of doing this.
// See the following example for a better approach.

db.rawQuery("""
    SELECT id, name
    FROM Customers
    WHERE city = 'Paris';
    """.trimIndent(),
    null
).use { cursor ->
    if (cursor.moveToFirst()) {
        // At least one customer from Paris
        // Handle found
    } else {
        // No customers from Paris
        // Handle not found
}
Aby pobrać tylko pierwszy wiersz, możesz użyć funkcji EXISTS(), która zwraca 0, jeśli nie ma pasującego wiersza, i 1, jeśli pasuje co najmniej 1 wiersz:
db.rawQuery("""
    SELECT EXISTS (
        SELECT null
        FROM Customers
        WHERE city = 'Paris';
    );
    """.trimIndent(),
    null
).use { cursor ->
    if (cursor.moveToFirst() && cursor.getInt(0) == 1) {
        // At least one customer from Paris
        // Handle found
    } else {
        // No customers from Paris
        // Handle not found
    }
}
Użyj funkcji agregujących SQLite w kodzie aplikacji:
COUNT: zlicza liczbę wierszy w kolumnie.SUM: dodaje wszystkie wartości liczbowe w kolumnie.MINlubMAX: określa najniższą lub najwyższą wartość. Działa w przypadku kolumn liczbowych, typówDATEi typów tekstowych.AVG: znajduje średnią wartość liczbową.GROUP_CONCAT: łączy ciągi znaków z opcjonalnym separatorem.
Użyj COUNT() zamiast Cursor.getCount()
W tym przykładzie funkcja Cursor.getCount() odczytuje wszystkie wiersze z bazy danych i zwraca wszystkie wartości wierszy:
// This is not the most efficient way of doing this.
// See the following example for a better approach.

db.rawQuery("""
    SELECT id
    FROM Customers;
    """.trimIndent(),
    null
).use { cursor ->
    val count = cursor.getCount()
    // Use count
}
Jeśli jednak użyjesz COUNT(), baza danych zwróci tylko liczbę:
db.rawQuery("""
    SELECT COUNT(*)
    FROM Customers;
    """.trimIndent(),
    null
).use { cursor ->
    cursor.moveToFirst()
    val count = cursor.getInt(0)
    // Use count
}
Zagnieżdżanie zapytań zamiast kodu
SQL jest kompozycyjny i obsługuje podzapytania, złączenia oraz ograniczenia kluczy obcych. Możesz użyć wyniku jednego zapytania w innym zapytaniu bez konieczności przechodzenia przez kod aplikacji. Zmniejsza to potrzebę kopiowania danych z SQLite i umożliwia silnikowi bazy danych optymalizację zapytania.
W tym przykładzie możesz uruchomić zapytanie, aby dowiedzieć się, w którym mieście jest najwięcej klientów, a następnie użyć wyniku w innym zapytaniu, aby znaleźć wszystkich klientów z tego miasta:
// This is not the most efficient way of doing this.
// See the following example for a better approach.

db.rawQuery("""
    SELECT city
    FROM Customers
    GROUP BY city
    ORDER BY COUNT(*) DESC
    LIMIT 1;
    """.trimIndent(),
    null
).use { cursor ->
    if (cursor.moveToFirst()) {
        val topCity = cursor.getString(0)
        db.rawQuery("""
            SELECT name, city
            FROM Customers
            WHERE city = ?;
        """.trimIndent(),
        arrayOf(topCity)).use { innerCursor ->
            while (innerCursor.moveToNext()) {
                // Process inner cursor data
            }
        }
    }
}
Aby uzyskać wynik w czasie o połowę krótszym niż w poprzednim przykładzie, użyj pojedynczego zapytania SQL z zagnieżdżonymi instrukcjami:
db.rawQuery("""
    SELECT name, city
    FROM Customers
    WHERE city IN (
        SELECT city
        FROM Customers
        GROUP BY city
        ORDER BY COUNT (*) DESC
        LIMIT 1;
    );
    """.trimIndent(),
    null
).use { cursor ->
    if (cursor.moveToNext()) {
        // Process cursor data
    }
}
Sprawdzanie unikalności w SQL
Jeśli wiersz nie może zostać wstawiony, chyba że określona wartość kolumny jest unikalna w tabeli, bardziej wydajne może być wymuszenie tej unikalności jako ograniczenia kolumny.
W tym przykładzie jedno zapytanie jest uruchamiane w celu sprawdzenia wiersza, który ma zostać wstawiony, a drugie w celu jego wstawienia:
// This is not the most efficient way of doing this.
// See the following example for a better approach.

db.rawQuery(
    """
    SELECT EXISTS (
        SELECT null
        FROM customers
        WHERE username = ?
    );
    """.trimIndent(),
    arrayOf(customer.username)
).use { cursor ->
    if (cursor.moveToFirst() && cursor.getInt(0) == 1) {
        throw AddCustomerException(customer)
    }
}
db.execSQL(
    "INSERT INTO customers VALUES (?, ?, ?)",
    arrayOf(
        customer.id.toString(),
        customer.name,
        customer.username
    )
)
Zamiast sprawdzać ograniczenie unikalności w Kotlin, możesz to zrobić w SQL podczas definiowania tabeli:
CREATE TABLE Customers(
  id INTEGER PRIMARY KEY,
  name TEXT,
  username TEXT UNIQUE
);
SQLite działa tak samo jak:
CREATE TABLE Customers(...);
CREATE UNIQUE INDEX CustomersUsername ON Customers(username);
Teraz możesz wstawić wiersz i pozwolić SQLite sprawdzić ograniczenie:
try {
    db.execSQL(
        "INSERT INTO Customers VALUES (?, ?, ?)",
        arrayOf(customer.id.toString(), customer.name, customer.username)
    )
} catch(e: SQLiteConstraintException) {
    throw AddCustomerException(customer, e)
}
SQLite obsługuje unikalne indeksy z wieloma kolumnami:
CREATE TABLE table(...);
CREATE UNIQUE INDEX unique_table ON table(column1, column2, ...);
SQLite weryfikuje ograniczenia szybciej i z mniejszym narzutem niż kod w języku Kotlin. Zalecamy używanie SQLite zamiast kodu aplikacji.
Grupowanie wielu wstawień w jednej transakcji
Transakcja zatwierdza wiele operacji, co poprawia nie tylko wydajność, ale też poprawność. Aby poprawić spójność danych i zwiększyć wydajność, możesz wstawiać dane zbiorczo:
db.beginTransaction()
try {
    customers.forEach { customer ->
        db.execSQL(
            "INSERT INTO Customers VALUES (?, ?, ?)",
            arrayOf(customer.id.toString(), customer.name, "customerValue")
        )
    }
    db.setTransactionSuccessful()
} finally {
    db.endTransaction()
}
Poza jawną transakcją każdy zapis jest wykonywany we własnej niejawnej transakcji i płaci pełny koszt zatwierdzenia, w tym fsync w trybie synchronicznym FULL. Grupowanie pozwala ponieść ten koszt tylko raz, co może sprawić, że grupa operacji zapisu będzie o rząd wielkości lub więcej szybsza.
Nie uwzględniaj w transakcji operacji niezwiązanych z bazą danych. Nie utrzymuj otwartej transakcji zapisu w przypadku blokowania operacji we/wy na plikach, takich jak File.delete, żądań sieciowych, komunikacji między procesami, takich jak wywołania lub transmisje ContentResolver, ani pozyskiwania blokad:
- Jednoczesne zapisy w bazie danych są blokowane do momentu zakończenia transakcji, a bez WAL blokowane są również odczyty.
- Uzyskanie blokady aplikacji między
beginTransactionaendTransactiongrozi zakleszczeniem, jeśli inny wątek utrzymuje tę blokadę podczas oczekiwania na połączenie z bazą danych. - Wycofanie nieudanej transakcji nie cofa zewnętrznych efektów ubocznych, takich jak usunięte pliki, a transmisje wysłane przed zatwierdzeniem
endTransactionwybudzają odbiorniki, zanim zmiany staną się widoczne.
Przygotuj dane zewnętrzne przed wywołaniem beginTransaction, wykonuj tylko operacje SQLite między beginTransaction i endTransaction oraz zapisuj ścieżki plików lub ładunki w pamięci, aby przeprowadzić czyszczenie lub wysłać transmisje po zatwierdzeniu endTransaction.
Jeśli baza danych odwołuje się do niezmiennych plików, przechowuj je w jednym katalogu nadrzędnym i przed rozpoczęciem transakcji utwórz, zapisz i zsynchronizuj każdy plik pod unikalną nazwą. Nazwy plików są unikalne, a baza danych jest źródłem informacji o aktywnych plikach, więc pomiń krok zmiany nazwy niepodzielnej. Aby wyczyścić pliki pozostawione przez wycofane transakcje lub zastąpione wiersze, zaplanuj okresowe zadanie WorkManager w tym samym sekwencyjnym wykonawcy zapisu (lub w ramach tej samej blokady), który serializuje zapisy w bazie danych i tworzenie plików. Dzięki temu proces czyszczenia będzie wysyłać zapytania do aktywnych wierszy i usuwać pliki bez odwołań bez konkurowania z aktywnym procesem zapisu.
Korzystanie z narzędzi do rozwiązywania problemów
SQLite udostępnia te narzędzia do rozwiązywania problemów, które pomagają mierzyć wydajność.
Korzystanie z interaktywnego promptu SQLite
Uruchom SQLite na swoim komputerze, aby wykonywać zapytania i uczyć się.
Różne wersje platformy Androida używają różnych wersji SQLite. Aby używać tego samego silnika co na urządzeniu z Androidem, użyj adb shell i uruchom sqlite3 na urządzeniu docelowym.
Możesz poprosić SQLite o mierzenie czasu zapytań:
sqlite> .timer on
sqlite> SELECT ...
Run Time: real ... user ... sys ...
EXPLAIN QUERY PLAN
Możesz poprosić SQLite o wyjaśnienie, jak zamierza odpowiedzieć na zapytanie, używając EXPLAIN QUERY PLAN:
sqlite> EXPLAIN QUERY PLAN
SELECT id, name
FROM Customers
WHERE city = 'Paris';
QUERY PLAN
`--SCAN Customers
W poprzednim przykładzie, aby znaleźć wszystkich klientów z Paryża, trzeba przeskanować całą tabelę bez indeksu. Jest to tzw. złożoność liniowa. SQLite musi odczytać wszystkie wiersze i zachować tylko te, które pasują do klientów z Paryża. Aby rozwiązać ten problem, możesz dodać indeks:
sqlite> CREATE INDEX Idx1 ON Customers(city);
sqlite> EXPLAIN QUERY PLAN
SELECT id, name
FROM Customers
WHERE city = 'Paris';
QUERY PLAN
`--SEARCH test USING INDEX Idx1 (city=?
Jeśli używasz interaktywnej powłoki, możesz poprosić SQLite o wyjaśnianie planów zapytań:
sqlite> .eqp on
Więcej informacji znajdziesz w artykule Planowanie zapytań.
SQLite Analyzer
SQLite udostępnia interfejs wiersza poleceń (CLI) sqlite3_analyzer, który umożliwia zrzucanie dodatkowych informacji, które mogą być przydatne do rozwiązywania problemów z wydajnością. Aby zainstalować, otwórz stronę pobierania SQLite.
Możesz użyć adb pull, aby pobrać plik bazy danych z urządzenia docelowego na stację roboczą w celu analizy:
adb pull /data/data/<app_package_name>/databases/<db_name>.db
SQLite Browser
Możesz też zainstalować narzędzie GUI SQLite Browser ze strony pobierania SQLite.
Logowanie na Androidzie
Android mierzy czas zapytań SQLite i rejestruje je:
# Enable query time logging
$ adb shell setprop log.tag.SQLiteTime VERBOSE
# Disable query time logging
$ adb shell setprop log.tag.SQLiteTime ERROR
Na Androidzie 13 i nowszych wersjach możesz też rejestrować tylko powolne operacje. Ustaw próg w milisekundach, a następnie ponownie uruchom aplikację, aby odczytała tag logu:
$ adb shell setprop log.tag.SQLiteSlowQueries VERBOSE
$ adb shell setprop db.log.slow_query_threshold 100
$ adb shell am force-stop <package-name>
Powolne operacje są widoczne w logcat pod tagiem SQLiteConnection wraz z czasem trwania, SQL i ścieżką bazy danych. Aby ustawić próg dla jednej aplikacji, użyj db.log.slow_query_threshold.<uid>, gdzie <uid> to identyfikator UID aplikacji.
Śledzenie Perfetto
Podczas konfigurowania Perfetto dodaj kategorię atrace database, aby uwzględnić operacje SQLite w śladzie. Aby zobaczyć, co robi każdy wątek podczas wykonywania kodu SQL, dodaj też zdarzenia harmonogramu:
data_sources {
  config {
    name: "linux.ftrace"
    ftrace_config {
      ftrace_events: "sched/sched_switch"
      ftrace_events: "sched/sched_waking"
      ftrace_events: "sched/sched_blocked_reason"
      atrace_categories: "database"
    }
  }
}
Android śledzi każdą operację bazy danych jako wycinek o nazwie odpowiadającej operacji i jej instrukcji SQL, np. executeForCursorWindow SELECT * FROM message WHERE body LIKE ?. SQL zachowuje obiekty zastępcze ? i jest skracany do 256 znaków. Argumenty powiązania nie są uwzględniane. Operacje obejmują open, close, prepare, execute i warianty executeFor. Wycinek prepare nie oznacza, że nie udało się znaleźć instrukcji w pamięci podręcznej.
Układ ścieżek zależy od wersji Androida:
- W Androidzie 17 i nowszych każde połączenie ma w procesie aplikacji ścieżkę asynchroniczną o nazwie
SQLiteConnection-, po której następuje numer połączenia. Transakcje są wyświetlane jako wycinkiTRANSACTION-EXCLUSIVE,TRANSACTION-IMMEDIATElubTRANSACTION-DEFERRED, a instrukcje, które zostały w nich wykonane, są zagnieżdżone pod nimi. Wątek, który wykonuje operację, otrzymuje też zdarzenia natychmiastoweSTART-iEND-na ścieżce wątku dla każdej transakcji i dla każdej instrukcji poza transakcją. Nazwy tych zdarzeń kończą się nazwą ścieżki połączenia, na przykład-SQLiteConnection-0. - W Androidzie 16 i starszych każda instrukcja SQL ma własną ścieżkę asynchroniczną w procesie aplikacji, a transakcje nie są śledzone.
Numery połączeń zaczynają się od 0 dla każdej bazy danych, więc główne połączenia wszystkich baz danych w procesie współdzielą ścieżkę SQLiteConnection-0. Jeśli aplikacja używa więcej niż 1 bazy danych jednocześnie, mierz czas trwania za pomocą zdarzeń START- i END- na ścieżkach wątków.
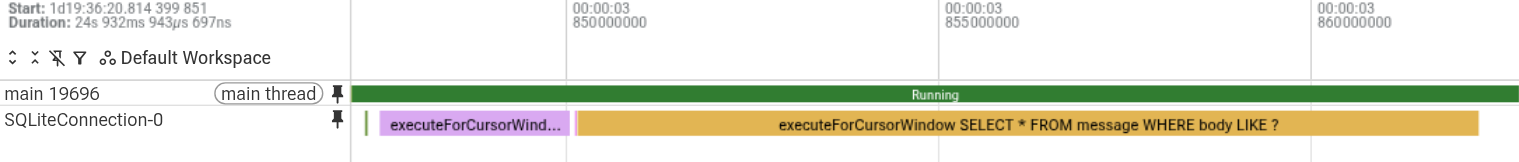
Rysunek 1. Pełne skanowanie tabeli w głównym wątku w Androidzie 17.
Te wycinki możesz analizować za pomocą PerfettoSQL w interfejsie Perfetto lub za pomocą trace_processor. To zapytanie znajduje najczęstsze operacje SQLite w każdym procesie. To zapytanie działa we wszystkich wersjach Androida:
INCLUDE PERFETTO MODULE slices.with_context;

SELECT process_name, name AS operation, COUNT(*) AS count
FROM process_slice
WHERE name GLOB 'open *' OR name GLOB 'close *'
  OR name GLOB 'prepare *' OR name GLOB 'execute*'
  OR name GLOB 'TRANSACTION-*'
GROUP BY process_name, name
ORDER BY count DESC
LIMIT 10;
Poniższe zapytanie wyświetla listę operacji SQLite, które trwały dłużej niż 1 ms w głównym wątku na Androidzie 17 lub nowszym:
INCLUDE PERFETTO MODULE slices.with_context;

WITH marks AS (
  SELECT process_name, utid, is_main_thread, ts, name,
    LEAD(ts) OVER (PARTITION BY utid ORDER BY ts) AS end_ts,
    LEAD(name) OVER (PARTITION BY utid ORDER BY ts) AS end_name
  FROM thread_slice
  WHERE name GLOB 'START-*' OR name GLOB 'END-*'
)
SELECT process_name, ts, ROUND((end_ts - ts) / 1e6, 1) AS dur_ms,
  substr(name, 7) AS operation
FROM marks
WHERE name GLOB 'START-*'
  AND end_name = 'END-' || substr(name, 7)
  AND is_main_thread
  AND end_ts - ts > 1e6
ORDER BY dur_ms DESC
LIMIT 10;
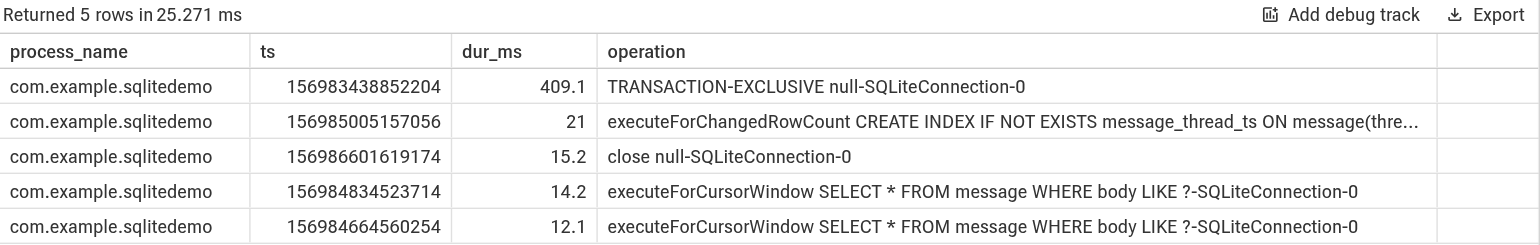
Rysunek 2. Operacje SQLite trwające dłużej niż 1 ms w głównym wątku.
To zapytanie znajduje wątki, które zapisują dane poza jawną transakcją, gdzie każdy zapis płaci za własne zatwierdzenie, w Androidzie 17 i nowszych:
INCLUDE PERFETTO MODULE slices.with_context;

WITH ops AS (
  SELECT process_name, thread_name, utid, name,
    upper(ltrim(substr(name, instr(name, ' ') + 1))) AS sql
  FROM thread_slice
  WHERE name GLOB 'START-*'
)
SELECT process_name, thread_name,
  SUM(name GLOB 'START-TRANSACTION-*') AS transactions,
  SUM(name GLOB 'START-execute*' AND (sql GLOB 'INSERT *'
    OR sql GLOB 'UPDATE *' OR sql GLOB 'DELETE *' OR sql GLOB 'REPLACE *'))
    AS autocommit_writes
FROM ops
GROUP BY utid
HAVING autocommit_writes > 0
ORDER BY autocommit_writes DESC
LIMIT 10;
dumpsys meminfo
adb shell dumpsys meminfo <package-name> wyświetla statystyki dotyczące wykorzystania pamięci przez aplikację, w tym szczegółowe informacje o SQLite w sekcji DATABASES. Na przykład ten fragment pochodzi z danych wyjściowych polecenia adb shell dumpsys meminfo com.google.android.gms.persistent na urządzeniu dewelopera:
DATABASES
      pgsz     dbsz   Lookaside(b) cache hits cache misses cache size  Dbname
PER CONNECTION STATS
         4       52             45     8    41     6  /data/user/10/com.google.android.gms/databases/gaia-discovery
         4        8                    0     0     0    (attached) temp
         4       52             56     5    23     6  /data/user/10/com.google.android.gms/databases/gaia-discovery (1)
         4      252             95   233   124    12  /data/user_de/10/com.google.android.gms/databases/phenotype.db
         4        8                    0     0     0    (attached) temp
         4      252             17     0    17     1  /data/user_de/10/com.google.android.gms/databases/phenotype.db (1)
         4     9280            105 103169 69805    25  /data/user/10/com.google.android.gms/databases/phenotype.db
         4       20                    0     0     0    (attached) temp
         4     9280            108 13877  6394    25  /data/user/10/com.google.android.gms/databases/phenotype.db (2)
         4        8                    0     0     0    (attached) temp
         4     9280            105 12548  5519    25  /data/user/10/com.google.android.gms/databases/phenotype.db (3)
         4        8                    0     0     0    (attached) temp
         4     9280            107 18328  7886    25  /data/user/10/com.google.android.gms/databases/phenotype.db (1)
         4        8                    0     0     0    (attached) temp
         4       36             51   156    29     5  /data/user/10/com.google.android.gms/databases/mobstore_gc_db_v0
         4       36             97    47    27    10  /data/user/10/com.google.android.gms/databases/context_feature_default.db
         4       36             56     3    16     4  /data/user/10/com.google.android.gms/databases/context_feature_default.db (2)
         4      300             40  2111    24     5  /data/user/10/com.google.android.gms/databases/gservices.db
         4      300             39     3    17     4  /data/user/10/com.google.android.gms/databases/gservices.db (1)
         4       20             17     0    14     1  /data/user/10/com.google.android.gms/databases/gms.notifications.db
         4       20             33     1    15     2  /data/user/10/com.google.android.gms/databases/gms.notifications.db (1)
         4      120             40   143   163     4  /data/user/10/com.google.android.gms/databases/android_pay
         4      120            123    86    32    19  /data/user/10/com.google.android.gms/databases/android_pay (1)
         4       28             33     4    17     3  /data/user/10/com.google.android.gms/databases/googlesettings.db
POOL STATS
     cache hits  cache misses    cache size  Dbname
             13            68            81  /data/user/10/com.google.android.gms/databases/gaia-discovery
            233           145           378  /data/user_de/10/com.google.android.gms/databases/phenotype.db
         147921         89616        237537  /data/user/10/com.google.android.gms/databases/phenotype.db
            156            30           186  /data/user/10/com.google.android.gms/databases/mobstore_gc_db_v0
             50            57           107  /data/user/10/com.google.android.gms/databases/context_feature_default.db
           2114            43          2157  /data/user/10/com.google.android.gms/databases/gservices.db
              1            31            32  /data/user/10/com.google.android.gms/databases/gms.notifications.db
            229           197           426  /data/user/10/com.google.android.gms/databases/android_pay
              4            18            22  /data/user/10/com.google.android.gms/databases/googlesettings.db
Android 14 i nowsze wersje drukują tabele PER CONNECTION STATS i POOL STATS pokazane w przykładzie. Android 13 i starsze wersje wyświetlają tylko tabelę dla poszczególnych połączeń, ze statystykami pamięci podręcznej połączonymi w jedną kolumnę cache jako hits/misses/size.
W sekcji PER CONNECTION STATS znajdziesz te elementy:
pgsz: rozmiar jednej strony bazy danych w KB.dbsz: rozmiar całego pliku bazy danych w KB.Lookaside(b): liczba gniazd pamięci lookaside używanych przez połączenie. Pomimo(b)w nagłówku jest to liczba slotów, a nie bajtów.cache hits,cache missesicache size: statystyki pamięci podręcznej przygotowanych instrukcji połączenia. Te wartości zliczają skompilowane instrukcje SQL, a nie strony bazy danych.Dbname: ścieżka do pliku bazy danych. Dodatkowe połączenia z tą samą bazą danych mają w nawiasie dołączony numer, np.(1). Dzięki WAL baza danych może mieć kilka połączeń, co umożliwia równoległe odczyty.
W sekcji POOL STATS znajdziesz statystyki pamięci podręcznej przygotowanych instrukcji dla każdej puli połączeń:
cache hits: SQLite zapisuje w pamięci podręcznej przygotowane instrukcje i próbuje ich używać ponownie podczas wykonywania zapytań, aby zaoszczędzić czas i pamięć podczas kompilowania instrukcji SQL. Jest to liczba trafień w pamięci podręcznej instrukcji.cache misses: liczba braków w pamięci podręcznej instrukcji.cache size: w Androidzie 16 QPR2 i nowszych liczba przygotowanych instrukcji w pamięci podręcznej, zsumowana we wszystkich bezczynnych połączeniach w puli. W Androidzie 14 do Androida 16 QPR1 ta wartość jest sumą trafień i chybień i nie odzwierciedla rozmiaru pamięci podręcznej.
Na podstawie tych statystyk możesz zdecydować, co poprawić:
- Wysoki współczynnik nietrafień oznacza, że SQLite wielokrotnie kompiluje te same instrukcje.
Najpierw poszukaj kodu SQL utworzonego za pomocą konkatenacji ciągów znaków i sparametryzuj go. Jeśli zapytania są już sparametryzowane, a parametr
cache sizedla połączenia osiągnął limit 25, zwiększ rozmiar pamięci podręcznej. - Ścieżka bazy danych, która pojawia się więcej niż raz bez sufiksu w stylu
(1), oznacza, że aplikacja otworzyła ten sam plik 2 razy. Otwórz każdą bazę danych raz. - Baza danych, z której aplikacja rzadko korzysta, nadal zajmuje pamięć, gdy jest otwarta. Gdy skończysz, zamknij go.
dumpsys dbinfo
adb shell dumpsys dbinfo <package-name> wyświetla stan każdej puli połączeń w aplikacji. Dodaj -v, aby wyświetlić listę instrukcji w pamięci podręcznej przygotowanych instrukcji każdego połączenia. Poniżej znajdziesz przykładowe dane wyjściowe z Androida 17 ze skróconymi ścieżkami i długimi wierszami:
** Database info for pid 2705 [com.example.app] **
Connection pool for /data/user/0/com.example.app/databases/settings.db:
  Open: true
  Max connections: 4
  Total execution time (ms): 4963
  Total statements executed: 231239
  Average time per statement (ms): 0
  Configuration: openFlags=805306368, ..., journalMode=WAL, syncMode=NORMAL
  IsReadOnlyDatabase: false
  Available primary connection:
    <none>
  Available non-primary connections:
    <none>
  Acquired connections:
    <none>
  Connection waiters:
    <none>
Connection pool for /data/user/0/com.example.app/databases/events.db:
  Open: true
  Max connections: 1
  Total execution time (ms): 842
  Total statements executed: 840
  Average time per statement (ms): 1
  Configuration: openFlags=268435456, ..., journalMode=TRUNCATE, syncMode=FULL
  IsReadOnlyDatabase: false
  Available primary connection:
    Connection #0:
      isPrimaryConnection: true
      onlyAllowReadOnlyOperations: false
      totalLongOperations: 0
      Most recently executed operations:
        0: [10-26 04:22:32.133] executeForChangedRowCount took 0ms -
           succeeded, sql="DELETE FROM params WHERE app_id=?", path=...
        1: [10-26 04:22:32.133] prepare took 0ms - succeeded,
           sql="DELETE FROM params WHERE app_id=?", path=...
        ...
Zwróć uwagę na te elementy:
Configuration: tryb dziennika i tryb synchroniczny puli. W Androidzie 13 i nowszych ten wiersz pokazuje tryby zastosowane przez platformę, w tym domyślne ustawienia platformy. W tym przykładzieevents.dbużywa dziennika wycofywania z trybem synchronicznymFULL, więc każde zatwierdzenie czeka na pełną synchronizację. Ta linia nie odzwierciedla instrukcjiPRAGMA, które uruchamiasz samodzielnie.Max connections: wartość 1 w przypadku bazy danych z możliwością zapisu oznacza, że platforma nie uważa bazy danych za działającą w trybie WAL, więc odczyty i zapisy korzystają z jednego połączenia.Total execution time,Total statements executediAverage time per statement: dostępne na Androidzie 13 lub nowszym. Użyj ich, aby znaleźć najbardziej obciążone bazy danych.Most recently executed operations: ostatnie 20 operacji na każdym połączeniu wraz z czasem ich trwania i instrukcją SQL. Szukaj wzorców, takich jak to samo zapytanie uruchamiane w pętli lub wiele zapisów z rzędu poza transakcją. W Androidzie 15 QPR1 i nowszych ta lista zawiera też transakcje jawne.totalLongOperationsiOperations exceeding 2000ms: dostępne w Androidzie 15 QPR1 i nowszych. Pokazują, ile operacji i transakcji trwało dłużej niż 2 sekundy, i wyświetlają listę ostatnich 10 z nich.Acquired connectionsiConnection waiters: połączenia, które są używane, i wątki, które czekają na połączenie. Oczekujące wskazują rywalizację, np. długą transakcję zapisu, która blokuje inne zapisy.Prepared statement cache: wydrukowano za pomocą-v. Wiele wpisów, które różnią się tylko wartościami literałów, wskazuje na SQL utworzony za pomocą konkatenacji ciągów znaków.- Ta sama ścieżka pod więcej niż jednym nagłówkiem
Connection pool foroznacza, że aplikacja otworzyła ten sam plik dwukrotnie.
Dodatkowe materiały
Wyświetla treści
Polecane dla Ciebie
- Uwaga: tekst linku jest wyświetlany, gdy język JavaScript jest wyłączony.
- Uruchamianie testów porównawczych w trybie ciągłej integracji
- Zablokowane klatki
- Tworzenie i pomiar profili podstawowych bez użycia biblioteki Macrobenchmark