Компиляция на 18 % быстрее без ущерба для производительности
Время на чтение: 8 минут
Команда Android Runtime (ART) сократила время компиляции на 18 %, не ухудшив качество скомпилированного кода и не допустив регрессии пикового использования памяти. Это улучшение было реализовано в рамках нашей инициативы 2025 года, направленной на сокращение времени компиляции без ущерба для использования памяти или качества скомпилированного кода.
Оптимизация скорости компиляции имеет решающее значение для ART. Например, при компиляции JIT это напрямую влияет на эффективность приложений и общую производительность устройства. Чем быстрее выполняется компиляция, тем быстрее начинают действовать оптимизации, что повышает удобство использования приложения. Кроме того, как в случае с JIT, так и с AOT, повышение скорости компиляции приводит к снижению потребления ресурсов во время компиляции, что положительно сказывается на времени работы от батареи и температуре устройства, особенно если оно относится к бюджетной категории.
Некоторые из этих улучшений скорости компиляции были реализованы в выпуске Android за июнь 2025 года, а остальные будут доступны в выпуске Android в конце года. Кроме того, все пользователи Android 12 и более новых версий могут получить эти улучшения с помощью основных обновлений.
Оптимизация оптимизирующего компилятора
Оптимизация компилятора всегда связана с компромиссами. Скорость не дается бесплатно, приходится чем-то жертвовать. Мы поставили перед собой очень четкую и сложную цель: ускорить работу компилятора, но при этом не допустить регрессии памяти и, что самое главное, не ухудшить качество создаваемого им кода. Если компилятор работает быстрее, но приложения работают медленнее, мы не достигли цели.
Единственный ресурс, который мы были готовы потратить, – это время наших разработчиков, чтобы провести глубокое исследование и найти решения, соответствующие строгим критериям. Давайте подробнее рассмотрим, как мы находим области для улучшения и решения различных проблем.
Поиск подходящих вариантов оптимизации
Чтобы оптимизировать показатель, его нужно отслеживать. В противном случае вы не сможете понять, улучшили ли вы его. К счастью, скорость компиляции довольно стабильна, если соблюдать некоторые меры предосторожности, например использовать одно и то же устройство для измерений до и после изменения и следить за тем, чтобы устройство не перегревалось. Кроме того, мы используем детерминированные методы измерения, например статистику компилятора, чтобы понять, что происходит на уровне кода.
Поскольку мы тратили на улучшения время разработчиков, нам нужно было как можно быстрее выпускать новые версии. Это означало, что мы взяли несколько типичных приложений (собственных, сторонних и саму ОС Android) для создания прототипов решений. Позже мы проверили, что окончательная реализация стоит того, с помощью ручного и автоматизированного тестирования.
С помощью этого набора APK мы запускаем локальную компиляцию вручную, получаем профиль компиляции и используем pprof, чтобы визуализировать, на что тратится время.
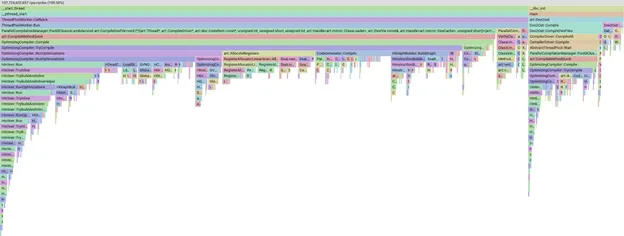
Пример диаграммы пламени профиля в pprof
Инструмент pprof очень мощный и позволяет нам разделять, фильтровать и сортировать данные, чтобы, например, узнать, какие этапы компиляции или методы занимают больше всего времени. Мы не будем подробно рассказывать о pprof, но знайте, что чем больше столбец, тем больше времени заняла компиляция.
В частности, вы можете посмотреть, какие методы занимают больше всего времени. На изображении ниже показан метод Kill, на который приходится более 1% времени компиляции. Другие популярные методы мы рассмотрим далее в этой статье.
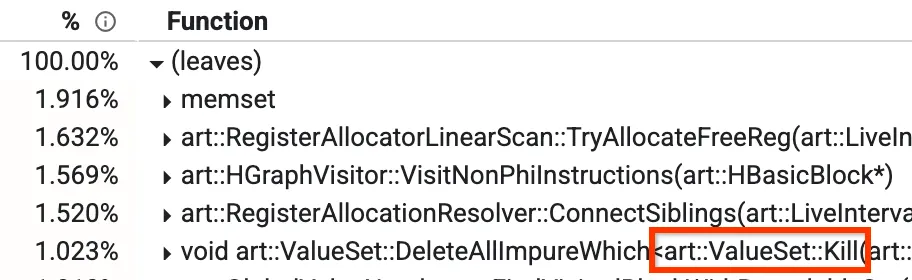
Профиль снизу вверх
В нашем оптимизирующем компиляторе есть этап, который называется глобальным присвоением номеров значений (GVN). Вам не нужно знать, как работает этот класс в целом, но важно понимать, что у него есть метод Kill, который удаляет некоторые узлы в соответствии с фильтром. Это занимает много времени, так как приходится перебирать все узлы и проверять их по одному. Мы заметили, что в некоторых случаях заранее известно, что проверка будет ложной, независимо от того, какие узлы активны в этот момент. В таких случаях мы можем полностью пропустить итерацию, снизив долю спама с 1,023% до 0,3% и сократив время выполнения GVN примерно на 15%.
Как внедрять полезные оптимизации
Мы рассказали, как измерять время и определять, на что оно тратится, но это только начало. Далее мы расскажем, как оптимизировать время компиляции.
Обычно в таких случаях, как с функцией Kill, мы смотрим, как выполняется итерация по узлам, и пытаемся ускорить ее, например выполняя действия параллельно или улучшая сам алгоритм. Именно так мы и поступили сначала, но когда поняли, что ничего не получается, то решили попробовать другой подход и в некоторых случаях вообще не вносить никаких изменений. При оптимизации такого рода легко упустить из виду общую картину.
В других случаях мы использовали различные методы, в том числе:
- использовать эвристические методы, чтобы определить, не приведет ли оптимизация к значимым результатам, и поэтому ее можно пропустить;
- использовать дополнительные структуры данных для кеширования вычисленных данных;
- изменение текущих структур данных для повышения скорости;
- лениво вычислять результаты, чтобы избежать циклов в некоторых случаях;
- используйте правильную абстракцию – ненужные функции могут замедлить работу кода;
- не тратить время на поиск часто используемого указателя в большом количестве загрузок;
Как понять, стоит ли заниматься оптимизацией?
В том-то и дело, что не нужно. Если вы обнаружили, что на компиляцию определенной области уходит много времени, и потратили много времени на попытки улучшить ее, иногда вы просто не можете найти решение. Возможно, ничего делать не нужно, на реализацию уйдет слишком много времени, значительно ухудшится другой показатель, увеличится сложность кода и т. д. За каждой успешной оптимизацией, о которой вы читаете в этом блоге, стоят бесчисленные другие, которые не принесли результатов.
Если вы оказались в похожей ситуации, попробуйте оценить, насколько вы сможете улучшить показатель, выполнив как можно меньше работы. Это означает, что:
- Оценка на основе собранных показателей или интуиции.
- Оценка с помощью быстрого прототипа
- Реализуйте решение.
Не забудьте оценить недостатки вашего решения. Например, если вы собираетесь использовать дополнительные структуры данных, сколько памяти вы готовы выделить?
Изучение данных
Давайте посмотрим, какие изменения мы внесли.
Мы оптимизировали метод FindReferenceInfoOf. Этот метод выполнял линейный поиск записи в векторе. Мы изменили структуру данных, чтобы индексировать ее по идентификатору инструкции, и теперь функция FindReferenceInfoOf имеет сложность O(1) вместо O(n). Кроме того, мы заранее выделили вектор, чтобы избежать изменения его размера. Мы немного увеличили объем памяти, поскольку нам пришлось добавить дополнительное поле, в котором подсчитывалось количество записей, вставленных в вектор, но это небольшая жертва, поскольку пиковое значение памяти не увеличилось. Это позволило ускорить этап LoadStoreAnalysis на 34–66 %, что привело к сокращению времени компиляции на 0,5–1,8 %.
У нас есть собственная реализация HashSet, которую мы используем в нескольких местах. Создание этой структуры данных занимало много времени, и мы выяснили почему. Много лет назад эта структура данных использовалась только в нескольких местах, где применялись очень большие наборы HashSet, и была оптимизирована для этого. Однако в последнее время он использовался в обратном направлении, и в нем было всего несколько записей, которые быстро удалялись. Это означало, что мы тратили ресурсы на создание огромного HashSet, но использовали его только для нескольких записей, а затем удаляли. Это изменение позволило сократить время компиляции примерно на 1, 3–2 %. Кроме того, использование памяти снизилось примерно на 0,5–1 %, поскольку мы перестали использовать такие большие структуры данных, как раньше.
Мы ускорили компиляцию на 0,5–1 %, передавая структуры данных по ссылке в лямбда-функцию, чтобы избежать их копирования. Это упущение, которое не было замечено при первоначальной проверке и оставалось в базе кода в течение многих лет. Именно благодаря профилям в pprof мы заметили, что эти методы создают и уничтожают много структур данных, что привело нас к необходимости исследовать и оптимизировать их.
Мы ускорили этап записи скомпилированного вывода, кэшируя вычисленные значения, что позволило сократить общее время компиляции на 1,3–2,8 %. К сожалению, дополнительный учет оказался слишком сложным, и автоматизированное тестирование выявило регрессию памяти. Позже мы ещё раз проанализировали этот код и реализовали новую версию, которая не только устранила регрессию памяти, но и дополнительно улучшила время компиляции на 0,5–1,8 %. В результате второго изменения нам пришлось переработать и переосмыслить принцип работы этого этапа, чтобы избавиться от одной из двух структур данных.
В нашем оптимизирующем компиляторе есть фаза, которая встраивает вызовы функций, чтобы повысить производительность. Чтобы выбрать, какие методы встраивать, мы используем эвристические методы до выполнения каких-либо вычислений и финальные проверки после выполнения работы, но непосредственно перед завершением встраивания. Если какой-либо из этих алгоритмов решит, что встраивание нецелесообразно (например, будет добавлено слишком много новых инструкций), вызов метода не будет встроен.
Мы перенесли две проверки из категории "Финальные проверки" в категорию "Эвристические проверки", чтобы оценивать, будет ли встраивание успешным, до выполнения ресурсоемких вычислений. Поскольку это оценка, она не идеальна, но мы проверили, что новые эвристические правила охватывают 99,9% встроенного кода без ущерба для производительности. Одна из новых эвристик была связана с необходимыми регистрами DEX (улучшение примерно на 0,2–1,3 %), а другая – с количеством инструкций (улучшение примерно на 2 %).
У нас есть собственная реализация BitVector, которую мы используем в нескольких местах. Мы заменили класс BitVector с изменяемым размером на более простой класс BitVectorView для некоторых битовых векторов фиксированного размера. Это позволяет избежать некоторых косвенных обращений и проверок диапазона во время выполнения и ускорить создание объектов битового вектора.
Кроме того, класс BitVectorView теперь использует шаблон для типа хранилища (вместо того чтобы всегда использовать uint32_t, как в старом BitVector). Это позволяет некоторым операциям, например Union(), обрабатывать в два раза больше битов на 64-битных платформах. При компиляции ОС Android количество образцов затронутых функций было уменьшено более чем на 1 %. Это было сделано в рамках нескольких изменений [1, 2, 3, 4, 5, 6].
Если бы мы подробно рассказали обо всех способах оптимизации, это заняло бы целый день. Если вы хотите узнать больше об оптимизации, ознакомьтесь с другими изменениями, которые мы внесли:
- Добавьте ведение учета, чтобы сократить время компиляции на 0,6–1,6%.
- Отложенное вычисление данных, чтобы избежать циклов, если это возможно.
- Провести рефакторинг кода, чтобы пропустить предварительные вычисления, если они не будут использоваться.
- Избегайте некоторых цепочек зависимых загрузок, если распределитель можно легко получить из других мест.
- Ещё один пример того, как проверка помогает избежать лишней работы.
- Избегайте частых переходов на тип регистра (основной/с плавающей запятой) в распределителе регистров.
- Убедитесь, что некоторые массивы инициализируются во время компиляции. Не полагайтесь на clang.
- Удалите лишние циклы. Используйте циклы по диапазону, которые clang может оптимизировать лучше, поскольку ему не нужно перезагружать внутренние указатели контейнера из-за побочных эффектов цикла. Не вызывайте виртуальную функцию `HInstruction::GetInputRecords()` в цикле через встроенную функцию `InputAt(.)` для каждого входа.
- Не используйте функции Accept() для шаблона посетителя, используя оптимизацию компилятора.
Заключение
Мы постоянно работаем над тем, чтобы ART компилировал код быстрее. Благодаря этому Android работает более плавно и эффективно, а также дольше держит заряд батареи и меньше нагревается. Мы тщательно выявляли и внедряли оптимизации и доказали, что можно значительно ускорить время компиляции, не ухудшая качество кода и не увеличивая использование памяти.
Мы использовали такие инструменты профилирования, как pprof, и были готовы к итерациям и даже к тому, чтобы отказаться от менее эффективных подходов. Коллективные усилия команды ART не только позволили значительно сократить время компиляции, но и заложили основу для дальнейших улучшений.
Все эти улучшения доступны в обновлении Android, выпущенном в конце 2025 года, а также в основных обновлениях для Android 12 и более новых версий. Надеемся, что это глубокое погружение в тему нашего процесса оптимизации поможет вам лучше понять, насколько сложна и интересна работа над компилятором!
-

 Новости продуктов
У разработчиков Android есть множество вариантов выбора агентов, больших языковых моделей (LLM), инструментов и интерфейсов командной строки (CLI), которые можно использовать для разработки приложений. Наша цель – помочь вам создавать красивые и качественные приложения для Android, независимо от того, как вы это делаете.
Simona Milanovic • Время на чтение: 4 минуты -
 Новости продуктов
Мы постоянно расширяем возможности платформы подписок в Google Play, чтобы помочь вам развивать бизнес, адаптироваться к новым бизнес-моделям и привлекать пользователей.
Sheenam Mittal • Время на чтение: 4 минуты -
 Новости продуктов
В прошлом году мы открыли Android Studio для любых моделей ИИ. Сегодня мы делаем следующий шаг и добавляем поддержку агентов для написания кода.
Matthew Warner • Время на чтение: 3 минуты
Получайте свежие новости о разработке приложений для Android на свою электронную почту каждую неделю.