

Android Neural Networks API (NNAPI) הוא Android C API שמיועד להפעלת פעולות חישוביות אינטנסיביות ללמידת מכונה במכשירי Android. NNAPI נועד לספק שכבת פונקציונליות בסיסית למסגרות למידת מכונה ברמה גבוהה יותר, כמו TensorFlow Lite ו-Caffe2, שיוצרות ומאמנות רשתות נוירונים. ה-API זמין בכל מכשירי Android עם Android 8.1 (רמת API 27) ומעלה, אבל הוא הוצא משימוש ב-Android 15.
NNAPI תומך בהסקת מסקנות על ידי החלת נתונים ממכשירי Android על מודלים שאומנו בעבר והוגדרו על ידי מפתחים. דוגמאות להסקת מסקנות כוללות סיווג תמונות, חיזוי התנהגות של משתמשים ובחירת תגובות מתאימות לשאילתת חיפוש.
להסקת מסקנות במכשיר יש הרבה יתרונות:
- זמן אחזור: לא צריך לשלוח בקשה דרך חיבור לרשת ולהמתין לתגובה. לדוגמה, זה יכול להיות קריטי לאפליקציות וידאו שמעבדות פריימים עוקבים שמגיעים ממצלמה.
- זמינות: האפליקציה פועלת גם כשאין כיסוי רשת.
- מהירות: חומרה חדשה שמיועדת ספציפית לעיבוד של רשתות נוירונים, ומאפשרת חישוב מהיר יותר באופן משמעותי בהשוואה למעבד (CPU) לשימוש כללי בלבד.
- פרטיות: הנתונים לא יוצאים ממכשיר Android.
- עלות: לא צריך חוות שרתים כשכל החישובים מתבצעים במכשיר Android.
יש גם כמה דברים שמפתחים צריכים לקחת בחשבון:
- ניצול המערכת: הערכת רשתות נוירונים כרוכה בחישובים רבים, שעלולים להגביר את השימוש בסוללה. אם אתם חוששים שהאפליקציה שלכם תגרום לבעיות בסוללה, כדאי לעקוב אחרי תקינות הסוללה, במיוחד אם האפליקציה מבצעת חישובים ממושכים.
- גודל האפליקציה: שימו לב לגודל של המודלים שלכם. המודלים יכולים לתפוס כמה מגה-בייטים של מקום. אם הוספת מודלים גדולים ל-APK תשפיע לרעה על המשתמשים, כדאי לשקול להוריד את המודלים אחרי התקנת האפליקציה, להשתמש במודלים קטנים יותר או להריץ את החישובים בענן. ב-NNAPI אין פונקציונליות להרצת מודלים בענן.
בדוגמה ל-Android Neural Networks API מוסבר איך להשתמש ב-NNAPI.
הסבר על זמן הריצה של Neural Networks API
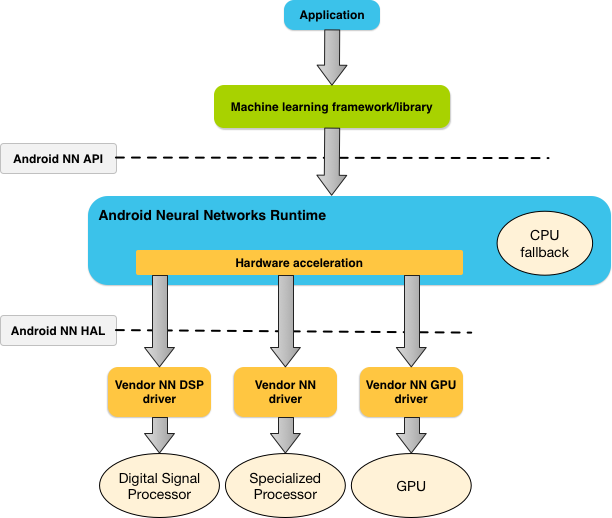
הקריאה ל-NNAPI מתבצעת על ידי ספריות, מסגרות וכלים של למידת מכונה, שמאפשרים למפתחים לאמן את המודלים שלהם מחוץ למכשיר ולפרוס אותם במכשירי Android. בדרך כלל, אפליקציות לא משתמשות ב-NNAPI באופן ישיר, אלא במסגרות למידת מכונה ברמה גבוהה יותר. המסגרות האלה יכולות להשתמש ב-NNAPI כדי לבצע פעולות הסקה (inference) עם שיפור מהירות באמצעות חומרה במכשירים נתמכים.
בהתאם לדרישות של האפליקציה וליכולות החומרה של מכשיר Android, זמן הריצה של הרשת הנוירונית של Android יכול לפזר ביעילות את עומס העבודה של החישוב בין המעבדים הזמינים במכשיר, כולל חומרה ייעודית של רשת נוירונית, יחידות עיבוד גרפיות (GPU) ומעבדי אותות ספרתיים (DSP).
במכשירי Android שאין בהם דרייבר ייעודי של ספק, סביבת זמן הריצה של NNAPI מריצה את הבקשות ב-CPU.
איור 1 מציג את ארכיטקטורת המערכת ברמה גבוהה של NNAPI.
מודל התכנות של Neural Networks API
כדי לבצע חישובים באמצעות NNAPI, קודם צריך לבנות גרף מכוון שמגדיר את החישובים שרוצים לבצע. תרשים החישוב הזה, בשילוב עם נתוני הקלט (לדוגמה, המשקלים וההטיות שמועברים ממסגרת למידת מכונה), יוצר את המודל להערכת זמן הריצה של NNAPI.
ב-NNAPI נעשה שימוש בארבע הפשטות עיקריות:
- מודל: תרשים חישוב של פעולות מתמטיות והערכים הקבועים שנלמדו בתהליך אימון. הפעולות האלה ספציפיות לרשתות נוירונים. הן כוללות קונבולוציה דו-ממדית (2D), הפעלה לוגיסטית (סיגמואיד), הפעלה לינארית מתוקנת (ReLU) ועוד. יצירת מודל היא פעולה סינכרונית.
אחרי שיוצרים את ה-Persona, אפשר להשתמש בה שוב בשרשורים ובאוספים שונים.
ב-NNAPI, מודל מיוצג כמופע של
ANeuralNetworksModel. - Compilation: מייצג הגדרה לקומפילציה של מודל NNAPI לקוד ברמה נמוכה יותר. יצירת אוסף היא פעולה סינכרונית. אחרי שיוצרים אותו, אפשר להשתמש בו שוב בשרשורים ובהפעלות שונות. ב-NNAPI, כל הידור מיוצג כמופע של
ANeuralNetworksCompilation. - זיכרון: מייצג זיכרון משותף, קבצים שממופים לזיכרון ומאגרי זיכרון דומים. שימוש במאגר נתונים זמני בזיכרון מאפשר לזמן הריצה של NNAPI להעביר נתונים למנהלי התקנים בצורה יעילה יותר. בדרך כלל, אפליקציה יוצרת מאגר זיכרון משותף אחד שמכיל את כל הטנזורים שנדרשים כדי להגדיר מודל. אפשר גם להשתמש במאגרי זיכרון כדי לאחסן את הקלט והפלט של מופע ביצוע. ב-NNAPI, כל מאגר נתונים בזיכרון מיוצג כמופע של
ANeuralNetworksMemory. ביצוע: ממשק להחלת מודל NNAPI על קבוצת קלט ולאיסוף התוצאות. אפשר להפעיל את הפונקציה באופן סינכרוני או אסינכרוני.
בהרצה אסינכרונית, כמה שרשורים יכולים להמתין לאותה הרצה. כשההרצה הזו מסתיימת, כל ה-threads משוחררים.
ב-NNAPI, כל הפעלה מיוצגת כמופע של
ANeuralNetworksExecution.
איור 2 מציג את תהליך התכנות הבסיסי.
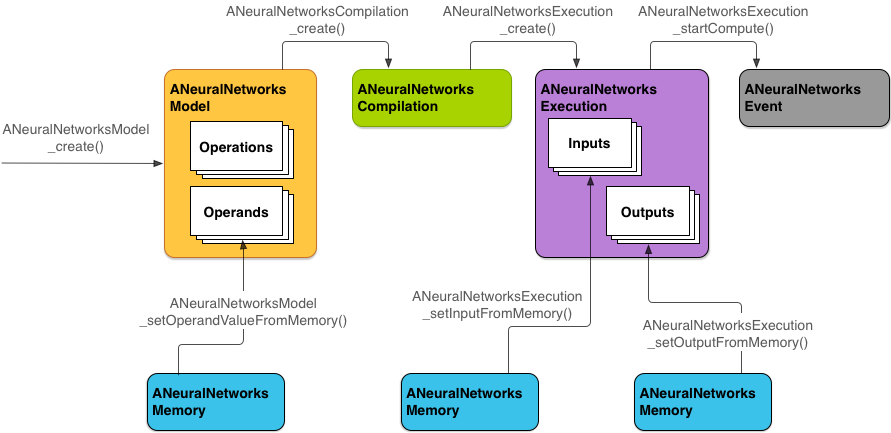
בהמשך הקטע הזה מתוארים השלבים להגדרת מודל NNAPI לביצוע חישוב, להרצת קומפילציה של המודל ולהפעלת המודל שעבר קומפילציה.
מתן גישה לנתוני אימון
סביר להניח שנתוני המשקלים וההטיות שאומנו מאוחסנים בקובץ. כדי לספק לזמן הריצה של NNAPI גישה יעילה לנתונים האלה, יוצרים מופע של ANeuralNetworksMemory על ידי קריאה לפונקציה ANeuralNetworksMemory_createFromFd() והעברת תיאור הקובץ של קובץ הנתונים שנפתח. אתם גם מציינים דגלים להגנה על הזיכרון והיסט שבו מתחיל אזור הזיכרון המשותף בקובץ.
// Create a memory buffer from the file that contains the trained data
ANeuralNetworksMemory* mem1 = NULL;
int fd = open("training_data", O_RDONLY);
ANeuralNetworksMemory_createFromFd(file_size, PROT_READ, fd, 0, &mem1);
למרות שבדוגמה הזו אנחנו משתמשים רק במכונה אחת של ANeuralNetworksMemory לכל המשקלים, אפשר להשתמש ביותר ממכונה אחת של ANeuralNetworksMemory לכמה קבצים.
שימוש במאגרי חומרה מקוריים
אפשר להשתמש במאגרי חומרה מקומיים לקלט, לפלט ולערכי אופרנד קבועים של המודל. במקרים מסוימים, מאיץ NNAPI יכול לגשת לאובייקטים של AHardwareBuffer בלי שהדרייבר יצטרך להעתיק את הנתונים. ל-AHardwareBuffer יש הרבה הגדרות אישיות שונות, ויכול להיות שלא כל מאיץ NNAPI יתמוך בכל ההגדרות האישיות האלה. בגלל המגבלה הזו, כדאי לעיין במגבלות שמפורטות במאמרי העזרה של ANeuralNetworksMemory_createFromAHardwareBuffer ולבדוק מראש במכשירי היעד כדי לוודא שההידורים וההפעלות שמשתמשים ב-AHardwareBuffer פועלים כצפוי, באמצעות הקצאת מכשיר כדי לציין את המאיץ.
כדי לאפשר לזמן הריצה של NNAPI לגשת לאובייקט AHardwareBuffer, צריך ליצור מכונה של ANeuralNetworksMemory על ידי קריאה לפונקציה ANeuralNetworksMemory_createFromAHardwareBuffer והעברת האובייקט AHardwareBuffer, כמו שמוצג בדוגמת הקוד הבאה:
// Configure and create AHardwareBuffer object
AHardwareBuffer_Desc desc = ...
AHardwareBuffer* ahwb = nullptr;
AHardwareBuffer_allocate(&desc, &ahwb);

// Create ANeuralNetworksMemory from AHardwareBuffer
ANeuralNetworksMemory* mem2 = NULL;
ANeuralNetworksMemory_createFromAHardwareBuffer(ahwb, &mem2);
כשה-NNAPI כבר לא צריך לגשת לאובייקט AHardwareBuffer, משחררים את המכונה התואמת של ANeuralNetworksMemory:
ANeuralNetworksMemory_free(mem2);
הערה:
- אפשר להשתמש ב-
AHardwareBufferרק לכל המאגר, ואי אפשר להשתמש בו עם פרמטרARect. - זמן הריצה של NNAPI לא ירוקן את המאגר. לפני שמתזמנים את ההפעלה, צריך לוודא שאפשר לגשת למאגרי הקלט והפלט.
- אין תמיכה בתיאורי קבצים של גדרות סנכרון.
- ב-
AHardwareBufferעם פורמטים ספציפיים לספק וביטים של שימוש, ההטמעה של הספק קובעת אם הלקוח או מנהל ההתקן אחראים לניקוי המטמון.
דגם
מודל הוא יחידת החישוב הבסיסית ב-NNAPI. כל מודל מוגדר על ידי אופרנד אחד או יותר ופעולות.
אופרנדים
אופרנדים הם אובייקטים של נתונים שמשמשים להגדרת התרשים. הם כוללים את הקלט והפלט של המודל, את צומתי הביניים שמכילים את הנתונים שעוברים מפעולה אחת לאחרת, ואת הקבועים שמועברים לפעולות האלה.
יש שני סוגים של אופרנדים שאפשר להוסיף למודלים של NNAPI: סקלרים וטנזורים.
סקלר מייצג ערך יחיד. NNAPI תומך בערכים סקלריים בפורמטים הבאים: בוליאני, נקודה צפה (floating point) של 16 ביט, נקודה צפה של 32 ביט, מספר שלם של 32 ביט ומספר שלם ללא סימן של 32 ביט.
רוב הפעולות ב-NNAPI כוללות טנזורים. טנזורים הם מערכים n-ממדיים. NNAPI תומך בטנזורים עם ערכים של נקודה צפה (floating point) של 16 ביט, נקודה צפה של 32 ביט, קוונטיזציה של 8 ביט, קוונטיזציה של 16 ביט, מספר שלם של 32 ביט וערכים בוליאניים של 8 ביט.
לדוגמה, איור 3 מייצג מודל עם שתי פעולות: חיבור ואחריו כפל. המודל מקבל טנזור קלט אחד ומפיק טנזור פלט אחד.
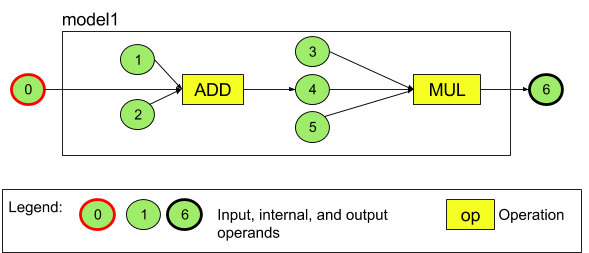
במודל שלמעלה יש שבעה אופרנדים. האופרנדים האלה מזוהים באופן משתמע לפי האינדקס של הסדר שבו הם נוספו למודל. האינדקס של האופרנד הראשון שנוסף הוא 0, האינדקס של האופרנד השני הוא 1 וכן הלאה. האופרנדים 1, 2, 3 ו-5 הם אופרנדים קבועים.
הסדר שבו מוסיפים את האופרנדים לא משנה. לדוגמה, האופרנד של הפלט מהמודל יכול להיות הראשון שנוסף. החלק החשוב הוא להשתמש בערך האינדקס הנכון כשמתייחסים לאופרנד.
לאופרנדים יש סוגים. הם מוגדרים כשהם מתווספים למודל.
אי אפשר להשתמש באופרנד גם כקלט וגם כפלט של מודל.
כל אופרנד חייב להיות קלט של מודל, קבוע או אופרנד פלט של פעולה אחת בדיוק.
תפעול
פעולה מציינת את החישובים שצריך לבצע. כל פעולה מורכבת מהרכיבים הבאים:
- סוג הפעולה (לדוגמה, חיבור, כפל, קונבולוציה),
- רשימה של אינדקסים של האופרנדים שהפעולה משתמשת בהם לקלט, וגם
- רשימה של אינדקסים של האופרנדים שהפעולה משתמשת בהם לפלט.
הסדר ברשימות האלה חשוב. במאמרי העזרה של ה-API של NNAPI מפורטים הקלטים והפלטים הצפויים של כל סוג פעולה.
לפני שמוסיפים את הפעולה, צריך להוסיף למודל את האופרנדים שהפעולה צורכת או מייצרת.
הסדר שבו מוסיפים את הפעולות לא משנה. כדי לקבוע את סדר הפעולות, NNAPI מסתמך על יחסי התלות שנוצרו על ידי תרשים החישוב של האופרנדים והפעולות.
הפעולות שנתמכות ב-NNAPI מסוכמות בטבלה הבאה:
בעיה מוכרת ברמת API 28: כשמעבירים טנזורים של ANEURALNETWORKS_TENSOR_QUANT8_ASYMM לפעולה ANEURALNETWORKS_PAD, שזמינה ב-Android 9 (רמת API 28) ומעלה, יכול להיות שהפלט מ-NNAPI לא יתאים לפלט ממסגרות למידת מכונה ברמה גבוהה יותר, כמו TensorFlow Lite. במקום זאת, צריך להעביר רק את ANEURALNETWORKS_TENSOR_FLOAT32.
הבעיה נפתרה ב-Android 10 (רמת API 29) ומעלה.
בניית מודלים
בדוגמה הבאה, אנחנו יוצרים את המודל עם שתי הפעולות שמופיע באיור 3.
כדי ליצור את המודל:
מפעילים את הפונקציה
ANeuralNetworksModel_create()כדי להגדיר מודל ריק.ANeuralNetworksModel* model = NULL; ANeuralNetworksModel_create(&model);
מוסיפים את האופרנדים למודל באמצעות קריאה ל-
ANeuralNetworks_addOperand(). סוגי הנתונים שלהם מוגדרים באמצעות מבנה הנתוניםANeuralNetworksOperandType.// In our example, all our tensors are matrices of dimension [3][4] ANeuralNetworksOperandType tensor3x4Type; tensor3x4Type.type = ANEURALNETWORKS_TENSOR_FLOAT32; tensor3x4Type.scale = 0.f; // These fields are used for quantized tensors tensor3x4Type.zeroPoint = 0; // These fields are used for quantized tensors tensor3x4Type.dimensionCount = 2; uint32_t dims[2] = {3, 4}; tensor3x4Type.dimensions = dims;
// We also specify operands that are activation function specifiers ANeuralNetworksOperandType activationType; activationType.type = ANEURALNETWORKS_INT32; activationType.scale = 0.f; activationType.zeroPoint = 0; activationType.dimensionCount = 0; activationType.dimensions = NULL;
// Now we add the seven operands, in the same order defined in the diagram ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 0 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 1 ANeuralNetworksModel_addOperand(model, &activationType); // operand 2 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 3 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 4 ANeuralNetworksModel_addOperand(model, &activationType); // operand 5 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 6לאופרנדים עם ערכים קבועים, כמו משקלים והטיות שהאפליקציה מקבלת מתהליך אימון, משתמשים בפונקציות
ANeuralNetworksModel_setOperandValue()ו-ANeuralNetworksModel_setOperandValueFromMemory().בדוגמה הבאה, אנחנו מגדירים ערכים קבועים מקובץ נתוני האימון שתואמים למאגר הנתונים הזמני בזיכרון שיצרנו בקטע מתן גישה לנתוני האימון.
// In our example, operands 1 and 3 are constant tensors whose values were
// established during the training process
const int sizeOfTensor = 3 * 4 * 4;    // The formula for size calculation is dim0 * dim1 * elementSize
ANeuralNetworksModel_setOperandValueFromMemory(model, 1, mem1, 0, sizeOfTensor);
ANeuralNetworksModel_setOperandValueFromMemory(model, 3, mem1, sizeOfTensor, sizeOfTensor);


// We set the values of the activation operands, in our example operands 2 and 5
int32_t noneValue = ANEURALNETWORKS_FUSED_NONE;
ANeuralNetworksModel_setOperandValue(model, 2, &noneValue, sizeof(noneValue));
ANeuralNetworksModel_setOperandValue(model, 5, &noneValue, sizeof(noneValue));
כדי לחשב כל פעולה בגרף המכוון, מוסיפים את הפעולה למודל באמצעות קריאה לפונקציה
ANeuralNetworksModel_addOperation().האפליקציה צריכה לספק את הפרמטרים הבאים לקריאה הזו:
- סוג הפעולה
- מספר ערכי הקלט
- מערך האינדקסים של האופרנדים של הקלט
- מספר ערכי הפלט
- מערך האינדקסים של האופרנדים של הפלט
שימו לב שאי אפשר להשתמש באופרנד גם לקלט וגם לפלט של אותה פעולה.
// We have two operations in our example
// The first consumes operands 1, 0, 2, and produces operand 4
uint32_t addInputIndexes[3] = {1, 0, 2};
uint32_t addOutputIndexes[1] = {4};
ANeuralNetworksModel_addOperation(model, ANEURALNETWORKS_ADD, 3, addInputIndexes, 1, addOutputIndexes);


// The second consumes operands 3, 4, 5, and produces operand 6
uint32_t multInputIndexes[3] = {3, 4, 5};
uint32_t multOutputIndexes[1] = {6};
ANeuralNetworksModel_addOperation(model, ANEURALNETWORKS_MUL, 3, multInputIndexes, 1, multOutputIndexes);
מזהים אילו אופרנדים המודל צריך להתייחס אליהם כאל קלט ופלט, על ידי קריאה לפונקציה
ANeuralNetworksModel_identifyInputsAndOutputs().// Our model has one input (0) and one output (6) uint32_t modelInputIndexes[1] = {0}; uint32_t modelOutputIndexes[1] = {6}; ANeuralNetworksModel_identifyInputsAndOutputs(model, 1, modelInputIndexes, 1 modelOutputIndexes);
אפשר גם לציין אם מותר לחשב את
ANEURALNETWORKS_TENSOR_FLOAT32עם טווח או דיוק נמוכים כמו אלה של פורמט הנקודה הצפה של IEEE 754 16-bit, על ידי קריאה ל-ANeuralNetworksModel_relaxComputationFloat32toFloat16().קוראים ל-
ANeuralNetworksModel_finish()כדי לסיים את הגדרת המודל. אם אין שגיאות, הפונקציה מחזירה את קוד התוצאהANEURALNETWORKS_NO_ERROR.ANeuralNetworksModel_finish(model);
אחרי שיוצרים מודל, אפשר לקמפל אותו כמה פעמים שרוצים ולהריץ כל קומפילציה כמה פעמים שרוצים.
בקרת זרימה
כדי לשלב זרימת בקרה במודל NNAPI, מבצעים את הפעולות הבאות:
יוצרים את תרשימי המשנה המתאימים להרצה (תרשימי משנה של
thenו-elseלהצהרתIF, תרשימי משנה שלconditionו-bodyללולאתWHILE) כמודלים עצמאיים שלANeuralNetworksModel*:ANeuralNetworksModel* thenModel = makeThenModel(); ANeuralNetworksModel* elseModel = makeElseModel();
יוצרים אופרנדים שמפנים למודלים האלה בתוך המודל שמכיל את זרימת הבקרה:
ANeuralNetworksOperandType modelType = {
    .type = ANEURALNETWORKS_MODEL,
};
ANeuralNetworksModel_addOperand(model, &modelType);  // kThenOperandIndex
ANeuralNetworksModel_addOperand(model, &modelType);  // kElseOperandIndex
ANeuralNetworksModel_setOperandValueFromModel(model, kThenOperandIndex, &thenModel);
ANeuralNetworksModel_setOperandValueFromModel(model, kElseOperandIndex, &elseModel);
מוסיפים את פעולת בקרת הזרימה:
uint32_t inputs[] = {kConditionOperandIndex,
                     kThenOperandIndex,
                     kElseOperandIndex,
                     kInput1, kInput2, kInput3};
uint32_t outputs[] = {kOutput1, kOutput2};
ANeuralNetworksModel_addOperation(model, ANEURALNETWORKS_IF,
                                  std::size(inputs), inputs,
                                  std::size(output), outputs);
קומפילציה
בשלב הקומפילציה נקבע באילו מעבדים המודל יופעל, והדרייברים המתאימים מתבקשים להתכונן להפעלה שלו. זה יכול לכלול יצירה של שפת מכונה ספציפית למעבדים שהמודל יפעל עליהם.
כדי להדר מודל:
מפעילים את הפונקציה
ANeuralNetworksCompilation_create()כדי ליצור מופע קומפילציה חדש.// Compile the model ANeuralNetworksCompilation* compilation; ANeuralNetworksCompilation_create(model, &compilation);
אפשר גם להשתמש בהקצאת מכשירים כדי לבחור באופן מפורש באילו מכשירים להריץ את הבדיקות.
אתם יכולים להשפיע על האופן שבו זמן הריצה מאזן בין השימוש בסוללה לבין מהירות הביצוע. כדי לעשות את זה, מפעילים את השיטה
ANeuralNetworksCompilation_setPreference().// Ask to optimize for low power consumption ANeuralNetworksCompilation_setPreference(compilation, ANEURALNETWORKS_PREFER_LOW_POWER);
ההעדפות שאתם יכולים לציין כוללות:
ANEURALNETWORKS_PREFER_LOW_POWER: עדיף לבצע את הפעולה באופן שמצמצם את התרוקנות הסוללה. זה רצוי לקומפילציות שמופעלות לעיתים קרובות.-
ANEURALNETWORKS_PREFER_FAST_SINGLE_ANSWER: עדיף להחזיר תשובה אחת כמה שיותר מהר, גם אם זה גורם לצריכת חשמל גבוהה יותר. זוהי אפשרות ברירת המחדל. ANEURALNETWORKS_PREFER_SUSTAINED_SPEED: העדפה של מקסימום תפוקה של פריימים עוקבים, למשל כשמעבדים פריימים עוקבים שמגיעים מהמצלמה.
אפשר גם להגדיר שמירת קומפילציה במטמון באמצעות קריאה ל-
ANeuralNetworksCompilation_setCaching.// Set up compilation caching ANeuralNetworksCompilation_setCaching(compilation, cacheDir, token);
משתמשים ב-
getCodeCacheDir()בשבילcacheDir. הערך שלtokenחייב להיות ייחודי לכל דגם באפליקציה.מסיימים את הגדרת האוסף באמצעות קריאה ל-
ANeuralNetworksCompilation_finish(). אם אין שגיאות, הפונקציה מחזירה את קוד התוצאהANEURALNETWORKS_NO_ERROR.ANeuralNetworksCompilation_finish(compilation);
גילוי והקצאה של מכשירים
במכשירי Android עם Android 10 (רמת API 29) ומעלה, NNAPI מספק פונקציות שמאפשרות לאפליקציות ולספריות של מסגרות למידת מכונה לקבל מידע על המכשירים הזמינים ולציין מכשירים לשימוש בהפעלה. כשהאפליקציות מקבלות מידע על המכשירים הזמינים, הן יכולות לקבל את הגרסה המדויקת של מנהלי ההתקנים שנמצאים במכשיר כדי למנוע בעיות תאימות ידועות. כך, האפליקציות יכולות לציין אילו מכשירים יבצעו חלקים שונים של מודל, ולבצע אופטימיזציה למכשיר Android שבו הן פרוסות.
גילוי מכשירים
משתמשים ב-ANeuralNetworks_getDeviceCount כדי לקבל את מספר המכשירים הזמינים. בכל מכשיר, משתמשים ב-ANeuralNetworks_getDevice כדי להגדיר מופע של ANeuralNetworksDevice כהפניה למכשיר הזה.
אחרי שקיבלתם הפניה למכשיר, אתם יכולים לקבל מידע נוסף על המכשיר באמצעות הפונקציות הבאות:
ANeuralNetworksDevice_getFeatureLevelANeuralNetworksDevice_getNameANeuralNetworksDevice_getTypeANeuralNetworksDevice_getVersion
הקצאת מכשירים
אפשר להשתמש ב-ANeuralNetworksModel_getSupportedOperationsForDevices כדי לגלות אילו פעולות של מודל אפשר להריץ במכשירים ספציפיים.
כדי לקבוע באילו מאיצים להשתמש להרצה, צריך להפעיל את ANeuralNetworksCompilation_createForDevices במקום את ANeuralNetworksCompilation_create.
משתמשים באובייקט ANeuralNetworksCompilation שנוצר, כרגיל.
הפונקציה מחזירה שגיאה אם המודל שצוין מכיל פעולות שלא נתמכות במכשירים שנבחרו.
אם מצוינים כמה מכשירים, סביבת זמן הריצה אחראית להפצת העבודה בין המכשירים.
בדומה למכשירים אחרים, הטמעת המעבד (CPU) של NNAPI מיוצגת על ידי ANeuralNetworksDevice עם השם nnapi-reference והסוג ANEURALNETWORKS_DEVICE_TYPE_CPU. כשמפעילים את ANeuralNetworksCompilation_createForDevices, ההטמעה של המעבד לא משמשת לטיפול במקרי הכשל של הידור המודל וההרצה שלו.
האפליקציה אחראית לחלק את המודל למודלי משנה שיכולים לפעול במכשירים שצוינו. באפליקציות שלא צריך לבצע בהן חלוקה למחיצות באופן ידני, צריך להמשיך להפעיל את השיטה הפשוטה יותר ANeuralNetworksCompilation_create כדי להשתמש בכל המכשירים הזמינים (כולל המעבד) להאצת המודל. אם המכשירים שציינתם באמצעות ANeuralNetworksCompilation_createForDevices לא תומכים במודל באופן מלא, תוחזר השגיאה ANEURALNETWORKS_BAD_DATA.
חלוקת המודל למחיצות
כשיש כמה מכשירים זמינים למודל, זמן הריצה של NNAPI מחלק את העבודה בין המכשירים. לדוגמה, אם ANeuralNetworksCompilation_createForDevices קיבל יותר ממכשיר אחד, כל המכשירים שצוינו יילקחו בחשבון בהקצאת העבודה. שימו לב שאם מכשיר ה-CPU לא נמצא ברשימה, ההפעלה של ה-CPU תושבת. כשמשתמשים ב-ANeuralNetworksCompilation_create, כל המכשירים הזמינים יילקחו בחשבון, כולל המעבד (CPU).
ההפצה מתבצעת על ידי בחירה מתוך רשימת המכשירים הזמינים, עבור כל אחת מהפעולות במודל, המכשיר התומך בפעולה ומצהיר על הביצועים הטובים ביותר, כלומר זמן הביצוע המהיר ביותר או צריכת החשמל הנמוכה ביותר, בהתאם להעדפת הביצוע שצוינה על ידי הלקוח. אלגוריתם החלוקה למחיצות לא מביא בחשבון חוסר יעילות אפשרי שנגרם על ידי הקלט/פלט בין המעבדים השונים. לכן, כשמציינים כמה מעבדים (באופן מפורש כשמשתמשים ב-ANeuralNetworksCompilation_createForDevices או באופן משתמע כשמשתמשים ב-ANeuralNetworksCompilation_create), חשוב ליצור פרופיל של האפליקציה שנוצרה.
כדי להבין איך המודל חולק על ידי NNAPI, חפשו ביומני Android הודעה (ברמת INFO עם התג ExecutionPlan):
ModelBuilder::findBestDeviceForEachOperation(op-name): device-index
op-name הוא השם התיאורי של הפעולה בתרשים, ו-device-index הוא האינדקס של המכשיר המועמד ברשימת המכשירים.
הרשימה הזו היא הקלט שסופק ל-ANeuralNetworksCompilation_createForDevices, או אם משתמשים ב-ANeuralNetworksCompilation_createForDevices, הרשימה של המכשירים שמוחזרת כשעוברים על כל המכשירים באמצעות ANeuralNetworks_getDeviceCount ו-ANeuralNetworks_getDevice.
ההודעה (ברמת INFO עם התג ExecutionPlan):
ModelBuilder::partitionTheWork: only one best device: device-name
ההודעה הזו מציינת שהתרשים כולו הואץ במכשיר device-name.
ביצוע
בשלב ההפעלה, המודל מוחל על קבוצת קלטים, ופלט החישוב נשמר במאגר נתונים זמני אחד או יותר של המשתמש או במרחבי זיכרון שהאפליקציה הקצתה.
כדי להריץ מודל מקומפל, מבצעים את השלבים הבאים:
מפעילים את הפונקציה
ANeuralNetworksExecution_create()כדי ליצור מכונה חדשה להפעלה.// Run the compiled model against a set of inputs ANeuralNetworksExecution* run1 = NULL; ANeuralNetworksExecution_create(compilation, &run1);
ציינו איפה האפליקציה קוראת את ערכי הקלט לחישוב. האפליקציה יכולה לקרוא ערכי קלט ממאגר נתונים זמני של משתמש או ממרחב זיכרון שהוקצה, על ידי קריאה ל-
ANeuralNetworksExecution_setInput()או ל-ANeuralNetworksExecution_setInputFromMemory(), בהתאמה.// Set the single input to our sample model. Since it is small, we won't use a memory buffer float32 myInput[3][4] = { ...the data... }; ANeuralNetworksExecution_setInput(run1, 0, NULL, myInput, sizeof(myInput));
מציינים איפה האפליקציה כותבת את ערכי הפלט. האפליקציה יכולה לכתוב ערכי פלט למאגר נתונים זמני של המשתמש או למרחב זיכרון שהוקצה, על ידי קריאה ל-
ANeuralNetworksExecution_setOutput()או ל-ANeuralNetworksExecution_setOutputFromMemory()בהתאמה.// Set the output float32 myOutput[3][4]; ANeuralNetworksExecution_setOutput(run1, 0, NULL, myOutput, sizeof(myOutput));
מתזמנים את תחילת ההפעלה באמצעות קריאה לפונקציה
ANeuralNetworksExecution_startCompute(). אם אין שגיאות, הפונקציה מחזירה את קוד התוצאהANEURALNETWORKS_NO_ERROR.// Starts the work. The work proceeds asynchronously ANeuralNetworksEvent* run1_end = NULL; ANeuralNetworksExecution_startCompute(run1, &run1_end);
קוראים לפונקציה
ANeuralNetworksEvent_wait()כדי להמתין עד שההרצה תסתיים. אם הביצוע הצליח, הפונקציה מחזירה את קוד התוצאהANEURALNETWORKS_NO_ERROR. ההמתנה יכולה להתבצע בשרשור שונה מזה שמתחיל את ההרצה.// For our example, we have no other work to do and will just wait for the completion ANeuralNetworksEvent_wait(run1_end); ANeuralNetworksEvent_free(run1_end); ANeuralNetworksExecution_free(run1);
אם רוצים, אפשר להחיל קבוצה אחרת של קלט על המודל המקומפל באמצעות אותו מופע קומפילציה כדי ליצור מופע חדש של
ANeuralNetworksExecution.// Apply the compiled model to a different set of inputs ANeuralNetworksExecution* run2; ANeuralNetworksExecution_create(compilation, &run2); ANeuralNetworksExecution_setInput(run2, ...); ANeuralNetworksExecution_setOutput(run2, ...); ANeuralNetworksEvent* run2_end = NULL; ANeuralNetworksExecution_startCompute(run2, &run2_end); ANeuralNetworksEvent_wait(run2_end); ANeuralNetworksEvent_free(run2_end); ANeuralNetworksExecution_free(run2);
הרצה סינכרונית
ביצוע אסינכרוני דורש זמן כדי ליצור ולסנכרן שרשורים. בנוסף, זמן האחזור יכול להשתנות מאוד, והעיכובים הארוכים ביותר מגיעים עד 500 מיקרו-שניות בין הזמן שבו השרשור מקבל התראה או מתעורר לבין הזמן שבו הוא נקשר בסופו של דבר לליבת מעבד.
כדי לשפר את זמן האחזור, אפשר להורות לאפליקציה לבצע קריאת הסקה סינכרונית לסביבת זמן הריצה. הקריאה הזו תחזיר תשובה רק אחרי שההסקה תושלם, ולא אחרי שהיא תתחיל. במקום להפעיל את ANeuralNetworksExecution_startCompute כדי לבצע קריאה אסינכרונית להסקה בזמן הריצה, האפליקציה מפעילה את ANeuralNetworksExecution_compute כדי לבצע קריאה סינכרונית בזמן הריצה. קריאה לפונקציה
ANeuralNetworksExecution_compute לא מקבלת ANeuralNetworksEvent ואינה
מותאמת לקריאה לפונקציה ANeuralNetworksEvent_wait.
הרצות בזק
במכשירי Android עם Android 10 (רמת API 29) ומעלה, ה-NNAPI תומך בהפעלות פרץ באמצעות האובייקט ANeuralNetworksBurst. הפעלות ברצף הן רצף של הפעלות של אותו קומפילציה שמתרחשות ברצף מהיר, כמו אלה שפועלות על פריימים של צילום מצלמה או דגימות אודיו עוקבות. שימוש באובייקטים מסוג ANeuralNetworksBurst עשוי להוביל להפעלה מהירה יותר, כי הם מציינים למאיצים שאפשר לעשות שימוש חוזר במשאבים בין הפעלות, ושהמאיצים צריכים להישאר במצב של ביצועים גבוהים למשך פרץ הפעילות.
ANeuralNetworksBurst מציג רק שינוי קטן בנתיב הביצוע הרגיל. כדי ליצור אובייקט של פרץ נתונים, משתמשים ב-ANeuralNetworksBurst_create, כמו בקטע הקוד הבא:
// Create burst object to be reused across a sequence of executions
ANeuralNetworksBurst* burst = NULL;
ANeuralNetworksBurst_create(compilation, &burst);
ההרצות המרוכזות הן סינכרוניות. אבל במקום להשתמש ב-ANeuralNetworksExecution_compute כדי לבצע כל הסקה, אתם משייכים את האובייקטים השונים של ANeuralNetworksExecution לאותו ANeuralNetworksBurst בקריאות לפונקציה ANeuralNetworksExecution_burstCompute.
// Create and configure first execution object
// ...

// Execute using the burst object
ANeuralNetworksExecution_burstCompute(execution1, burst);

// Use results of first execution and free the execution object
// ...

// Create and configure second execution object
// ...

// Execute using the same burst object
ANeuralNetworksExecution_burstCompute(execution2, burst);

// Use results of second execution and free the execution object
// ...
משחררים את האובייקט ANeuralNetworksBurst באמצעות
ANeuralNetworksBurst_free
כשלא צריך אותו יותר.
// Cleanup
ANeuralNetworksBurst_free(burst);
תורי פקודות אסינכרוניים והרצה מגודרת
ב-Android מגרסה 11 ואילך, NNAPI תומך בדרך נוספת לתזמן הפעלה אסינכרונית באמצעות ה-method ANeuralNetworksExecution_startComputeWithDependencies(). כשמשתמשים בשיטה הזו, ההפעלה ממתינה עד שכל האירועים התלויים יאותתו לפני שהיא מתחילה את ההערכה. אחרי שההרצה מסתיימת והפלט מוכן לשימוש, האירוע שמוחזר מסומן.
בהתאם למכשירים שמטפלים בהפעלה, יכול להיות שהאירוע יגובה על ידי גדר סנכרון. צריך להפעיל את ANeuralNetworksEvent_wait() כדי להמתין לאירוע ולשחזר את המשאבים שבהם השתמשה ההפעלה. אפשר לייבא גדרות סנכרון לאובייקט אירוע באמצעות ANeuralNetworksEvent_createFromSyncFenceFd(), ולייצא גדרות סנכרון מאובייקט אירוע באמצעות ANeuralNetworksEvent_getSyncFenceFd().
פלטים בגודל דינמי
כדי לתמוך במודלים שבהם גודל הפלט תלוי בנתוני הקלט, כלומר אי אפשר לקבוע את הגודל בזמן הרצת המודל, צריך להשתמש ב-ANeuralNetworksExecution_getOutputOperandRank וב-ANeuralNetworksExecution_getOutputOperandDimensions.
בדוגמת הקוד הבאה אפשר לראות איך עושים את זה:
// Get the rank of the output
uint32_t myOutputRank = 0;
ANeuralNetworksExecution_getOutputOperandRank(run1, 0, &myOutputRank);

// Get the dimensions of the output
std::vector<uint32_t> myOutputDimensions(myOutputRank);
ANeuralNetworksExecution_getOutputOperandDimensions(run1, 0, myOutputDimensions.data());
הסרת המשאבים
שלב הניקוי מטפל בשחרור המשאבים הפנימיים ששימשו לחישוב.
// Cleanup
ANeuralNetworksCompilation_free(compilation);
ANeuralNetworksModel_free(model);
ANeuralNetworksMemory_free(mem1);
ניהול שגיאות ושימוש במעבד (CPU) כגיבוי
אם יש שגיאה במהלך החלוקה למחיצות, אם מנהל התקן נכשל בהידור של (חלק מ)מודל, או אם מנהל התקן נכשל בהפעלה של (חלק מ)מודל מהודר, NNAPI עשוי לחזור להטמעת המעבד (CPU) שלו של פעולה אחת או יותר.
אם לקוח NNAPI מכיל גרסאות אופטימליות של הפעולה (לדוגמה, TFLite), יכול להיות שכדאי להשבית את החלופה של המעבד (CPU) ולטפל בכשלים באמצעות הטמעת הפעולה האופטימלית של הלקוח.
ב-Android 10, אם ההידור מתבצע באמצעות ANeuralNetworksCompilation_createForDevices, החלופה של המעבד מושבתת.
ב-Android P, אם ההפעלה של NNAPI במנהל ההתקן נכשלת, היא עוברת ל-CPU.
זה נכון גם ב-Android 10 כשמשתמשים ב-ANeuralNetworksCompilation_create במקום ב-ANeuralNetworksCompilation_createForDevices.
ההרצה הראשונה חוזרת למצב הקודם עבור המחיצה היחידה הזו, ואם זה עדיין נכשל, היא מנסה שוב את כל המודל ב-CPU.
אם החלוקה למחיצות או ההידור נכשלים, המערכת תנסה להריץ את המודל כולו ב-CPU.
במקרים מסוימים, פעולות מסוימות לא נתמכות ב-CPU, ובמצבים כאלה ההידור או ההפעלה ייכשלו במקום לחזור למצב הקודם.
גם אחרי שמשביתים את האפשרות לעבור למעבד (CPU), יכול להיות שעדיין יהיו פעולות במודל שיתבצעו במעבד (CPU). אם המעבד (CPU) נמצא ברשימת המעבדים שסופקו ל-ANeuralNetworksCompilation_createForDevices, והוא המעבד היחיד שתומך בפעולות האלה או המעבד שמספק את הביצועים הטובים ביותר לפעולות האלה, הוא ייבחר כמעבד הראשי (לא כגיבוי).
כדי לוודא שאין הפעלה של המעבד (CPU), צריך להשתמש ב-ANeuralNetworksCompilation_createForDevices ולהחריג את nnapi-reference מרשימת המכשירים.
החל מ-Android P, אפשר להשבית את החלופה בזמן ההפעלה בגרסאות build לניפוי באגים, על ידי הגדרת המאפיין debug.nn.partition ל-2.
דומיינים של זיכרון
ב-Android מגרסה 11 ואילך, NNAPI תומך בדומיינים של זיכרון שמספקים ממשקי הקצאה לזיכרונות אטומים. כך אפליקציות יכולות להעביר זיכרונות מקוריים של המכשיר בין הפעלות, כדי ש-NNAPI לא יעתיק או ישנה נתונים שלא לצורך בזמן ביצוע הפעלות עוקבות באותו מנהל התקן.
התכונה "תחום זיכרון" מיועדת לטנזורים שהם בעיקר פנימיים למנהל ההתקן, ושלא צריכים גישה תכופה לצד הלקוח. דוגמאות לטנזורים כאלה כוללות את טנזורי המצב במודלים של רצפים. לטנזורים שצריכים גישה תכופה למעבד (CPU) בצד הלקוח, השתמשו במאגרי זיכרון משותפים.
כדי להקצות זיכרון אטום, מבצעים את השלבים הבאים:
מפעילים את הפונקציה
ANeuralNetworksMemoryDesc_create()כדי ליצור מתאר זיכרון חדש:// Create a memory descriptor ANeuralNetworksMemoryDesc* desc; ANeuralNetworksMemoryDesc_create(&desc);
מציינים את כל תפקידי הקלט והפלט הרצויים באמצעות קריאה ל-
ANeuralNetworksMemoryDesc_addInputRole()ול-ANeuralNetworksMemoryDesc_addOutputRole().// Specify that the memory may be used as the first input and the first output // of the compilation ANeuralNetworksMemoryDesc_addInputRole(desc, compilation, 0, 1.0f); ANeuralNetworksMemoryDesc_addOutputRole(desc, compilation, 0, 1.0f);
אפשר גם לציין את ממדי הזיכרון באמצעות קריאה ל-
ANeuralNetworksMemoryDesc_setDimensions().// Specify the memory dimensions uint32_t dims[] = {3, 4}; ANeuralNetworksMemoryDesc_setDimensions(desc, 2, dims);
מסיימים את הגדרת התיאור באמצעות קריאה ל-
ANeuralNetworksMemoryDesc_finish().ANeuralNetworksMemoryDesc_finish(desc);
אפשר להקצות כמה זיכרונות שצריך על ידי העברת התיאור אל
ANeuralNetworksMemory_createFromDesc().// Allocate two opaque memories with the descriptor ANeuralNetworksMemory* opaqueMem; ANeuralNetworksMemory_createFromDesc(desc, &opaqueMem);
צריך לשחרר את מתאר הזיכרון כשכבר לא צריך אותו.
ANeuralNetworksMemoryDesc_free(desc);
הלקוח יכול להשתמש באובייקט ANeuralNetworksMemory שנוצר רק עם ANeuralNetworksExecution_setInputFromMemory() או עם ANeuralNetworksExecution_setOutputFromMemory(), בהתאם לתפקידים שצוינו באובייקט ANeuralNetworksMemoryDesc. הארגומנטים offset ו-length צריכים להיות מוגדרים ל-0, כדי לציין שנעשה שימוש בכל הזיכרון. הלקוח יכול גם להגדיר או לחלץ באופן מפורש את תוכן הזיכרון באמצעות ANeuralNetworksMemory_copy().
אתם יכולים ליצור זיכרונות אטומים עם תפקידים של ממדים או דירוג לא מוגדרים.
במקרה כזה, יכול להיות שהיצירה של הזיכרון תיכשל עם הסטטוס ANEURALNETWORKS_OP_FAILED אם הוא לא נתמך על ידי הדרייבר הבסיסי. מומלץ ללקוח להטמיע לוגיקה חלופית על ידי הקצאת מאגר נתונים זמני גדול מספיק שמגובה על ידי Ashmem או AHardwareBuffer במצב BLOB.
כש-NNAPI כבר לא צריך לגשת לאובייקט הזיכרון האטום, משחררים את המכונה התואמת של ANeuralNetworksMemory:
ANeuralNetworksMemory_free(opaqueMem);
למדוד ביצועים
כדי להעריך את ביצועי האפליקציה, אתם יכולים למדוד את זמן הביצוע או ליצור פרופיל.
זמן הביצוע
כדי לקבוע את זמן הביצוע הכולל באמצעות זמן הריצה, אפשר להשתמש ב-API של הביצוע הסינכרוני ולמדוד את משך הזמן של הקריאה החוזרת. כדי לקבוע את זמן הביצוע הכולל באמצעות רמה נמוכה יותר של מחסנית התוכנה, אפשר להשתמש ב-ANeuralNetworksExecution_setMeasureTiming וב-ANeuralNetworksExecution_getDuration כדי לקבל:
- זמן הביצוע במאיץ (לא במנהל ההתקן, שפועל במעבד המארח).
- זמן הביצוע בדרייבר, כולל הזמן במאיץ.
זמן ההרצה במנהל ההתקן לא כולל תקורה כמו זו של סביבת זמן הריצה עצמה וה-IPC שנדרש לסביבת זמן הריצה כדי לתקשר עם מנהל ההתקן.
ממשקי ה-API האלה מודדים את משך הזמן בין האירועים של שליחת העבודה והשלמת העבודה, ולא את הזמן שבו הדרייבר או המאיץ מבצעים את ההסקה, שייתכן שנקטע בגלל החלפת הקשר.
לדוגמה, אם הסקת המסקנות הראשונה מתחילה, ואז הדרייבר מפסיק את העבודה כדי לבצע את הסקת המסקנות השנייה, ואז הוא ממשיך ומשלים את הסקת המסקנות הראשונה, זמן הביצוע של הסקת המסקנות הראשונה יכלול את הזמן שבו העבודה הופסקה כדי לבצע את הסקת המסקנות השנייה.
המידע הזה על התזמון יכול להיות שימושי לפריסה של אפליקציה בסביבת ייצור כדי לאסוף נתוני טלמטריה לשימוש אופליין. אתם יכולים להשתמש בנתוני התזמון כדי לשנות את האפליקציה ולשפר את הביצועים שלה.
כשמשתמשים בפונקציונליות הזו, חשוב לזכור את הדברים הבאים:
- איסוף מידע על תזמון עלול לפגוע בביצועים.
- רק מנהל התקן יכול לחשב את הזמן שנדרש לו או למאיץ, לא כולל הזמן שנדרש ל-NNAPI בזמן ריצה ול-IPC.
- אפשר להשתמש בממשקי ה-API האלה רק עם
ANeuralNetworksExecutionשנוצר באמצעותANeuralNetworksCompilation_createForDevicesעםnumDevices = 1. - לא נדרש מנהל התקן כדי לדווח על מידע לגבי תזמון.
יצירת פרופיל לאפליקציה באמצעות Android Systrace
החל מ-Android 10, NNAPI יוצר באופן אוטומטי אירועי systrace שבהם אתם יכולים להשתמש כדי ליצור פרופיל של האפליקציה.
מקור ה-NNAPI כולל כלי שירות של parse_systrace לעיבוד אירועי ה-systrace שנוצרו על ידי האפליקציה, וליצירת תצוגת טבלה שבה מוצג הזמן שהושקע בשלבים השונים של מחזור החיים של המודל (יצירת מופע, הכנה, ביצוע הידור וסיום) ובשכבות השונות של האפליקציות. השכבות שבהן האפליקציה מפוצלת הן:
-
Application: קוד האפליקציה הראשי -
Runtime: זמן ריצה ל-NNAPI -
IPC: התקשורת בין התהליכים של זמן הריצה של NNAPI לבין קוד הדרייבר -
Driver: תהליך מנהל ההתקן של מאיץ החומרה.
יצירת נתוני ניתוח הפרופילים
נניח שבדקתם את עץ המקור של AOSP ב-$ANDROID_BUILD_TOP, והשתמשתם בדוגמה לסיווג תמונות של TFLite כאפליקציית היעד. אתם יכולים ליצור את נתוני הפרופיילינג של NNAPI באמצעות השלבים הבאים:
- מפעילים את systrace ב-Android באמצעות הפקודה הבאה:
$ANDROID_BUILD_TOP/external/chromium-trace/systrace.py -o trace.html -a org.tensorflow.lite.examples.classification nnapi hal freq sched idle load binder_driver
הפרמטר -o trace.html מציין שהמעקבים ייכתבו ב-trace.html. כשיוצרים פרופיל לאפליקציה שלכם, צריך להחליף את org.tensorflow.lite.examples.classification בשם התהליך שצוין בקובץ המניפסט של האפליקציה.
הפעולה הזו תעסיק את אחד ממסופי המעטפת. אל תריצו את הפקודה ברקע כי היא ממתינה באופן אינטראקטיבי לסיום של enter.
- אחרי שמפעילים את כלי האיסוף systrace, מפעילים את האפליקציה ומריצים את בדיקת ההשוואה לשוק.
במקרה שלנו, אפשר להפעיל את האפליקציה Image Classification מ-Android Studio או ישירות מממשק המשתמש של טלפון הבדיקה, אם האפליקציה כבר הותקנה. כדי ליצור נתוני NNAPI, צריך להגדיר את האפליקציה לשימוש ב-NNAPI על ידי בחירה ב-NNAPI כמכשיר היעד בתיבת הדו-שיח של הגדרת האפליקציה.
כשהבדיקה מסתיימת, מסיימים את ה-systrace על ידי לחיצה על
enterבטרמינל של המסוף שפעיל משלב 1.מריצים את הכלי
systrace_parserכדי ליצור נתונים סטטיסטיים מצטברים:
$ANDROID_BUILD_TOP/frameworks/ml/nn/tools/systrace_parser/parse_systrace.py --total-times trace.html
המנתח מקבל את הפרמטרים הבאים:
- --total-times: מציג את משך הזמן הכולל בשכבה, כולל הזמן שבו המערכת המתינה לביצוע בקריאה לשכבה בסיסית
- --print-detail: מדפיס את כל האירועים שנאספו מ-systrace
- --per-execution: מדפיס רק את הביצוע ואת שלבי המשנה שלו (כמשכי זמן לכל ביצוע) במקום נתונים סטטיסטיים לכל השלבים
- --json: מפיק את הפלט בפורמט JSON
דוגמה לפלט:
===========================================================================================================================================
NNAPI timing summary (total time, ms wall-clock)                                                      Execution
                                                           ----------------------------------------------------
              Initialization   Preparation   Compilation           I/O       Compute      Results     Ex. total   Termination        Total
              --------------   -----------   -----------   -----------  ------------  -----------   -----------   -----------   ----------
Application              n/a         19.06       1789.25           n/a           n/a         6.70         21.37           n/a      1831.17*
Runtime                    -         18.60       1787.48          2.93         11.37         0.12         14.42          1.32      1821.81
IPC                     1.77             -       1781.36          0.02          8.86            -          8.88             -      1792.01
Driver                  1.04             -       1779.21           n/a           n/a          n/a          7.70             -      1787.95

Total                   1.77*        19.06*      1789.25*         2.93*        11.74*        6.70*        21.37*         1.32*     1831.17*
===========================================================================================================================================
* This total ignores missing (n/a) values and thus is not necessarily consistent with the rest of the numbers
יכול להיות שהמנתח ייכשל אם האירועים שנאספו לא מייצגים מעקב מלא אחרי האפליקציה. הוא עלול להיכשל במיוחד אם אירועי systrace שנוצרו כדי לסמן את הסוף של קטע מסוים נמצאים במעקב בלי אירוע משויך של התחלת קטע. בדרך כלל זה קורה אם אירועים מסוימים מסשן קודם של יצירת פרופיל נוצרים כשמפעילים את הכלי לאיסוף נתונים של systrace. במקרה כזה, תצטרכו להפעיל שוב את יצירת הפרופיל.
הוספת נתונים סטטיסטיים של קוד האפליקציה לפלט של systrace_parser
האפליקציה parse_systrace מבוססת על הפונקציונליות המובנית של systrace ב-Android. אתם יכולים להוסיף מעקבים לפעולות ספציפיות באפליקציה באמצעות systrace API (ל-Java, לאפליקציות נייטיב) עם שמות של אירועים בהתאמה אישית.
כדי לשייך את האירועים המותאמים אישית לשלבים במחזור החיים של האפליקציה, צריך להוסיף לשם האירוע את אחת מהמחרוזות הבאות:
-
[NN_LA_PI]: אירוע ברמת האפליקציה להפעלה -
[NN_LA_PP]: אירוע ברמת האפליקציה להכנה -
[NN_LA_PC]: אירוע ברמת האפליקציה לצורך הידור -
[NN_LA_PE]: אירוע ברמת האפליקציה להפעלה
הנה דוגמה לשינוי קוד לדוגמה של סיווג תמונות ב-TFLite על ידי הוספת קטע runInferenceModel לשלב Execution ושכבת Application שמכילה קטעים אחרים preprocessBitmap שלא יובאו בחשבון במעקבי NNAPI. הקטע runInferenceModel יהיה חלק מאירועי ה-systrace שיעובדו על ידי מנתח ה-systrace של NNAPI:
Kotlin
/** Runs inference and returns the classification results. */ fun recognizeImage(bitmap: Bitmap): List{ // This section won’t appear in the NNAPI systrace analysis Trace.beginSection("preprocessBitmap") convertBitmapToByteBuffer(bitmap) Trace.endSection() // Run the inference call. // Add this method in to NNAPI systrace analysis. Trace.beginSection("[NN_LA_PE]runInferenceModel") long startTime = SystemClock.uptimeMillis() runInference() long endTime = SystemClock.uptimeMillis() Trace.endSection() ... return recognitions }
Java
/** Runs inference and returns the classification results. */ public ListrecognizeImage(final Bitmap bitmap) { // This section won’t appear in the NNAPI systrace analysis Trace.beginSection("preprocessBitmap"); convertBitmapToByteBuffer(bitmap); Trace.endSection(); // Run the inference call. // Add this method in to NNAPI systrace analysis. Trace.beginSection("[NN_LA_PE]runInferenceModel"); long startTime = SystemClock.uptimeMillis(); runInference(); long endTime = SystemClock.uptimeMillis(); Trace.endSection(); ... Trace.endSection(); return recognitions; }
איכות השירות (QoS)
ב-Android 11 ואילך, NNAPI מאפשר איכות שירות (QoS) טובה יותר בכך שהוא מאפשר לאפליקציה לציין את העדיפויות היחסיות של המודלים שלה, את משך הזמן המקסימלי שצפוי להכנת מודל נתון ואת משך הזמן המקסימלי שצפוי להשלמת חישוב נתון. ב-Android 11 יש גם קודי תוצאות נוספים של NNAPI, שמאפשרים לאפליקציות להבין כשלים כמו חריגה ממועדי הביצוע.
הגדרת העדיפות של עומס עבודה
כדי להגדיר את העדיפות של עומס עבודה ב-NNAPI, צריך להפעיל את ANeuralNetworksCompilation_setPriority() לפני שמפעילים את ANeuralNetworksCompilation_finish().
הגדרת מועדי הגשה
אפליקציות יכולות להגדיר מועדים אחרונים גם להידור המודל וגם להסקת המסקנות.
- כדי להגדיר את הזמן הקצוב לתפוגה של הקומפילציה, צריך להפעיל את
ANeuralNetworksCompilation_setTimeout()לפני שמפעילים אתANeuralNetworksCompilation_finish(). - כדי להגדיר את זמן הקצוב לתפוגה של ההסקה, צריך להפעיל את
ANeuralNetworksExecution_setTimeout()לפני התחלת ההידור.
מידע נוסף על אופרנדים
הקטע הבא עוסק בנושאים מתקדמים שקשורים לשימוש באופרנדים.
טנזורים מכווננים
טנזור מכומת הוא דרך קומפקטית לייצג מערך n-ממדי של ערכים עם נקודה צפה.
NNAPI תומך בטנזורים מכומתים אסימטריים של 8 ביט. בטנזורים האלה, הערך של כל תא מיוצג על ידי מספר שלם של 8 ביט. לכל טנזור משויכים ערך קנה מידה וערך נקודת אפס. הם משמשים להמרת מספרים שלמים של 8 ביט לערכים של נקודה צפה (floating point) שמיוצגים.
הנוסחה היא:
(cellValue - zeroPoint) * scale
כאשר הערך של zeroPoint הוא מספר שלם של 32 ביט, והערך של scale הוא מספר נקודה צפה של 32 ביט.
בהשוואה לטנזורים של ערכי נקודה צפה (floating point) של 32 ביט, לטנזורים מכומתים של 8 ביט יש שני יתרונות:
- האפליקציה קטנה יותר, כי המשקלים המאומנים תופסים רבע מהגודל של טנסורים של 32 ביט.
- בדרך כלל אפשר לבצע חישובים מהר יותר. הסיבה לכך היא שכמות הנתונים שצריך לאחזר מהזיכרון קטנה יותר, והמעבדים (כמו DSP) יעילים יותר בביצוע פעולות מתמטיות של מספרים שלמים.
אפשר להמיר מודל של נקודה צפה למודל מכומת, אבל הניסיון שלנו מראה שאפשר להשיג תוצאות טובות יותר על ידי אימון ישיר של מודל מכומת. למעשה, רשת הנוירונים לומדת לפצות על רמת הפירוט המוגברת של כל ערך. לכל טנזור מכומת, ערכי ה-scale וה-zeroPoint נקבעים במהלך תהליך האימון.
ב-NNAPI, מגדירים סוגים של טנזורים מכומתים על ידי הגדרת השדה type של מבנה הנתונים ANeuralNetworksOperandType לערך ANEURALNETWORKS_TENSOR_QUANT8_ASYMM.
בנוסף, מציינים את הערכים scale ו-zeroPoint של הטנזור במבנה הנתונים הזה.
בנוסף לטנזורים אסימטריים מכומתים של 8 ביט, NNAPI תומך גם ב:
-
ANEURALNETWORKS_TENSOR_QUANT8_SYMM_PER_CHANNEL, שבה אפשר להשתמש כדי לייצג משקלים לפעולותCONV/DEPTHWISE_CONV/TRANSPOSED_CONV. ANEURALNETWORKS_TENSOR_QUANT16_ASYMMשאפשר להשתמש בו למצב הפנימי שלQUANTIZED_16BIT_LSTM.ANEURALNETWORKS_TENSOR_QUANT8_SYMMשיכול להיות קלט שלANEURALNETWORKS_DEQUANTIZE.
אופרנדים אופציונליים
בחלק מהפעולות, כמו ANEURALNETWORKS_LSH_PROJECTION, יש אופרנדים אופציונליים. כדי לציין במודל שהאופרנד האופציונלי הושמט, קוראים לפונקציה ANeuralNetworksModel_setOperandValue() ומעבירים את הערך NULL למאגר הנתונים הזמני ואת הערך 0 לאורך.
אם ההחלטה אם האופרנד קיים או לא משתנה בכל הפעלה, אתם מציינים שהאופרנד מושמט באמצעות הפונקציות ANeuralNetworksExecution_setInput() או ANeuralNetworksExecution_setOutput(), ומעבירים את הערך NULL למאגר הנתונים ואת הערך 0 לאורך.
טנזורים בדרגה לא ידועה
ב-Android 9 (רמת API 28) נוספו אופרנדים של מודלים עם ממדים לא ידועים אבל עם דירוג ידוע (מספר הממדים). ב-Android 10 (רמת API 29) הושקו טנזורים בדרגה לא ידועה, כמו שמוצג ב-ANeuralNetworksOperandType.
בנצ'מרק של NNAPI
הבנצ'מרק של NNAPI זמין ב-AOSP ב-platform/test/mlts/benchmark (אפליקציית בנצ'מרק) וב-platform/test/mlts/models (מודלים ומערכי נתונים).
בדיקת הביצועים מעריכה את זמן האחזור והדיוק ומשווה בין מנהלי התקנים לאותה עבודה שבוצעה באמצעות Tensorflow Lite שפועל ב-CPU, עבור אותם מודלים וקבוצות נתונים.
כדי להשתמש בבדיקה:
מחברים את מכשיר ה-Android הרצוי למחשב, פותחים את חלון הטרמינל ומוודאים שאפשר להגיע למכשיר דרך adb.
אם מחוברים כמה מכשירי Android, מייצאים את משתנה הסביבה
ANDROID_SERIALשל מכשיר היעד.עוברים לספריית קובצי המקור ברמה העליונה של Android.
מריצים את הפקודות הבאות:
lunch aosp_arm-userdebug # Or aosp_arm64-userdebug if available
./test/mlts/benchmark/build_and_run_benchmark.sh
בסיום ההרצה של נקודת ההשוואה, התוצאות יוצגו כדף HTML שיועבר אל
xdg-open.
יומני NNAPI
NNAPI יוצר מידע שימושי לניתוח ביצועים ביומני המערכת. כדי לנתח את היומנים, משתמשים בכלי logcat.
כדי להפעיל רישום מפורט ביומן של NNAPI לשלבים או לרכיבים ספציפיים, מגדירים את המאפיין debug.nn.vlog (באמצעות adb shell) לרשימת הערכים הבאה, כשהם מופרדים באמצעות רווח, נקודתיים או פסיק:
-
model: בניית מודל -
compilation: יצירת תוכנית ההרצה והקומפילציה של המודל -
execution: הפעלת המודל cpuexe: ביצוע פעולות באמצעות הטמעת ה-CPU של NNAPI-
manager: תוספי NNAPI, ממשקים זמינים ומידע שקשור ליכולות -
allאו1: כל הרכיבים שלמעלה
לדוגמה, כדי להפעיל רישום מפורט (verbose) מלא ביומן, משתמשים בפקודה adb shell setprop debug.nn.vlog all. כדי להשבית את הרישום המפורט ביומן, משתמשים בפקודה adb shell setprop debug.nn.vlog '""'.
אחרי שמפעילים את רישום היומן המפורט, נוצרות רשומות ביומן ברמת INFO עם תג שמוגדר לשלב או לשם הרכיב.
בנוסף להודעות שנשלטות על ידי debug.nn.vlog, רכיבי NNAPI API מספקים רשומות אחרות ביומן ברמות שונות, כשכל אחת מהן משתמשת בתג יומן ספציפי.
כדי לקבל רשימה של רכיבים, מחפשים בעץ המקור באמצעות הביטוי הבא:
grep -R 'define LOG_TAG' | awk -F '"' '{print $2}' | sort -u | egrep -v "Sample|FileTag|test"
הביטוי הזה מחזיר כרגע את התגים הבאים:
- BurstBuilder
- התקשרות חזרה
- CompilationBuilder
- CpuExecutor
- ExecutionBuilder
- ExecutionBurstController
- ExecutionBurstServer
- ExecutionPlan
- FibonacciDriver
- GraphDump
- IndexedShapeWrapper
- IonWatcher
- מנהל
- זיכרון
- MemoryUtils
- MetaModel
- ModelArgumentInfo
- ModelBuilder
- NeuralNetworks
- OperationResolver
- תפעול
- OperationsUtils
- PackageInfo
- TokenHasher
- TypeManager
- כלי עזר
- ValidateHal
- VersionedInterfaces
כדי לשלוט ברמת הודעות היומן שמוצגות על ידי logcat, משתמשים במשתנה הסביבה ANDROID_LOG_TAGS.
כדי להציג את כל הודעות היומן של NNAPI ולהשבית את כל השאר, מגדירים את ANDROID_LOG_TAGS כך:
BurstBuilder:V Callbacks:V CompilationBuilder:V CpuExecutor:V ExecutionBuilder:V ExecutionBurstController:V ExecutionBurstServer:V ExecutionPlan:V FibonacciDriver:V GraphDump:V IndexedShapeWrapper:V IonWatcher:V Manager:V MemoryUtils:V Memory:V MetaModel:V ModelArgumentInfo:V ModelBuilder:V NeuralNetworks:V OperationResolver:V OperationsUtils:V Operations:V PackageInfo:V TokenHasher:V TypeManager:V Utils:V ValidateHal:V VersionedInterfaces:V *:S.
כדי להגדיר את ANDROID_LOG_TAGS, משתמשים בפקודה הבאה:
export ANDROID_LOG_TAGS=$(grep -R 'define LOG_TAG' | awk -F '"' '{ print $2 ":V" }' | sort -u | egrep -v "Sample|FileTag|test" | xargs echo -n; echo ' *:S')
חשוב לזכור שזה רק מסנן שחל על logcat. עדיין צריך להגדיר את המאפיין debug.nn.vlog לערך all כדי ליצור מידע מפורט ביומן.