تیم زمان اجرای Android (ART) زمان ترجمه را بدون بهخطر انداختن کد ترجمهشده یا هرگونه پسرفت حافظه اوج ۱۸٪ کاهش داده است. این بهبود بخشی از ابتکار سال ۲۰۲۵ ما برای بهبود زمان ترجمه بدون فدا کردن استفاده از حافظه یا کیفیت کد ترجمهشده بود.
بهینهسازی سرعت زمان ترجمه برای ART بسیار مهم است. برای مثال، هنگام ترجمه درجا (JIT)، این موضوع مستقیماً بر کارایی برنامهها و عملکرد کلی دستگاه تأثیر میگذارد. کامپایلهای سریعتر زمان قبلاز شروع بهینهسازیها را کاهش میدهد و منجر به تجربه کاربری روانتر و واکنشگراتر میشود. علاوهبراین، هم برای JIT و هم برای «پیشاز موعد» (AOT)، بهبود سرعت زمان ترجمه به کاهش مصرف منابع درطول فرایند ترجمه منجر میشود که برای عمر باتری و دمای دستگاه، بهویژه در دستگاههای ردهپایین، مفید است.
برخیاز این بهبودهای سرعت زمان ترجمه در نسخه ژوئن ۲۰۲۵ Android عرضه شده است و بقیه در نسخه پایان سال Android دردسترس قرار خواهد گرفت. علاوهبراین، همه کاربران Android در نسخههای ۱۲ و بالاتر واجدشرایط دریافت این بهبودها ازطریق بهروزرسانیهای اصلی هستند.
بهینهسازی کامپایلر بهینهسازی
بهینهسازی کامپایلر همیشه بازی بدهبستان است. نمیتوانید سرعت را رایگان بهدست آورید؛ باید چیزی را فدا کنید. هدف بسیار واضح و چالشبرانگیزی برای خودمان تعیین کردیم: کامپایلر را سریعتر کنیم، اما این کار را بدون ایجاد پسرفت حافظه و، مهمتر از همه، بدون کاهش کیفیت کدی که تولید میکند انجام دهیم. اگر کامپایلر سریعتر باشد اما برنامهها کندتر اجرا شوند، ما شکست خوردهایم.
تنها منبعی که مایل بودیم صرف کنیم زمان توسعه خودمان بود تا عمیقاً کاوش کنیم، بررسی کنیم، و راهحلهای هوشمندانهای پیدا کنیم که این معیارهای سختگیرانه را برآورده کند. بیایید نگاهی دقیقتر به نحوه کارمان برای یافتن زمینههای بهبود و همچنین یافتن راهحلهای مناسب برای مشکلات مختلف بیندازیم.
یافتن بهینهسازیهای احتمالی ارزشمند
قبلاز اینکه بتوانید بهینهسازی سنجهای را شروع کنید، باید بتوانید آن را اندازهگیری کنید. درغیراینصورت، هرگز نمیتوانید مطمئن شوید که آن را بهبود دادهاید یا نه. خوشبختانه برای ما، سرعت زمان ترجمه نسبتاً ثابت است، بهشرطی که برخی اقدامات احتیاطی را انجام دهید، مانند استفاده از همان دستگاهی که برای اندازهگیری قبل و بعداز تغییر استفاده میکنید، و اطمینان از اینکه دستگاهتان را بهدلیل حرارت بالا محدود نمیکنید. علاوهبراین، ما اندازهگیریهای قطعی مانند آمار کامپایلر را نیز داریم که به ما کمک میکند تا بفهمیم در پشت صحنه چه اتفاقی میافتد.
ازآنجاییکه منبعی که برای این بهبودها فدا میکردیم زمان توسعه ما بود، میخواستیم بتوانیم تا جایی که میتوانیم سریع تکرار کنیم. این یعنی ما چند برنامه نمونه (ترکیبی از برنامههای طرف اول، برنامههای طرف سوم، و خود سیستمعامل Android) را برای ساختن نمونه اولیه راهکارها انتخاب کردیم. بعداً با آزمایش دستی و خودکار بهطور گسترده تأیید کردیم که پیادهسازی نهایی ارزشش را داشت.
با آن مجموعه از فایلهای APK دستچینشده، یک کامپایل دستی را بهصورت محلی راهاندازی میکنیم، نمایهای از کامپایل دریافت میکنیم، و از pprof برای تجسم جایی که وقت خود را صرف میکنیم استفاده میکنیم.
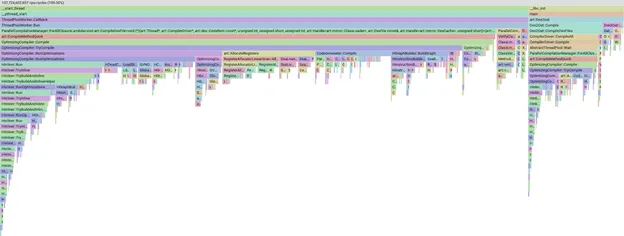
نمونهای از نمودار شعلهای نمایه در pprof
ابزار pprof بسیار قدرتمند است و به ما امکان میدهد دادهها را برش دهیم، فیلتر کنیم، و مرتب کنیم تا ببینیم، برای مثال، کدام فازها یا روشهای کامپایلر بیشترین زمان را میبرند. وارد جزئیات pprof نخواهیم شد؛ فقط بدانید که اگر نوار بزرگتر باشد، یعنی زمان بیشتری برای کامپایل صرف شده است.
یکی از این نماها، نمای «پایین به بالا» است که در آن میتوانید ببینید کدام روشها بیشترین زمان را میگیرند. در تصویر زیر، میتوانیم روشی بهنام Kill را ببینیم که بیشاز ۱٪ زمان ترجمه را به خود اختصاص داده است. برخیاز روشهای برتر دیگر نیز بعداً در پست وبلاگ مورد بحث قرار خواهند گرفت.
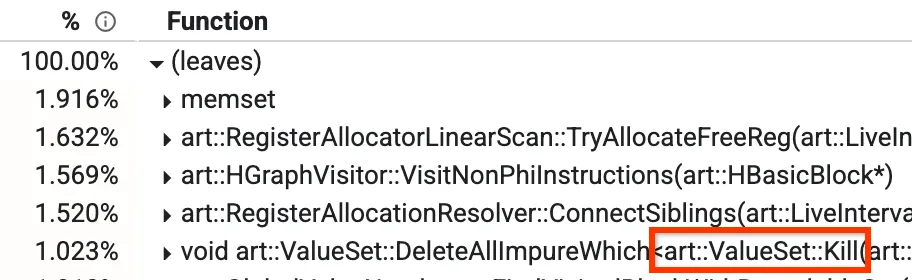
نمای پایین به بالای نمایه
در کامپایلر بهینهسازی ما، مرحلهای بهنام «شمارهگذاری مقدار سراسری» (GVN) وجود دارد. لازم نیست نگران عملکرد کلی آن باشید، اما بخش مهم این است که بدانید این کلاس متدی به نام `Kill` دارد که برخی گرهها را براساس یک فیلتر حذف میکند. این کار زمانبر است زیرا باید همه گرهها را تکرار کند و یکییکی بررسی کند. متوجه شدیم که در برخی موارد ازقبل میدانیم که بررسی نادرست خواهد بود، صرفنظر از اینکه در آن نقطه چه گرههایی فعال باشند. در این موارد، میتوانیم تکرار را بهطور کامل رد کنیم، آن را از ۱٫۰۲۳٪ به حدود ۰٫۳٪ کاهش دهیم و زمان اجرای GVN را حدود ۱۵٪ بهبود دهیم.
اجرای بهینهسازیهای ارزشمند
ما نحوه اندازهگیری و نحوه تشخیص اینکه زمان کجا صرف میشود را پوشش دادیم، اما این تازه شروع کار است. مرحله بعدی این است که چگونه زمان صرفشده برای کامپایل کردن را بهینه کنید.
معمولاً در موردی مانند مورد `Kill` در بالا، نگاهی به نحوه تکرار گرهها میاندازیم و آن را سریعتر انجام میدهیم، مثلاً با انجام کارها بهصورت موازی یا بهبود خود الگوریتم. درواقع، این همان چیزی است که در ابتدا امتحان کردیم و تنها زمانی که نتوانستیم کاری برای انجام دادن پیدا کنیم، لحظهای «صبر کنید…» داشتیم و دیدیم که راهحل این است که (در برخی موارد) اصلاً تکرار نکنیم! هنگام انجام این نوع بهینهسازیها، بهراحتی ممکن است جزئیات را فدای کلیات کنید.
در موارد دیگر، از چند تکنیک مختلف استفاده کردیم، ازجمله:
- استفاده از روشهای اکتشافی برای تصمیمگیری درباره اینکه آیا بهینهسازی نتایج ارزشمندی تولید نخواهد کرد و بنابراین میتوان از آن صرفنظر کرد
- استفاده از ساختارهای داده اضافی برای ذخیره دادههای محاسبهشده در حافظه نهان
- تغییر ساختارهای داده فعلی برای افزایش سرعت
- محاسبه تنبل نتایج برای اجتناب از چرخهها در برخی موارد
- از انتزاع مناسب استفاده کنید - ویژگیهای غیرضروری میتوانند کد را کند کنند
- از دنبال کردن اشارهگر پرکاربرد در بارگیریهای متعدد اجتناب کنید
چگونه بدانیم که بهینهسازیها ارزش دنبال کردن دارند؟
نکته جالب این است که لازم نیست این کار را بکنید. پساز تشخیص اینکه بخشی زمان ترجمه زیادی مصرف میکند و پساز اختصاص دادن زمان توسعه برای تلاش در جهت بهبود آن، گاهی اوقات نمیتوانید راهحلی پیدا کنید. شاید کاری برای انجام دادن وجود نداشته باشد، پیادهسازی آن خیلی طول بکشد، سنجه دیگری را بهطور قابلتوجهی پسرفت دهد، پیچیدگی پایگاه کد را افزایش دهد، و غیره. برای هر بهینهسازی موفقی که در این پست وبلاگ میبینید، بدانید که موارد بیشمار دیگری وجود دارد که به نتیجه نرسیدهاند.
اگر در موقعیت مشابهی هستید، سعی کنید با انجام کمترین کار ممکن، تخمین بزنید که چقدر میتوانید سنجه را بهبود ببخشید. این یعنی بهترتیب:
- برآورد با سنجههایی که قبلاً جمعآوری کردهاید، یا فقط یک احساس درونی
- برآورد کردن با نمونه اولیه سریع و کثیف
- راهحلی را اجرا کنید.
فراموش نکنید که معایب راهحلتان را هم تخمین بزنید. برای مثال، اگر قرار است به ساختارهای داده اضافی تکیه کنید، چقدر حافظه میخواهید استفاده کنید؟
درحال کاوش عمیقتر
بدون معطلی، بیایید به برخیاز تغییراتی که اعمال کردهایم نگاهی بیندازیم.
تغییری برای بهینهسازی روشی بهنام FindReferenceInfoOf اعمال کردیم. این روش جستجوی خطی بردار را برای پیدا کردن ورودی انجام میداد. ما آن ساختار داده را بهروزرسانی کردیم تا با شناسه دستورالعمل نمایه شود تا FindReferenceInfoOf بهجای O(n) برابر با O(1) باشد. همچنین، بردار را ازقبل اختصاص دادیم تا از تغییر اندازه جلوگیری شود. حافظه را کمی افزایش دادیم چون مجبور بودیم فیلد اضافهای اضافه کنیم که تعداد ورودیهای درجشده در بردار را میشمرد، اما این فداکاری کوچکی بود چون اوج حافظه افزایش نیافت. این کار فاز LoadStoreAnalysis ما را ۳۴ تا ۶۶ درصد سرعت بخشید که بهنوبه خود باعث بهبود حدود ۰٫۵ تا ۱٫۸ درصدی زمان ترجمه میشود.
ما یک پیادهسازی سفارشی از HashSet داریم که در چندین مکان از آن استفاده میکنیم. ایجاد این ساختار داده زمان قابلتوجهی میبرد و ما دلیل آن را پیدا کردیم. سالها پیش، این ساختار داده فقط در چند مکان که از HashSetهای بسیار بزرگ استفاده میکردند استفاده میشد و برای بهینهسازی در آن مکانها اصلاح شده بود. بااینحال، امروزه در جهت مخالف با تنها چند ورودی و با طول عمر کوتاه استفاده میشود. این یعنی ما با ایجاد این HashSet بزرگ چرخهها را هدر میدادیم اما فقط برای چند ورودی از آن استفاده میکردیم و سپس آن را دور میانداختیم. با این تغییر، زمان ترجمه را حدود ۱٫۳ تا ۲ درصد بهبود بخشیدیم. بهعنوان یک مزیت اضافی، مصرف حافظه حدود ۰٫۵ تا ۱ درصد کاهش یافت زیرا دیگر از ساختارهای داده بزرگ مانند گذشته استفاده نمیکردیم.
با ارسال ساختارهای داده ازطریق ارجاع به لامبدا برای جلوگیری از کپی کردن آنها، زمان ترجمه را حدود ۰٫۵ تا ۱ درصد بهبود دادیم. این چیزی بود که در بازبینی اصلی از قلم افتاده بود و سالها در پایگاه کد ما باقی مانده بود. بهلطف نگاهی که به نمایهها در pprof انداختیم متوجه شدیم که این روشها ساختارهای داده زیادی را ایجاد و تخریب میکنند، که باعث شد آنها را بررسی و بهینهسازی کنیم.
با ذخیره کردن مقادیر محاسبهشده در حافظه نهان، مرحلهای را که خروجی ترجمهشده را مینویسد تسریع کردیم که این امر به بهبود حدود ۱٫۳ تا ۲٫۸ درصدی کل زمان ترجمه منجر شد. متأسفانه، دفترداری اضافی بیشاز حد بود و آزمایش خودکار ما درباره پسرفت حافظه به ما هشدار داد. بعداً، نگاهی دوباره به همان کد انداختیم و نسخه جدیدی را پیادهسازی کردیم که نهتنها مشکل پسرفت حافظه را برطرف کرد، بلکه زمان ترجمه را نیز حدود ۰٫۵ تا ۱٫۸ درصد بهبود بخشید! در این تغییر دوم، مجبور شدیم نحوه عملکرد این مرحله را بازسازی و بازانگاری کنیم تا از یکی از دو ساختار داده خلاص شویم.
ما در کامپایلر بهینهسازی خود مرحلهای داریم که فراخوانیهای تابع را بهصورت درونخطی انجام میدهد تا عملکرد بهتری داشته باشیم. برای انتخاب روشهای درونخطی، هم از اکتشافات قبلاز انجام هرگونه محاسبات استفاده میکنیم و هم از بررسیهای نهایی پساز انجام کار اما درست قبلاز نهایی کردن درونخطی. اگر هریک از آنها تشخیص دهد که درونخطی کردن ارزشش را ندارد (برای مثال، دستورالعملهای جدید بسیار زیادی اضافه خواهد شد)، فراخوانی روش را درونخطی نمیکنیم.
دو بررسی را از دسته «بررسیهای نهایی» به دسته «اکتشافی» منتقل کردیم تا قبلاز انجام هرگونه محاسبات زمانبر، تخمین بزنیم که آیا درونخطیسازی موفق خواهد بود یا نه. ازآنجاییکه این یک تخمین است، کامل نیست، اما ما تأیید کردیم که اکتشافات جدید ما ۹۹٫۹٪ از آنچه قبلاً درونخطی شده بود را بدون تأثیر بر عملکرد پوشش میدهد. یکی از این اکتشافیهای جدید درباره ثبتهای DEX موردنیاز (~۰٫۲-۱٫۳٪ بهبود) و دیگری درباره تعداد دستورالعملها (~۲٪ بهبود) بود.
ما یک پیادهسازی سفارشی از BitVector داریم که در چندین مکان از آن استفاده میکنیم. کلاس BitVector با قابلیت تغییر اندازه را با BitVectorView سادهتر برای برخیاز بردارهای بیتی با اندازه ثابت جایگزین کردیم. این کار برخیاز ارجاعهای غیرمستقیم و بررسیهای محدوده زمان اجرا را حذف میکند و ساخت اشیای بردار بیت را سرعت میبخشد.
علاوهبراین، کلاس BitVectorView در نوع ذخیرهسازی زیربنایی قالببندی شد (بهجای اینکه همیشه از uint32_t بهعنوان BitVector قدیمی استفاده شود). این کار به برخیاز عملیاتها، برای مثال Union()، اجازه میدهد تا دو برابر بیتهای بیشتری را با هم در پلاتفرمهای ۶۴ بیتی پردازش کنند. نمونههای توابع تحتتأثیرقرارگرفته درمجموع بیشاز ۱٪ درطول کامپایل کردن سیستمعامل Android کاهش یافت. این کار در چندین تغییر انجام شد [۱، ۲، ۳، ۴، ۵، ۶]
اگر بخواهیم درباره همه بهینهسازیها با جزئیات صحبت کنیم، کل روز را باید اینجا باشیم! اگر به بهینهسازیهای بیشتری علاقه دارید، به برخی تغییرات دیگری که اعمال کردهایم نگاهی بیندازید:
- افزودن دفترداری برای بهبود زمانهای ترجمه تا حدود ۰٫۶ تا ۱٫۶٪.
- درصورت امکان، برای جلوگیری از چرخهها، دادهها را بهصورت تنبل محاسبه کنید.
- کد ما را بازسازی کن تا وقتی از کار پیشمحاسبه استفاده نمیشود، از آن رد شود.
- از برخی زنجیرههای بار وابسته اجتناب کنید وقتی که تخصیصدهنده بهراحتی از جاهای دیگر قابل دریافت باشد.
- مورد دیگری از افزودن بررسی برای جلوگیری از کار غیرضروری.
- از انشعاب مکرر در نوع ثبات (هسته/FP) در تخصیصدهنده ثبات اجتناب کنید.
- مطمئن شوید برخیآرایهها در زمان ترجمه مقداردهی اولیه شده باشند. برای انجام این کار به clang تکیه نکنید.
- برخیاز حلقهها را پاکسازی کنید. از حلقههای محدوده استفاده کنید که clang میتواند بهتر بهینهسازی کند زیرا بهدلیل عوارض جانبی حلقه نیازی به بار کردن مجدد اشارهگرهای داخلی محفظه ندارد. از فراخوانی تابع مجازی `HInstruction::GetInputRecords()` در حلقه ازطریق `InputAt(.)` درونخطی برای هر ورودی اجتناب کنید.
- با بهرهبرداری از بهینهسازی کامپایلر، از توابع Accept() برای الگوی بازدیدکننده اجتناب کنید.
نتیجهگیری
تعهد ما به بهبود سرعت زمان ترجمه ART منجر به بهبودهای قابلتوجهی شده است که Android را روانتر و کارآمدتر میکند و درعینحال به بهبود عمر باتری و دمای دستگاه کمک میکند. با شناسایی و اجرای دقیق بهینهسازیها، نشان دادهایم که دستاوردهای قابلتوجهی در زمان ترجمه بدون بهخطر انداختن استفاده از حافظه یا کیفیت کد امکانپذیر است.
سفر ما شامل نمایهسازی با ابزارهایی مانند pprof، تمایل به تکرار، و گاهی اوقات حتی رها کردن مسیرهای کمثمر بود. تلاشهای جمعی تیم ART نهتنها زمان ترجمه را بهمیزان قابلتوجهی کاهش داده است، بلکه زمینهساز پیشرفتهای آینده نیز شده است.
همه این بهبودها در بهروزرسانی Android پایان سال ۲۰۲۵ و برای Android 12 و بالاتر ازطریق بهروزرسانیهای خط اصلی دردسترس است. امیدواریم این بررسی عمیق در فرایند بهینهسازی ما، اطلاعات آماری ارزشمندی درباره پیچیدگیها و پاداشهای مهندسی کامپایلر ارائه دهد!
-
 اخبار محصول
پساز بیشاز یک سال آمادهسازی مشترک با رهبران صنعت، شرکای منطقهای، توزیعکنندگان برنامه، و انجمنهای Android، محافظتهای ما از کاربران در ۳۰ سپتامبر با موفقیت برای فروشگاههای شرکتکننده در سراسر اندونزی، برزیل، تایلند، و سنگاپور فعال شد.
Matthew Forsythe • ۲ دقیقه خواندن -
 اخبار محصول
برای ارائه این تجربهها به بازیکنان و اطمینان از اینکه بازیهایتان در هر اندازه صفحهنمایشی میدرخشند، Google Play الزامات کیفیت جدیدی برای بازیها در صفحهنمایشهای بزرگ معرفی میکند
Aurash Mahbod • زمان خواندن: ۴ دقیقه -
 اخبار محصول
نسخه نوامبر ۲۰۲۶ از Jetpack Compose پایدار است! این نسخه، نسخه ۱.۱۳ را در سراسر ماژولهای اصلی Compose ارائه میکند (نگاشت کامل BOM را ببینید)، بهروزرسانیهایی را برای نوشتار، گرافیک، چیدمان، عملکرد، و موارد دیگر معرفی میکند—همراه با چند منسوخسازی مهم و تغییرات رفتاری که باید از آنها مطلع باشید.
Meghan Mehta • ۱۰ دقیقه مطالعه
جدیدترین اطلاعات آماری توسعه Android را بهصورت هفتگی در صندوق ورودیتان دریافت کنید.