我們希望協助您更快速輕鬆地打造優質 Android 應用程式,其中一個方法就是讓您輕鬆運用 AI 提高工作效率。我們知道您希望 AI 能真正理解 Android 平台的細微差異,因此我們一直在評估大型語言模型在 Android 開發任務中的表現。今天,我們發布了第一版 Android Bench,這是 Android 開發人員專用的官方 LLM 排行榜。
我們的目標是為模型創作者提供基準,評估 LLM 在 Android 開發方面的能力。我們為優質 Android 開發作業建立明確可靠的基準,協助模型建立者找出差距並加速改善,讓開發人員能更有效率地工作,並有更多實用的模型可供選擇,最終在整個 Android 生態系統中打造出更高品質的應用程式。
設計實際的 Android 開發工作
我們針對一系列常見的 Android 開發領域,精心挑選一組任務,建立基準。其中包含來自公開 GitHub Android 存放區、難度不一的實際挑戰。例如解決 Android 版本之間的破壞性變更、處理穿戴式裝置網路等特定領域工作,以及遷移至最新版 Jetpack Compose。
每次評估都會嘗試讓 LLM 修正工作回報的問題,然後我們再使用單元或檢測設備測試進行驗證。這種不受特定模型限制的方法,可讓我們評估模型在複雜程式碼集中的導覽能力、對依附元件的理解程度,以及解決日常問題的能力。
我們與 JetBrains 等多個 LLM 製作團隊合作,驗證了這項方法。
「評估 AI 對 Android 的影響是一項艱鉅的挑戰,因此很高興看到這個架構如此健全且切合實際。雖然我們積極進行基準測試,但 Android Bench 是獨特且受歡迎的新工具。這種方法正是 Android 開發人員目前需要的嚴謹評估方式。」
- JetBrains AI 整合主管 Kirill Smelov。
第一份 Android Bench 結果
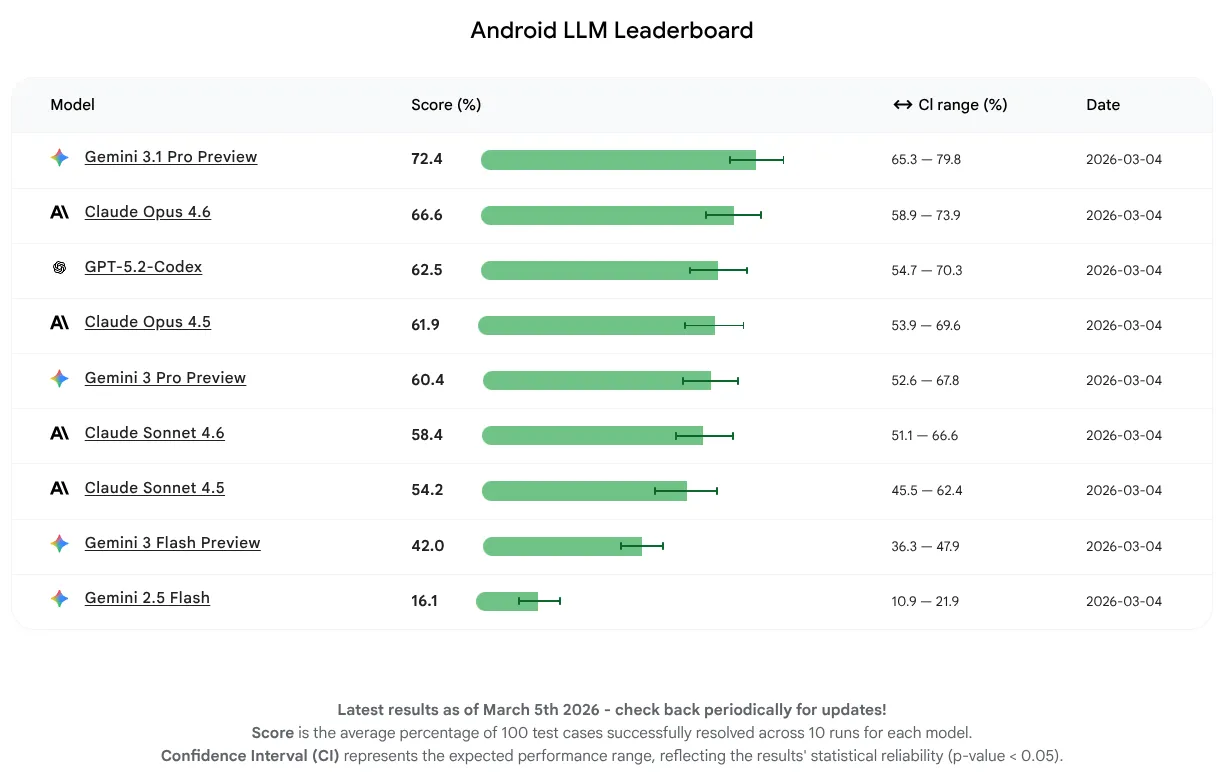
在這次的初始版本中,我們只想單純評估模型效能,不著重於代理或工具的使用。模型能成功完成 16% 到 72% 的工作。這個範圍很廣,顯示部分 LLM 已具備 Android 知識的良好基準,而其他 LLM 則有更多改進空間。無論模型目前的表現如何,我們都預期會持續改善,並鼓勵 LLM 開發人員強化模型,以利 Android 開發。
在首個版本中,Gemini 3.1 Pro 的平均分數最高,Claude Opus 4.6 則緊追在後。您可以使用最新穩定版 Android Studio 的 API 金鑰,試用我們評估過的所有模型,為 Android 專案提供 AI 輔助。
為開發人員和 LLM 建立者提供透明度
我們重視開放透明的做法,因此在 GitHub 上公開我們的方法、資料集和測試控管工具。
任何公開基準都面臨資料污染的風險,也就是模型可能在訓練過程中接觸過評估任務。我們已採取措施,確保結果反映出真正的推論,而非記憶或猜測,包括徹底手動審查代理軌跡,或整合 Canary 字串來防止訓練。
展望未來,我們會持續改良方法,確保資料集完整,同時也會在日後發布基準測試時做出改善,例如增加任務數量和複雜度。
我們期待 Android Bench 能長期提升 AI 輔助功能。我們的願景是縮短從概念到優質程式碼的距離。我們正在奠定基礎,未來無論您有什麼構想,都能在 Android 上實現。
-
 產品最新消息
今天,我們在 Android 開發人員高峰會上宣布,將廣泛提供多項工具和 API,旨在消除日常摩擦,讓您更靈活地建構出色的 Android 應用程式。
Matthew McCullough • 閱讀時間:4 分鐘 -
 產品最新消息
今天,我們發布了第一組長程任務 (LHT),這些任務非常複雜,工程師需要多天甚至一週才能完成。我們也將推出代理評估功能,首先會從相應模型供應商的代理開始。
Matthew McCullough • 閱讀時間:3 分鐘 -
 產品最新消息
今天,我們將發布 Android 17,並在多數支援的 Pixel 裝置上推出。未來幾個月,搭載 Android 17 的新裝置將陸續上市。
Matthew McCullough • 閱讀時間:13 分鐘
每週透過電子郵件接收 Android 開發人員的最新深入分析。