Android Bench 2.0: Zorlu ve uzun vadeli görevlerle sınırları zorlama
Okuma süresi: 3 dk.
Android Bench'i ilk kullanıma sunduğumuzda, büyük dil modellerinin (LLM'ler) geliştiricilere gerçek dünyadaki Android görevlerinde nasıl yardımcı olduğunu değerlendirmek için titiz bir temel oluşturduk. Yapay zeka modelleri ve temsilcileri hızla gelişirken biz de metodolojimizi güncelliyoruz. Örneğin, karşılaştırma çerçevemizi Harbor çerçevesiyle uyumlu hale getiriyoruz. Bugün, ilk uzun vadeli görevler (LHT) grubunu yayınlıyoruz. Bunlar, bir mühendisin tamamlaması birkaç gün, hatta bir hafta süren son derece karmaşık görevlerdir. Ayrıca, ilgili model sağlayıcıların temsilcileriyle başlayarak temsilci tabanlı değerlendirmeyi de kullanıma sunuyoruz. Bu eklemeyle birlikte Android Bench 2.0'a ulaştık. Bu, yapay zeka modellerini ve temsilcilerini her gün karşılaştığınız ölçek, belirsizlik ve karmaşık çok adımlı problem çözme açısından değerlendirmek için tasarlanmış önemli bir yükseltmedir.
Artımlı düzeltmelerden uzun vadeli görevlere
Android Bench'in ilk sürümü, benzer erken yapay zeka kodlama karşılaştırmalarıyla birlikte, mevcut depolardaki artımlı değişikliklere odaklanıyordu. Bu değişiklikler genellikle hata düzeltmeleri veya daha küçük özellik istekleriyle sınırlıydı. Bu, Yapay Zeka Desteği'nin o dönemdeki özelliklerini ve bu özelliği nasıl kullandığınızı yansıtıyordu.
Geliştirme iş akışınıza en uygun modelleri ve kodlama temsilcilerini bulmanıza yardımcı olmaya devam etmek için değerlendirmelerimizin çıtasını yapay zekaya devrettiğiniz işlere uyacak şekilde yükselttik. Android Bench 2.0, bağımlılıkları yükseltme, yeni özellikler ekleme, sıfırdan uygulama geliştirme veya platformlar arası bir uygulamayı Android'e dönüştürme gibi LHT'lerle bu iddialı zorlukları yansıtır.
Karmaşık görevler daha ayrıntılı bir değerlendirme ve puanlama gerektirir.
Birkaç gün süren mühendislik görevlerinde, başarılı veya başarısız şeklinde ikili notlandırma, tam resmi yansıtmaz.
Örneğin, bir temsilci 40 ekranı Jetpack Compose'a yeniden düzenleyebilir, veritabanı tabloları oluşturabilir ve şartların% 90'ını karşılayabilir ancak tek bir uç durum iddiasında başarısız olabilir. İkili puanlama, bu denemeyi %0 olarak değerlendirir ve modelin mimari yeteneklerini gizler. Hem model geliştirme hem de yapay zekanın size nasıl yardımcı olabileceğini anlamanız için daha anlamlı bir sinyal sağlamak amacıyla sürekli puanlamaya geçiyoruz.
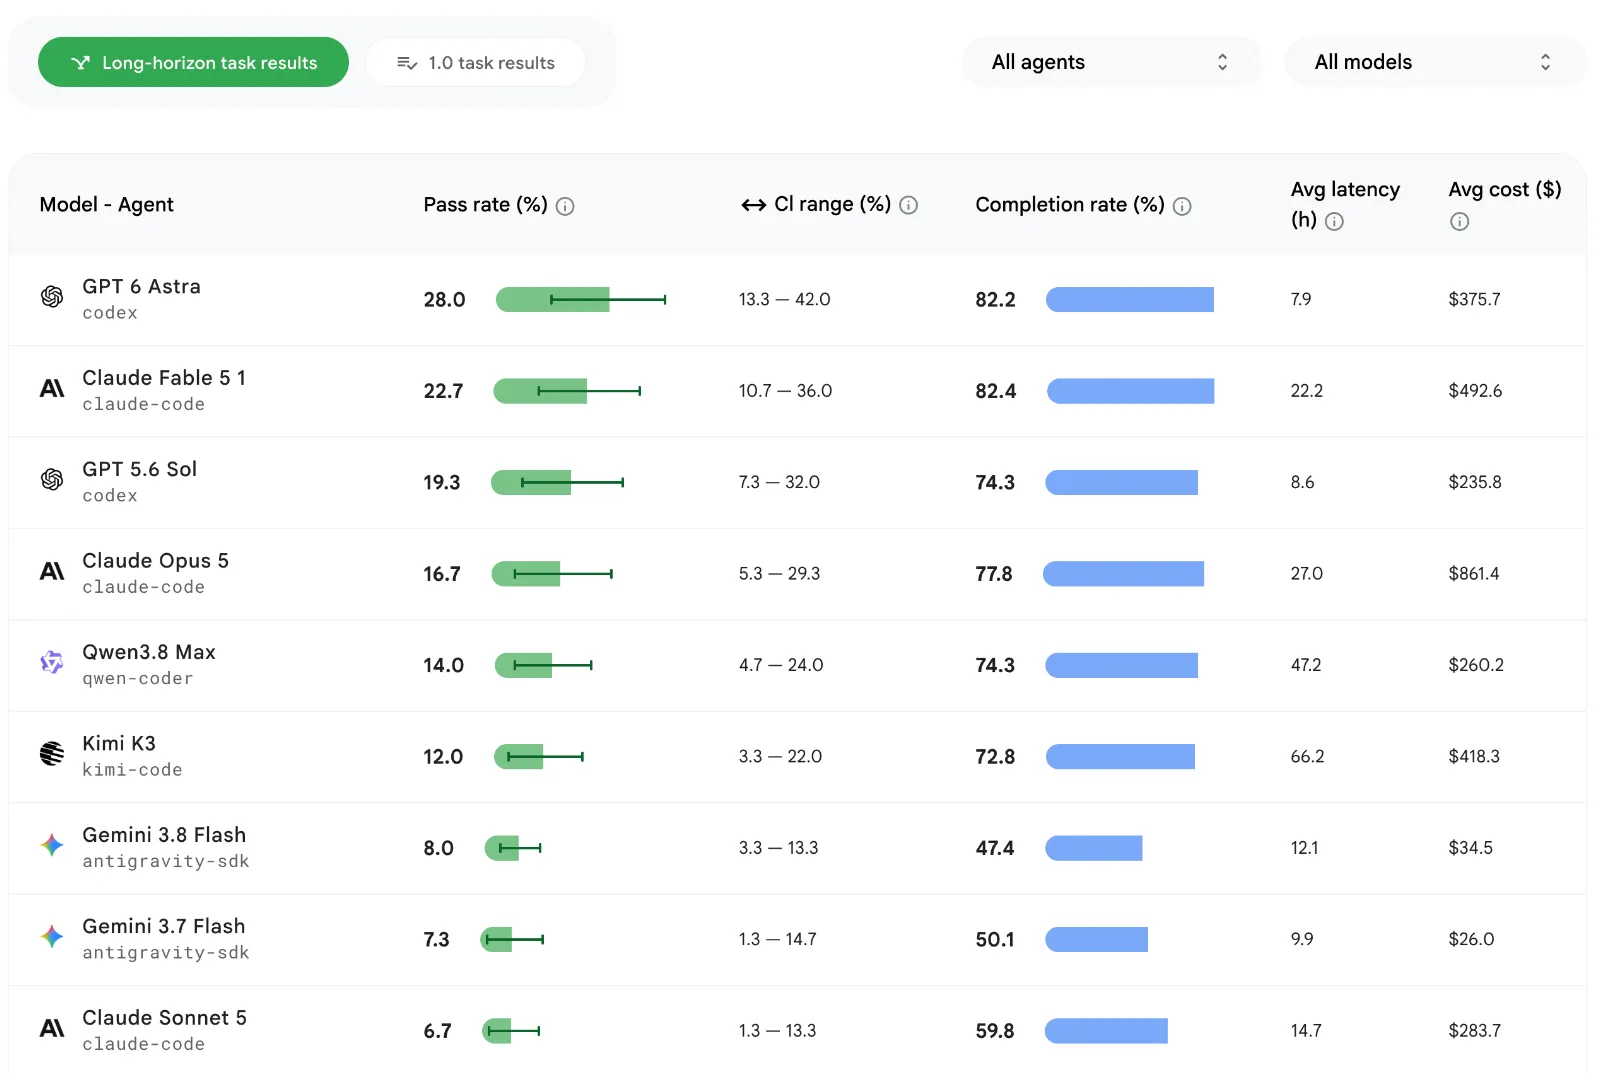
Bu tamamlanma oranını hesaplarken işlevsellik, görsel doğruluk ve gerilemelerden kaçınma gibi çeşitli faktörleri göz önünde bulundururuz. Ayrıca, değerlendirme talimatlarından veya yapısal kısıtlamalardan sapmalar için nesnel puanlama cezaları uygularız. Güncellenen skor tablosuna göz atın ve her modelin kart görünümünü tıklayarak geçme oranı, tamamlanma oranı ve model ile görev başına ortalama maliyet gibi ek unsurları görün.
LHT'ler için en yüksek geçme oranı yaklaşık %28'dir. Bu oran, karşılaştırmadaki orijinal görevler için geçerli olan yaklaşık% 91'lik orandan çok daha düşüktür.

Uzun vadeli görevler, yapay zeka desteği için faydalı analizler sunar
LHT veri kümesi, yapay zekanın uzun süreli görevleri ne kadar iyi yerine getirdiğini ölçmenin yanı sıra test edilen modellerin güçlü ve zayıf yönleri hakkında daha fazla bilgi edinmemize yardımcı olur. Böylece size daha pratik rehberlik sunabiliriz.
Yapay zeka, tüm model katmanlarında mevcut kodu yeniden düzenlemek yerine yeni kod yazma konusunda daha başarılıdır. Yeniden düzenleme ve taşıma işlemleri, başarı kod hacminden ziyade mimari karmaşıklığa bağlı olduğundan daha zor hale gelir.
Modeller; Java'yı Kotlin'e dönüştürme, Retrofit'i Ktor ile değiştirme veya ViewModel katmanı ekleme gibi iyi bilinen, deterministik dönüşümlerde güçlü özellikler gösterir. Bu kalıpları 125'ten fazla dosya ve 8.000'den fazla kod satırında bile tutarlı bir şekilde uygularlar.
Ancak modeller, çalışma zamanı doğrulaması gerektiren görevlerde (ör. eksik bağımlılık ekleme grafikleri), çerçeve değişikliklerini bozan durumlarda veya yayınlanmamış kitaplıklarla ilgili bilgi eksikliklerinde zorlanır. Çapraz platform uygulamalarını Android'e taşımak hâlâ zorlu bir süreç. Hiçbir model% 100 başarı oranına ulaşamıyor ve öncü modeller en fazla% 80 tamamlanma oranına ulaşıyor.
Temsilci değerlendirmeleri kullanıma sunuluyor
Modellerin, ajan tabanlı iş akışlarınıza entegre edildiğinde nasıl performans gösterdiğini daha iyi anlamanıza yardımcı olmak için en çok tercih edilen temsilcileri değerlendirmemize ekliyoruz. İlgili model sağlayıcının temsilcileriyle birlikte yeni modelleri LHT'lere karşı çalıştırarak başlıyoruz. Örneğin, Codex'te GPT 5.6 Sol'u, Google Antigravity'de ise Gemini 3.8 Flash'ı çalıştırdık. Bu eşleştirme, istem önbelleğe alma ve kompakt araç pencerelerinin jeton sayısını azaltabileceğini gördüğümüz için, donanım tasarımının geliştirici sonuçlarını nasıl olumlu etkilediğini gösterir.
Gelecekte bu özelliği genişleterek çeşitli model ve temsilci kombinasyonlarındaki sonuçları da vurgulayacağız. Böylece, siz ve ekibiniz için en uygun kombinasyonları keşfedebileceksiniz.
Android geliştiriciliği için tercih ettiğiniz ajanı ve modeli kullanabilmeniz önemli olduğundan bu ölçüme yatırım yapıyoruz. Önümüzdeki haftalarda sizinle daha fazla bilgi paylaşacağız.
Yeni modeller eklendi
Ayrıca, geliştirme kararlarınız için en güncel verilere sahip olmanızı sağlamak amacıyla skor tablomuzu genişletmeye devam ediyoruz. Gemini 3.8 Flash, Gemini 3.7 Flash, OpenAI'ın GPT-6'sı, Anthropic'in Fable 5.1'i, Kimi K3 ve Qwen 3.8 Max'i ekledik. OpenAI'ın GPT-6 Astra'sı% 28'lik geçme oranıyla en üst sırada yer aldı.
Geleceğe dönük planlar
Android Bench 2.0, Android geliştiricileri için yapay zekayı ölçmeye yönelik sağlam bir ortam sunar. Uzun vadeli görevleri, çok formatlı değerlendirmeyi, temsilcileri ve sürekli puanlamayı birleştirerek yapay zeka araştırma ekiplerinin daha yetenekli ve güvenilir yapay zeka kodlama yardımcıları oluşturmasını sağlamayı ve yapay zeka geliştirme seçenekleriniz konusunda size daha fazla şeffaflık sunmayı umuyoruz.
Güncellenen metodoloji ile birlikte güncellenen skor tablosuna göz atın. Geri bildirimleriniz, Android Bench'i geliştirme şeklimizi doğrudan etkiler. Bu nedenle, lütfen geri bildirimlerinizi GitHub'da ve X ile LinkedIn gibi sosyal kanallarımızda bizimle paylaşmaya devam edin.
-
 Ürün Haberleri
Bugün Android Dev Summit'te, günlük sorunları ortadan kaldırmak ve size mükemmel Android uygulamaları geliştirme konusunda daha fazla esneklik sağlamak için tasarlanmış birçok araç ve API'nin genel kullanıma sunulduğunu duyuruyoruz.
Matthew McCullough • Okuma süresi: 4 dk. -
 Ürün Haberleri
Temsilci tabanlı geliştirme hızlandıkça Android mühendisliği heyecan verici yeni bir aşamaya geçiyor: Yardımcı kod tamamlamadan, sizin yönlendirmenizle uçtan uca yürütülen temsilcilere geçiş. Kullandığınız modeller ve temsilciler konusunda tam bir seçim özgürlüğüne ve esnekliğe sahipsiniz.
Jason Buchel • Okuma süresi: 3 dk. -
 Ürün Haberleri
Android geliştiricileri olarak uygulama geliştirme için kullandığınız temsilciler, LLM'ler, araçlar ve komut satırı arayüzleri (KSA) konusunda birçok seçeneğiniz vardır. Amacımız, hangi yöntemi seçerseniz seçin güzel ve yüksek kaliteli Android uygulamaları geliştirmenize yardımcı olmaktır.
Simona Milanovic • Okuma süresi: 4 dk.
En son Android geliştirici analizlerini haftalık olarak gelen kutunuza alın.