

Android Neural Networks API (NNAPI) เป็น Android C API ที่ออกแบบมาเพื่อเรียกใช้การดำเนินการที่ต้องใช้การประมวลผลสูงสำหรับแมชชีนเลิร์นนิงในอุปกรณ์ Android NNAPI ออกแบบมาเพื่อมอบเลเยอร์พื้นฐานของฟังก์ชันการทำงานสำหรับเฟรมเวิร์กแมชชีนเลิร์นนิงระดับสูง เช่น TensorFlow Lite และ Caffe2 ซึ่งสร้างและฝึกโครงข่ายระบบประสาทเทียม API นี้พร้อมใช้งานในอุปกรณ์ Android ทั้งหมดที่ใช้ Android 8.1 (ระดับ API 27) ขึ้นไป แต่เลิกใช้งานแล้วใน Android 15
NNAPI รองรับการอนุมานโดยใช้ข้อมูลจากอุปกรณ์ Android กับโมเดลที่นักพัฒนาซอฟต์แวร์กำหนดซึ่งได้รับการฝึกไว้ก่อนหน้านี้ ตัวอย่างของการอนุมาน ได้แก่ การแยกประเภทรูปภาพ การคาดการณ์พฤติกรรมของผู้ใช้ และการเลือกคำตอบที่เหมาะสมสำหรับคำค้นหา
การอนุมานในอุปกรณ์มีประโยชน์หลายประการ ดังนี้
- เวลาในการตอบสนอง: คุณไม่จำเป็นต้องส่งคำขอผ่านการเชื่อมต่อเครือข่ายและรอการตอบกลับ ตัวอย่างเช่น การดำเนินการนี้อาจมีความสำคัญต่อแอปพลิเคชันวิดีโอที่ประมวลผลเฟรมต่อเนื่องที่มาจากกล้อง
- ความพร้อมใช้งาน: แอปพลิเคชันจะทำงานแม้จะอยู่นอกพื้นที่ครอบคลุมของเครือข่าย
- ความเร็ว: ฮาร์ดแวร์ใหม่ที่เฉพาะเจาะจงสำหรับการประมวลผลโครงข่ายประสาทเทียมช่วยให้การประมวลผลเร็วขึ้นอย่างมากเมื่อเทียบกับการใช้ CPU อเนกประสงค์เพียงอย่างเดียว
- ความเป็นส่วนตัว: ข้อมูลจะไม่ถูกส่งออกไปนอกอุปกรณ์ Android
- ค่าใช้จ่าย: ไม่จำเป็นต้องใช้เซิร์ฟเวอร์ฟาร์มเมื่อการประมวลผลทั้งหมดดำเนินการในอุปกรณ์ Android
นอกจากนี้ยังมีข้อดีข้อเสียที่นักพัฒนาแอปควรคำนึงถึง ดังนี้
- การใช้ทรัพยากรระบบ: การประเมินโครงข่ายระบบประสาทเทียมเกี่ยวข้องกับการประมวลผลจำนวนมาก ซึ่งอาจเพิ่มการใช้พลังงานแบตเตอรี่ คุณควรพิจารณาตรวจสอบประสิทธิภาพแบตเตอรี่หากเป็นข้อกังวลสำหรับแอป โดยเฉพาะอย่างยิ่งสำหรับการคำนวณที่ใช้เวลานาน
- ขนาดแอปพลิเคชัน: ให้ความสำคัญกับขนาดของโมเดล โมเดลอาจใช้พื้นที่หลายเมกะไบต์ หากการรวมโมเดลขนาดใหญ่ไว้ใน APK จะส่งผลกระทบต่อผู้ใช้มากเกินไป คุณอาจพิจารณาดาวน์โหลดโมเดลหลังจากติดตั้งแอป ใช้โมเดลขนาดเล็กลง หรือเรียกใช้การประมวลผลในระบบคลาวด์ NNAPI ไม่มีฟังก์ชันการทำงานสำหรับโมเดลที่ทำงานในระบบคลาวด์
ดูตัวอย่าง Android Neural Networks API เพื่อดูตัวอย่างวิธีใช้ NNAPI
ทำความเข้าใจรันไทม์ของ Neural Networks API
NNAPI มีไว้เพื่อให้ไลบรารี เฟรมเวิร์ก และเครื่องมือแมชชีนเลิร์นนิงเรียกใช้ ซึ่งช่วยให้นักพัฒนาแอปฝึกโมเดลนอกอุปกรณ์และติดตั้งใช้งานในอุปกรณ์ Android ได้ โดยปกติแล้ว แอปจะไม่ใช้ NNAPI โดยตรง แต่จะใช้เฟรมเวิร์กแมชชีนเลิร์นนิงระดับสูงกว่าแทน เฟรมเวิร์กเหล่านี้อาจใช้ NNAPI เพื่อดำเนินการอนุมานที่เร่งด้วยฮาร์ดแวร์ในอุปกรณ์ที่รองรับ
รันไทม์ของโครงข่ายระบบประสาทเทียมของ Android สามารถกระจายภาระงานการประมวลผลไปยังโปรเซสเซอร์ในอุปกรณ์ที่พร้อมใช้งานได้อย่างมีประสิทธิภาพ ซึ่งรวมถึงฮาร์ดแวร์โครงข่ายระบบประสาทเทียมโดยเฉพาะ หน่วยประมวลผลกราฟิก (GPU) และตัวประมวลผลสัญญาณดิจิทัล (DSP) โดยอิงตามข้อกำหนดของแอปและความสามารถของฮาร์ดแวร์ในอุปกรณ์ Android
สำหรับอุปกรณ์ Android ที่ไม่มีไดรเวอร์ของผู้ให้บริการเฉพาะ รันไทม์ NNAPI จะดำเนินการตามคำขอใน CPU
รูปที่ 1 แสดงสถาปัตยกรรมระบบระดับสูงสำหรับ NNAPI

โมเดลการเขียนโปรแกรม Neural Networks API
หากต้องการทำการคำนวณโดยใช้ NNAPI คุณต้องสร้างกราฟแบบมีทิศทางที่กำหนดการคำนวณที่จะทำก่อน กราฟการคำนวณนี้เมื่อรวมกับข้อมูลอินพุต (เช่น น้ำหนักและอคติที่ส่งต่อมาจากเฟรมเวิร์กแมชชีนเลิร์นนิง) จะสร้างโมเดลสำหรับการประเมินรันไทม์ของ NNAPI
NNAPI ใช้การแยกข้อมูลหลัก 4 รายการ ได้แก่
- โมเดล: กราฟการคำนวณของการดำเนินการทางคณิตศาสตร์และค่าคงที่ที่เรียนรู้ผ่านกระบวนการฝึก การดำเนินการเหล่านี้มีไว้สำหรับโครงข่ายระบบประสาทเทียมโดยเฉพาะ ซึ่งรวมถึงคอนโวลูชัน 2 มิติ (2D), การเปิดใช้งานแบบโลจิสติก (ซิกมอยด์), การเปิดใช้งานแบบเชิงเส้นที่ได้รับการแก้ไข (ReLU) และอื่นๆ การสร้างโมเดลเป็นการดำเนินการแบบซิงโครนัส
เมื่อสร้างเรียบร้อยแล้ว คุณจะนำไปใช้ซ้ำในชุดข้อความและการรวบรวมต่างๆ ได้
ใน NNAPI โมเดลจะแสดงเป็นอินสแตนซ์
ANeuralNetworksModel - การคอมไพล์: แสดงการกำหนดค่าสำหรับการคอมไพล์โมเดล NNAPI เป็นโค้ดระดับต่ำกว่า การสร้างการคอมไพล์เป็นการดำเนินการแบบซิงโครนัส เมื่อสร้างสำเร็จแล้ว คุณจะใช้ซ้ำในชุดข้อความและการดำเนินการต่างๆ ได้ ใน NNAPI การคอมไพล์แต่ละครั้งจะแสดงเป็นอินสแตนซ์
ANeuralNetworksCompilation - หน่วยความจำ: แสดงหน่วยความจำที่ใช้ร่วมกัน ไฟล์ที่แมปหน่วยความจำ และบัฟเฟอร์หน่วยความจำที่คล้ายกัน การใช้บัฟเฟอร์หน่วยความจำช่วยให้รันไทม์ NNAPI โอนข้อมูลไปยังไดรเวอร์ได้อย่างมีประสิทธิภาพมากขึ้น โดยปกติแล้ว แอปจะสร้างบัฟเฟอร์หน่วยความจำที่ใช้ร่วมกัน 1 รายการซึ่งมี Tensor ทุกรายการที่จำเป็นต่อการกำหนดโมเดล นอกจากนี้ คุณยังใช้บัฟเฟอร์หน่วยความจำเพื่อจัดเก็บอินพุตและเอาต์พุตสำหรับอินสแตนซ์การดำเนินการได้ด้วย ใน NNAPI
บัฟเฟอร์หน่วยความจำแต่ละรายการจะแสดงเป็นอินสแตนซ์
ANeuralNetworksMemory การดำเนินการ: อินเทอร์เฟซสำหรับการใช้โมเดล NNAPI กับชุดอินพุตและรวบรวมผลลัพธ์ การดำเนินการสามารถทำได้ทั้งแบบซิงโครนัสหรือแบบอะซิงโครนัส
สำหรับการดำเนินการแบบอะซิงโครนัส เทรดหลายรายการสามารถรอการดำเนินการเดียวกันได้ เมื่อการดำเนินการนี้เสร็จสมบูรณ์ ระบบจะปล่อยเทรดทั้งหมด
ใน NNAPI การดำเนินการแต่ละครั้งจะแสดงเป็นอินสแตนซ์
ANeuralNetworksExecution
รูปที่ 2 แสดงขั้นตอนการเขียนโปรแกรมพื้นฐาน
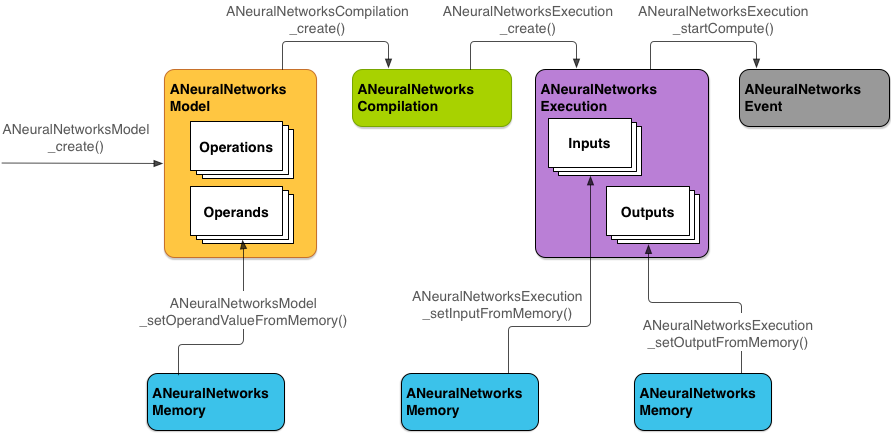
ส่วนที่เหลือของส่วนนี้จะอธิบายขั้นตอนในการตั้งค่าโมเดล NNAPI เพื่อทำการคำนวณ คอมไพล์โมเดล และเรียกใช้โมเดลที่คอมไพล์แล้ว
ให้สิทธิ์เข้าถึงข้อมูลฝึกฝน
ข้อมูลน้ำหนักและอคติที่ฝึกแล้วน่าจะจัดเก็บไว้ในไฟล์ หากต้องการให้รันไทม์ NNAPI เข้าถึงข้อมูลนี้ได้อย่างมีประสิทธิภาพ ให้สร้างอินสแตนซ์ ANeuralNetworksMemory โดยเรียกใช้ฟังก์ชัน ANeuralNetworksMemory_createFromFd() และส่งผ่านตัวบอกไฟล์ของไฟล์ข้อมูลที่เปิดอยู่ นอกจากนี้ คุณยังระบุแฟล็กการป้องกันหน่วยความจำและออฟเซ็ตที่ขอบเขตหน่วยความจำที่ใช้ร่วมกันเริ่มต้นในไฟล์ด้วย
// Create a memory buffer from the file that contains the trained data
ANeuralNetworksMemory* mem1 = NULL;
int fd = open("training_data", O_RDONLY);
ANeuralNetworksMemory_createFromFd(file_size, PROT_READ, fd, 0, &mem1);
แม้ว่าในตัวอย่างนี้เราจะใช้อินสแตนซ์ ANeuralNetworksMemory เพียงรายการเดียวสำหรับน้ำหนักทั้งหมด แต่คุณสามารถใช้อินสแตนซ์ ANeuralNetworksMemory มากกว่า 1 รายการสำหรับไฟล์หลายไฟล์ได้
ใช้บัฟเฟอร์ฮาร์ดแวร์แบบเนทีฟ
คุณสามารถใช้บัฟเฟอร์ฮาร์ดแวร์แบบเนทีฟสำหรับอินพุต เอาต์พุต และค่าตัวถูกดำเนินการคงที่ของโมเดล ในบางกรณี ตัวเร่ง NNAPI สามารถเข้าถึงออบเจ็กต์ AHardwareBuffer ได้โดยที่ไดรเวอร์ไม่จำเป็นต้องคัดลอกข้อมูล AHardwareBuffer มีการกำหนดค่าที่แตกต่างกันมากมาย และตัวเร่ง NNAPI บางตัวอาจไม่รองรับการกำหนดค่าทั้งหมดเหล่านี้ เนื่องจากข้อจำกัดนี้ โปรดดูข้อจำกัดที่ระบุไว้ในเอกสารอ้างอิง ANeuralNetworksMemory_createFromAHardwareBuffer และทดสอบล่วงหน้าในอุปกรณ์เป้าหมายเพื่อให้แน่ใจว่าการคอมไพล์และการดำเนินการที่ใช้ AHardwareBuffer ทำงานตามที่คาดไว้ โดยใช้การกำหนดอุปกรณ์เพื่อระบุตัวเร่ง
หากต้องการอนุญาตให้รันไทม์ NNAPI เข้าถึงออบเจ็กต์ AHardwareBuffer ให้สร้างอินสแตนซ์ ANeuralNetworksMemory โดยเรียกใช้ฟังก์ชัน ANeuralNetworksMemory_createFromAHardwareBuffer และส่งออบเจ็กต์ AHardwareBuffer ดังที่แสดงในตัวอย่างโค้ดต่อไปนี้
// Configure and create AHardwareBuffer object
AHardwareBuffer_Desc desc = ...
AHardwareBuffer* ahwb = nullptr;
AHardwareBuffer_allocate(&desc, &ahwb);

// Create ANeuralNetworksMemory from AHardwareBuffer
ANeuralNetworksMemory* mem2 = NULL;
ANeuralNetworksMemory_createFromAHardwareBuffer(ahwb, &mem2);
เมื่อ NNAPI ไม่จำเป็นต้องเข้าถึงออบเจ็กต์ AHardwareBuffer อีกต่อไป ให้ปล่อยอินสแตนซ์ ANeuralNetworksMemory ที่เกี่ยวข้อง ดังนี้
ANeuralNetworksMemory_free(mem2);
หมายเหตุ:
- คุณใช้
AHardwareBufferได้เฉพาะกับทั้งบัฟเฟอร์เท่านั้น โดยจะใช้กับพารามิเตอร์ARectไม่ได้ - รันไทม์ NNAPI จะไม่ล้างบัฟเฟอร์ คุณต้องตรวจสอบว่าบัฟเฟอร์อินพุตและเอาต์พุตเข้าถึงได้ก่อนที่จะกำหนดเวลาการดำเนินการ
- ระบบไม่รองรับตัวบอกไฟล์ของรั้วการซิงค์
- สำหรับ
AHardwareBufferที่มีรูปแบบและบิตการใช้งานเฉพาะของผู้ให้บริการ การติดตั้งใช้งานของผู้ให้บริการจะเป็นตัวกำหนดว่าไคลเอ็นต์หรือไดรเวอร์มีหน้าที่รับผิดชอบในการล้างแคชหรือไม่
รุ่น
โมเดลคือหน่วยพื้นฐานของการประมวลผลใน NNAPI แต่ละรูปแบบจะกำหนดโดยตัวถูกดำเนินการและการดำเนินการอย่างน้อย 1 รายการ
ตัวถูกดำเนินการ
ตัวถูกดำเนินการคือออบเจ็กต์ข้อมูลที่ใช้ในการกำหนดกราฟ ซึ่งรวมถึงอินพุตและเอาต์พุตของโมเดล โหนดกลางที่มีข้อมูลที่ส่งจากกระบวนการหนึ่งไปยังอีกกระบวนการหนึ่ง และค่าคงที่ที่ส่งไปยังกระบวนการเหล่านี้
ตัวถูกดำเนินการที่เพิ่มลงในโมเดล NNAPI ได้มี 2 ประเภท ได้แก่ สเกลาร์และเทนเซอร์
สเกลาร์แสดงค่าเดียว NNAPI รองรับค่าสเกลาร์ในรูปแบบบูลีน, จุดลอยตัว 16 บิต, จุดลอยตัว 32 บิต, จำนวนเต็ม 32 บิต และจำนวนเต็ม 32 บิตแบบไม่มีเครื่องหมาย
การดำเนินการส่วนใหญ่ใน NNAPI เกี่ยวข้องกับเทนเซอร์ เทนเซอร์คืออาร์เรย์ n มิติ NNAPI รองรับเทนเซอร์ที่มีค่าจุดลอยตัว 16 บิต, จุดลอยตัว 32 บิต, Quantized 8 บิต, Quantized 16 บิต, จำนวนเต็ม 32 บิต และบูลีน 8 บิต
ตัวอย่างเช่น รูปที่ 3 แสดงโมเดลที่มีการดำเนินการ 2 อย่าง ได้แก่ การบวกตามด้วยการคูณ โมเดลจะรับเทนเซอร์อินพุตและสร้างเทนเซอร์เอาต์พุต 1 รายการ
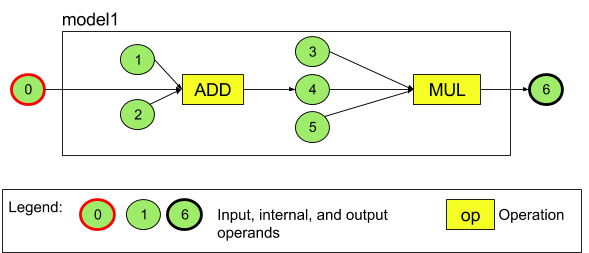
โมเดลด้านบนมีตัวถูกดำเนินการ 7 ตัว ตัวถูกดำเนินการเหล่านี้จะได้รับการระบุโดยนัยตามดัชนีของลำดับที่เพิ่มลงในโมเดล ตัวถูกดำเนินการแรกที่เพิ่มจะมีดัชนีเป็น 0 ตัวถูกดำเนินการที่ 2 มีดัชนีเป็น 1 เป็นต้น ตัวถูกดำเนินการ 1, 2, 3 และ 5 เป็นตัวถูกดำเนินการค่าคงที่
คุณจะเพิ่มตัวถูกดำเนินการในลำดับใดก็ได้ ตัวอย่างเช่น ตัวถูกดำเนินการเอาต์พุตโมเดลอาจเป็นตัวถูกดำเนินการแรกที่เพิ่มเข้ามา ส่วนสำคัญคือการใช้ค่าดัชนีที่ถูกต้องเมื่ออ้างอิงถึงตัวถูกดำเนินการ
ตัวถูกดำเนินการมีประเภท ซึ่งจะระบุเมื่อเพิ่มลงในโมเดล
ไม่สามารถใช้ตัวถูกดำเนินการเป็นทั้งอินพุตและเอาต์พุตของโมเดล
ตัวถูกดำเนินการทุกตัวต้องเป็นอินพุตโมเดล ค่าคงที่ หรือตัวถูกดำเนินการเอาต์พุตของการดำเนินการเดียวเท่านั้น
ดูข้อมูลเพิ่มเติมเกี่ยวกับการใช้ตัวถูกดำเนินการได้ที่ข้อมูลเพิ่มเติมเกี่ยวกับตัวถูกดำเนินการ
การดำเนินการ
การดำเนินการจะระบุการคำนวณที่จะทำ การดำเนินการแต่ละรายการประกอบด้วยองค์ประกอบต่อไปนี้
- ประเภทการดำเนินการ (เช่น การบวก การคูณ การคอนโวลูชัน)
- รายการดัชนีของตัวถูกดำเนินการที่การดำเนินการใช้เป็นอินพุต และ
- รายการดัชนีของตัวถูกดำเนินการที่การดำเนินการใช้สำหรับเอาต์พุต
ลำดับในรายการเหล่านี้มีความสำคัญ โปรดดูเอกสารอ้างอิง NNAPI API สำหรับอินพุตและเอาต์พุตที่คาดไว้ของการดำเนินการแต่ละประเภท
คุณต้องเพิ่มตัวถูกดำเนินการที่การดำเนินการใช้หรือสร้างลงในโมเดลก่อนที่จะเพิ่มการดำเนินการ
ลำดับที่คุณเพิ่มการดำเนินการไม่มีความสำคัญ NNAPI อาศัยทรัพยากร Dependency ที่สร้างขึ้นโดยกราฟการคํานวณของตัวถูกดําเนินการและการดําเนินการเพื่อกําหนดลําดับการดําเนินการ
การดำเนินการที่ NNAPI รองรับจะสรุปไว้ในตารางด้านล่าง
ปัญหาที่ทราบในระดับ API 28: เมื่อส่งผ่าน ANEURALNETWORKS_TENSOR_QUANT8_ASYMM Tensor ไปยังการดำเนินการ ANEURALNETWORKS_PAD ซึ่งพร้อมใช้งานใน Android 9 (ระดับ API 28) ขึ้นไป เอาต์พุตจาก NNAPI อาจไม่ตรงกับเอาต์พุตจากเฟรมเวิร์กแมชชีนเลิร์นนิงระดับสูงกว่า เช่น TensorFlow Lite คุณควรส่งเฉพาะ ANEURALNETWORKS_TENSOR_FLOAT32 แทน
ปัญหานี้ได้รับการแก้ไขแล้วใน Android 10 (ระดับ API 29) ขึ้นไป
สร้างโมเดล
ในตัวอย่างต่อไปนี้ เราจะสร้างโมเดลการดำเนินการ 2 รายการที่พบในรูปที่ 3
หากต้องการสร้างโมเดล ให้ทำตามขั้นตอนต่อไปนี้
เรียกใช้ฟังก์ชัน
ANeuralNetworksModel_create()เพื่อกำหนดโมเดลที่ว่างเปล่าANeuralNetworksModel* model = NULL; ANeuralNetworksModel_create(&model);
เพิ่มตัวถูกดำเนินการลงในโมเดลโดยเรียกใช้
ANeuralNetworks_addOperand()ประเภทข้อมูลจะกำหนดโดยใช้โครงสร้างข้อมูลANeuralNetworksOperandType// In our example, all our tensors are matrices of dimension [3][4] ANeuralNetworksOperandType tensor3x4Type; tensor3x4Type.type = ANEURALNETWORKS_TENSOR_FLOAT32; tensor3x4Type.scale = 0.f; // These fields are used for quantized tensors tensor3x4Type.zeroPoint = 0; // These fields are used for quantized tensors tensor3x4Type.dimensionCount = 2; uint32_t dims[2] = {3, 4}; tensor3x4Type.dimensions = dims;
// We also specify operands that are activation function specifiers ANeuralNetworksOperandType activationType; activationType.type = ANEURALNETWORKS_INT32; activationType.scale = 0.f; activationType.zeroPoint = 0; activationType.dimensionCount = 0; activationType.dimensions = NULL;
// Now we add the seven operands, in the same order defined in the diagram ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 0 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 1 ANeuralNetworksModel_addOperand(model, &activationType); // operand 2 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 3 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 4 ANeuralNetworksModel_addOperand(model, &activationType); // operand 5 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 6สำหรับตัวถูกดำเนินการที่มีค่าคงที่ เช่น น้ำหนักและอคติที่แอปของคุณได้รับจากกระบวนการฝึก ให้ใช้ฟังก์ชัน
ANeuralNetworksModel_setOperandValue()และANeuralNetworksModel_setOperandValueFromMemory()ในตัวอย่างต่อไปนี้ เราตั้งค่าคงที่จากไฟล์ข้อมูลฝึกฝนที่สอดคล้องกับบัฟเฟอร์หน่วยความจำที่เราสร้างขึ้นในให้สิทธิ์เข้าถึงข้อมูลการฝึก
// In our example, operands 1 and 3 are constant tensors whose values were
// established during the training process
const int sizeOfTensor = 3 * 4 * 4;    // The formula for size calculation is dim0 * dim1 * elementSize
ANeuralNetworksModel_setOperandValueFromMemory(model, 1, mem1, 0, sizeOfTensor);
ANeuralNetworksModel_setOperandValueFromMemory(model, 3, mem1, sizeOfTensor, sizeOfTensor);


// We set the values of the activation operands, in our example operands 2 and 5
int32_t noneValue = ANEURALNETWORKS_FUSED_NONE;
ANeuralNetworksModel_setOperandValue(model, 2, &noneValue, sizeof(noneValue));
ANeuralNetworksModel_setOperandValue(model, 5, &noneValue, sizeof(noneValue));
สำหรับการดำเนินการแต่ละรายการในกราฟแบบมีทิศทางที่คุณต้องการคำนวณ ให้เพิ่มการดำเนินการลงในโมเดลโดยเรียกใช้ฟังก์ชัน
ANeuralNetworksModel_addOperation()แอปของคุณต้องระบุข้อมูลต่อไปนี้เป็นพารามิเตอร์สำหรับการเรียกนี้
- ประเภทการดำเนินการ
- จำนวนค่าอินพุต
- อาร์เรย์ของดัชนีสำหรับตัวถูกดำเนินการอินพุต
- จำนวนค่าเอาต์พุต
- อาร์เรย์ของดัชนีสำหรับตัวถูกดำเนินการเอาต์พุต
โปรดทราบว่าคุณไม่สามารถใช้ตัวถูกดำเนินการสำหรับทั้งอินพุตและเอาต์พุตของการดำเนินการเดียวกันได้
// We have two operations in our example
// The first consumes operands 1, 0, 2, and produces operand 4
uint32_t addInputIndexes[3] = {1, 0, 2};
uint32_t addOutputIndexes[1] = {4};
ANeuralNetworksModel_addOperation(model, ANEURALNETWORKS_ADD, 3, addInputIndexes, 1, addOutputIndexes);


// The second consumes operands 3, 4, 5, and produces operand 6
uint32_t multInputIndexes[3] = {3, 4, 5};
uint32_t multOutputIndexes[1] = {6};
ANeuralNetworksModel_addOperation(model, ANEURALNETWORKS_MUL, 3, multInputIndexes, 1, multOutputIndexes);
ระบุตัวถูกดำเนินการที่โมเดลควรใช้เป็นอินพุตและเอาต์พุตโดยเรียกใช้ฟังก์ชัน
ANeuralNetworksModel_identifyInputsAndOutputs()// Our model has one input (0) and one output (6) uint32_t modelInputIndexes[1] = {0}; uint32_t modelOutputIndexes[1] = {6}; ANeuralNetworksModel_identifyInputsAndOutputs(model, 1, modelInputIndexes, 1 modelOutputIndexes);
ระบุหรือไม่ก็ได้ว่าอนุญาตให้คำนวณ
ANEURALNETWORKS_TENSOR_FLOAT32โดยมีช่วงหรือความแม่นยำต่ำเท่ากับรูปแบบจุดลอยตัว 16 บิตของ IEEE 754 หรือไม่โดยเรียกใช้ANeuralNetworksModel_relaxComputationFloat32toFloat16()เรียกใช้
ANeuralNetworksModel_finish()เพื่อสรุปคำจำกัดความของโมเดล หากไม่มีข้อผิดพลาด ฟังก์ชันนี้จะแสดงรหัสผลลัพธ์เป็นANEURALNETWORKS_NO_ERRORANeuralNetworksModel_finish(model);
เมื่อสร้างโมเดลแล้ว คุณจะคอมไพล์โมเดลกี่ครั้งก็ได้ และเรียกใช้การคอมไพล์แต่ละครั้งกี่ครั้งก็ได้
ควบคุมโฟลว์
หากต้องการรวมขั้นตอนการควบคุมในโมเดล NNAPI ให้ทำดังนี้
สร้างกราฟย่อยการดำเนินการที่เกี่ยวข้อง (กราฟย่อย
thenและelseสำหรับคำสั่งIF, กราฟย่อยconditionและbodyสำหรับลูปWHILE) เป็นโมเดลANeuralNetworksModel*แบบสแตนด์อโลนANeuralNetworksModel* thenModel = makeThenModel(); ANeuralNetworksModel* elseModel = makeElseModel();
สร้างตัวถูกดำเนินการที่อ้างอิงโมเดลเหล่านั้นภายในโมเดลที่มีโฟลว์การควบคุม ดังนี้
ANeuralNetworksOperandType modelType = {
    .type = ANEURALNETWORKS_MODEL,
};
ANeuralNetworksModel_addOperand(model, &modelType);  // kThenOperandIndex
ANeuralNetworksModel_addOperand(model, &modelType);  // kElseOperandIndex
ANeuralNetworksModel_setOperandValueFromModel(model, kThenOperandIndex, &thenModel);
ANeuralNetworksModel_setOperandValueFromModel(model, kElseOperandIndex, &elseModel);
เพิ่มการดำเนินการโฟลว์การควบคุมดังนี้
uint32_t inputs[] = {kConditionOperandIndex,
                     kThenOperandIndex,
                     kElseOperandIndex,
                     kInput1, kInput2, kInput3};
uint32_t outputs[] = {kOutput1, kOutput2};
ANeuralNetworksModel_addOperation(model, ANEURALNETWORKS_IF,
                                  std::size(inputs), inputs,
                                  std::size(output), outputs);
การรวบรวม
ขั้นตอนการคอมไพล์จะกำหนดโปรเซสเซอร์ที่จะใช้เรียกใช้โมเดล และขอให้ไดรเวอร์ที่เกี่ยวข้องเตรียมพร้อมสำหรับการเรียกใช้ ซึ่งอาจรวมถึงการสร้างรหัสเครื่องที่เฉพาะเจาะจงสำหรับโปรเซสเซอร์ที่โมเดลจะทำงาน
หากต้องการคอมไพล์โมเดล ให้ทำตามขั้นตอนต่อไปนี้
เรียกใช้ฟังก์ชัน
ANeuralNetworksCompilation_create()เพื่อสร้างอินสแตนซ์การคอมไพล์ใหม่// Compile the model ANeuralNetworksCompilation* compilation; ANeuralNetworksCompilation_create(model, &compilation);
คุณสามารถใช้การกำหนดอุปกรณ์เพื่อเลือกอุปกรณ์ที่จะดำเนินการอย่างชัดเจนได้ (ไม่บังคับ)
คุณสามารถเลือกกำหนดวิธีที่รันไทม์จะแลกเปลี่ยนระหว่างการใช้พลังงานแบตเตอรี่และความเร็วในการดำเนินการได้ โดยเรียกใช้
ANeuralNetworksCompilation_setPreference()// Ask to optimize for low power consumption ANeuralNetworksCompilation_setPreference(compilation, ANEURALNETWORKS_PREFER_LOW_POWER);
ค่ากำหนดที่คุณระบุได้มีดังนี้
ANEURALNETWORKS_PREFER_LOW_POWER: ต้องการดำเนินการในลักษณะที่ลดการใช้แบตเตอรี่ ซึ่งเป็นสิ่งที่พึงประสงค์สำหรับการคอมไพล์ที่ดำเนินการบ่อยครั้งANEURALNETWORKS_PREFER_FAST_SINGLE_ANSWER: ต้องการแสดงผลลัพธ์เดียวโดยเร็วที่สุด แม้ว่าจะทำให้ใช้พลังงานมากขึ้นก็ตาม ทั้งนี้ ตัวเลือกนี้คือค่าเริ่มต้นANEURALNETWORKS_PREFER_SUSTAINED_SPEED: ต้องการเพิ่มอัตราการส่งข้อมูลของเฟรมที่ต่อเนื่องกันให้สูงสุด เช่น เมื่อประมวลผลเฟรมที่ต่อเนื่องกันซึ่งมาจากกล้อง
คุณสามารถเลือกตั้งค่าการแคชการคอมไพล์ได้โดยเรียกใช้
ANeuralNetworksCompilation_setCaching// Set up compilation caching ANeuralNetworksCompilation_setCaching(compilation, cacheDir, token);
ใช้
getCodeCacheDir()สำหรับcacheDirtokenที่ระบุต้องไม่ซ้ำกันสำหรับแต่ละโมเดลภายในแอปพลิเคชันสรุปคำจำกัดความของการคอมไพล์โดยเรียกใช้
ANeuralNetworksCompilation_finish()หากไม่มีข้อผิดพลาด ฟังก์ชันนี้จะแสดงรหัสผลลัพธ์เป็นANEURALNETWORKS_NO_ERRORANeuralNetworksCompilation_finish(compilation);
การค้นหาและการมอบหมายอุปกรณ์
ในอุปกรณ์ Android ที่ใช้ Android 10 (ระดับ API 29) ขึ้นไป NNAPI จะมีฟังก์ชันที่ช่วยให้ไลบรารีและแอปเฟรมเวิร์กแมชชีนเลิร์นนิงได้รับข้อมูลเกี่ยวกับอุปกรณ์ที่พร้อมใช้งานและระบุอุปกรณ์ที่จะใช้สำหรับการดำเนินการ การให้ข้อมูลเกี่ยวกับอุปกรณ์ที่พร้อมใช้งานช่วยให้แอปได้รับไดรเวอร์เวอร์ชันที่แน่นอนซึ่งพบในอุปกรณ์เพื่อหลีกเลี่ยงความไม่เข้ากันที่ทราบ การให้แอปสามารถระบุอุปกรณ์ที่จะเรียกใช้ส่วนต่างๆ ของโมเดลจะช่วยเพิ่มประสิทธิภาพแอปสำหรับอุปกรณ์ Android ที่ติดตั้งใช้งานได้
การค้นหาอุปกรณ์
ใช้
ANeuralNetworks_getDeviceCount
เพื่อดูจำนวนอุปกรณ์ที่พร้อมใช้งาน สำหรับอุปกรณ์แต่ละเครื่อง ให้ใช้
ANeuralNetworks_getDevice
เพื่อตั้งค่าอินสแตนซ์ ANeuralNetworksDevice เป็นการอ้างอิงถึงอุปกรณ์นั้น
เมื่อมีการอ้างอิงอุปกรณ์แล้ว คุณจะดูข้อมูลเพิ่มเติมเกี่ยวกับอุปกรณ์นั้นได้โดยใช้ฟังก์ชันต่อไปนี้
ANeuralNetworksDevice_getFeatureLevelANeuralNetworksDevice_getNameANeuralNetworksDevice_getTypeANeuralNetworksDevice_getVersion
การมอบหมายอุปกรณ์
ใช้
ANeuralNetworksModel_getSupportedOperationsForDevices
เพื่อดูว่าการดำเนินการใดของโมเดลที่สามารถเรียกใช้ในอุปกรณ์ที่เฉพาะเจาะจงได้
หากต้องการควบคุมตัวเร่งที่จะใช้สำหรับการดำเนินการ ให้เรียกใช้
ANeuralNetworksCompilation_createForDevices
แทน ANeuralNetworksCompilation_create
ใช้ออบเจ็กต์ ANeuralNetworksCompilation ที่ได้ตามปกติ
ฟังก์ชันจะแสดงข้อผิดพลาดหากโมเดลที่ระบุมีการดำเนินการที่อุปกรณ์ที่เลือกไม่รองรับ
หากมีการระบุอุปกรณ์หลายเครื่อง รันไทม์จะรับผิดชอบในการกระจายงานไปยังอุปกรณ์ต่างๆ
การใช้งาน NNAPI CPU จะแสดงด้วย ANeuralNetworksDevice ที่มีชื่อว่า nnapi-reference และประเภท ANEURALNETWORKS_DEVICE_TYPE_CPU เช่นเดียวกับอุปกรณ์อื่นๆ เมื่อเรียกใช้ ANeuralNetworksCompilation_createForDevices ระบบจะไม่ใช้การติดตั้งใช้งาน CPU เพื่อจัดการกรณีที่การคอมไพล์และการดำเนินการโมเดลไม่สำเร็จ
แอปพลิเคชันมีหน้าที่แบ่งพาร์ติชันโมเดลเป็นโมเดลย่อยที่สามารถทำงานบนอุปกรณ์ที่ระบุได้ แอปพลิเคชันที่ไม่จำเป็นต้องทำการแบ่งพาร์ติชันด้วยตนเองควรเรียกใช้ ANeuralNetworksCompilation_create ที่ง่ายกว่าต่อไปเพื่อใช้อุปกรณ์ที่พร้อมใช้งานทั้งหมด (รวมถึง CPU) เพื่อเร่งความเร็วโมเดล หากอุปกรณ์ที่คุณระบุโดยใช้ ANeuralNetworksCompilation_createForDevices ไม่รองรับโมเดลอย่างเต็มรูปแบบ ระบบจะแสดงผล ANEURALNETWORKS_BAD_DATA
การแบ่งพาร์ติชันโมเดล
เมื่อมีอุปกรณ์หลายเครื่องที่ใช้โมเดลได้ รันไทม์ NNAPI จะกระจายงานไปยังอุปกรณ์ต่างๆ เช่น หากมีการระบุอุปกรณ์มากกว่า 1 เครื่องให้กับ ANeuralNetworksCompilation_createForDevices ระบบจะพิจารณาอุปกรณ์ทั้งหมดที่ระบุเมื่อจัดสรรงาน โปรดทราบว่าหากอุปกรณ์ CPU ไม่อยู่ในรายการ ระบบจะปิดใช้การดำเนินการ CPU เมื่อใช้ ANeuralNetworksCompilation_create ระบบจะพิจารณาอุปกรณ์ที่พร้อมใช้งานทั้งหมด รวมถึง CPU
การกระจายจะดำเนินการโดยเลือกจากรายการอุปกรณ์ที่พร้อมใช้งานสำหรับการดำเนินการแต่ละอย่างในโมเดล อุปกรณ์ที่รองรับการดำเนินการ และประกาศประสิทธิภาพที่ดีที่สุด เช่น เวลาดำเนินการที่เร็วที่สุดหรือการใช้พลังงานต่ำที่สุด ทั้งนี้ขึ้นอยู่กับค่ากำหนดการดำเนินการที่ไคลเอ็นต์ระบุ อัลกอริทึมการแบ่งพาร์ติชันนี้ไม่ได้พิจารณาถึงความไม่มีประสิทธิภาพที่อาจเกิดขึ้นจาก IO ระหว่างโปรเซสเซอร์ต่างๆ ดังนั้นเมื่อระบุโปรเซสเซอร์หลายตัว (ไม่ว่าจะระบุอย่างชัดเจนเมื่อใช้ ANeuralNetworksCompilation_createForDevices หรือระบุโดยนัยเมื่อใช้ ANeuralNetworksCompilation_create) คุณจึงควรสร้างโปรไฟล์แอปพลิเคชันที่ได้
หากต้องการทำความเข้าใจวิธีที่ NNAPI แบ่งพาร์ติชันโมเดลของคุณ ให้ตรวจสอบบันทึกของ Android เพื่อหาข้อความ (ที่ระดับ INFO พร้อมแท็ก ExecutionPlan) ดังนี้
ModelBuilder::findBestDeviceForEachOperation(op-name): device-index
op-name คือชื่อที่สื่อความหมายของการดำเนินการในกราฟ และ device-index คือดัชนีของอุปกรณ์ที่เป็นไปได้ในรายการอุปกรณ์
รายการนี้เป็นอินพุตที่ระบุให้กับ ANeuralNetworksCompilation_createForDevices หรือหากใช้ ANeuralNetworksCompilation_createForDevices จะเป็นรายการอุปกรณ์ที่แสดงผลเมื่อทำซ้ำในอุปกรณ์ทั้งหมดโดยใช้ ANeuralNetworks_getDeviceCount และ ANeuralNetworks_getDevice
ข้อความ (ที่ระดับ INFO พร้อมแท็ก ExecutionPlan) มีดังนี้
ModelBuilder::partitionTheWork: only one best device: device-name
ข้อความนี้บ่งบอกว่ากราฟทั้งหมดได้รับการเร่งความเร็วในอุปกรณ์ device-name แล้ว
การลงมือปฏิบัติ
ขั้นตอนการดำเนินการจะใช้โมเดลกับชุดอินพุตและจัดเก็บเอาต์พุตการคำนวณไว้ในบัฟเฟอร์ของผู้ใช้หรือพื้นที่หน่วยความจำอย่างน้อย 1 รายการที่แอปจัดสรรไว้
หากต้องการเรียกใช้โมเดลที่คอมไพล์แล้ว ให้ทำตามขั้นตอนต่อไปนี้
เรียกใช้ฟังก์ชัน
ANeuralNetworksExecution_create()เพื่อสร้างอินสแตนซ์การดำเนินการใหม่// Run the compiled model against a set of inputs ANeuralNetworksExecution* run1 = NULL; ANeuralNetworksExecution_create(compilation, &run1);
ระบุตำแหน่งที่แอปอ่านค่าอินพุตสำหรับการคำนวณ แอปของคุณสามารถอ่านค่าอินพุตจากบัฟเฟอร์ของผู้ใช้หรือพื้นที่หน่วยความจำที่จัดสรรไว้ได้โดยเรียกใช้
ANeuralNetworksExecution_setInput()หรือANeuralNetworksExecution_setInputFromMemory()ตามลำดับ// Set the single input to our sample model. Since it is small, we won't use a memory buffer float32 myInput[3][4] = { ...the data... }; ANeuralNetworksExecution_setInput(run1, 0, NULL, myInput, sizeof(myInput));
ระบุตำแหน่งที่แอปจะเขียนค่าเอาต์พุต แอปของคุณสามารถเขียนค่าเอาต์พุตลงในบัฟเฟอร์ของผู้ใช้หรือพื้นที่หน่วยความจำที่จัดสรรไว้ได้โดยเรียกใช้
ANeuralNetworksExecution_setOutput()หรือANeuralNetworksExecution_setOutputFromMemory()ตามลำดับ// Set the output float32 myOutput[3][4]; ANeuralNetworksExecution_setOutput(run1, 0, NULL, myOutput, sizeof(myOutput));
กำหนดเวลาให้การดำเนินการเริ่มต้นโดยเรียกใช้ฟังก์ชัน
ANeuralNetworksExecution_startCompute()หากไม่มีข้อผิดพลาด ฟังก์ชันนี้จะแสดงรหัสผลลัพธ์เป็นANEURALNETWORKS_NO_ERROR// Starts the work. The work proceeds asynchronously ANeuralNetworksEvent* run1_end = NULL; ANeuralNetworksExecution_startCompute(run1, &run1_end);
เรียกใช้ฟังก์ชัน
ANeuralNetworksEvent_wait()เพื่อรอให้การดำเนินการเสร็จสมบูรณ์ หากดำเนินการสำเร็จ ฟังก์ชันนี้จะแสดงรหัสผลลัพธ์เป็นANEURALNETWORKS_NO_ERRORการรอสามารถทำได้ในเทรดอื่นที่ไม่ใช่เทรดที่เริ่มการดำเนินการ// For our example, we have no other work to do and will just wait for the completion ANeuralNetworksEvent_wait(run1_end); ANeuralNetworksEvent_free(run1_end); ANeuralNetworksExecution_free(run1);
หรือจะใช้อินพุตชุดอื่นกับโมเดลที่คอมไพล์แล้วก็ได้โดยใช้อินสแตนซ์การคอมไพล์เดียวกันเพื่อสร้างอินสแตนซ์
ANeuralNetworksExecutionใหม่// Apply the compiled model to a different set of inputs ANeuralNetworksExecution* run2; ANeuralNetworksExecution_create(compilation, &run2); ANeuralNetworksExecution_setInput(run2, ...); ANeuralNetworksExecution_setOutput(run2, ...); ANeuralNetworksEvent* run2_end = NULL; ANeuralNetworksExecution_startCompute(run2, &run2_end); ANeuralNetworksEvent_wait(run2_end); ANeuralNetworksEvent_free(run2_end); ANeuralNetworksExecution_free(run2);
การดำเนินการแบบซิงโครนัส
การดำเนินการแบบอะซิงโครนัสใช้เวลาในการสร้างและซิงค์เทรด นอกจากนี้ เวลาในการตอบสนองยังอาจแตกต่างกันอย่างมาก โดยความล่าช้าที่นานที่สุดอาจถึง 500 ไมโครวินาทีระหว่างเวลาที่เทรดได้รับการแจ้งเตือนหรือถูกปลุกและเวลาที่เทรดเชื่อมโยงกับแกน CPU ในที่สุด
หากต้องการปรับปรุงเวลาในการตอบสนอง คุณสามารถกำหนดให้แอปพลิเคชันทำการเรียกใช้การอนุมานแบบซิงโครนัสไปยังรันไทม์แทนได้ การเรียกนั้นจะแสดงผลก็ต่อเมื่อการอนุมานเสร็จสมบูรณ์แล้วเท่านั้น แทนที่จะแสดงผลเมื่อการอนุมานเริ่มต้นขึ้น แทนที่จะเรียกใช้
ANeuralNetworksExecution_startCompute
สำหรับการเรียกใช้การอนุมานแบบอะซิงโครนัสไปยังรันไทม์ แอปพลิเคชันจะเรียกใช้
ANeuralNetworksExecution_compute
เพื่อทำการเรียกใช้แบบซิงโครนัสไปยังรันไทม์ การเรียกใช้ ANeuralNetworksExecution_compute ไม่ใช้ ANeuralNetworksEvent และไม่ได้จับคู่กับการเรียกใช้ ANeuralNetworksEvent_wait
การดำเนินการแบบ Burst
ในอุปกรณ์ Android ที่ใช้ Android 10 (ระดับ API 29) ขึ้นไป NNAPI จะรองรับการดำเนินการแบบต่อเนื่องผ่านออบเจ็กต์ ANeuralNetworksBurst การดำเนินการแบบต่อเนื่องคือลำดับการดำเนินการของการคอมไพล์เดียวกันที่เกิดขึ้นอย่างรวดเร็ว เช่น การดำเนินการกับเฟรมของการจับภาพจากกล้องหรือตัวอย่างเสียงที่ต่อเนื่องกัน การใช้ออบเจ็กต์ ANeuralNetworksBurst อาจส่งผลให้การดำเนินการเร็วขึ้น เนื่องจากออบเจ็กต์เหล่านี้จะระบุให้ตัวเร่งทราบว่าอาจมีการใช้ทรัพยากรซ้ำระหว่างการดำเนินการ และตัวเร่งควรอยู่ในสถานะที่มีประสิทธิภาพสูงตลอดระยะเวลาของการทำงานแบบต่อเนื่อง
ANeuralNetworksBurst มีการเปลี่ยนแปลงเพียงเล็กน้อยในเส้นทางการดำเนินการปกติ คุณสร้างออบเจ็กต์ต่อเนื่องโดยใช้ ANeuralNetworksBurst_create ดังที่แสดงในข้อมูลโค้ดต่อไปนี้
// Create burst object to be reused across a sequence of executions
ANeuralNetworksBurst* burst = NULL;
ANeuralNetworksBurst_create(compilation, &burst);
การดำเนินการแบบช่วงเร่งประสิทธิภาพเป็นแบบซิงโครนัส อย่างไรก็ตาม แทนที่จะใช้ ANeuralNetworksExecution_compute เพื่อทำการอนุมานแต่ละครั้ง คุณจะจับคู่ออบเจ็กต์ ANeuralNetworksExecution ต่างๆ กับ ANeuralNetworksBurst เดียวกันในการเรียกใช้ฟังก์ชัน ANeuralNetworksExecution_burstCompute
// Create and configure first execution object
// ...

// Execute using the burst object
ANeuralNetworksExecution_burstCompute(execution1, burst);

// Use results of first execution and free the execution object
// ...

// Create and configure second execution object
// ...

// Execute using the same burst object
ANeuralNetworksExecution_burstCompute(execution2, burst);

// Use results of second execution and free the execution object
// ...
ปล่อยออบเจ็กต์ ANeuralNetworksBurst ด้วย
ANeuralNetworksBurst_free
เมื่อไม่จำเป็นต้องใช้แล้ว
// Cleanup
ANeuralNetworksBurst_free(burst);
คิวคำสั่งแบบอะซิงโครนัสและการดำเนินการที่มีการกำหนดขอบเขต
ใน Android 11 ขึ้นไป NNAPI รองรับวิธีเพิ่มเติมในการกำหนดเวลาการดำเนินการแบบอะซิงโครนัสผ่านเมธอด ANeuralNetworksExecution_startComputeWithDependencies() เมื่อคุณใช้วิธีนี้ การดำเนินการจะรอให้มีการส่งสัญญาณเหตุการณ์ที่เกี่ยวข้องทั้งหมดก่อนที่จะเริ่มการประเมิน เมื่อการดำเนินการเสร็จสมบูรณ์และเอาต์พุตพร้อมใช้งานแล้ว ระบบจะส่งสัญญาณเหตุการณ์ที่แสดงผล
เหตุการณ์อาจได้รับการสนับสนุนโดยรั้วการซิงค์ ทั้งนี้ขึ้นอยู่กับอุปกรณ์ที่จัดการการดำเนินการ คุณต้องเรียกใช้ ANeuralNetworksEvent_wait() เพื่อรอเหตุการณ์และกู้คืนทรัพยากรที่การดำเนินการใช้ คุณสามารถนำเข้า Sync Fence ไปยังออบเจ็กต์เหตุการณ์ได้โดยใช้ ANeuralNetworksEvent_createFromSyncFenceFd() และส่งออก Sync Fence จากออบเจ็กต์เหตุการณ์ได้โดยใช้ ANeuralNetworksEvent_getSyncFenceFd()
เอาต์พุตที่มีขนาดแบบไดนามิก
หากต้องการรองรับโมเดลที่ขนาดของเอาต์พุตขึ้นอยู่กับข้อมูลอินพุต ซึ่งก็คือไม่สามารถกำหนดขนาดได้ในเวลาที่เรียกใช้โมเดล ให้ใช้ ANeuralNetworksExecution_getOutputOperandRank และ ANeuralNetworksExecution_getOutputOperandDimensions
ตัวอย่างโค้ดต่อไปนี้แสดงวิธีดำเนินการ
// Get the rank of the output
uint32_t myOutputRank = 0;
ANeuralNetworksExecution_getOutputOperandRank(run1, 0, &myOutputRank);

// Get the dimensions of the output
std::vector<uint32_t> myOutputDimensions(myOutputRank);
ANeuralNetworksExecution_getOutputOperandDimensions(run1, 0, myOutputDimensions.data());
ล้างข้อมูล
ขั้นตอนการล้างข้อมูลจะจัดการการปล่อยทรัพยากรภายในที่ใช้สำหรับการประมวลผล
// Cleanup
ANeuralNetworksCompilation_free(compilation);
ANeuralNetworksModel_free(model);
ANeuralNetworksMemory_free(mem1);
การจัดการข้อผิดพลาดและการใช้ CPU สำรอง
หากมีข้อผิดพลาดระหว่างการแบ่งพาร์ติชัน หากไดรเวอร์คอมไพล์ (ส่วนหนึ่งของ) โมเดลไม่สำเร็จ หรือหากไดรเวอร์เรียกใช้ (ส่วนหนึ่งของ) โมเดลที่คอมไพล์ไม่สำเร็จ NNAPI อาจกลับไปใช้การติดตั้งใช้งาน CPU ของตนเองสำหรับการดำเนินการอย่างน้อย 1 รายการ
หากไคลเอ็นต์ NNAPI มีเวอร์ชันที่เพิ่มประสิทธิภาพของการดำเนินการ (เช่น TFLite) การปิดใช้การสำรองข้อมูล CPU และจัดการความล้มเหลวด้วยการติดตั้งใช้งานการดำเนินการที่เพิ่มประสิทธิภาพของไคลเอ็นต์อาจเป็นประโยชน์
ใน Android 10 หากการคอมไพล์ดำเนินการโดยใช้ ANeuralNetworksCompilation_createForDevices ระบบจะปิดใช้ CPU สำรอง
ใน Android P การดำเนินการ NNAPI จะกลับไปใช้ CPU หากการดำเนินการในไดรเวอร์ไม่สำเร็จ
ซึ่งรวมถึงใน Android 10 เมื่อใช้ ANeuralNetworksCompilation_create แทน ANeuralNetworksCompilation_createForDevices ด้วย
การดำเนินการครั้งแรกจะกลับไปใช้พาร์ติชันเดียว และหากยังไม่สำเร็จ ระบบจะลองใช้โมเดลทั้งหมดอีกครั้งใน CPU
หากการแบ่งพาร์ติชันหรือการคอมไพล์ล้มเหลว ระบบจะลองใช้โมเดลทั้งหมดใน CPU
มีบางกรณีที่ CPU ไม่รองรับการดำเนินการบางอย่าง และในสถานการณ์เช่นนี้ การคอมไพล์หรือการดำเนินการจะล้มเหลวแทนที่จะกลับไปใช้ CPU
แม้ว่าจะปิดใช้การใช้ CPU สำรองแล้ว แต่ก็อาจยังมีการดำเนินการในโมเดลที่กำหนดเวลาไว้ใน CPU อยู่ หาก CPU อยู่ในรายการโปรเซสเซอร์ที่ส่งไปยัง ANeuralNetworksCompilation_createForDevices และเป็นโปรเซสเซอร์เพียงตัวเดียวที่รองรับการดำเนินการเหล่านั้น หรือเป็นโปรเซสเซอร์ที่อ้างว่ามีประสิทธิภาพดีที่สุดสำหรับการดำเนินการเหล่านั้น ระบบจะเลือกโปรเซสเซอร์ดังกล่าวเป็นผู้ดำเนินการหลัก (ไม่ใช่แบบสำรอง)
หากต้องการตรวจสอบว่าไม่มีการดำเนินการของ CPU ให้ใช้ ANeuralNetworksCompilation_createForDevices ขณะยกเว้น nnapi-reference จากรายการอุปกรณ์
ตั้งแต่ Android P เป็นต้นไป คุณสามารถปิดใช้การสำรองข้อมูลในเวลาดำเนินการในบิลด์การแก้ไขข้อบกพร่องได้โดยตั้งค่าพร็อพเพอร์ตี้ debug.nn.partition เป็น 2
โดเมนหน่วยความจำ
ใน Android 11 ขึ้นไป NNAPI รองรับโดเมนหน่วยความจำที่ให้อินเทอร์เฟซตัวจัดสรรสำหรับหน่วยความจำทึบแสง ซึ่งช่วยให้แอปพลิเคชันส่งผ่านหน่วยความจำที่มาพร้อมกับอุปกรณ์ได้ตลอดการดำเนินการ เพื่อให้ NNAPI ไม่คัดลอกหรือแปลงข้อมูลโดยไม่จำเป็นเมื่อทำการดำเนินการติดต่อกันในไดรเวอร์เดียวกัน
ฟีเจอร์โดเมนหน่วยความจำมีไว้สำหรับเทนเซอร์ที่ส่วนใหญ่เป็นแบบภายในไดรเวอร์และไม่จำเป็นต้องเข้าถึงฝั่งไคลเอ็นต์บ่อยๆ ตัวอย่างของเทนเซอร์ดังกล่าว ได้แก่ เทนเซอร์สถานะในโมเดลลำดับ สำหรับ Tensor ที่ต้องเข้าถึง CPU บ่อยครั้งในฝั่งไคลเอ็นต์ ให้ใช้พูลหน่วยความจำที่ใช้ร่วมกันแทน
หากต้องการจัดสรรหน่วยความจำแบบทึบแสง ให้ทำตามขั้นตอนต่อไปนี้
เรียกใช้ฟังก์ชัน
ANeuralNetworksMemoryDesc_create()เพื่อสร้างข้อบ่งชี้หน่วยความจำใหม่// Create a memory descriptor ANeuralNetworksMemoryDesc* desc; ANeuralNetworksMemoryDesc_create(&desc);
ระบุบทบาทอินพุตและเอาต์พุตที่ต้องการทั้งหมดโดยเรียกใช้
ANeuralNetworksMemoryDesc_addInputRole()และANeuralNetworksMemoryDesc_addOutputRole()// Specify that the memory may be used as the first input and the first output // of the compilation ANeuralNetworksMemoryDesc_addInputRole(desc, compilation, 0, 1.0f); ANeuralNetworksMemoryDesc_addOutputRole(desc, compilation, 0, 1.0f);
(ไม่บังคับ) ระบุมิติข้อมูลหน่วยความจำโดยเรียกใช้
ANeuralNetworksMemoryDesc_setDimensions()// Specify the memory dimensions uint32_t dims[] = {3, 4}; ANeuralNetworksMemoryDesc_setDimensions(desc, 2, dims);
สรุปคำจำกัดความของข้อบ่งชี้โดยเรียกใช้
ANeuralNetworksMemoryDesc_finish()ANeuralNetworksMemoryDesc_finish(desc);
จัดสรรหน่วยความจำได้มากเท่าที่ต้องการโดยส่งข้อบ่งชี้ไปยัง
ANeuralNetworksMemory_createFromDesc()// Allocate two opaque memories with the descriptor ANeuralNetworksMemory* opaqueMem; ANeuralNetworksMemory_createFromDesc(desc, &opaqueMem);
เพิ่มพื้นที่ว่างให้ตัวบ่งชี้หน่วยความจำเมื่อไม่ต้องการใช้แล้ว
ANeuralNetworksMemoryDesc_free(desc);
ไคลเอ็นต์จะใช้ออบเจ็กต์ ANeuralNetworksMemory ที่สร้างขึ้นได้เฉพาะกับ ANeuralNetworksExecution_setInputFromMemory() หรือ ANeuralNetworksExecution_setOutputFromMemory() ตามบทบาทที่ระบุไว้ในออบเจ็กต์ ANeuralNetworksMemoryDesc เท่านั้น ต้องตั้งค่าอาร์กิวเมนต์ออฟเซ็ตและความยาวเป็น 0 ซึ่งหมายความว่ามีการใช้หน่วยความจำทั้งหมด นอกจากนี้ ไคลเอ็นต์ยังตั้งค่าหรือดึงเนื้อหาของหน่วยความจำอย่างชัดเจนได้โดยใช้ ANeuralNetworksMemory_copy()
คุณสามารถสร้างความทรงจำที่คลุมเครือซึ่งมีบทบาทของมิติข้อมูลหรืออันดับที่ไม่ได้ระบุ
ในกรณีนี้ การสร้างหน่วยความจำอาจล้มเหลวโดยมีสถานะ ANEURALNETWORKS_OP_FAILED หากไดรเวอร์ที่เกี่ยวข้องไม่รองรับ เราขอแนะนำให้ไคลเอ็นต์ใช้ตรรกะสำรองโดยจัดสรรบัฟเฟอร์ขนาดใหญ่พอที่รองรับโดย Ashmem หรือ AHardwareBuffer โหมด BLOB
เมื่อ NNAPI ไม่จำเป็นต้องเข้าถึงออบเจ็กต์หน่วยความจำทึบแสงอีกต่อไป ให้ปล่อยอินสแตนซ์ ANeuralNetworksMemory ที่เกี่ยวข้อง
ANeuralNetworksMemory_free(opaqueMem);
วัดประสิทธิภาพ
คุณประเมินประสิทธิภาพของแอปได้โดยการวัดเวลาในการดำเนินการหรือโดยการทำโปรไฟล์
เวลาดำเนินการ
เมื่อต้องการกำหนดเวลาดำเนินการทั้งหมดผ่านรันไทม์ คุณสามารถใช้ API การดำเนินการแบบซิงโครนัสและวัดเวลาที่ใช้ในการเรียกใช้ได้ เมื่อต้องการกำหนดเวลาดำเนินการทั้งหมดผ่านสแต็กซอฟต์แวร์ระดับต่ำ คุณสามารถใช้ ANeuralNetworksExecution_setMeasureTiming และ ANeuralNetworksExecution_getDuration เพื่อดูข้อมูลต่อไปนี้
- เวลาในการดำเนินการบนตัวเร่ง (ไม่ใช่ในไดรเวอร์ซึ่งทำงานบนโปรเซสเซอร์โฮสต์)
- เวลาในการดำเนินการในไดรเวอร์ รวมถึงเวลาใน Accelerator
เวลาในการดำเนินการในไดรเวอร์ไม่รวมค่าใช้จ่ายเพิ่มเติม เช่น ค่าใช้จ่ายของรันไทม์เองและ IPC ที่จำเป็นสำหรับรันไทม์ในการสื่อสารกับไดรเวอร์
API เหล่านี้จะวัดระยะเวลาระหว่างเหตุการณ์ที่ส่งงานและเหตุการณ์ที่งานเสร็จสมบูรณ์ แทนที่จะวัดเวลาที่ไดรเวอร์หรือ Accelerator ใช้ในการอนุมาน ซึ่งอาจถูกขัดจังหวะด้วยการสลับบริบท
ตัวอย่างเช่น หากการอนุมาน 1 เริ่มต้นขึ้น จากนั้นไดรเวอร์หยุดทำงานเพื่อทำการอนุมาน 2 แล้วกลับมาทำงานต่อและทำการอนุมาน 1 จนเสร็จ เวลาในการดำเนินการสำหรับการอนุมาน 1 จะรวมเวลาที่หยุดทำงานเพื่อทำการอนุมาน 2 ด้วย
ข้อมูลเวลาเหล่านี้อาจเป็นประโยชน์สำหรับการติดตั้งใช้งานแอปพลิเคชันเวอร์ชันที่ใช้งานจริงเพื่อรวบรวมการวัดและส่งข้อมูลทางไกลสำหรับการใช้งานแบบออฟไลน์ คุณสามารถใช้ข้อมูลเวลาเพื่อแก้ไขแอปให้มีประสิทธิภาพสูงขึ้นได้
โปรดคำนึงถึงสิ่งต่อไปนี้เมื่อใช้ฟังก์ชันการทำงานนี้
- การรวบรวมข้อมูลเวลาอาจส่งผลต่อประสิทธิภาพ
- มีเพียงไดรเวอร์เท่านั้นที่สามารถคำนวณเวลาที่ใช้ในตัวเองหรือในตัวเร่ง โดยไม่รวมเวลาที่ใช้ในรันไทม์ NNAPI และใน IPC
- คุณใช้ API เหล่านี้ได้เฉพาะกับ
ANeuralNetworksExecutionที่สร้างด้วยANeuralNetworksCompilation_createForDevicesที่มีnumDevices = 1เท่านั้น - ไม่จำเป็นต้องมีไดรเวอร์เพื่อรายงานข้อมูลเวลา
สร้างโปรไฟล์แอปพลิเคชันด้วย Android Systrace
ตั้งแต่ Android 10 เป็นต้นไป NNAPI จะสร้างเหตุการณ์ systrace โดยอัตโนมัติซึ่งคุณสามารถใช้เพื่อทำโปรไฟล์แอปพลิเคชันได้
แหล่งที่มาของ NNAPI มาพร้อมกับยูทิลิตี parse_systrace เพื่อประมวลผลเหตุการณ์ systrace ที่สร้างขึ้นโดยแอปพลิเคชันของคุณ และสร้างมุมมองตารางที่แสดงเวลาที่ใช้ในระยะต่างๆ ของวงจรโมเดล (การสร้างอินสแตนซ์ การเตรียม การคอมไพล์ การดำเนินการ และการสิ้นสุด) และเลเยอร์ต่างๆ ของแอปพลิเคชัน เลเยอร์ที่แอปพลิเคชันของคุณแบ่งออกเป็นส่วนๆ ได้แก่
Application: โค้ดของแอปพลิเคชันหลักRuntime: รันไทม์ NNAPIIPC: การสื่อสารระหว่างกระบวนการระหว่างรันไทม์ NNAPI กับโค้ดไดรเวอร์Driver: กระบวนการไดรเวอร์ Accelerator
สร้างข้อมูลการวิเคราะห์การทำโปรไฟล์
สมมติว่าคุณตรวจสอบซอร์สทรี AOSP ที่ $ANDROID_BUILD_TOP และใช้ตัวอย่างการแยกประเภทรูปภาพ TFLite เป็นแอปพลิเคชันเป้าหมาย คุณสามารถสร้างข้อมูลการทำโปรไฟล์ NNAPI ได้โดยทำตามขั้นตอนต่อไปนี้
- เริ่ม Android systrace ด้วยคำสั่งต่อไปนี้
$ANDROID_BUILD_TOP/external/chromium-trace/systrace.py -o trace.html -a org.tensorflow.lite.examples.classification nnapi hal freq sched idle load binder_driver
พารามิเตอร์ -o trace.html บ่งชี้ว่าระบบจะเขียนการติดตามใน trace.html เมื่อสร้างโปรไฟล์แอปพลิเคชันของคุณเอง คุณจะต้องแทนที่ org.tensorflow.lite.examples.classification ด้วยชื่อกระบวนการที่ระบุไว้ในไฟล์ Manifest ของแอป
การดำเนินการนี้จะทำให้คอนโซลเชลล์ของคุณไม่ว่าง อย่าเรียกใช้คำสั่งในเบื้องหลังเนื่องจากคำสั่งจะรอให้ enter สิ้นสุดการทำงานแบบอินเทอร์แอกทีฟ
- หลังจากเริ่มตัวรวบรวม Systrace แล้ว ให้เริ่มแอปและเรียกใช้การทดสอบการเปรียบเทียบ
ในกรณีของเรา คุณสามารถเริ่มแอปการแยกประเภทรูปภาพจาก Android Studio หรือจาก UI ของโทรศัพท์ทดสอบโดยตรงหากติดตั้งแอปไว้แล้ว หากต้องการสร้างข้อมูล NNAPI คุณต้องกำหนดค่าแอปให้ใช้ NNAPI โดยเลือก NNAPI เป็นอุปกรณ์เป้าหมายในกล่องโต้ตอบการกำหนดค่าแอป
เมื่อการทดสอบเสร็จสมบูรณ์ ให้สิ้นสุด systrace โดยกด
enterบนเทอร์มินัลคอนโซลที่ทำงานอยู่ตั้งแต่ขั้นตอนที่ 1เรียกใช้ยูทิลิตี
systrace_parserเพื่อสร้างสถิติสะสม ดังนี้
$ANDROID_BUILD_TOP/frameworks/ml/nn/tools/systrace_parser/parse_systrace.py --total-times trace.html
โปรแกรมแยกวิเคราะห์ยอมรับพารามิเตอร์ต่อไปนี้
- --total-times: แสดงเวลาทั้งหมดที่ใช้ในเลเยอร์ รวมถึงเวลาที่ใช้ในการรอการดำเนินการในการเรียกใช้เลเยอร์ที่สำคัญ
- --print-detail: พิมพ์เหตุการณ์ทั้งหมดที่รวบรวมจาก systrace
- --per-execution: พิมพ์เฉพาะการดำเนินการและระยะย่อย (ตามเวลาต่อการดำเนินการ) แทนสถิติสำหรับทุกระยะ
- --json: สร้างเอาต์พุตในรูปแบบ JSON
ตัวอย่างเอาต์พุตจะแสดงอยู่ด้านล่าง
===========================================================================================================================================
NNAPI timing summary (total time, ms wall-clock)                                                      Execution
                                                           ----------------------------------------------------
              Initialization   Preparation   Compilation           I/O       Compute      Results     Ex. total   Termination        Total
              --------------   -----------   -----------   -----------  ------------  -----------   -----------   -----------   ----------
Application              n/a         19.06       1789.25           n/a           n/a         6.70         21.37           n/a      1831.17*
Runtime                    -         18.60       1787.48          2.93         11.37         0.12         14.42          1.32      1821.81
IPC                     1.77             -       1781.36          0.02          8.86            -          8.88             -      1792.01
Driver                  1.04             -       1779.21           n/a           n/a          n/a          7.70             -      1787.95

Total                   1.77*        19.06*      1789.25*         2.93*        11.74*        6.70*        21.37*         1.32*     1831.17*
===========================================================================================================================================
* This total ignores missing (n/a) values and thus is not necessarily consistent with the rest of the numbers
โปรแกรมแยกวิเคราะห์อาจทำงานไม่สำเร็จหากเหตุการณ์ที่รวบรวมไม่ได้แสดงถึงการติดตามแอปพลิเคชันที่สมบูรณ์ โดยเฉพาะอย่างยิ่ง อาจดำเนินการไม่สำเร็จหากมีเหตุการณ์ systrace ที่สร้างขึ้นเพื่อทำเครื่องหมายการสิ้นสุดของส่วนหนึ่งๆ อยู่ในการติดตามโดยไม่มีเหตุการณ์เริ่มต้นส่วนที่เกี่ยวข้อง ซึ่งมักเกิดขึ้นหากมีการสร้างเหตุการณ์บางอย่างจากเซสชันการทำโปรไฟล์ก่อนหน้าเมื่อคุณเริ่มตัวรวบรวม systrace ในกรณีนี้ คุณจะต้องเรียกใช้การทำโปรไฟล์อีกครั้ง
เพิ่มสถิติสำหรับโค้ดของแอปพลิเคชันลงในเอาต์พุต systrace_parser
แอปพลิเคชัน parse_systrace อิงตามฟังก์ชันการทำงานของ systrace ในตัวของ Android คุณสามารถเพิ่มการติดตามสำหรับการดำเนินการที่เฉพาะเจาะจงในแอปได้โดยใช้ systrace API (สำหรับ Java, สำหรับแอปพลิเคชันแบบเนทีฟ) ที่มีชื่อเหตุการณ์ที่กำหนดเอง
หากต้องการเชื่อมโยงเหตุการณ์ที่กำหนดเองกับระยะต่างๆ ของวงจรแอปพลิเคชัน ให้ใส่สตริงต่อไปนี้ไว้หน้าชื่อเหตุการณ์
[NN_LA_PI]: เหตุการณ์ระดับแอปพลิเคชันสำหรับการเริ่มต้น[NN_LA_PP]: เหตุการณ์ระดับแอปพลิเคชันสำหรับการเตรียมความพร้อม[NN_LA_PC]: เหตุการณ์ระดับแอปพลิเคชันสำหรับการคอมไพล์[NN_LA_PE]: เหตุการณ์ระดับแอปพลิเคชันสำหรับการดำเนินการ
ต่อไปนี้คือตัวอย่างวิธีแก้ไขโค้ดตัวอย่างการแยกประเภทรูปภาพ TFLite โดยเพิ่มส่วน runInferenceModel สำหรับระยะ Execution และเลเยอร์ Application ที่มีส่วนอื่นๆ preprocessBitmap ซึ่งจะไม่ได้รับการพิจารณาในการติดตาม NNAPI ส่วน runInferenceModel จะเป็นส่วนหนึ่งของเหตุการณ์ systrace ที่ประมวลผลโดยโปรแกรมแยกวิเคราะห์ systrace ของ nnapi
Kotlin
/** Runs inference and returns the classification results. */ fun recognizeImage(bitmap: Bitmap): List{ // This section won’t appear in the NNAPI systrace analysis Trace.beginSection("preprocessBitmap") convertBitmapToByteBuffer(bitmap) Trace.endSection() // Run the inference call. // Add this method in to NNAPI systrace analysis. Trace.beginSection("[NN_LA_PE]runInferenceModel") long startTime = SystemClock.uptimeMillis() runInference() long endTime = SystemClock.uptimeMillis() Trace.endSection() ... return recognitions }
Java
/** Runs inference and returns the classification results. */ public ListrecognizeImage(final Bitmap bitmap) { // This section won’t appear in the NNAPI systrace analysis Trace.beginSection("preprocessBitmap"); convertBitmapToByteBuffer(bitmap); Trace.endSection(); // Run the inference call. // Add this method in to NNAPI systrace analysis. Trace.beginSection("[NN_LA_PE]runInferenceModel"); long startTime = SystemClock.uptimeMillis(); runInference(); long endTime = SystemClock.uptimeMillis(); Trace.endSection(); ... Trace.endSection(); return recognitions; }
คุณภาพของการบริการ
ใน Android 11 ขึ้นไป NNAPI ช่วยให้คุณภาพของบริการ (QoS) ดีขึ้นโดยอนุญาตให้แอปพลิเคชันระบุลำดับความสำคัญที่เกี่ยวข้องของโมเดล ระยะเวลาสูงสุดที่คาดว่าจะใช้ในการเตรียมโมเดลหนึ่งๆ และระยะเวลาสูงสุดที่คาดว่าจะใช้ในการคำนวณหนึ่งๆ ให้เสร็จสมบูรณ์ นอกจากนี้ Android 11 ยังเปิดตัวรหัสผลลัพธ์ NNAPI เพิ่มเติมที่ช่วยให้แอปพลิเคชันเข้าใจความล้มเหลว เช่น การดำเนินการที่เลยกำหนดเวลา
กำหนดลำดับความสำคัญของภาระงาน
หากต้องการกำหนดลำดับความสำคัญของภาระงาน NNAPI ให้เรียกใช้
ANeuralNetworksCompilation_setPriority()
ก่อนเรียกใช้ ANeuralNetworksCompilation_finish()
กำหนดเวลาส่ง
แอปพลิเคชันสามารถกำหนดเวลาสิ้นสุดสำหรับทั้งการคอมไพล์และการอนุมานโมเดลได้
- หากต้องการตั้งค่าระยะหมดเวลาการคอมไพล์ ให้เรียกใช้
ANeuralNetworksCompilation_setTimeout()ก่อนเรียกใช้ANeuralNetworksCompilation_finish() - หากต้องการตั้งค่าระยะหมดเวลาของการอนุมาน ให้เรียกใช้
ANeuralNetworksExecution_setTimeout()ก่อนเริ่มการคอมไพล์
ข้อมูลเพิ่มเติมเกี่ยวกับตัวถูกดำเนินการ
ส่วนต่อไปนี้จะครอบคลุมหัวข้อขั้นสูงเกี่ยวกับการใช้ตัวถูกดำเนินการ
เทนเซอร์ที่ผ่านการควอนไทซ์
เทนเซอร์ที่ผ่านการควอนไทซ์เป็นวิธีที่กะทัดรัดในการแสดงอาร์เรย์ n มิติของค่าจุดลอยตัว
NNAPI รองรับเทนเซอร์ที่ผ่านการควอนไทซ์แบบไม่สมมาตรขนาด 8 บิต สำหรับเทนเซอร์เหล่านี้ ค่าของแต่ละเซลล์จะแสดงด้วยจำนวนเต็ม 8 บิต เทนเซอร์จะเชื่อมโยงกับค่าสเกลและค่าจุดศูนย์ ซึ่งใช้เพื่อแปลงจำนวนเต็ม 8 บิตเป็นค่าจุดลอยตัวที่แสดงอยู่
สูตรคือ
(cellValue - zeroPoint) * scale
โดยที่ค่า zeroPoint เป็นจำนวนเต็ม 32 บิต และสเกลเป็นค่าจุดลอยตัว 32 บิต
เมื่อเทียบกับเทนเซอร์ของค่าจุดลอยตัว 32 บิต เทนเซอร์ที่ผ่านการทำ Quantization 8 บิตมีข้อดี 2 ประการดังนี้
- แอปพลิเคชันของคุณจะมีขนาดเล็กลง เนื่องจากน้ำหนักที่ฝึกใช้ขนาดเพียง 1 ใน 4 ของเทนเซอร์ 32 บิต
- การคำนวณมักจะทำได้เร็วขึ้น เนื่องจากข้อมูลที่ต้องดึงมาจากหน่วยความจำมีปริมาณน้อยลง และประสิทธิภาพของโปรเซสเซอร์ เช่น DSP ในการคำนวณจำนวนเต็ม
แม้ว่าจะสามารถแปลงโมเดลจุดลอยตัวเป็นโมเดลที่ผ่านการทำ Quantization ได้ แต่ประสบการณ์ของเราแสดงให้เห็นว่าการฝึกโมเดลที่ผ่านการทำ Quantization โดยตรงจะให้ผลลัพธ์ที่ดีกว่า ซึ่งส่งผลให้โครงข่ายประสาทเทียมเรียนรู้ที่จะชดเชยความละเอียดที่เพิ่มขึ้นของแต่ละค่า สำหรับ Tensor ที่ผ่านการควอนไทซ์แต่ละรายการ ระบบจะกำหนดค่าสเกลและค่า zeroPoint ในระหว่างกระบวนการฝึก
ใน NNAPI คุณกำหนดประเภทเทนเซอร์ที่ผ่านการควอนไทซ์โดยการตั้งค่าช่องประเภทของโครงสร้างข้อมูล ANeuralNetworksOperandType เป็น ANEURALNETWORKS_TENSOR_QUANT8_ASYMM
นอกจากนี้ คุณยังระบุค่า scale และ zeroPoint ของ Tensor ในโครงสร้างข้อมูลนั้นด้วย
นอกจากเทนเซอร์ที่ผ่านการทำ Quantization แบบไม่สมมาตร 8 บิตแล้ว NNAPI ยังรองรับสิ่งต่อไปนี้ด้วย
ANEURALNETWORKS_TENSOR_QUANT8_SYMM_PER_CHANNELซึ่งคุณสามารถใช้เพื่อแสดงน้ำหนักสำหรับการดำเนินการCONV/DEPTHWISE_CONV/TRANSPOSED_CONVANEURALNETWORKS_TENSOR_QUANT16_ASYMMซึ่งคุณสามารถใช้สำหรับสถานะภายในของQUANTIZED_16BIT_LSTMได้ANEURALNETWORKS_TENSOR_QUANT8_SYMMซึ่งสามารถเป็นอินพุตสำหรับANEURALNETWORKS_DEQUANTIZE
ตัวถูกดำเนินการที่ไม่บังคับ
การดำเนินการบางอย่าง เช่น ANEURALNETWORKS_LSH_PROJECTION จะใช้ตัวถูกดำเนินการหรือไม่ก็ได้ หากต้องการระบุในโมเดลว่าไม่ได้ระบุตัวถูกดำเนินการที่ไม่บังคับ ให้เรียกใช้ฟังก์ชัน ANeuralNetworksModel_setOperandValue() โดยส่ง NULL สำหรับบัฟเฟอร์และ 0 สำหรับความยาว
หากการตัดสินใจว่ามีตัวถูกดำเนินการหรือไม่นั้นแตกต่างกันไปสำหรับการดำเนินการแต่ละครั้ง คุณจะระบุว่าละเว้นตัวถูกดำเนินการได้โดยใช้ฟังก์ชัน ANeuralNetworksExecution_setInput() หรือ ANeuralNetworksExecution_setOutput() โดยส่ง NULL สำหรับบัฟเฟอร์และ 0 สำหรับความยาว
เทนเซอร์ของอันดับที่ไม่รู้จัก
Android 9 (ระดับ API 28) เปิดตัวตัวถูกดำเนินการของโมเดลที่มีมิติข้อมูลที่ไม่รู้จัก แต่มีอันดับที่รู้จัก (จำนวนมิติข้อมูล) Android 10 (API ระดับ 29) เปิดตัวเทนเซอร์ที่มีอันดับไม่รู้จัก ดังที่แสดงใน ANeuralNetworksOperandType
การเปรียบเทียบ NNAPI
การเปรียบเทียบ NNAPI พร้อมใช้งานใน AOSP ใน platform/test/mlts/benchmark (แอปการเปรียบเทียบ) และ platform/test/mlts/models (โมเดลและชุดข้อมูล)
การเปรียบเทียบจะประเมินเวลาในการตอบสนองและความแม่นยำ และเปรียบเทียบไดรเวอร์กับงานเดียวกันที่ทำโดยใช้ Tensorflow Lite ที่ทำงานบน CPU สำหรับโมเดลและชุดข้อมูลเดียวกัน
หากต้องการใช้การเปรียบเทียบ ให้ทำดังนี้
เชื่อมต่ออุปกรณ์ Android เป้าหมายกับคอมพิวเตอร์ เปิดหน้าต่างเทอร์มินัล และตรวจสอบว่าอุปกรณ์เข้าถึงได้ผ่าน adb
หากเชื่อมต่ออุปกรณ์ Android มากกว่า 1 เครื่อง ให้ส่งออกตัวแปรสภาพแวดล้อม
ANDROID_SERIALของอุปกรณ์เป้าหมายไปที่ไดเรกทอรีต้นทางระดับบนสุดของ Android
เรียกใช้คำสั่งต่อไปนี้
lunch aosp_arm-userdebug # Or aosp_arm64-userdebug if available
./test/mlts/benchmark/build_and_run_benchmark.sh
เมื่อการเรียกใช้การเปรียบเทียบเสร็จสิ้น ระบบจะแสดงผลลัพธ์เป็นหน้า HTML ที่ส่งไปยัง
xdg-open
บันทึก NNAPI
NNAPI จะสร้างข้อมูลการวินิจฉัยที่เป็นประโยชน์ในบันทึกของระบบ หากต้องการวิเคราะห์บันทึก ให้ใช้ยูทิลิตี logcat
เปิดใช้การบันทึก NNAPI แบบละเอียดสำหรับระยะหรือคอมโพเนนต์ที่เฉพาะเจาะจงโดยตั้งค่าพร็อพเพอร์ตี้ debug.nn.vlog (โดยใช้ adb shell) เป็นรายการค่าต่อไปนี้ โดยคั่นด้วยเว้นวรรค โคลอน หรือคอมมา
model: การสร้างโมเดลcompilation: การสร้างแผนการดำเนินการและการคอมไพล์โมเดลexecution: การดำเนินการโมเดลcpuexe: การดำเนินการโดยใช้การติดตั้งใช้งาน CPU ของ NNAPImanager: ส่วนขยาย NNAPI, อินเทอร์เฟซที่พร้อมใช้งาน และข้อมูลที่เกี่ยวข้องกับความสามารถallหรือ1: องค์ประกอบทั้งหมดข้างต้น
เช่น หากต้องการเปิดใช้การบันทึกแบบละเอียดอย่างเต็มรูปแบบ ให้ใช้คำสั่ง adb shell setprop debug.nn.vlog all หากต้องการปิดใช้การบันทึกแบบละเอียด ให้ใช้คำสั่ง adb shell setprop debug.nn.vlog '""'
เมื่อเปิดใช้แล้ว การบันทึกแบบละเอียดจะสร้างรายการบันทึกที่ระดับ INFO โดยมีแท็กที่ตั้งค่าเป็นชื่อเฟสหรือคอมโพเนนต์
นอกจากข้อความที่ควบคุมโดย debug.nn.vlog แล้ว คอมโพเนนต์ NNAPI API ยังมีรายการบันทึกอื่นๆ ในระดับต่างๆ โดยแต่ละรายการจะใช้แท็กบันทึกที่เฉพาะเจาะจง
หากต้องการดูรายการคอมโพเนนต์ ให้ค้นหาโครงสร้างแหล่งที่มาโดยใช้นิพจน์ต่อไปนี้
grep -R 'define LOG_TAG' | awk -F '"' '{print $2}' | sort -u | egrep -v "Sample|FileTag|test"
ปัจจุบันนิพจน์นี้จะแสดงผลแท็กต่อไปนี้
- BurstBuilder
- Callback
- CompilationBuilder
- CpuExecutor
- ExecutionBuilder
- ExecutionBurstController
- ExecutionBurstServer
- ExecutionPlan
- FibonacciDriver
- GraphDump
- IndexedShapeWrapper
- IonWatcher
- ผู้จัดการ
- หน่วยความจำ
- MemoryUtils
- MetaModel
- ModelArgumentInfo
- ModelBuilder
- NeuralNetworks
- OperationResolver
- การดำเนินการ
- OperationsUtils
- PackageInfo
- TokenHasher
- TypeManager
- Utils
- ValidateHal
- VersionedInterfaces
หากต้องการควบคุมระดับของข้อความในบันทึกที่แสดงโดย logcat ให้ใช้ตัวแปรสภาพแวดล้อม ANDROID_LOG_TAGS
หากต้องการแสดงข้อความในบันทึก NNAPI ทั้งชุดและปิดใช้ข้อความอื่นๆ ให้ตั้งค่า ANDROID_LOG_TAGS เป็นค่าต่อไปนี้
BurstBuilder:V Callbacks:V CompilationBuilder:V CpuExecutor:V ExecutionBuilder:V ExecutionBurstController:V ExecutionBurstServer:V ExecutionPlan:V FibonacciDriver:V GraphDump:V IndexedShapeWrapper:V IonWatcher:V Manager:V MemoryUtils:V Memory:V MetaModel:V ModelArgumentInfo:V ModelBuilder:V NeuralNetworks:V OperationResolver:V OperationsUtils:V Operations:V PackageInfo:V TokenHasher:V TypeManager:V Utils:V ValidateHal:V VersionedInterfaces:V *:S.
คุณตั้งค่า ANDROID_LOG_TAGS ได้โดยใช้คำสั่งต่อไปนี้
export ANDROID_LOG_TAGS=$(grep -R 'define LOG_TAG' | awk -F '"' '{ print $2 ":V" }' | sort -u | egrep -v "Sample|FileTag|test" | xargs echo -n; echo ' *:S')
โปรดทราบว่านี่เป็นเพียงตัวกรองที่ใช้กับ logcat เท่านั้น คุณยังคงต้องตั้งค่าพร็อพเพอร์ตี้ debug.nn.vlog เป็น all เพื่อสร้างข้อมูลบันทึกแบบละเอียด