

Android Neural Networks API (NNAPI) هي واجهة برمجة تطبيقات Android C مصمَّمة لتشغيل العمليات التي تتطلّب موارد حوسبة مكثّفة لتعلُّم الآلة على أجهزة Android. تم تصميم واجهة برمجة التطبيقات NNAPI لتوفير طبقة أساسية من الوظائف لأُطر عمل تعلُّم الآلة ذات المستوى الأعلى، مثل TensorFlow Lite وCaffe2، التي تنشئ الشبكات العصبية وتدرّبها. تتوفّر واجهة برمجة التطبيقات هذه على جميع أجهزة Android التي تعمل بالإصدار Android 8.1 (المستوى 27 من واجهة برمجة التطبيقات) أو الإصدارات الأحدث، ولكن تم إيقافها نهائيًا في الإصدار Android 15.
تتيح واجهة NNAPI الاستدلال من خلال تطبيق البيانات من أجهزة Android على النماذج التي تم تدريبها مسبقًا والتي حدّدها المطوّر. وتشمل أمثلة الاستدلال تصنيف الصور وتوقُّع سلوك المستخدم واختيار الردود المناسبة لطلب بحث معيّن.
توفّر ميزة الاستدلال على الجهاز فقط العديد من المزايا:
- وقت الاستجابة: لا تحتاج إلى إرسال طلب عبر اتصال بالشبكة وانتظار الردّ. على سبيل المثال، يمكن أن يكون هذا أمرًا بالغ الأهمية لتطبيقات الفيديو التي تعالج الإطارات المتتالية القادمة من الكاميرا.
- مدى التوفّر: يعمل التطبيق حتى خارج نطاق تغطية الشبكة.
- السرعة: توفّر الأجهزة الجديدة المخصّصة لمعالجة الشبكات العصبية عمليات حسابية أسرع بكثير من وحدة المعالجة المركزية (CPU) العامة الأغراض وحدها.
- الخصوصية: لا تتم مشاركة البيانات خارج جهاز Android.
- التكلفة: لا حاجة إلى مركز بيانات عندما يتم إجراء جميع العمليات الحسابية على جهاز Android.
هناك أيضًا بعض الجوانب التي يجب أن يضعها المطوّر في الاعتبار:
- استخدام النظام: يتطلّب تقييم الشبكات العصبية الكثير من العمليات الحسابية، ما قد يؤدي إلى زيادة استخدام طاقة البطارية. ننصحك بمراقبة صحة البطارية إذا كان هذا الأمر يهمّك في تطبيقك، خاصةً بالنسبة إلى العمليات الحسابية التي تستغرق وقتًا طويلاً.
- حجم التطبيق: انتبه إلى حجم النماذج. قد تشغل النماذج مساحة عدة ميغابايت. إذا كان تجميع النماذج الكبيرة في حزمة APK سيؤثر سلبًا في المستخدمين، يمكنك تنزيل النماذج بعد تثبيت التطبيق أو استخدام نماذج أصغر أو إجراء العمليات الحسابية في السحابة الإلكترونية. لا توفّر واجهة NNAPI وظائف لتشغيل النماذج في السحابة الإلكترونية.
يمكنك الاطّلاع على نموذج واجهة برمجة التطبيقات Android Neural Networks API لمعرفة مثال على كيفية استخدام NNAPI.
فهم وقت تشغيل واجهة برمجة التطبيقات Neural Networks API
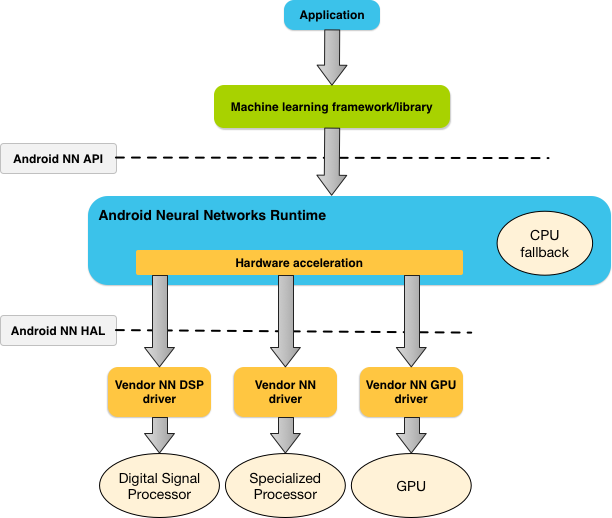
تم تصميم واجهة NNAPI ليتم استدعاؤها من خلال مكتبات وأُطر عمل وأدوات تعلُّم الآلة التي تتيح للمطوّرين تدريب نماذجهم خارج الجهاز ونشرها على أجهزة Android. لا تستخدم التطبيقات عادةً واجهة NNAPI مباشرةً، بل تستخدم أُطر عمل تعلُّم الآلة ذات المستوى الأعلى. ويمكن لهذه الأُطر بدورها استخدام واجهة NNAPI لإجراء عمليات استنتاج مستندة إلى تسريع الأجهزة على الأجهزة المتوافقة.
استنادًا إلى متطلبات التطبيق وإمكانات الأجهزة على جهاز Android، يمكن لبيئة تشغيل الشبكة العصبية في Android توزيع عبء عمل الحوسبة بكفاءة على المعالِجات المتاحة على الجهاز، بما في ذلك أجهزة الشبكة العصبية المخصّصة ووحدات معالجة الرسومات (GPU) ومعالِجات الإشارات الرقمية (DSP).
بالنسبة إلى أجهزة Android التي لا تتضمّن برنامج تشغيل خاصًا بالمورّد، ينفّذ وقت تشغيل NNAPI الطلبات على وحدة المعالجة المركزية.
يوضّح الشكل 1 بنية النظام العالية المستوى لواجهة NNAPI.
نموذج برمجة واجهة برمجة تطبيقات الشبكات العصبية
لإجراء العمليات الحسابية باستخدام NNAPI، عليك أولاً إنشاء رسم بياني موجّه يحدّد العمليات الحسابية المطلوب إجراؤها. يشكّل هذا الرسم البياني الحسابي، بالإضافة إلى بيانات الإدخال (مثل الأوزان والتحيزات التي تم تمريرها من إطار عمل تعلُّم الآلة)، نموذجًا لتقييم وقت تشغيل NNAPI.
تستخدم واجهة NNAPI أربعة تجريدات رئيسية:
- النموذج: رسم بياني حسابي للعمليات الرياضية والقيم الثابتة التي يتم تعلُّمها من خلال عملية التدريب هذه العمليات خاصة
بالشبكات العصبية. وتشمل هذه العمليات الالتفاف الثنائي الأبعاد (2D) والتفعيل اللوجستي (الدالة السينية) والتفعيل الخطي المصحَّح (ReLU) وغير ذلك. إنشاء نموذج هو عملية متزامنة.
بعد إنشائه بنجاح، يمكن إعادة استخدامه في سلاسل المحادثات والمجموعات.
في NNAPI، يتم تمثيل النموذج كمثيل
ANeuralNetworksModel. - Compilation: يمثّل إعدادًا لتجميع نموذج NNAPI في رمز برمجي من مستوى أدنى. إنشاء مجموعة هو عملية متزامنة. بعد إنشائه بنجاح، يمكن إعادة استخدامه في سلاسل المحادثات وعمليات التنفيذ. في
NNAPI، يتم تمثيل كل عملية تجميع على أنّها مثيل
ANeuralNetworksCompilation. - الذاكرة: تمثّل الذاكرة المشتركة والملفات التي تم ربطها بالذاكرة ومخازن الذاكرة المؤقتة المماثلة. يتيح استخدام مخزن الذاكرة المؤقت لوقت تشغيل NNAPI نقل البيانات إلى برامج التشغيل
بشكل أكثر كفاءة. ينشئ التطبيق عادةً مخزنًا مؤقتًا واحدًا للذاكرة المشتركة يحتوي على كل موتر مطلوب لتحديد النموذج. يمكنك أيضًا استخدام مخازن الذاكرة المؤقتة لتخزين المدخلات والمخرجات لمثيل التنفيذ. في NNAPI،
يتم تمثيل كل مخزن مؤقت للذاكرة على أنّه مثيل
ANeuralNetworksMemory. التنفيذ: واجهة لتطبيق نموذج NNAPI على مجموعة من الإدخالات وجمع النتائج يمكن تنفيذها بشكل متزامن أو غير متزامن.
بالنسبة إلى التنفيذ غير المتزامن، يمكن أن تنتظر سلاسل محادثات متعددة على التنفيذ نفسه. عند اكتمال هذا التنفيذ، يتم تحرير جميع سلاسل التعليمات.
في NNAPI، يتم تمثيل كل عملية تنفيذ كـ
ANeuralNetworksExecutionمثيل.
يوضّح الشكل 2 مسار البرمجة الأساسي.
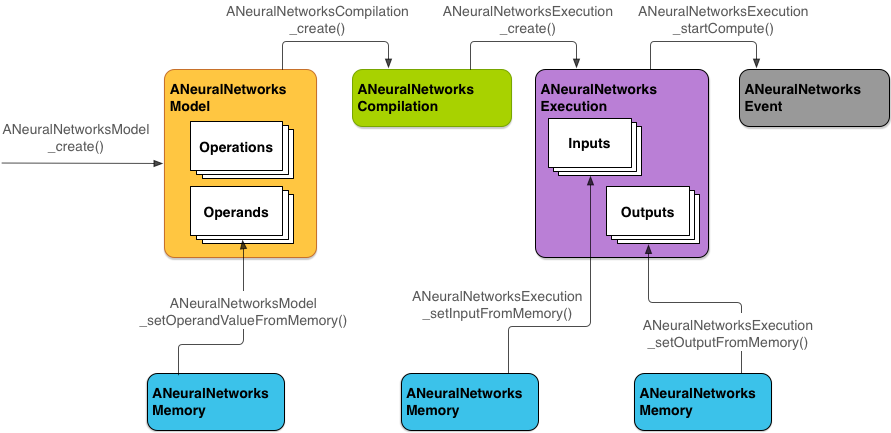
يصف الجزء المتبقي من هذا القسم خطوات إعداد نموذج NNAPI لإجراء العمليات الحسابية وتجميع النموذج وتنفيذه.
توفير إمكانية الوصول إلى بيانات التدريب
من المرجّح أن يتم تخزين بيانات الأوزان والانحيازات المدرَّبة في ملف. لتزويد وقت تشغيل NNAPI بإمكانية الوصول الفعّال إلى هذه البيانات، أنشئ مثيلاً ANeuralNetworksMemory من خلال استدعاء الدالة ANeuralNetworksMemory_createFromFd() وتمرير واصِف الملف لملف البيانات المفتوح. يمكنك أيضًا
تحديد علامات حماية الذاكرة والإزاحة التي تبدأ عندها منطقة الذاكرة المشتركة
في الملف.
// Create a memory buffer from the file that contains the trained data
ANeuralNetworksMemory* mem1 = NULL;
int fd = open("training_data", O_RDONLY);
ANeuralNetworksMemory_createFromFd(file_size, PROT_READ, fd, 0, &mem1);
على الرغم من أنّنا نستخدم في هذا المثال نسخة واحدة فقط من
ANeuralNetworksMemory
لجميع الأوزان، يمكن استخدام أكثر من نسخة واحدة من
ANeuralNetworksMemory لملفات متعددة.
استخدام مخازن الأجهزة المؤقتة الأصلية
يمكنك استخدام مخازن الأجهزة المؤقتة الأصلية
لإدخالات النماذج ومخرجاتها وقيم المعاملات الثابتة. في بعض الحالات، يمكن لمسرِّع NNAPI الوصول إلى عناصر
AHardwareBuffer
بدون حاجة برنامج التشغيل إلى نسخ البيانات. يحتوي AHardwareBuffer على العديد من الإعدادات المختلفة، وقد لا تتيح بعض مسرّعات NNAPI كل هذه الإعدادات. بسبب هذا القيد، يُرجى الرجوع إلى القيود
المدرَجة في
مستندات مرجع ANeuralNetworksMemory_createFromAHardwareBuffer
وإجراء الاختبار مسبقًا على الأجهزة المستهدَفة لضمان أنّ عمليات التجميع والتنفيذ
التي تستخدم AHardwareBuffer تعمل على النحو المتوقّع، وذلك باستخدام
تحديد الجهاز لتحديد المسرِّع.
للسماح لوقت تشغيل NNAPI بالوصول إلى عنصر AHardwareBuffer، أنشئ مثيلاً لـ ANeuralNetworksMemory من خلال استدعاء الدالة ANeuralNetworksMemory_createFromAHardwareBuffer وتمرير عنصر AHardwareBuffer، كما هو موضّح في عينة التعليمات البرمجية التالية:
// Configure and create AHardwareBuffer object
AHardwareBuffer_Desc desc = ...
AHardwareBuffer* ahwb = nullptr;
AHardwareBuffer_allocate(&desc, &ahwb);

// Create ANeuralNetworksMemory from AHardwareBuffer
ANeuralNetworksMemory* mem2 = NULL;
ANeuralNetworksMemory_createFromAHardwareBuffer(ahwb, &mem2);
عندما لا تحتاج واجهة NNAPI إلى الوصول إلى عنصر AHardwareBuffer، يمكنك إخلاء مثيل ANeuralNetworksMemory المقابل:
ANeuralNetworksMemory_free(mem2);
ملاحظة:
- يمكنك استخدام
AHardwareBufferفقط للمخزن المؤقت بالكامل، ولا يمكنك استخدامه مع مَعلمةARect. - لن يفرغ وقت تشغيل NNAPI المخزن المؤقت. يجب التأكّد من إمكانية الوصول إلى مخازن الإدخال والإخراج المؤقتة قبل جدولة التنفيذ.
- لا تتوفّر ميزة واصفات ملفات سياج المزامنة.
- بالنسبة إلى
AHardwareBufferالذي يتضمّن تنسيقات خاصة بالمورّد ووحدات بت للاستخدام، يعود الأمر إلى تنفيذ المورّد لتحديد ما إذا كان العميل أو برنامج التشغيل مسؤولاً عن محو ذاكرة التخزين المؤقت.
الطراز
النموذج هو الوحدة الأساسية للحوسبة في واجهة برمجة التطبيقات NNAPI. يتم تحديد كل نموذج من خلال معامل واحد أو أكثر وعمليات.
المعاملات
المعاملات هي عناصر بيانات تُستخدَم في تحديد الرسم البياني. وتشمل هذه العناصر مدخلات النموذج ومخرجاته، والعُقد الوسيطة التي تحتوي على البيانات التي تتدفق من عملية إلى أخرى، والثوابت التي يتم تمريرها إلى هذه العمليات.
هناك نوعان من المعاملات التي يمكن إضافتها إلى نماذج NNAPI: الكميات القياسية والموترات.
تمثّل القيمة العددية قيمة واحدة. تتيح واجهة NNAPI استخدام القيم العددية بتنسيقات منطقية، وتنسيقات النقطة العائمة 16 بت، والنقطة العائمة 32 بت، والأعداد الصحيحة 32 بت، والأعداد الصحيحة غير الموقَّعة 32 بت.
تتضمّن معظم العمليات في NNAPI الموتّرات. الموتّرات هي صفائف ذات أبعاد ن. تتوافق واجهة NNAPI مع الموتّرات التي تتضمّن قيمًا منطقية ذات فاصلة عائمة 16 بت وفاصلة عائمة 32 بت ومُكمَّمة 8 بت ومُكمَّمة 16 بت وأعداد صحيحة 32 بت و8 بت.
على سبيل المثال، يمثّل الشكل 3 نموذجًا يتضمّن عمليتَين: عملية جمع تليها عملية ضرب. يأخذ النموذج موتر إدخال وينتج موتر إخراج واحد.
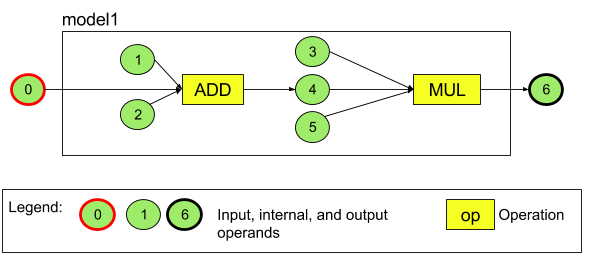
يحتوي النموذج أعلاه على سبعة معاملات. يتم تحديد هذه المعاملات ضمنيًا من خلال فهرس الترتيب الذي تتم إضافتها به إلى النموذج. ويكون فهرس المعامل الأول الذي تمت إضافته هو 0، وفهرس المعامل الثاني هو 1، وهكذا. المعاملات 1 و2 و3 و5 هي معاملات ثابتة.
لا يهم الترتيب الذي تضيف به المعاملات. على سبيل المثال، يمكن أن يكون معامل مخرجات النموذج هو أول معامل تتم إضافته. والجزء المهم هو استخدام قيمة الفهرس الصحيحة عند الإشارة إلى معامل.
المعاملات لها أنواع. ويتم تحديدها عند إضافتها إلى النموذج.
لا يمكن استخدام معامل كإدخال وإخراج لنموذج.
يجب أن يكون كل معامل إما إدخال نموذج أو ثابتًا أو معامل ناتج لعملية واحدة بالضبط.
للحصول على معلومات إضافية حول استخدام المعاملات، يُرجى الاطّلاع على مزيد من المعلومات حول المعاملات.
العمليات
تحدّد العملية العمليات الحسابية المطلوب تنفيذها. تتكوّن كل عملية من العناصر التالية:
- نوع العملية (على سبيل المثال، الجمع، الضرب، الالتفاف)،
- قائمة بفهارس المعاملات التي تستخدمها العملية للإدخال،
- قائمة بفهارس المعاملات التي تستخدمها العملية للإخراج.
يُعدّ الترتيب في هذه القوائم مهمًا، لذا يُرجى الاطّلاع على مرجع واجهة برمجة التطبيقات NNAPI لمعرفة المدخلات والمخرجات المتوقّعة لكل نوع من أنواع العمليات.
يجب إضافة المعاملات التي تستهلكها العملية أو تنتجها إلى النموذج قبل إضافة العملية.
لا يهم الترتيب الذي تضيف به العمليات. تعتمد واجهة NNAPI على التبعيات التي تم إنشاؤها بواسطة الرسم البياني الحسابي للمعاملات والعمليات لتحديد الترتيب الذي يتم به تنفيذ العمليات.
يتم تلخيص العمليات التي تتيحها واجهة NNAPI في الجدول أدناه:
مشكلة معروفة في المستوى 28 لواجهة برمجة التطبيقات: عند تمرير
ANEURALNETWORKS_TENSOR_QUANT8_ASYMM
مصفوفات متعدّدة الأبعاد إلى العملية
ANEURALNETWORKS_PAD
المتوفّرة على نظام التشغيل Android 9 (المستوى 28 لواجهة برمجة التطبيقات) والإصدارات الأحدث، قد لا يتطابق الناتج من واجهة برمجة التطبيقات للشبكة العصبية (NNAPI) مع الناتج من أُطر عمل تعلُّم الآلة ذات المستوى الأعلى، مثل
TensorFlow Lite. بدلاً من ذلك، يجب تمرير ANEURALNETWORKS_TENSOR_FLOAT32 فقط.
تم حلّ المشكلة في الإصدار 10 من نظام التشغيل Android (المستوى 29 من واجهة برمجة التطبيقات) والإصدارات الأحدث.
إنشاء النماذج
في المثال التالي، ننشئ نموذج العمليتين الموضح في الشكل 3.
لإنشاء النموذج، اتّبِع الخطوات التالية:
استدعِ الدالة
ANeuralNetworksModel_create()لتحديد نموذج فارغ.ANeuralNetworksModel* model = NULL; ANeuralNetworksModel_create(&model);
أضِف المعاملات إلى النموذج من خلال استدعاء
ANeuralNetworks_addOperand(). يتم تحديد أنواع البيانات باستخدام بنية البياناتANeuralNetworksOperandType.// In our example, all our tensors are matrices of dimension [3][4] ANeuralNetworksOperandType tensor3x4Type; tensor3x4Type.type = ANEURALNETWORKS_TENSOR_FLOAT32; tensor3x4Type.scale = 0.f; // These fields are used for quantized tensors tensor3x4Type.zeroPoint = 0; // These fields are used for quantized tensors tensor3x4Type.dimensionCount = 2; uint32_t dims[2] = {3, 4}; tensor3x4Type.dimensions = dims;
// We also specify operands that are activation function specifiers ANeuralNetworksOperandType activationType; activationType.type = ANEURALNETWORKS_INT32; activationType.scale = 0.f; activationType.zeroPoint = 0; activationType.dimensionCount = 0; activationType.dimensions = NULL;
// Now we add the seven operands, in the same order defined in the diagram ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 0 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 1 ANeuralNetworksModel_addOperand(model, &activationType); // operand 2 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 3 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 4 ANeuralNetworksModel_addOperand(model, &activationType); // operand 5 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 6بالنسبة إلى المعاملات التي لها قيم ثابتة، مثل الأوزان والانحيازات التي يحصل عليها تطبيقك من عملية تدريب، استخدِم الدالتَين
ANeuralNetworksModel_setOperandValue()وANeuralNetworksModel_setOperandValueFromMemory().في المثال التالي، نضبط القيم الثابتة من ملف بيانات التدريب المتوافق مع المخزن المؤقت للذاكرة الذي أنشأناه في توفير إمكانية الوصول إلى بيانات التدريب.
// In our example, operands 1 and 3 are constant tensors whose values were
// established during the training process
const int sizeOfTensor = 3 * 4 * 4;    // The formula for size calculation is dim0 * dim1 * elementSize
ANeuralNetworksModel_setOperandValueFromMemory(model, 1, mem1, 0, sizeOfTensor);
ANeuralNetworksModel_setOperandValueFromMemory(model, 3, mem1, sizeOfTensor, sizeOfTensor);


// We set the values of the activation operands, in our example operands 2 and 5
int32_t noneValue = ANEURALNETWORKS_FUSED_NONE;
ANeuralNetworksModel_setOperandValue(model, 2, &noneValue, sizeof(noneValue));
ANeuralNetworksModel_setOperandValue(model, 5, &noneValue, sizeof(noneValue));
بالنسبة إلى كل عملية في الرسم البياني الموجَّه الذي تريد حسابه، أضِف العملية إلى النموذج من خلال استدعاء الدالة
ANeuralNetworksModel_addOperation().يجب أن يوفّر تطبيقك ما يلي كمَعلمات لهذا الطلب:
- نوع العملية
- عدد القيم المُدخلة
- مصفوفة الفهارس للمعاملات المُدخلة
- عدد قيم الناتج
- مصفوفة الفهارس لمعاملات الإخراج
يُرجى العِلم أنّه لا يمكن استخدام معامل لكل من الإدخال والإخراج في العملية نفسها.
// We have two operations in our example
// The first consumes operands 1, 0, 2, and produces operand 4
uint32_t addInputIndexes[3] = {1, 0, 2};
uint32_t addOutputIndexes[1] = {4};
ANeuralNetworksModel_addOperation(model, ANEURALNETWORKS_ADD, 3, addInputIndexes, 1, addOutputIndexes);


// The second consumes operands 3, 4, 5, and produces operand 6
uint32_t multInputIndexes[3] = {3, 4, 5};
uint32_t multOutputIndexes[1] = {6};
ANeuralNetworksModel_addOperation(model, ANEURALNETWORKS_MUL, 3, multInputIndexes, 1, multOutputIndexes);
حدِّد المعاملات التي يجب أن يتعامل معها النموذج كمدخلات ومخرجات من خلال استدعاء الدالة
ANeuralNetworksModel_identifyInputsAndOutputs().// Our model has one input (0) and one output (6) uint32_t modelInputIndexes[1] = {0}; uint32_t modelOutputIndexes[1] = {6}; ANeuralNetworksModel_identifyInputsAndOutputs(model, 1, modelInputIndexes, 1 modelOutputIndexes);
يمكنك اختياريًا تحديد ما إذا كان يُسمح بحساب
ANEURALNETWORKS_TENSOR_FLOAT32بنطاق أو دقة منخفضة مثل تنسيق النقطة العائمة IEEE 754 16 بت من خلال استدعاءANeuralNetworksModel_relaxComputationFloat32toFloat16().استخدِم الدالة
ANeuralNetworksModel_finish()لإنهاء تعريف النموذج. في حال عدم حدوث أي أخطاء، تعرض هذه الدالة رمز النتيجةANEURALNETWORKS_NO_ERROR.ANeuralNetworksModel_finish(model);
بعد إنشاء نموذج، يمكنك تجميعه أي عدد من المرات وتنفيذ كل عملية تجميع أي عدد من المرات.
التحكّم في التدفق
لدمج تدفق التحكم في نموذج NNAPI، قم بما يلي:
أنشئ الرسوم البيانية الفرعية للتنفيذ المقابلة (الرسوم البيانية الفرعية
thenوelseلعبارةIF، والرسوم البيانية الفرعيةconditionوbodyلحلقةWHILE) كنماذجANeuralNetworksModel*مستقلة:ANeuralNetworksModel* thenModel = makeThenModel(); ANeuralNetworksModel* elseModel = makeElseModel();
أنشئ معاملات تشير إلى تلك النماذج داخل النموذج الذي يحتوي على تدفق التحكم:
ANeuralNetworksOperandType modelType = {
    .type = ANEURALNETWORKS_MODEL,
};
ANeuralNetworksModel_addOperand(model, &modelType);  // kThenOperandIndex
ANeuralNetworksModel_addOperand(model, &modelType);  // kElseOperandIndex
ANeuralNetworksModel_setOperandValueFromModel(model, kThenOperandIndex, &thenModel);
ANeuralNetworksModel_setOperandValueFromModel(model, kElseOperandIndex, &elseModel);
أضِف عملية التحكّم في التدفق:
uint32_t inputs[] = {kConditionOperandIndex,
                     kThenOperandIndex,
                     kElseOperandIndex,
                     kInput1, kInput2, kInput3};
uint32_t outputs[] = {kOutput1, kOutput2};
ANeuralNetworksModel_addOperation(model, ANEURALNETWORKS_IF,
                                  std::size(inputs), inputs,
                                  std::size(output), outputs);
موسيقى مجمّعة
تحدّد خطوة التجميع المعالجات التي سيتم تنفيذ النموذج عليها وتطلب من برامج التشغيل المقابلة الاستعداد لتنفيذه. وقد يشمل ذلك إنشاء لغة آلة خاصة بالمعالجات التي سيتم تشغيل النموذج عليها.
لتجميع نموذج، اتّبِع الخطوات التالية:
استدعِ الدالة
ANeuralNetworksCompilation_create()لإنشاء مثيل تجميع جديد.// Compile the model ANeuralNetworksCompilation* compilation; ANeuralNetworksCompilation_create(model, &compilation);
يمكنك اختياريًا استخدام تخصيص الأجهزة لاختيار الأجهزة التي تريد تنفيذ الاختبار عليها بشكل صريح.
يمكنك اختياريًا التأثير في كيفية موازنة وقت التشغيل بين استخدام طاقة البطارية وسرعة التنفيذ. يمكنك إجراء ذلك من خلال الاتصال بالرقم
ANeuralNetworksCompilation_setPreference().// Ask to optimize for low power consumption ANeuralNetworksCompilation_setPreference(compilation, ANEURALNETWORKS_PREFER_LOW_POWER);
تشمل الإعدادات المفضّلة التي يمكنك تحديدها ما يلي:
ANEURALNETWORKS_PREFER_LOW_POWER: يُفضَّل تنفيذ المهام بطريقة تقلّل من استنزاف البطارية. هذا مرغوب فيه لعمليات التجميع التي يتم تنفيذها كثيرًا.ANEURALNETWORKS_PREFER_FAST_SINGLE_ANSWER: يُفضَّل عرض إجابة واحدة في أسرع وقت ممكن، حتى إذا كان ذلك يؤدي إلى زيادة استهلاك الطاقة. وهذا هو الخيار التلقائي.ANEURALNETWORKS_PREFER_SUSTAINED_SPEED: يُفضَّل زيادة معدّل نقل البيانات للّقطات المتتالية إلى أقصى حد، مثلاً عند معالجة اللقطات المتتالية الواردة من الكاميرا.
يمكنك اختياريًا إعداد ميزة التخزين المؤقت لعمليات التجميع من خلال استدعاء
ANeuralNetworksCompilation_setCaching.// Set up compilation caching ANeuralNetworksCompilation_setCaching(compilation, cacheDir, token);
استخدِم
getCodeCacheDir()لـcacheDir. يجب أن يكونtokenالمحدد فريدًا لكل نموذج داخل التطبيق.يمكنك إنهاء تعريف التجميع من خلال استدعاء
ANeuralNetworksCompilation_finish(). في حال عدم حدوث أي أخطاء، تعرض هذه الدالة رمز النتيجةANEURALNETWORKS_NO_ERROR.ANeuralNetworksCompilation_finish(compilation);
اكتشاف الأجهزة وتعيينها
على أجهزة Android التي تعمل بالإصدار 10 من نظام التشغيل Android (المستوى 29 من واجهة برمجة التطبيقات) والإصدارات الأحدث، توفّر واجهة NNAPI وظائف تتيح لمكتبات وتطبيقات إطار عمل تعلُّم الآلة الحصول على معلومات حول الأجهزة المتاحة وتحديد الأجهزة التي سيتم استخدامها للتنفيذ. يتيح توفير معلومات عن الأجهزة المتاحة للتطبيقات الحصول على الإصدار الدقيق لبرامج التشغيل المتوفّرة على الجهاز لتجنُّب حالات عدم التوافق المعروفة. من خلال منح التطبيقات إمكانية تحديد الأجهزة التي ستنفّذ أقسامًا مختلفة من النموذج، يمكن تحسين التطبيقات لتتوافق مع جهاز Android الذي يتم نشرها عليه.
رصد الأجهزة
استخدِم
ANeuralNetworks_getDeviceCount
لمعرفة عدد الأجهزة المتاحة. لكل جهاز، استخدِم
ANeuralNetworks_getDevice
لضبط مثيل ANeuralNetworksDevice على مرجع لهذا الجهاز.
بعد الحصول على مرجع الجهاز، يمكنك العثور على معلومات إضافية عن هذا الجهاز باستخدام الدوال التالية:
ANeuralNetworksDevice_getFeatureLevelANeuralNetworksDevice_getNameANeuralNetworksDevice_getTypeANeuralNetworksDevice_getVersion
تخصيص الأجهزة
استخدِم
ANeuralNetworksModel_getSupportedOperationsForDevices
لمعرفة العمليات التي يمكن تنفيذها في نموذج على أجهزة معيّنة.
للتحكّم في مسرّعات الأجهزة التي يجب استخدامها للتنفيذ، يمكنك استدعاء
ANeuralNetworksCompilation_createForDevices
بدلاً من ANeuralNetworksCompilation_create.
استخدِم كائن ANeuralNetworksCompilation الناتج كالمعتاد.
تعرض الدالة خطأ إذا كان النموذج المقدَّم يحتوي على عمليات غير متوافقة مع الأجهزة المحدّدة.
If multiple devices are specified, the runtime is responsible for distributing the work across the devices.
على غرار الأجهزة الأخرى، يتم تمثيل تنفيذ وحدة المعالجة المركزية (CPU) في NNAPI من خلال
ANeuralNetworksDevice بالاسم nnapi-reference والنوع
ANEURALNETWORKS_DEVICE_TYPE_CPU. عند استدعاء
ANeuralNetworksCompilation_createForDevices، لا يتم استخدام تنفيذ وحدة المعالجة المركزية
لمعالجة حالات الفشل في تجميع النماذج وتنفيذها.
تقع على عاتق التطبيق مسؤولية تقسيم النموذج إلى نماذج فرعية يمكن تشغيلها على الأجهزة المحدّدة. بالنسبة إلى التطبيقات التي لا تحتاج إلى إجراء تقسيم يدوي،
يجب أن تواصل طلب الدالة الأبسط
ANeuralNetworksCompilation_create
لاستخدام جميع الأجهزة المتاحة (بما في ذلك وحدة المعالجة المركزية) لتسريع
النموذج. إذا لم يكن النموذج متوافقًا بشكل كامل مع الأجهزة التي حدّدتها باستخدام ANeuralNetworksCompilation_createForDevices، يتم عرض ANEURALNETWORKS_BAD_DATA.
تقسيم النموذج
عندما تتوفّر أجهزة متعددة للنموذج، يوزّع وقت تشغيل NNAPI العمل على الأجهزة. على سبيل المثال، إذا تم توفير أكثر من جهاز واحد لـ ANeuralNetworksCompilation_createForDevices، سيتم أخذ جميع الأجهزة المحدّدة في الاعتبار عند تخصيص العمل. يُرجى العِلم أنّه في حال عدم توفّر جهاز وحدة المعالجة المركزية في القائمة، سيتم إيقاف تنفيذ وحدة المعالجة المركزية. عند استخدام ANeuralNetworksCompilation_create، سيتم أخذ جميع الأجهزة المتاحة في الاعتبار، بما في ذلك وحدة المعالجة المركزية (CPU).
يتم التوزيع من خلال الاختيار من قائمة الأجهزة المتاحة، لكل عملية من العمليات في النموذج، الجهاز الذي يدعم العملية ويعلن عن أفضل أداء، أي أسرع وقت تنفيذ أو أقل استهلاك للطاقة، اعتمادًا على تفضيل التنفيذ الذي يحدده العميل. لا تأخذ خوارزمية التقسيم هذه في الاعتبار أوجه القصور المحتملة الناتجة عن الإدخال/الإخراج بين المعالجات المختلفة، لذا عند تحديد معالجات متعددة (إما بشكل صريح عند استخدام ANeuralNetworksCompilation_createForDevices أو بشكل ضمني باستخدام ANeuralNetworksCompilation_create)، من المهم تحديد ملف تعريف التطبيق الناتج.
لمعرفة كيفية تقسيم النموذج بواسطة NNAPI، يمكنك الاطّلاع على
سجلّات Android بحثًا عن رسالة (على مستوى INFO مع العلامة ExecutionPlan):
ModelBuilder::findBestDeviceForEachOperation(op-name): device-index
op-name هو الاسم الوصفي للعملية في الرسم البياني وdevice-index هو فهرس الجهاز المرشَّح في قائمة الأجهزة.
هذه القائمة هي الإدخال المقدَّم إلى ANeuralNetworksCompilation_createForDevices
أو، في حال استخدام ANeuralNetworksCompilation_createForDevices، قائمة الأجهزة
التي يتم عرضها عند التكرار على جميع الأجهزة باستخدام ANeuralNetworks_getDeviceCount و
ANeuralNetworks_getDevice.
الرسالة (على مستوى INFO مع العلامة ExecutionPlan):
ModelBuilder::partitionTheWork: only one best device: device-name
تشير هذه الرسالة إلى أنّه تم تسريع الرسم البياني بالكامل على الجهاز
device-name.
التنفيذ
تطبّق خطوة التنفيذ النموذج على مجموعة من المدخلات وتخزّن مخرجات العمليات الحسابية في مخزن مؤقت واحد أو أكثر للمستخدم أو مساحات الذاكرة التي خصّصها تطبيقك.
لتنفيذ نموذج مجمَّع، اتّبِع الخطوات التالية:
استدعِ الدالة
ANeuralNetworksExecution_create()لإنشاء مثيل تنفيذ جديد.// Run the compiled model against a set of inputs ANeuralNetworksExecution* run1 = NULL; ANeuralNetworksExecution_create(compilation, &run1);
حدِّد المكان الذي يقرأ منه تطبيقك قيم الإدخال لإجراء العملية الحسابية. يمكن لتطبيقك قراءة قيم الإدخال من مخزن مؤقت للمستخدم أو من مساحة ذاكرة مخصّصة من خلال استدعاء
ANeuralNetworksExecution_setInput()أوANeuralNetworksExecution_setInputFromMemory()على التوالي.// Set the single input to our sample model. Since it is small, we won't use a memory buffer float32 myInput[3][4] = { ...the data... }; ANeuralNetworksExecution_setInput(run1, 0, NULL, myInput, sizeof(myInput));
حدِّد المكان الذي يكتب فيه تطبيقك قيم الإخراج. يمكن لتطبيقك كتابة قيم الإخراج إما في مخزن مؤقت للمستخدم أو في مساحة ذاكرة مخصّصة، وذلك من خلال استدعاء
ANeuralNetworksExecution_setOutput()أوANeuralNetworksExecution_setOutputFromMemory()على التوالي.// Set the output float32 myOutput[3][4]; ANeuralNetworksExecution_setOutput(run1, 0, NULL, myOutput, sizeof(myOutput));
حدِّد موعدًا لبدء التنفيذ من خلال استدعاء الدالة
ANeuralNetworksExecution_startCompute(). في حال عدم حدوث أي أخطاء، تعرض هذه الدالة رمز النتيجةANEURALNETWORKS_NO_ERROR.// Starts the work. The work proceeds asynchronously ANeuralNetworksEvent* run1_end = NULL; ANeuralNetworksExecution_startCompute(run1, &run1_end);
استدعِ الدالة
ANeuralNetworksEvent_wait()للانتظار حتى يكتمل التنفيذ. إذا تم التنفيذ بنجاح، ستعرض هذه الدالة رمز النتيجةANEURALNETWORKS_NO_ERROR. يمكن الانتظار في سلسلة محادثات مختلفة عن تلك التي تبدأ التنفيذ.// For our example, we have no other work to do and will just wait for the completion ANeuralNetworksEvent_wait(run1_end); ANeuralNetworksEvent_free(run1_end); ANeuralNetworksExecution_free(run1);
يمكنك اختياريًا تطبيق مجموعة مختلفة من المدخلات على النموذج المجمَّع باستخدام مثيل التجميع نفسه لإنشاء مثيل
ANeuralNetworksExecutionجديد.// Apply the compiled model to a different set of inputs ANeuralNetworksExecution* run2; ANeuralNetworksExecution_create(compilation, &run2); ANeuralNetworksExecution_setInput(run2, ...); ANeuralNetworksExecution_setOutput(run2, ...); ANeuralNetworksEvent* run2_end = NULL; ANeuralNetworksExecution_startCompute(run2, &run2_end); ANeuralNetworksEvent_wait(run2_end); ANeuralNetworksEvent_free(run2_end); ANeuralNetworksExecution_free(run2);
التنفيذ المتزامن
يستغرق التنفيذ غير المتزامن وقتًا لإنشاء سلاسل المحادثات ومزامنتها. علاوة على ذلك، يمكن أن يكون وقت الاستجابة متغيرًا بشكل كبير، مع أطول تأخيرات تصل إلى 500 ميكروثانية بين وقت إخطار سلسلة المحادثات أو استيقاظها والوقت الذي يتم فيه ربطها في النهاية بنواة وحدة المعالجة المركزية.
لتحسين وقت الاستجابة، يمكنك بدلاً من ذلك توجيه تطبيق لإجراء مكالمة استنتاج متزامنة مع وقت التشغيل. لن يتم عرض هذا الطلب إلا بعد اكتمال عملية الاستنتاج، وليس بعد بدئها. بدلاً من استدعاء ANeuralNetworksExecution_startCompute لإجراء استدعاء استدلال غير متزامن لوقت التشغيل، يستدعي التطبيق ANeuralNetworksExecution_compute لإجراء استدعاء متزامن لوقت التشغيل. لا يتطلّب استدعاء الدالة
ANeuralNetworksExecution_compute استخدام ANeuralNetworksEvent
ولا يتم إقرانه باستدعاء الدالة ANeuralNetworksEvent_wait.
عمليات التنفيذ السريعة
على أجهزة Android التي تعمل بالإصدار 10 من نظام التشغيل Android (المستوى 29 من واجهة برمجة التطبيقات) والإصدارات الأحدث، تتيح واجهة NNAPI عمليات التنفيذ المتسلسل من خلال الكائن ANeuralNetworksBurst. عمليات التنفيذ المتسلسلة هي سلسلة من عمليات تنفيذ التجميع نفسه
التي تحدث بتتابع سريع، مثل تلك التي تعمل على لقطات من الكاميرا
أو عينات صوتية متتالية. قد يؤدي استخدام عناصر ANeuralNetworksBurst إلى تنفيذ أسرع، لأنّها تشير إلى المسرّعات بأنّه يمكن إعادة استخدام الموارد بين عمليات التنفيذ وأنّ المسرّعات يجب أن تظل في حالة أداء عالٍ طوال مدة الاندفاع.
يُدخل ANeuralNetworksBurst تغييرًا بسيطًا فقط في مسار التنفيذ العادي. يمكنك إنشاء عنصر لقطة سريعة باستخدام
ANeuralNetworksBurst_create،
كما هو موضّح في مقتطف الرمز التالي:
// Create burst object to be reused across a sequence of executions
ANeuralNetworksBurst* burst = NULL;
ANeuralNetworksBurst_create(compilation, &burst);
تكون عمليات التنفيذ المتزامنة متزامنة. ومع ذلك، بدلاً من استخدام
ANeuralNetworksExecution_compute
لإجراء كل استنتاج، يمكنك إقران عناصر
ANeuralNetworksExecution
المختلفة مع ANeuralNetworksBurst نفسه في طلبات الدالة
ANeuralNetworksExecution_burstCompute.
// Create and configure first execution object
// ...

// Execute using the burst object
ANeuralNetworksExecution_burstCompute(execution1, burst);

// Use results of first execution and free the execution object
// ...

// Create and configure second execution object
// ...

// Execute using the same burst object
ANeuralNetworksExecution_burstCompute(execution2, burst);

// Use results of second execution and free the execution object
// ...
يمكنك تحرير عنصر ANeuralNetworksBurst باستخدام
ANeuralNetworksBurst_free
عندما لا تعود هناك حاجة إليه.
// Cleanup
ANeuralNetworksBurst_free(burst);
قوائم انتظار الأوامر غير المتزامنة والتنفيذ المحمي
في Android 11 والإصدارات الأحدث، تتيح واجهة NNAPI طريقة إضافية لجدولة
التنفيذ غير المتزامن من خلال
طريقة
ANeuralNetworksExecution_startComputeWithDependencies(). عند استخدام هذه الطريقة، ينتظر التنفيذ حتى يتم إرسال إشارة إلى جميع الأحداث التابعة قبل بدء التقييم. بعد اكتمال التنفيذ
وتصبح المخرجات جاهزة للاستخدام، يتم إرسال إشارة إلى الحدث الذي تم إرجاعه.
استنادًا إلى الأجهزة التي تتعامل مع التنفيذ، قد يكون الحدث مدعومًا
بسياج مزامنة. يجب استدعاء
ANeuralNetworksEvent_wait()
للانتظار حتى انتهاء الحدث واستعادة الموارد التي استخدمها التنفيذ. يمكنك
استيراد حدود المزامنة إلى عنصر حدث باستخدام
ANeuralNetworksEvent_createFromSyncFenceFd()،
ويمكنك تصدير حدود المزامنة من عنصر حدث باستخدام
ANeuralNetworksEvent_getSyncFenceFd().
مخرجات بحجم ديناميكي
لدعم النماذج التي يعتمد فيها حجم الناتج على بيانات الإدخال، أي عندما لا يمكن تحديد الحجم في وقت تنفيذ النموذج، استخدِم ANeuralNetworksExecution_getOutputOperandRank وANeuralNetworksExecution_getOutputOperandDimensions.
يوضّح نموذج الرمز التالي كيفية إجراء ذلك:
// Get the rank of the output
uint32_t myOutputRank = 0;
ANeuralNetworksExecution_getOutputOperandRank(run1, 0, &myOutputRank);

// Get the dimensions of the output
std::vector<uint32_t> myOutputDimensions(myOutputRank);
ANeuralNetworksExecution_getOutputOperandDimensions(run1, 0, myOutputDimensions.data());
تنظيف
تتولى خطوة التنظيف تحرير الموارد الداخلية المستخدمة في الحساب.
// Cleanup
ANeuralNetworksCompilation_free(compilation);
ANeuralNetworksModel_free(model);
ANeuralNetworksMemory_free(mem1);
إدارة الأخطاء والعودة إلى وحدة المعالجة المركزية
إذا حدث خطأ أثناء التقسيم، أو إذا تعذّر على برنامج تشغيل تجميع (جزء من) نموذج، أو إذا تعذّر على برنامج تشغيل تنفيذ (جزء من) نموذج مجمَّع، قد تعود واجهة NNAPI إلى تنفيذ وحدة المعالجة المركزية الخاصة بها لعملية واحدة أو أكثر.
إذا كان برنامج NNAPI يحتوي على نُسخ محسَّنة من العملية (مثل TFLite)، قد يكون من المفيد إيقاف ميزة "العودة إلى وحدة المعالجة المركزية" ومعالجة حالات التعذُّر من خلال تنفيذ العملية المحسَّنة للبرنامج.
في Android 10، إذا تم إجراء التجميع باستخدام
ANeuralNetworksCompilation_createForDevices، سيتم إيقاف وحدة المعالجة المركزية الاحتياطية.
في Android P، يعود تنفيذ NNAPI إلى وحدة المعالجة المركزية في حال تعذّر التنفيذ على برنامج التشغيل.
وينطبق ذلك أيضًا على نظام التشغيل Android 10 عند استخدام ANeuralNetworksCompilation_create بدلاً من ANeuralNetworksCompilation_createForDevices.
يتم الرجوع إلى التنفيذ الأول لهذا القسم الفردي، وإذا استمر الفشل، تتم إعادة محاولة تنفيذ النموذج بالكامل على وحدة المعالجة المركزية.
إذا تعذّر التقسيم أو التجميع، ستتم تجربة النموذج بالكامل على وحدة المعالجة المركزية.
هناك حالات لا تتوفّر فيها بعض العمليات على وحدة المعالجة المركزية، وفي هذه الحالات، ستتعذّر عملية التجميع أو التنفيذ بدلاً من الرجوع إلى الإصدار السابق.
حتى بعد إيقاف ميزة "العودة إلى وحدة المعالجة المركزية"، قد تظل هناك عمليات في النموذج
مجدولة على وحدة المعالجة المركزية. إذا كانت وحدة المعالجة المركزية ضمن قائمة المعالجات المقدَّمة إلى ANeuralNetworksCompilation_createForDevices، وكانت المعالج الوحيد الذي يتيح تنفيذ هذه العمليات أو المعالج الذي يقدّم أفضل أداء لهذه العمليات، سيتم اختيارها كمنفّذ أساسي (غير احتياطي).
لضمان عدم تنفيذ وحدة المعالجة المركزية، استخدِم ANeuralNetworksCompilation_createForDevices
مع استبعاد nnapi-reference من قائمة الأجهزة.
بدءًا من الإصدار Android P، يمكن إيقاف الإجراء الاحتياطي في وقت التنفيذ على إصدارات مخصصة لتصحيح الأخطاء من خلال ضبط السمة debug.nn.partition على 2.
نطاقات الذاكرة
في الإصدار 11 من نظام التشغيل Android والإصدارات الأحدث، تتيح واجهة NNAPI استخدام نطاقات الذاكرة التي توفّر واجهات مخصِّصة للذاكرة غير الشفافة. يتيح ذلك للتطبيقات تمرير ذكريات الجهاز الأصلية عبر عمليات التنفيذ، بحيث لا تنسخ واجهة برمجة التطبيقات NNAPI البيانات أو تحوّلها بشكل غير ضروري عند إجراء عمليات تنفيذ متتالية على برنامج التشغيل نفسه.
تم تصميم ميزة نطاق الذاكرة للموتّرات التي تكون في الغالب داخلية في برنامج التشغيل ولا تحتاج إلى الوصول المتكرر إلى جهة العميل. ومن الأمثلة على هذه الموتّرات موتّرات الحالة في النماذج التسلسلية. بالنسبة إلى الموتّرات التي تحتاج إلى وصول متكرّر إلى وحدة المعالجة المركزية على جانب العميل، استخدِم مجموعات الذاكرة المشتركة بدلاً من ذلك.
لتخصيص ذاكرة غير شفافة، اتّبِع الخطوات التالية:
استدعِ الدالة
ANeuralNetworksMemoryDesc_create()لإنشاء واصف ذاكرة جديد:// Create a memory descriptor ANeuralNetworksMemoryDesc* desc; ANeuralNetworksMemoryDesc_create(&desc);
حدِّد جميع أدوار الإدخال والإخراج المقصودة من خلال استدعاء
ANeuralNetworksMemoryDesc_addInputRole()وANeuralNetworksMemoryDesc_addOutputRole().// Specify that the memory may be used as the first input and the first output // of the compilation ANeuralNetworksMemoryDesc_addInputRole(desc, compilation, 0, 1.0f); ANeuralNetworksMemoryDesc_addOutputRole(desc, compilation, 0, 1.0f);
يمكنك تحديد أبعاد الذاكرة من خلال استدعاء
ANeuralNetworksMemoryDesc_setDimensions().// Specify the memory dimensions uint32_t dims[] = {3, 4}; ANeuralNetworksMemoryDesc_setDimensions(desc, 2, dims);
يمكنك إنهاء تعريف الواصف من خلال استدعاء
ANeuralNetworksMemoryDesc_finish().ANeuralNetworksMemoryDesc_finish(desc);
يمكنك تخصيص أكبر عدد ممكن من الذكريات من خلال تمرير الواصف إلى
ANeuralNetworksMemory_createFromDesc().// Allocate two opaque memories with the descriptor ANeuralNetworksMemory* opaqueMem; ANeuralNetworksMemory_createFromDesc(desc, &opaqueMem);
يجب تحرير واصف الذاكرة عندما لا تعود بحاجة إليه.
ANeuralNetworksMemoryDesc_free(desc);
يمكن للعميل استخدام عنصر ANeuralNetworksMemory الذي تم إنشاؤه فقط مع
ANeuralNetworksExecution_setInputFromMemory() أو
ANeuralNetworksExecution_setOutputFromMemory() وفقًا للأدوار
المحددة في عنصر ANeuralNetworksMemoryDesc. يجب ضبط وسيطات الإزاحة والطول على 0، ما يشير إلى استخدام الذاكرة بالكامل. يمكن للعميل أيضًا ضبط محتوى الذاكرة أو استخراجه بشكل صريح باستخدام ANeuralNetworksMemory_copy().
يمكنك إنشاء ذكريات غير شفافة بأدوار ذات أبعاد أو ترتيب غير محدّد.
في هذه الحالة، قد يتعذّر إنشاء الذاكرة مع حالة ANEURALNETWORKS_OP_FAILED إذا لم تكن متوافقة مع برنامج التشغيل الأساسي. يُنصح العميل بتنفيذ منطق احتياطي من خلال تخصيص مخزن مؤقت كبير بما يكفي ومدعوم من Ashmem أو وضع BLOB AHardwareBuffer.
عندما لا تحتاج واجهة NNAPI إلى الوصول إلى عنصر الذاكرة المبهم، يمكنك إخلاء مثيل ANeuralNetworksMemory المقابل:
ANeuralNetworksMemory_free(opaqueMem);
قياس الأداء
يمكنك تقييم أداء تطبيقك من خلال قياس وقت التنفيذ أو من خلال إنشاء ملفات التعريف.
وقت التنفيذ
عندما تريد تحديد إجمالي وقت التنفيذ من خلال وقت التشغيل، يمكنك استخدام واجهة برمجة التطبيقات للتنفيذ المتزامن وقياس الوقت الذي يستغرقه الطلب. عندما تريد تحديد إجمالي وقت التنفيذ من خلال مستوى أدنى من حزمة البرامج، يمكنك استخدام ANeuralNetworksExecution_setMeasureTiming وANeuralNetworksExecution_getDuration للحصول على:
- وقت التنفيذ على مسرِّع (وليس في برنامج التشغيل الذي يعمل على المعالج المضيف).
- وقت التنفيذ في برنامج التشغيل، بما في ذلك الوقت المستغرَق في مسرِّع الأجهزة
لا يشمل وقت التنفيذ في برنامج التشغيل النفقات العامة، مثل وقت التشغيل نفسه وIPC اللازم لوقت التشغيل للتواصل مع برنامج التشغيل.
تقيس واجهات برمجة التطبيقات هذه المدة بين أحداث إرسال العمل وإكماله، بدلاً من الوقت الذي يخصّصه برنامج التشغيل أو المسرّع لإجراء الاستنتاج، والذي قد تتم مقاطعته بسبب تبديل السياق.
على سبيل المثال، إذا بدأ الاستنتاج 1، ثم توقف برنامج التشغيل عن العمل لإجراء الاستنتاج 2، ثم استأنف الاستنتاج 1 وأكمله، فإن وقت تنفيذ الاستنتاج 1 سيشمل الوقت الذي توقف فيه العمل لإجراء الاستنتاج 2.
قد تكون معلومات التوقيت هذه مفيدة في عملية نشر تطبيق في بيئة الإنتاج لجمع بيانات القياس عن بُعد للاستخدام بلا إنترنت. يمكنك استخدام بيانات التوقيت لتعديل التطبيق من أجل تحقيق أداء أعلى.
عند استخدام هذه الوظيفة، يُرجى مراعاة ما يلي:
- قد يؤدي جمع معلومات التوقيت إلى تكلفة في الأداء.
- يمكن لبرنامج التشغيل فقط حساب الوقت المستغرَق في البرنامج نفسه أو في المسرِّع، باستثناء الوقت المستغرَق في وقت تشغيل NNAPI وفي IPC.
- يمكنك استخدام واجهات برمجة التطبيقات هذه فقط مع
ANeuralNetworksExecutionتم إنشاؤه باستخدامANeuralNetworksCompilation_createForDevicesمعnumDevices = 1. - لا يلزم توفّر برنامج تشغيل لتتمكّن من الإبلاغ عن معلومات التوقيت.
تحليل أداء تطبيقك باستخدام Android Systrace
بدءًا من الإصدار Android 10، تنشئ واجهة NNAPI تلقائيًا أحداث systrace التي يمكنك استخدامها لإنشاء ملف شخصي لتطبيقك.
يأتي مصدر NNAPI مزوّدًا بأداة parse_systrace لمعالجة أحداث systrace التي ينشئها تطبيقك وإنشاء عرض جدول يوضّح الوقت المستغرَق في المراحل المختلفة من مراحل نشاط النموذج (إنشاء مثيل والإعداد والتجميع والتنفيذ والإنهاء) والطبقات المختلفة للتطبيقات. الطبقات التي ينقسم إليها تطبيقك هي:
-
Application: الرمز البرمجي للتطبيق الرئيسي -
Runtime: وقت تشغيل NNAPI IPC: رمز الاتصال بين العمليات بين وقت تشغيل NNAPI وبرنامج التشغيلDriver: عملية برنامج تشغيل المسرِّع
إنشاء بيانات تحليل الملفات الشخصية
بافتراض أنّك تحقّقت من شجرة مصدر نظام التشغيل Android في $ANDROID_BUILD_TOP، وباستخدام مثال تصنيف صور TFLite كتطبيق مستهدف، يمكنك إنشاء بيانات تحليل NNAPI من خلال الخطوات التالية:
- ابدأ تتبُّع نظام Android باستخدام الأمر التالي:
$ANDROID_BUILD_TOP/external/chromium-trace/systrace.py -o trace.html -a org.tensorflow.lite.examples.classification nnapi hal freq sched idle load binder_driver
تشير المَعلمة -o trace.html إلى أنّه سيتم كتابة عمليات التتبُّع في trace.html. عند تحليل أداء تطبيقك، عليك
استبدال org.tensorflow.lite.examples.classification باسم العملية
المحدَّد في بيان تطبيقك.
سيؤدي ذلك إلى إبقاء إحدى وحدات تحكّم واجهة الأوامر مشغولة، لذا لا تشغِّل الأمر في
الخلفية لأنّه ينتظر بشكل تفاعلي إنهاء enter.
- بعد بدء أداة تجميع systrace، ابدأ تشغيل تطبيقك وأجرِ اختبار قياس الأداء.
في حالتنا، يمكنك بدء تطبيق تصنيف الصور من استوديو Android أو مباشرةً من واجهة مستخدم هاتف الاختبار إذا كان التطبيق مثبّتًا من قبل. لإنشاء بعض بيانات NNAPI، عليك ضبط التطبيق لاستخدام NNAPI من خلال اختيار NNAPI كجهاز اختبار في مربّع حوار ضبط التطبيق.
عند اكتمال الاختبار، يمكنك إنهاء systrace بالضغط على
enterفي وحدة تحكّم Terminal النشطة منذ الخطوة 1.شغِّل الأداة المساعدة
systrace_parserلإنشاء إحصاءات تراكمية:
$ANDROID_BUILD_TOP/frameworks/ml/nn/tools/systrace_parser/parse_systrace.py --total-times trace.html
يقبل المحلل اللغوي المَعلمات التالية:
- --total-times: يعرض إجمالي الوقت المستغرَق في طبقة، بما في ذلك الوقت
المستغرَق في انتظار التنفيذ عند طلب طبقة أساسية
- --print-detail: يطبع جميع الأحداث التي تم جمعها من systrace
- --per-execution: يطبع فقط التنفيذ ومراحله الفرعية
(كأوقات لكل تنفيذ) بدلاً من إحصاءات جميع المراحل
- --json: ينتج الناتج بتنسيق JSON
في ما يلي مثال على الناتج:
===========================================================================================================================================
NNAPI timing summary (total time, ms wall-clock)                                                      Execution
                                                           ----------------------------------------------------
              Initialization   Preparation   Compilation           I/O       Compute      Results     Ex. total   Termination        Total
              --------------   -----------   -----------   -----------  ------------  -----------   -----------   -----------   ----------
Application              n/a         19.06       1789.25           n/a           n/a         6.70         21.37           n/a      1831.17*
Runtime                    -         18.60       1787.48          2.93         11.37         0.12         14.42          1.32      1821.81
IPC                     1.77             -       1781.36          0.02          8.86            -          8.88             -      1792.01
Driver                  1.04             -       1779.21           n/a           n/a          n/a          7.70             -      1787.95

Total                   1.77*        19.06*      1789.25*         2.93*        11.74*        6.70*        21.37*         1.32*     1831.17*
===========================================================================================================================================
* This total ignores missing (n/a) values and thus is not necessarily consistent with the rest of the numbers
قد يتعذّر على المحلل اللغوي تحليل الأحداث إذا لم تكن الأحداث التي تم جمعها تمثّل تتبُّعًا كاملاً للتطبيق. In particular it might fail if systrace events generated to mark the end of a section are present in the trace without an associated section start event. يحدث هذا عادةً إذا تم إنشاء بعض الأحداث من جلسة تحليل أداء سابقة عند بدء أداة تجميع systrace. في هذه الحالة، عليك تشغيل عملية التحليل مرة أخرى.
إضافة إحصاءات للرمز البرمجي للتطبيق إلى مخرجات systrace_parser
يستند تطبيق parse_systrace إلى وظيفة systrace المضمّنة في Android. يمكنك إضافة عمليات تتبُّع لعمليات محدّدة في تطبيقك باستخدام systrace API (للغة Java ، للتطبيقات الأصلية ) مع أسماء أحداث مخصّصة.
لربط الأحداث المخصّصة بمراحل دورة حياة التطبيق، أضِف إحدى السلاسل التالية إلى بداية اسم الحدث:
-
[NN_LA_PI]: حدث على مستوى التطبيق لبدء التشغيل -
[NN_LA_PP]: حدث على مستوى التطبيق للتحضير -
[NN_LA_PC]: حدث على مستوى التطبيق لعملية التجميع -
[NN_LA_PE]: حدث على مستوى التطبيق للتنفيذ
في ما يلي مثال على كيفية تغيير نموذج الرمز البرمجي لتصنيف الصور في TFLite من خلال إضافة قسم runInferenceModel لمرحلة Execution وطبقة Application التي تحتوي على أقسام أخرى preprocessBitmap لن يتم أخذها في الاعتبار في عمليات تتبُّع NNAPI. سيكون قسم runInferenceModel جزءًا من أحداث systrace التي تتم معالجتها بواسطة محلّل nnapi systrace:
Kotlin
/** Runs inference and returns the classification results. */ fun recognizeImage(bitmap: Bitmap): List{ // This section won’t appear in the NNAPI systrace analysis Trace.beginSection("preprocessBitmap") convertBitmapToByteBuffer(bitmap) Trace.endSection() // Run the inference call. // Add this method in to NNAPI systrace analysis. Trace.beginSection("[NN_LA_PE]runInferenceModel") long startTime = SystemClock.uptimeMillis() runInference() long endTime = SystemClock.uptimeMillis() Trace.endSection() ... return recognitions }
Java
/** Runs inference and returns the classification results. */ public ListrecognizeImage(final Bitmap bitmap) { // This section won’t appear in the NNAPI systrace analysis Trace.beginSection("preprocessBitmap"); convertBitmapToByteBuffer(bitmap); Trace.endSection(); // Run the inference call. // Add this method in to NNAPI systrace analysis. Trace.beginSection("[NN_LA_PE]runInferenceModel"); long startTime = SystemClock.uptimeMillis(); runInference(); long endTime = SystemClock.uptimeMillis(); Trace.endSection(); ... Trace.endSection(); return recognitions; }
جودة الخدمة
في الإصدار 11 من نظام التشغيل Android والإصدارات الأحدث، تتيح واجهة NNAPI جودة خدمة (QoS) أفضل من خلال السماح للتطبيق بالإشارة إلى الأولويات النسبية لنماذجه، والحد الأقصى للوقت المتوقع لإعداد نموذج معين، والحد الأقصى للوقت المتوقع لإكمال عملية حسابية معينة. يقدّم Android 11 أيضًا رموز نتائج إضافية لواجهة NNAPI تتيح للتطبيقات فهم حالات الإخفاق، مثل عدم الالتزام بالمواعيد النهائية للتنفيذ.
ضبط أولوية عبء العمل
لضبط أولوية عبء عمل NNAPI، يمكنك استدعاء
ANeuralNetworksCompilation_setPriority()
قبل استدعاء ANeuralNetworksCompilation_finish().
تحديد المواعيد النهائية
يمكن للتطبيقات تحديد مواعيد نهائية لكل من تجميع النماذج والاستدلال.
- لضبط مهلة التجميع، يمكنك استدعاء
ANeuralNetworksCompilation_setTimeout()قبل استدعاءANeuralNetworksCompilation_finish(). - لضبط مهلة الاستنتاج، يمكنك استدعاء
ANeuralNetworksExecution_setTimeout()قبل بدء عملية التجميع.
مزيد من المعلومات حول المعاملات
يتناول القسم التالي مواضيع متقدّمة حول استخدام المعاملات.
الموتّرات المكمّمة
الموتّر المكمّم هو طريقة مدمجة لتمثيل مصفوفة ذات أبعاد n من قيم النقاط العائمة.
تتيح واجهة NNAPI استخدام الموتّرات المكمّمة غير المتماثلة ذات 8 بت. بالنسبة إلى هذه الموتّرات، يتم تمثيل قيمة كل خلية بعدد صحيح من 8 بت. يرتبط الموتّر بمقياس وقيمة نقطة الصفر. تُستخدم هذه لتحويل الأعداد الصحيحة ذات 8 بت إلى قيم الفاصلة العائمة التي يتم تمثيلها.
الصيغة هي:
(cellValue - zeroPoint) * scale
حيث تكون قيمة zeroPoint عددًا صحيحًا من 32 بت والمقياس قيمة نقطة عائمة من 32 بت.
مقارنةً بالموتّرات ذات قيم النقاط العائمة بتنسيق 32 بت، تتميز الموتّرات المكمَّمة بتنسيق 8 بت بميزتَين:
- يكون حجم تطبيقك أصغر، لأنّ الأوزان المدرَّبة تشغل ربع حجم الموتّرات ذات الـ 32 بت.
- يمكن غالبًا تنفيذ العمليات الحسابية بشكل أسرع. ويرجع ذلك إلى الكمية الأصغر من البيانات التي يجب جلبها من الذاكرة وكفاءة المعالجات مثل معالِجات الإشارات الرقمية (DSP) في إجراء العمليات الحسابية للأعداد الصحيحة.
على الرغم من أنه من الممكن تحويل نموذج النقطة العائمة إلى نموذج كمي، إلا أن تجربتنا أظهرت أنه يتم تحقيق نتائج أفضل من خلال تدريب نموذج كمي مباشرة. في الواقع، تتعلّم الشبكة العصبية كيفية التعويض عن الدقة المتزايدة لكل قيمة. بالنسبة إلى كل موتر مكمَّم، يتم تحديد قيم المقياس وzeroPoint أثناء عملية التدريب.
في NNAPI، يمكنك تحديد أنواع الموتّرات المكمّمة من خلال ضبط حقل النوع في بنية بيانات ANeuralNetworksOperandType على ANEURALNETWORKS_TENSOR_QUANT8_ASYMM.
يمكنك أيضًا تحديد قيمة المقياس وzeroPoint للموتّر في بنية البيانات هذه.
بالإضافة إلى الموتّرات الكمية غير المتماثلة ذات 8 بت، تتيح واجهة NNAPI ما يلي:
ANEURALNETWORKS_TENSOR_QUANT8_SYMM_PER_CHANNELالتي يمكنك استخدامها لتمثيل الأوزان لعملياتCONV/DEPTHWISE_CONV/TRANSPOSED_CONV.ANEURALNETWORKS_TENSOR_QUANT16_ASYMMالتي يمكنك استخدامها للحالة الداخلية لـQUANTIZED_16BIT_LSTM.ANEURALNETWORKS_TENSOR_QUANT8_SYMMالتي يمكن أن تكون إدخالاً فيANEURALNETWORKS_DEQUANTIZE.
المعاملات الاختيارية
تتطلّب بعض العمليات، مثل
ANEURALNETWORKS_LSH_PROJECTION،
مَعاملات اختيارية. للإشارة في النموذج إلى أنّه تم حذف المعامل الاختياري، يمكنك استدعاء الدالة ANeuralNetworksModel_setOperandValue()، مع تمرير NULL للمخزن المؤقت و0 للطول.
إذا كان قرار وجود المعامل أو عدم وجوده يختلف لكل
تنفيذ، فإنك تشير إلى أنه تم حذف المعامل باستخدام
الدوال ANeuralNetworksExecution_setInput()
أو
ANeuralNetworksExecution_setOutput()،
وتمرير NULL للمخزن المؤقت و0 للطول.
موتّرات من رتبة غير معروفة
قدّم الإصدار Android 9 (المستوى 28 من واجهة برمجة التطبيقات) معاملات نموذجية ذات أبعاد غير معروفة ولكن ذات ترتيب معروف (عدد الأبعاد). قدّم نظام التشغيل Android 10 (المستوى 29 من واجهة برمجة التطبيقات) مصفوفات متعدّدة الأبعاد ذات رتبة غير معروفة، كما هو موضّح في ANeuralNetworksOperandType.
مقياس أداء NNAPI
يتوفّر مقياس أداء NNAPI على "مشروع Android المفتوح المصدر" (AOSP) في platform/test/mlts/benchmark
(تطبيق مقياس الأداء) وplatform/test/mlts/models (النماذج ومجموعات البيانات).
يقيّم مقياس الأداء وقت الاستجابة والدقة ويقارن برامج التشغيل بالعمل نفسه الذي يتم تنفيذه باستخدام Tensorflow Lite الذي يعمل على وحدة المعالجة المركزية، للنماذج ومجموعات البيانات نفسها.
لاستخدام مقياس الأداء، اتّبِع الخطوات التالية:
وصِّل جهاز Android المستهدَف بالكمبيوتر، وافتح نافذة المحطة الطرفية، وتأكَّد من إمكانية الوصول إلى الجهاز من خلال adb.
إذا كان هناك أكثر من جهاز Android واحد متصل، يمكنك تصدير متغيّر بيئة جهاز الاختبار
ANDROID_SERIAL.انتقِل إلى دليل ملفات المصدر ذي المستوى الأعلى في Android.
نفِّذ الأوامر التالية:
lunch aosp_arm-userdebug # Or aosp_arm64-userdebug if available
./test/mlts/benchmark/build_and_run_benchmark.sh
At the end of a benchmark run, its results will be presented as an HTML page passed to
xdg-open.
سجلّات NNAPI
تنشئ واجهة NNAPI معلومات تشخيصية مفيدة في سجلّات النظام. لتحليل السجلّات، استخدِم الأداة المساعدة logcat.
يمكنك تفعيل التسجيل المطوّل لواجهة NNAPI لمراحل أو مكوّنات معيّنة من خلال ضبط السمة debug.nn.vlog (باستخدام adb shell) على قائمة القيم التالية، مفصولة بمسافة أو نقطتين رأسيتين أو فاصلة:
model: بناء نموذج-
compilation: إنشاء خطة تنفيذ النموذج وتجميعه -
execution: تنفيذ النموذج cpuexe: تنفيذ العمليات باستخدام وحدة المعالجة المركزية (CPU) في واجهة برمجة التطبيقات للشبكة العصبية (NNAPI)manager: إضافات NNAPI والواجهات المتاحة والمعلومات ذات الصلة بالإمكانات-
allأو1: جميع العناصر أعلاه
على سبيل المثال، لتفعيل التسجيل المطوَّل بالكامل، استخدِم الأمر adb shell setprop debug.nn.vlog all. لإيقاف التسجيل المطوَّل، استخدِم الأمر
adb shell setprop debug.nn.vlog '""'.
بعد تفعيل التسجيل المطوّل، يتم إنشاء إدخالات في السجلّ على مستوى INFO مع ضبط علامة على اسم المرحلة أو المكوّن.
إلى جانب الرسائل التي يتم التحكّم فيها من خلال debug.nn.vlog، توفّر مكوّنات واجهة برمجة التطبيقات NNAPI
إدخالات أخرى في السجلّ على مستويات مختلفة، ويستخدم كلّ منها علامة سجلّ محدّدة.
للحصول على قائمة بالمكونات، ابحث في شجرة المصدر باستخدام التعبير التالي:
grep -R 'define LOG_TAG' | awk -F '"' '{print $2}' | sort -u | egrep -v "Sample|FileTag|test"
يعرض هذا التعبير حاليًا العلامات التالية:
- BurstBuilder
- عمليات الاسترداد
- CompilationBuilder
- CpuExecutor
- ExecutionBuilder
- ExecutionBurstController
- ExecutionBurstServer
- ExecutionPlan
- FibonacciDriver
- GraphDump
- IndexedShapeWrapper
- IonWatcher
- مدير
- الذاكرة
- MemoryUtils
- MetaModel
- ModelArgumentInfo
- ModelBuilder
- NeuralNetworks
- OperationResolver
- العمليات
- OperationsUtils
- PackageInfo
- TokenHasher
- TypeManager
- أدوات مساعدة
- ValidateHal
- VersionedInterfaces
للتحكّم في مستوى الرسائل المسجّلة التي يعرضها logcat، استخدِم
متغيّر البيئة ANDROID_LOG_TAGS.
لعرض المجموعة الكاملة من رسائل سجلّ NNAPI وإيقاف أي رسائل أخرى، اضبط ANDROID_LOG_TAGS على
ما يلي:
BurstBuilder:V Callbacks:V CompilationBuilder:V CpuExecutor:V ExecutionBuilder:V ExecutionBurstController:V ExecutionBurstServer:V ExecutionPlan:V FibonacciDriver:V GraphDump:V IndexedShapeWrapper:V IonWatcher:V Manager:V MemoryUtils:V Memory:V MetaModel:V ModelArgumentInfo:V ModelBuilder:V NeuralNetworks:V OperationResolver:V OperationsUtils:V Operations:V PackageInfo:V TokenHasher:V TypeManager:V Utils:V ValidateHal:V VersionedInterfaces:V *:S.
يمكنك ضبط ANDROID_LOG_TAGS باستخدام الأمر التالي:
export ANDROID_LOG_TAGS=$(grep -R 'define LOG_TAG' | awk -F '"' '{ print $2 ":V" }' | sort -u | egrep -v "Sample|FileTag|test" | xargs echo -n; echo ' *:S')
يُرجى العِلم أنّ هذا مجرد فلتر ينطبق على logcat. يجب ضبط السمة debug.nn.vlog على all لإنشاء معلومات سجلّ مطوّلة.