

Android Neural Networks API (NNAPI), Android C API है. इसे Android डिवाइसों पर मशीन लर्निंग के लिए, कंप्यूटेशनल तौर पर ज़्यादा काम करने वाले ऑपरेशन चलाने के लिए डिज़ाइन किया गया है. NNAPI को TensorFlow Lite और Caffe2 जैसे बेहतर मशीन लर्निंग फ़्रेमवर्क के लिए, बुनियादी सुविधाएं उपलब्ध कराने के मकसद से डिज़ाइन किया गया है. ये फ़्रेमवर्क, न्यूरल नेटवर्क बनाते हैं और उन्हें ट्रेनिंग देते हैं. यह एपीआई, Android 8.1 (एपीआई लेवल 27) या इसके बाद के वर्शन पर काम करने वाले सभी Android डिवाइसों पर उपलब्ध है. हालांकि, इसे Android 15 में बंद कर दिया गया था.
NNAPI, Android डिवाइसों से मिले डेटा को पहले से ट्रेन किए गए और डेवलपर के तय किए गए मॉडल पर लागू करके, अनुमान लगाने में मदद करता है. अनुमान लगाने के उदाहरणों में, इमेज को अलग-अलग कैटगरी में बांटना, उपयोगकर्ता के व्यवहार का अनुमान लगाना, और किसी सर्च क्वेरी के लिए सही जवाब चुनना शामिल है.
उपयोगकर्ता के डिवाइस पर अनुमान लगाने की सुविधा के कई फ़ायदे हैं:
- लेटेंसी: आपको इंटरनेट कनेक्शन का इस्तेमाल करके अनुरोध भेजने और जवाब का इंतज़ार करने की ज़रूरत नहीं पड़ती. उदाहरण के लिए, यह वीडियो ऐप्लिकेशन के लिए ज़रूरी हो सकता है. ये ऐप्लिकेशन, कैमरे से आने वाले फ़्रेम को प्रोसेस करते हैं.
- उपलब्धता: ऐप्लिकेशन, नेटवर्क कवरेज से बाहर होने पर भी काम करता है.
- स्पीड: न्यूरल नेटवर्क प्रोसेसिंग के लिए खास तौर पर बनाया गया नया हार्डवेयर, अलग-अलग कामों के लिए इस्तेमाल की जाने वाली मशीन वाले सीपीयू की तुलना में काफ़ी तेज़ी से कंप्यूटेशन करता है.
- निजता: डेटा को Android डिवाइस से बाहर नहीं भेजा जाता.
- लागत: जब सभी कंप्यूटेशन Android डिवाइस पर किए जाते हैं, तो सर्वर फ़ार्म की ज़रूरत नहीं होती.
डेवलपर को इन बातों का भी ध्यान रखना चाहिए:
- सिस्टम का इस्तेमाल: न्यूरल नेटवर्क का आकलन करने के लिए, बहुत ज़्यादा कंप्यूटेशन की ज़रूरत होती है. इससे बैटरी की खपत बढ़ सकती है. अगर आपके ऐप्लिकेशन के लिए बैटरी की परफ़ॉर्मेंस मायने रखती है, तो आपको बैटरी की परफ़ॉर्मेंस पर नज़र रखनी चाहिए. खास तौर पर, लंबे समय तक चलने वाले कंप्यूटेशन के लिए.
- ऐप्लिकेशन का साइज़: अपने मॉडल के साइज़ पर ध्यान दें. मॉडल, कई मेगाबाइट स्टोरेज ले सकते हैं. अगर आपके APK में बड़े मॉडल बंडल करने से, आपके उपयोगकर्ताओं पर बुरा असर पड़ता है, तो आपके पास ऐप्लिकेशन इंस्टॉल करने के बाद मॉडल डाउनलोड करने, छोटे मॉडल इस्तेमाल करने या क्लाउड में कंप्यूटेशन चलाने का विकल्प है. NNAPI, क्लाउड में मॉडल चलाने की सुविधा नहीं देता.
NNAPI का इस्तेमाल करने का तरीका जानने के लिए, Android Neural Networks API का सैंपल देखें.
न्यूरल नेटवर्क एपीआई रनटाइम को समझना
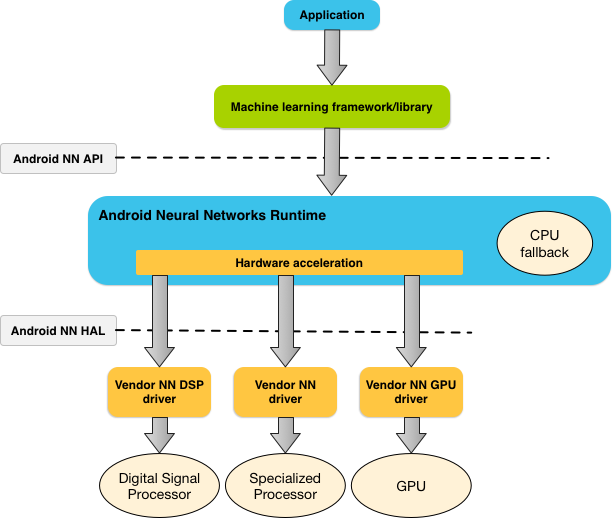
NNAPI को मशीन लर्निंग लाइब्रेरी, फ़्रेमवर्क, और टूल से कॉल किया जाता है. इनकी मदद से, डेवलपर अपने मॉडल को डिवाइस से बाहर ट्रेन कर सकते हैं और उन्हें Android डिवाइसों पर डिप्लॉय कर सकते हैं. आम तौर पर, ऐप्लिकेशन सीधे तौर पर NNAPI का इस्तेमाल नहीं करते. इसके बजाय, वे ज़्यादा बेहतर मशीन लर्निंग फ़्रेमवर्क का इस्तेमाल करते हैं. ये फ़्रेमवर्क, NNAPI का इस्तेमाल करके, काम करने वाले डिवाइसों पर हार्डवेयर से तेज़ी लाने वाले अनुमान से जुड़े ऑपरेशन कर सकते हैं.
किसी ऐप्लिकेशन की ज़रूरी शर्तों और Android डिवाइस पर हार्डवेयर की क्षमताओं के आधार पर, Android का न्यूरल नेटवर्क रनटाइम, डिवाइस पर उपलब्ध प्रोसेसर के बीच कंप्यूटेशन वर्कलोड को बेहतर तरीके से बांट सकता है. इनमें, खास तौर पर न्यूरल नेटवर्क हार्डवेयर, ग्राफ़िक्स प्रोसेसिंग यूनिट (जीपीयू), और डिजिटल सिग्नल प्रोसेसर (डीएसपी) शामिल हैं.
जिन Android डिवाइसों में खास वेंडर ड्राइवर नहीं होता है उनके लिए, NNAPI रनटाइम सीपीयू पर अनुरोधों को पूरा करता है.
पहली इमेज में, NNAPI के लिए हाई-लेवल सिस्टम आर्किटेक्चर दिखाया गया है.
Neural Networks API का प्रोग्रामिंग मॉडल
NNAPI का इस्तेमाल करके कंप्यूटेशन करने के लिए, आपको सबसे पहले एक डायरेक्टेड ग्राफ़ बनाना होगा. इसमें कंप्यूटेशन के बारे में बताया जाता है. यह कंप्यूटेशन ग्राफ़, आपके इनपुट डेटा के साथ मिलकर, NNAPI रनटाइम के आकलन के लिए मॉडल बनाता है. उदाहरण के लिए, मशीन लर्निंग फ़्रेमवर्क से पास किए गए वेट और बायस.
NNAPI, चार मुख्य ऐब्स्ट्रैक्शन का इस्तेमाल करता है:
- मॉडल: गणितीय संक्रियाओं और ट्रेनिंग प्रोसेस से सीखी गई कॉन्स्टेंट वैल्यू का कंप्यूटेशन ग्राफ़. ये ऑपरेशन, न्यूरल नेटवर्क के लिए खास तौर पर बनाए गए हैं. इनमें 2-डाइमेंशनल (2D)
कॉन्वोल्यूशन,
लॉजिस्टिक
(सिग्मॉइड)
ऐक्टिवेशन,
रेक्टिफ़ाइड लीनियर
(ReLU) ऐक्टिवेशन वगैरह शामिल हैं. मॉडल बनाना एक सिंक्रोनस कार्रवाई है.
एक बार बन जाने के बाद, इसे थ्रेड और कंपाइलेशन में फिर से इस्तेमाल किया जा सकता है.
NNAPI में, मॉडल को
ANeuralNetworksModelइंस्टेंस के तौर पर दिखाया जाता है. - कंपाइलेशन: यह NNAPI मॉडल को लोअर-लेवल कोड में कंपाइल करने के लिए कॉन्फ़िगरेशन दिखाता है. कंपाइलेशन बनाना एक सिंक्रोनस कार्रवाई है. सफलतापूर्वक बनाए जाने के बाद, इसे थ्रेड और एक्ज़ीक्यूशन में फिर से इस्तेमाल किया जा सकता है. NNAPI में, हर कंपाइलेशन को
ANeuralNetworksCompilationइंस्टेंस के तौर पर दिखाया जाता है. - मेमोरी: इससे शेयर की गई मेमोरी, मेमोरी मैप की गई फ़ाइलों, और मिलती-जुलती मेमोरी बफ़र के बारे में पता चलता है. मेमोरी बफ़र का इस्तेमाल करने से, NNAPI रनटाइम, ड्राइवर को ज़्यादा बेहतर तरीके से डेटा ट्रांसफ़र कर पाता है. आम तौर पर, कोई ऐप्लिकेशन एक शेयर किया गया मेमोरी बफ़र बनाता है. इसमें मॉडल को तय करने के लिए ज़रूरी हर टेंसर मौजूद होता है. एक्ज़ीक्यूशन इंस्टेंस के इनपुट और आउटपुट को सेव करने के लिए, मेमोरी बफ़र का भी इस्तेमाल किया जा सकता है. NNAPI में, हर मेमोरी बफ़र को
ANeuralNetworksMemoryइंस्टेंस के तौर पर दिखाया जाता है. Execution: यह इंटरफ़ेस, इनपुट के सेट पर NNAPI मॉडल लागू करने और नतीजे इकट्ठा करने के लिए है. एक्ज़ीक्यूशन को सिंक्रोनस या एसिंक्रोनस तरीके से किया जा सकता है.
एसिंक्रोनस एक्ज़ीक्यूशन के लिए, कई थ्रेड एक ही एक्ज़ीक्यूशन पर इंतज़ार कर सकते हैं. यह प्रोसेस पूरी होने पर, सभी थ्रेड रिलीज़ हो जाते हैं.
NNAPI में, हर एक्ज़ीक्यूशन को
ANeuralNetworksExecutionइंस्टेंस के तौर पर दिखाया जाता है.
दूसरी इमेज में, प्रोग्रामिंग का बुनियादी फ़्लो दिखाया गया है.
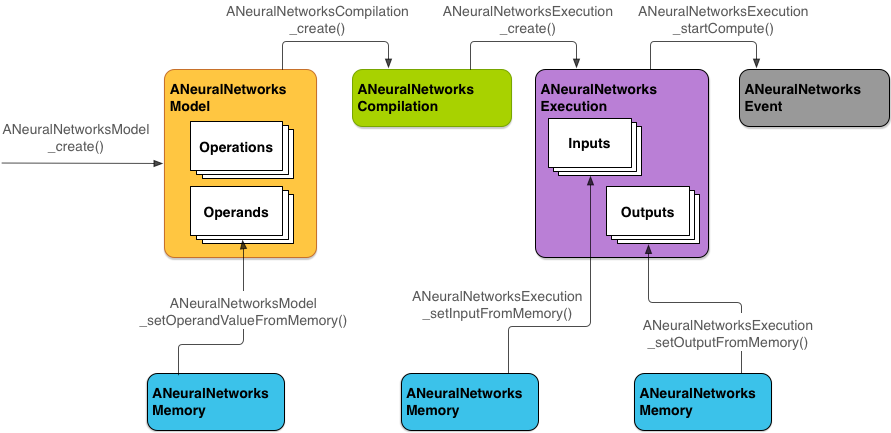
इस सेक्शन के बाकी हिस्से में, NNAPI मॉडल को सेट अप करने का तरीका बताया गया है. इससे, कंप्यूटेशन करने, मॉडल को कंपाइल करने, और कंपाइल किए गए मॉडल को लागू करने में मदद मिलती है.
आपको अपने प्रोडक्शन कोड में ऐसा करना चाहिए.ट्रेनिंग डेटा का ऐक्सेस देना
ट्रेन किए गए वेट और बायस डेटा को किसी फ़ाइल में सेव किया जाता है. NNAPI रनटाइम को इस डेटा का बेहतर ऐक्सेस देने के लिए, ANeuralNetworksMemory इंस्टेंस बनाएं. इसके लिए, ANeuralNetworksMemory_createFromFd() फ़ंक्शन को कॉल करें और खोली गई डेटा फ़ाइल के फ़ाइल डिस्क्रिप्टर को पास करें. आपको मेमोरी सुरक्षा फ़्लैग और ऑफ़सेट भी तय करना होगा, जहां फ़ाइल में शेयर की गई मेमोरी का हिस्सा शुरू होता है.
// Create a memory buffer from the file that contains the trained data
ANeuralNetworksMemory* mem1 = NULL;
int fd = open("training_data", O_RDONLY);
ANeuralNetworksMemory_createFromFd(file_size, PROT_READ, fd, 0, &mem1);
हालांकि, इस उदाहरण में हम अपने सभी वेट के लिए, सिर्फ़ एक
ANeuralNetworksMemory
इंस्टेंस का इस्तेमाल करते हैं. हालांकि, कई फ़ाइलों के लिए एक से ज़्यादा
ANeuralNetworksMemory इंस्टेंस का इस्तेमाल किया जा सकता है.
नेटिव हार्डवेयर बफ़र का इस्तेमाल करना
मॉडल के इनपुट, आउटपुट, और कॉन्स्टेंट ऑपरेंड वैल्यू के लिए, नेटिव हार्डवेयर बफ़र का इस्तेमाल किया जा सकता है. कुछ मामलों में, NNAPI ऐक्सेलरेटर, ड्राइवर को डेटा कॉपी किए बिना ही AHardwareBuffer ऑब्जेक्ट को ऐक्सेस कर सकता है. AHardwareBuffer में कई अलग-अलग कॉन्फ़िगरेशन होते हैं. ऐसा हो सकता है कि हर NNAPI ऐक्सेलरेटर, इन सभी कॉन्फ़िगरेशन के साथ काम न करे. इस सीमा की वजह से, ANeuralNetworksMemory_createFromAHardwareBuffer रेफ़रंस दस्तावेज़ में दी गई पाबंदियों को देखें. साथ ही, टारगेट डिवाइसों पर पहले से टेस्ट करें, ताकि यह पक्का किया जा सके कि AHardwareBuffer का इस्तेमाल करने वाले कंपाइलेशन और एक्ज़ीक्यूशन उम्मीद के मुताबिक काम करें. इसके लिए, ऐक्सेलरेटर की जानकारी देने के लिए डिवाइस असाइनमेंट का इस्तेमाल करें.
NNAPI रनटाइम को AHardwareBuffer ऑब्जेक्ट ऐक्सेस करने की अनुमति देने के लिए, ANeuralNetworksMemory_createFromAHardwareBuffer फ़ंक्शन को कॉल करके और AHardwareBuffer ऑब्जेक्ट को पास करके, ANeuralNetworksMemory इंस्टेंस बनाएं. इसके बारे में यहां दिए गए कोड सैंपल में बताया गया है:
// Configure and create AHardwareBuffer object
AHardwareBuffer_Desc desc = ...
AHardwareBuffer* ahwb = nullptr;
AHardwareBuffer_allocate(&desc, &ahwb);

// Create ANeuralNetworksMemory from AHardwareBuffer
ANeuralNetworksMemory* mem2 = NULL;
ANeuralNetworksMemory_createFromAHardwareBuffer(ahwb, &mem2);
जब NNAPI को AHardwareBuffer ऑब्जेक्ट को ऐक्सेस करने की ज़रूरत न हो, तो उससे जुड़े ANeuralNetworksMemory इंस्टेंस को खाली करें:
ANeuralNetworksMemory_free(mem2);
ध्यान दें:
AHardwareBufferका इस्तेमाल सिर्फ़ पूरे बफ़र के लिए किया जा सकता है. इसेARectपैरामीटर के साथ इस्तेमाल नहीं किया जा सकता.- NNAPI रनटाइम, बफ़र को फ़्लश नहीं करेगा. एक्सीक्यूशन को शेड्यूल करने से पहले, आपको यह पक्का करना होगा कि इनपुट और आउटपुट बफ़र को ऐक्सेस किया जा सकता हो.
- सिंक फ़ेंस फ़ाइल डिस्क्रिप्टर के लिए कोई सहायता उपलब्ध नहीं है.
- वेंडर के हिसाब से फ़ॉर्मैट और इस्तेमाल की बिट वाले
AHardwareBufferके लिए, वेंडर के लागू करने के तरीके पर निर्भर करता है कि क्लाइंट या ड्राइवर, कैश मेमोरी को खाली करने के लिए ज़िम्मेदार है या नहीं.
मॉडल
मॉडल, NNAPI में कंप्यूटेशन की बुनियादी यूनिट है. हर मॉडल को एक या उससे ज़्यादा ऑपरेंड और ऑपरेशन से तय किया जाता है.
ऑपरेंड
ऑपरेंड, डेटा ऑब्जेक्ट होते हैं. इनका इस्तेमाल ग्राफ़ को तय करने के लिए किया जाता है. इनमें मॉडल के इनपुट और आउटपुट, इंटरमीडिएट नोड, और कॉन्स्टेंट शामिल हैं. इंटरमीडिएट नोड में वह डेटा होता है जो एक ऑपरेशन से दूसरे ऑपरेशन में जाता है. वहीं, कॉन्स्टेंट को इन ऑपरेशन में पास किया जाता है.
NNAPI मॉडल में दो तरह के ऑपरेंड जोड़े जा सकते हैं: स्केलर और टेंसर.
स्केलर, एक वैल्यू को दिखाता है. NNAPI, बूलियन, 16-बिट फ़्लोटिंग पॉइंट, 32-बिट फ़्लोटिंग पॉइंट, 32-बिट इंटिजर, और अनसाइंड 32-बिट इंटिजर फ़ॉर्मैट में स्केलर वैल्यू के साथ काम करता है.
NNAPI में ज़्यादातर कार्रवाइयों में टेंसर शामिल होते हैं. टेंसर, n-डाइमेंशन वाले अरे होते हैं. NNAPI, 16-बिट फ़्लोटिंग पॉइंट, 32-बिट फ़्लोटिंग पॉइंट, 8-बिट क्वांटाइज़्ड, 16-बिट क्वांटाइज़्ड, 32-बिट इंटिजर, और 8-बिट बूलियन वैल्यू वाले टेंसर के साथ काम करता है.
उदाहरण के लिए, इमेज 3 में दो ऑपरेशन वाला एक मॉडल दिखाया गया है: पहले जोड़ना और फिर गुणा करना. यह मॉडल, एक इनपुट टेंसर लेता है और एक आउटपुट टेंसर जनरेट करता है.
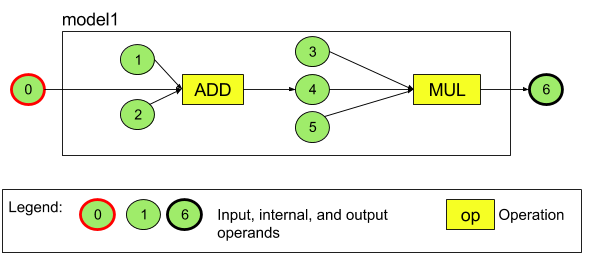
ऊपर दिए गए मॉडल में सात ऑपरेंड हैं. इन ऑपरेंड की पहचान, मॉडल में जोड़े जाने के क्रम के इंडेक्स से की जाती है. जोड़े गए पहले ऑपरेंड का इंडेक्स 0 होता है, दूसरे का इंडेक्स 1 होता है, और इसी तरह आगे भी. ऑपरेंड 1, 2, 3, और 5 कॉन्स्टेंट ऑपरेंड हैं.
ऑपरेंड को जोड़ने के क्रम से कोई फ़र्क़ नहीं पड़ता. उदाहरण के लिए, मॉडल आउटपुट ऑपरेंड को सबसे पहले जोड़ा जा सकता है. किसी ऑपरेंड का रेफ़रंस देते समय, सही इंडेक्स वैल्यू का इस्तेमाल करना ज़रूरी है.
ऑपरेंड के टाइप होते हैं. मॉडल में जोड़े जाने पर, इनकी जानकारी दी जाती है.
किसी ऑपरेंड को मॉडल के इनपुट और आउटपुट, दोनों के तौर पर इस्तेमाल नहीं किया जा सकता.
हर ऑपरेंड, मॉडल इनपुट, कॉन्सटेंट या सिर्फ़ एक ऑपरेशन का आउटपुट ऑपरेंड होना चाहिए.
ऑपरेंड इस्तेमाल करने के बारे में ज़्यादा जानकारी के लिए, ऑपरेंड के बारे में ज़्यादा जानें लेख पढ़ें.
कार्रवाइयां
ऑपरेशन से पता चलता है कि कौनसी गणनाएं की जानी हैं. हर ऑपरेशन में ये एलिमेंट शामिल होते हैं:
- ऑपरेशन टाइप (उदाहरण के लिए, जोड़ना, गुणा करना, कॉन्वोल्यूशन),
- ऑपरेंड के इंडेक्स की सूची, जिनका इस्तेमाल ऑपरेशन इनपुट के लिए करता है, और
- उन ऑपरेंड के इंडेक्स की सूची जिनका इस्तेमाल ऑपरेशन, आउटपुट के लिए करता है.
इन सूचियों में क्रम मायने रखता है. हर तरह के ऑपरेशन के लिए, ज़रूरी इनपुट और आउटपुट देखने के लिए, NNAPI एपीआई का संदर्भ देखें.
ऑपरेशन जोड़ने से पहले, आपको मॉडल में वे ऑपरेंड जोड़ने होंगे जिनका इस्तेमाल ऑपरेशन करता है या जो ऑपरेशन से जनरेट होते हैं.
ऑपरेशन जोड़ने के क्रम से कोई फ़र्क़ नहीं पड़ता. NNAPI, ऑपरेंड और ऑपरेशन के कंप्यूटेशन ग्राफ़ से तय की गई डिपेंडेंसी पर निर्भर करता है. इससे यह तय होता है कि ऑपरेशन किस क्रम में लागू किए जाएंगे.
NNAPI के साथ काम करने वाले ऑपरेशन की खास जानकारी, यहां दी गई टेबल में दी गई है:
एपीआई लेवल 28 में पहले से मौजूद समस्या: Android 9 (एपीआई लेवल 28) और इसके बाद के वर्शन पर उपलब्ध ANEURALNETWORKS_PAD ऑपरेशन में ANEURALNETWORKS_TENSOR_QUANT8_ASYMM टेंसर पास करते समय, NNAPI से मिलने वाला आउटपुट, TensorFlow लाइट जैसे हाई-लेवल मशीन लर्निंग फ़्रेमवर्क से मिलने वाले आउटपुट से मैच नहीं हो सकता. इसके बजाय, आपको सिर्फ़ ANEURALNETWORKS_TENSOR_FLOAT32 पास करना चाहिए.
इस समस्या को Android 10 (एपीआई लेवल 29) और इसके बाद के वर्शन में ठीक कर दिया गया है.
मॉडल बनाना
यहां दिए गए उदाहरण में, हम दो ऑपरेशन वाला मॉडल बनाते हैं, जो इमेज 3 में मौजूद है.
मॉडल बनाने के लिए, यह तरीका अपनाएं:
खाली मॉडल तय करने के लिए,
ANeuralNetworksModel_create()फ़ंक्शन को कॉल करें.ANeuralNetworksModel* model = NULL; ANeuralNetworksModel_create(&model);
ANeuralNetworks_addOperand()को कॉल करके, अपने मॉडल में ऑपरेंड जोड़ें. इनके डेटा टाइप,ANeuralNetworksOperandTypeडेटा स्ट्रक्चर का इस्तेमाल करके तय किए जाते हैं.// In our example, all our tensors are matrices of dimension [3][4] ANeuralNetworksOperandType tensor3x4Type; tensor3x4Type.type = ANEURALNETWORKS_TENSOR_FLOAT32; tensor3x4Type.scale = 0.f; // These fields are used for quantized tensors tensor3x4Type.zeroPoint = 0; // These fields are used for quantized tensors tensor3x4Type.dimensionCount = 2; uint32_t dims[2] = {3, 4}; tensor3x4Type.dimensions = dims;
// We also specify operands that are activation function specifiers ANeuralNetworksOperandType activationType; activationType.type = ANEURALNETWORKS_INT32; activationType.scale = 0.f; activationType.zeroPoint = 0; activationType.dimensionCount = 0; activationType.dimensions = NULL;
// Now we add the seven operands, in the same order defined in the diagram ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 0 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 1 ANeuralNetworksModel_addOperand(model, &activationType); // operand 2 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 3 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 4 ANeuralNetworksModel_addOperand(model, &activationType); // operand 5 ANeuralNetworksModel_addOperand(model, &tensor3x4Type); // operand 6ऐसे ऑपरेंड जिनकी वैल्यू स्थिर होती है, जैसे कि ट्रेनिंग प्रोसेस से आपके ऐप्लिकेशन को मिलने वाले वेट और बायस, उनके लिए
ANeuralNetworksModel_setOperandValue()औरANeuralNetworksModel_setOperandValueFromMemory()फ़ंक्शन का इस्तेमाल करें.यहां दिए गए उदाहरण में, हमने ट्रेनिंग डेटा फ़ाइल से कॉन्स्टेंट वैल्यू सेट की हैं. ये वैल्यू, उस मेमोरी बफ़र से जुड़ी हैं जिसे हमने ट्रेनिंग डेटा का ऐक्सेस दें में बनाया था.
// In our example, operands 1 and 3 are constant tensors whose values were
// established during the training process
const int sizeOfTensor = 3 * 4 * 4;    // The formula for size calculation is dim0 * dim1 * elementSize
ANeuralNetworksModel_setOperandValueFromMemory(model, 1, mem1, 0, sizeOfTensor);
ANeuralNetworksModel_setOperandValueFromMemory(model, 3, mem1, sizeOfTensor, sizeOfTensor);


// We set the values of the activation operands, in our example operands 2 and 5
int32_t noneValue = ANEURALNETWORKS_FUSED_NONE;
ANeuralNetworksModel_setOperandValue(model, 2, &noneValue, sizeof(noneValue));
ANeuralNetworksModel_setOperandValue(model, 5, &noneValue, sizeof(noneValue));
आपको डायरेक्टेड ग्राफ़ में जिस ऑपरेशन की गणना करनी है उसके लिए,
ANeuralNetworksModel_addOperation()फ़ंक्शन को कॉल करके, ऑपरेशन को अपने मॉडल में जोड़ें.इस कॉल के पैरामीटर के तौर पर, आपके ऐप्लिकेशन को ये चीज़ें उपलब्ध करानी होंगी:
- कार्रवाई का टाइप
- इनपुट वैल्यू की संख्या
- इनपुट ऑपरेंड के इंडेक्स का कलेक्शन
- आउटपुट वैल्यू की संख्या
- आउटपुट ऑपरेंड के इंडेक्स का कलेक्शन
ध्यान दें कि किसी ऑपरेंड का इस्तेमाल, एक ही ऑपरेशन के इनपुट और आउटपुट, दोनों के लिए नहीं किया जा सकता.
// We have two operations in our example // The first consumes operands 1, 0, 2, and produces operand 4 uint32_t addInputIndexes[3] = {1, 0, 2}; uint32_t addOutputIndexes[1] = {4}; ANeuralNetworksModel_addOperation(model, ANEURALNETWORKS_ADD, 3, addInputIndexes, 1, addOutputIndexes);
// The second consumes operands 3, 4, 5, and produces operand 6 uint32_t multInputIndexes[3] = {3, 4, 5}; uint32_t multOutputIndexes[1] = {6}; ANeuralNetworksModel_addOperation(model, ANEURALNETWORKS_MUL, 3, multInputIndexes, 1, multOutputIndexes);ANeuralNetworksModel_identifyInputsAndOutputs()फ़ंक्शन को कॉल करके, यह पहचान करें कि मॉडल को किन ऑपरेंड को इनपुट और आउटपुट के तौर पर इस्तेमाल करना चाहिए.// Our model has one input (0) and one output (6) uint32_t modelInputIndexes[1] = {0}; uint32_t modelOutputIndexes[1] = {6}; ANeuralNetworksModel_identifyInputsAndOutputs(model, 1, modelInputIndexes, 1 modelOutputIndexes);
विकल्प के तौर पर, यह तय करें कि
ANEURALNETWORKS_TENSOR_FLOAT32को IEEE 754 16-बिट फ़्लोटिंग-पॉइंट फ़ॉर्मैट जितनी कम रेंज या सटीक वैल्यू के साथ कैलकुलेट करने की अनुमति है या नहीं. इसके लिए,ANeuralNetworksModel_relaxComputationFloat32toFloat16()को कॉल करें.अपने मॉडल की परिभाषा को फ़ाइनल करने के लिए,
ANeuralNetworksModel_finish()को कॉल करें. अगर कोई गड़बड़ी नहीं होती है, तो यह फ़ंक्शनANEURALNETWORKS_NO_ERRORनतीजे वाला कोड दिखाता है.ANeuralNetworksModel_finish(model);
मॉडल बनाने के बाद, उसे कितनी भी बार कंपाइल किया जा सकता है. साथ ही, हर कंपाइलेशन को कितनी भी बार चलाया जा सकता है.
कंट्रोल फ़्लो
NNAPI मॉडल में कंट्रोल फ़्लो को शामिल करने के लिए, यह तरीका अपनाएं:
एग्ज़ीक्यूशन के लिए सबग्राफ़ बनाएं (
IFस्टेटमेंट के लिएthenऔरelseसबग्राफ़,WHILEलूप के लिएconditionऔरbodyसबग्राफ़). इन्हें स्टैंडअलोनANeuralNetworksModel*मॉडल के तौर पर बनाएं:ANeuralNetworksModel* thenModel = makeThenModel(); ANeuralNetworksModel* elseModel = makeElseModel();
कंट्रोल फ़्लो वाले मॉडल में, उन मॉडल का रेफ़रंस देने वाले ऑपरेंड बनाएं:
ANeuralNetworksOperandType modelType = {
    .type = ANEURALNETWORKS_MODEL,
};
ANeuralNetworksModel_addOperand(model, &modelType);  // kThenOperandIndex
ANeuralNetworksModel_addOperand(model, &modelType);  // kElseOperandIndex
ANeuralNetworksModel_setOperandValueFromModel(model, kThenOperandIndex, &thenModel);
ANeuralNetworksModel_setOperandValueFromModel(model, kElseOperandIndex, &elseModel);
कंट्रोल फ़्लो ऑपरेशन जोड़ें:
uint32_t inputs[] = {kConditionOperandIndex,
                     kThenOperandIndex,
                     kElseOperandIndex,
                     kInput1, kInput2, kInput3};
uint32_t outputs[] = {kOutput1, kOutput2};
ANeuralNetworksModel_addOperation(model, ANEURALNETWORKS_IF,
                                  std::size(inputs), inputs,
                                  std::size(output), outputs);
कंपाइलेशन
कंपाइलेशन के चरण में यह तय किया जाता है कि आपका मॉडल किन प्रोसेसर पर चलाया जाएगा. साथ ही, इससे जुड़े ड्राइवर को इसे चलाने के लिए तैयार होने के लिए कहा जाता है. इसमें, आपके मॉडल के लिए इस्तेमाल किए जाने वाले प्रोसेसर के हिसाब से मशीन कोड जनरेट करना शामिल हो सकता है.
किसी मॉडल को कंपाइल करने के लिए, यह तरीका अपनाएं:
नया कंपाइलेशन इंस्टेंस बनाने के लिए,
ANeuralNetworksCompilation_create()फ़ंक्शन को कॉल करें.// Compile the model ANeuralNetworksCompilation* compilation; ANeuralNetworksCompilation_create(model, &compilation);
इसके अलावा, डिवाइस असाइनमेंट का इस्तेमाल करके, यह साफ़ तौर पर चुना जा सकता है कि किन डिवाइसों पर टेस्ट चलाना है.
आपके पास यह तय करने का विकल्प होता है कि रनटाइम, बैटरी पावर के इस्तेमाल और एक्ज़ीक्यूशन की स्पीड के बीच कैसे संतुलन बनाए. इसके लिए,
ANeuralNetworksCompilation_setPreference()पर कॉल करें.// Ask to optimize for low power consumption ANeuralNetworksCompilation_setPreference(compilation, ANEURALNETWORKS_PREFER_LOW_POWER);
इनमें ये प्राथमिकताएं शामिल हैं:
ANEURALNETWORKS_PREFER_LOW_POWER: टास्क को इस तरह से पूरा करें कि बैटरी कम से कम खर्च हो. यह उन कंपाइलेशन के लिए ज़रूरी है जो अक्सर एक्ज़ीक्यूट किए जाते हैं.ANEURALNETWORKS_PREFER_FAST_SINGLE_ANSWER: जितनी जल्दी हो सके, एक जवाब दें. भले ही, इसमें ज़्यादा बैटरी खर्च हो. यह डिफ़ॉल्ट विकल्प है.ANEURALNETWORKS_PREFER_SUSTAINED_SPEED: एक के बाद एक आने वाले फ़्रेम के थ्रूपुट को बढ़ाने को प्राथमिकता दें. जैसे, कैमरे से एक के बाद एक आने वाले फ़्रेम को प्रोसेस करते समय.
आपके पास
ANeuralNetworksCompilation_setCachingको कॉल करके, कंपाइलेशन कैश मेमोरी सेट अप करने का विकल्प होता है.// Set up compilation caching ANeuralNetworksCompilation_setCaching(compilation, cacheDir, token);
cacheDirके लिए,getCodeCacheDir()का इस्तेमाल करें. ऐप्लिकेशन में मौजूद हर मॉडल के लिए,tokenकी वैल्यू यूनीक होनी चाहिए.ANeuralNetworksCompilation_finish()को कॉल करके, कंपाइलेशन की परिभाषा को पूरा करें. अगर कोई गड़बड़ी नहीं होती है, तो यह फ़ंक्शनANEURALNETWORKS_NO_ERRORका नतीजा कोड दिखाता है.ANeuralNetworksCompilation_finish(compilation);
डिवाइस का पता लगाना और उसे असाइन करना
Android 10 (एपीआई लेवल 29) और इसके बाद के वर्शन वाले Android डिवाइसों पर, NNAPI ऐसे फ़ंक्शन उपलब्ध कराता है जिनकी मदद से मशीन लर्निंग फ़्रेमवर्क लाइब्रेरी और ऐप्लिकेशन, उपलब्ध डिवाइसों के बारे में जानकारी हासिल कर सकते हैं. साथ ही, यह तय कर सकते हैं कि किन डिवाइसों का इस्तेमाल किया जाए. उपलब्ध डिवाइसों के बारे में जानकारी देने से, ऐप्लिकेशन को किसी डिवाइस पर मौजूद ड्राइवर का सटीक वर्शन मिल जाता है. इससे, डिवाइस के साथ काम न करने की समस्या से बचा जा सकता है. ऐप्लिकेशन को यह तय करने की सुविधा देकर कि किसी मॉडल के अलग-अलग सेक्शन को किन डिवाइसों पर चलाना है, ऐप्लिकेशन को उस Android डिवाइस के लिए ऑप्टिमाइज़ किया जा सकता है जिस पर उन्हें डिप्लॉय किया गया है.
कास्ट की सुविधा वाले डिवाइस खोजना
उपलब्ध डिवाइसों की संख्या जानने के लिए,
ANeuralNetworks_getDeviceCount
का इस्तेमाल करें. हर डिवाइस के लिए,
ANeuralNetworks_getDevice
का इस्तेमाल करके, ANeuralNetworksDevice इंस्टेंस को उस डिवाइस के रेफ़रंस पर सेट करें.
डिवाइस का रेफ़रंस मिलने के बाद, इन फ़ंक्शन का इस्तेमाल करके उस डिवाइस के बारे में ज़्यादा जानकारी पाई जा सकती है:
ANeuralNetworksDevice_getFeatureLevelANeuralNetworksDevice_getNameANeuralNetworksDevice_getTypeANeuralNetworksDevice_getVersion
डिवाइस असाइन करना
ANeuralNetworksModel_getSupportedOperationsForDevices
का इस्तेमाल करके जानें कि किसी मॉडल के कौनसे ऑपरेशन, चुनिंदा डिवाइसों पर चलाए जा सकते हैं.
एक्सीलिरेटर को कंट्रोल करने के लिए, ANeuralNetworksCompilation_create के बजाय ANeuralNetworksCompilation_createForDevices को कॉल करें.
नतीजे के तौर पर मिले ANeuralNetworksCompilation ऑब्जेक्ट का सामान्य तरीके से इस्तेमाल करें.
अगर दिए गए मॉडल में ऐसे ऑपरेशन शामिल हैं जो चुने गए डिवाइसों पर काम नहीं करते, तो फ़ंक्शन एक गड़बड़ी दिखाता है.
अगर एक से ज़्यादा डिवाइसों के बारे में बताया गया है, तो रनटाइम की ज़िम्मेदारी है कि वह सभी डिवाइसों पर काम को बांट दे.
अन्य डिवाइसों की तरह, NNAPI सीपीयू को लागू करने की प्रोसेस को ANeuralNetworksDevice से दिखाया जाता है. इसका नाम nnapi-reference और टाइप ANEURALNETWORKS_DEVICE_TYPE_CPU होता है. ANeuralNetworksCompilation_createForDevices को कॉल करते समय, सीपीयू इंप्लिमेंटेशन का इस्तेमाल, मॉडल कंपाइलेशन और एक्ज़ीक्यूशन के फ़ेलियर केस को हैंडल करने के लिए नहीं किया जाता.
यह ऐप्लिकेशन की ज़िम्मेदारी है कि वह किसी मॉडल को ऐसे सब-मॉडल में बांटे जो तय किए गए डिवाइसों पर चल सकें. जिन ऐप्लिकेशन को मैन्युअल तरीके से पार्टिशन करने की ज़रूरत नहीं है उन्हें मॉडल को तेज़ी से चलाने के लिए, उपलब्ध सभी डिवाइसों (सीपीयू के साथ) का इस्तेमाल करना चाहिए. इसके लिए, उन्हें आसान ANeuralNetworksCompilation_create को कॉल करना जारी रखना चाहिए. अगर ANeuralNetworksCompilation_createForDevices का इस्तेमाल करके बताए गए डिवाइसों पर मॉडल पूरी तरह से काम नहीं करता है, तो ANEURALNETWORKS_BAD_DATA दिखता है.
मॉडल पार्टिशनिंग
जब मॉडल के लिए कई डिवाइस उपलब्ध होते हैं, तो NNAPI रनटाइम, डिवाइसों के बीच काम को बांट देता है. उदाहरण के लिए, अगर ANeuralNetworksCompilation_createForDevices को एक से ज़्यादा डिवाइस दिए गए हैं, तो काम असाइन करते समय उन सभी डिवाइसों को ध्यान में रखा जाएगा. ध्यान दें कि अगर सीपीयू डिवाइस
सूची में नहीं है, तो सीपीयू एक्ज़ीक्यूशन बंद हो जाएगा. ANeuralNetworksCompilation_create का इस्तेमाल करने पर, उपलब्ध सभी डिवाइसों को ध्यान में रखा जाएगा. इनमें सीपीयू भी शामिल है.
डिवाइसों की सूची में से, मॉडल में मौजूद हर ऑपरेशन के लिए, उस डिवाइस को चुना जाता है जो ऑपरेशन को सपोर्ट करता हो और सबसे अच्छी परफ़ॉर्मेंस देता हो.जैसे, सबसे कम समय में ऑपरेशन पूरा करना या सबसे कम बिजली खर्च करना. यह क्लाइंट की ओर से तय की गई, ऑपरेशन को पूरा करने की प्राथमिकता पर निर्भर करता है. यह पार्टिशनिंग एल्गोरिदम, अलग-अलग प्रोसेसर के बीच IO की वजह से होने वाली संभावित गड़बड़ियों को ध्यान में नहीं रखता. इसलिए, कई प्रोसेसर तय करते समय (ANeuralNetworksCompilation_createForDevices का इस्तेमाल करते समय साफ़ तौर पर या ANeuralNetworksCompilation_create का इस्तेमाल करके इंप्लिसिट तौर पर), नतीजे के तौर पर मिलने वाले ऐप्लिकेशन की प्रोफ़ाइल बनाना ज़रूरी है.
यह समझने के लिए कि NNAPI ने आपके मॉडल को कैसे बांटा है, Android लॉग में मैसेज देखें. यह मैसेज, INFO लेवल पर ExecutionPlan टैग के साथ होता है:
ModelBuilder::findBestDeviceForEachOperation(op-name): device-index
op-name, ग्राफ़ में ऑपरेशन का ब्यौरा देने वाला नाम है और
device-index, डिवाइसों की सूची में मौजूद कैंडिडेट डिवाइस का इंडेक्स है.
यह सूची, ANeuralNetworksCompilation_createForDevices को दिए गए इनपुट की है. इसके अलावा, ANeuralNetworksCompilation_createForDevices का इस्तेमाल करने पर, यह उन डिवाइसों की सूची होती है जो ANeuralNetworks_getDeviceCount और ANeuralNetworks_getDevice का इस्तेमाल करके, सभी डिवाइसों को बार-बार दोहराने पर मिलती है.
मैसेज (टैग ExecutionPlan के साथ जानकारी के लेवल पर):
ModelBuilder::partitionTheWork: only one best device: device-name
इस मैसेज से पता चलता है कि डिवाइस device-name पर पूरे ग्राफ़ को तेज़ी से लोड किया गया है.
प्लान लागू करना
एक्ज़ीक्यूशन चरण, मॉडल को इनपुट के सेट पर लागू करता है. साथ ही, कंप्यूटेशन आउटपुट को एक या उससे ज़्यादा उपयोगकर्ता बफ़र या मेमोरी स्पेस में सेव करता है. ये बफ़र या मेमोरी स्पेस, आपके ऐप्लिकेशन ने असाइन किए होते हैं.
कंपाइल किए गए मॉडल को लागू करने के लिए, यह तरीका अपनाएं:
एक्ज़ीक्यूशन का नया इंस्टेंस बनाने के लिए,
ANeuralNetworksExecution_create()फ़ंक्शन को कॉल करें.// Run the compiled model against a set of inputs ANeuralNetworksExecution* run1 = NULL; ANeuralNetworksExecution_create(compilation, &run1);
यह बताएं कि आपका ऐप्लिकेशन, कंप्यूटेशन के लिए इनपुट वैल्यू कहां से पढ़ता है. आपका ऐप्लिकेशन,
ANeuralNetworksExecution_setInput()याANeuralNetworksExecution_setInputFromMemory()को कॉल करके, उपयोगकर्ता बफ़र या तय की गई मेमोरी स्पेस से इनपुट वैल्यू को पढ़ सकता है.// Set the single input to our sample model. Since it is small, we won't use a memory buffer float32 myInput[3][4] = { ...the data... }; ANeuralNetworksExecution_setInput(run1, 0, NULL, myInput, sizeof(myInput));
यह बताएं कि आपका ऐप्लिकेशन, आउटपुट वैल्यू कहां लिखता है. आपका ऐप्लिकेशन, आउटपुट वैल्यू को उपयोगकर्ता बफ़र या तय की गई मेमोरी स्पेस में लिख सकता है. इसके लिए, उसे क्रमशः
ANeuralNetworksExecution_setOutput()याANeuralNetworksExecution_setOutputFromMemory()को कॉल करना होगा.// Set the output float32 myOutput[3][4]; ANeuralNetworksExecution_setOutput(run1, 0, NULL, myOutput, sizeof(myOutput));
ANeuralNetworksExecution_startCompute()फ़ंक्शन को कॉल करके, एक्ज़ीक्यूशन शुरू होने का समय शेड्यूल करें. अगर कोई गड़बड़ी नहीं होती है, तो यह फ़ंक्शनANEURALNETWORKS_NO_ERRORका नतीजा कोड दिखाता है.// Starts the work. The work proceeds asynchronously ANeuralNetworksEvent* run1_end = NULL; ANeuralNetworksExecution_startCompute(run1, &run1_end);
एक्ज़ीक्यूशन पूरा होने का इंतज़ार करने के लिए,
ANeuralNetworksEvent_wait()फ़ंक्शन को कॉल करें. अगर प्रोसेस पूरी हो जाती है, तो यह फ़ंक्शनANEURALNETWORKS_NO_ERRORनतीजे वाला कोड दिखाता है. इंतज़ार करने की प्रोसेस, एक्ज़ीक्यूशन शुरू करने वाले थ्रेड के बजाय किसी दूसरे थ्रेड पर की जा सकती है.// For our example, we have no other work to do and will just wait for the completion ANeuralNetworksEvent_wait(run1_end); ANeuralNetworksEvent_free(run1_end); ANeuralNetworksExecution_free(run1);
इसके अलावा, कंपाइल किए गए मॉडल पर इनपुट का कोई दूसरा सेट लागू किया जा सकता है. इसके लिए, उसी कंपाइलेशन इंस्टेंस का इस्तेमाल करके नया
ANeuralNetworksExecutionइंस्टेंस बनाएं.// Apply the compiled model to a different set of inputs ANeuralNetworksExecution* run2; ANeuralNetworksExecution_create(compilation, &run2); ANeuralNetworksExecution_setInput(run2, ...); ANeuralNetworksExecution_setOutput(run2, ...); ANeuralNetworksEvent* run2_end = NULL; ANeuralNetworksExecution_startCompute(run2, &run2_end); ANeuralNetworksEvent_wait(run2_end); ANeuralNetworksEvent_free(run2_end); ANeuralNetworksExecution_free(run2);
सिंक्रोनस एक्ज़ीक्यूशन
एसिंक्रोनस एक्ज़ीक्यूशन में, थ्रेड को जनरेट और सिंक करने में समय लगता है. इसके अलावा, इंतज़ार का समय काफ़ी अलग-अलग हो सकता है. थ्रेड को सूचना मिलने या चालू होने और सीपीयू कोर से बाउंड होने के बीच, ज़्यादा से ज़्यादा 500 माइक्रोसेकंड की देरी हो सकती है.
लेटेंसी को कम करने के लिए, किसी ऐप्लिकेशन को रनटाइम के लिए सिंक्रोनस इन्फ़्रेंस कॉल करने का निर्देश दिया जा सकता है. यह कॉल, अनुमान शुरू होने के बाद नहीं, बल्कि अनुमान पूरा होने के बाद ही वापस आएगा. रनटाइम को एसिंक्रोनस अनुमान कॉल करने के लिए,
ANeuralNetworksExecution_startCompute
को कॉल करने के बजाय, ऐप्लिकेशन
ANeuralNetworksExecution_compute
को कॉल करता है, ताकि रनटाइम को सिंक्रोनस कॉल किया जा सके. ANeuralNetworksExecution_compute को कॉल करने पर, ANeuralNetworksEvent नहीं लिया जाता. साथ ही, इसे ANeuralNetworksEvent_wait को किए गए कॉल के साथ नहीं जोड़ा जाता.
बर्स्ट एक्ज़ीक्यूशन
Android 10 (एपीआई लेवल 29) और इसके बाद के वर्शन वाले Android डिवाइसों पर, एनएनएपीआई ANeuralNetworksBurst ऑब्जेक्ट की मदद से, एक साथ कई एक्ज़ीक्यूशन को सपोर्ट करता है. बर्स्ट एक्ज़ीक्यूशन, एक ही कंपाइलेशन के एक्ज़ीक्यूशन का क्रम होता है. ये एक के बाद एक तेज़ी से होते हैं. जैसे, कैमरे से कैप्चर किए गए फ़्रेम या लगातार ऑडियो सैंपल पर काम करने वाले एक्ज़ीक्यूशन. ANeuralNetworksBurst ऑब्जेक्ट का इस्तेमाल करने से, कोड तेज़ी से एक्ज़ीक्यूट हो सकते हैं. ऐसा इसलिए, क्योंकि ये ऑब्जेक्ट, ऐक्सेलरेटर को बताते हैं कि कोड के एक्ज़ीक्यूशन के बीच संसाधनों का फिर से इस्तेमाल किया जा सकता है. साथ ही, ऐक्सेलरेटर को बर्स्ट के दौरान, बेहतर परफ़ॉर्मेंस वाली स्थिति में रहना चाहिए.
ANeuralNetworksBurst, सामान्य तरीके से लागू होने वाले पाथ में सिर्फ़ एक छोटा सा बदलाव करता है. ANeuralNetworksBurst_create का इस्तेमाल करके, बर्स्ट ऑब्जेक्ट बनाया जाता है. इसके बारे में यहां दिए गए कोड स्निपेट में बताया गया है:
// Create burst object to be reused across a sequence of executions
ANeuralNetworksBurst* burst = NULL;
ANeuralNetworksBurst_create(compilation, &burst);
बर्स्ट एक्ज़ीक्यूशन सिंक्रोनस होते हैं. हालांकि, हर अनुमान के लिए ANeuralNetworksExecution_compute का इस्तेमाल करने के बजाय, ANeuralNetworksExecution_burstCompute फ़ंक्शन के कॉल में, अलग-अलग ANeuralNetworksExecution ऑब्जेक्ट को एक ही ANeuralNetworksBurst के साथ जोड़ा जाता है.
// Create and configure first execution object
// ...

// Execute using the burst object
ANeuralNetworksExecution_burstCompute(execution1, burst);

// Use results of first execution and free the execution object
// ...

// Create and configure second execution object
// ...

// Execute using the same burst object
ANeuralNetworksExecution_burstCompute(execution2, burst);

// Use results of second execution and free the execution object
// ...
जब ANeuralNetworksBurst ऑब्जेक्ट की ज़रूरत न हो, तो उसे
ANeuralNetworksBurst_free
की मदद से हटा दें.
// Cleanup
ANeuralNetworksBurst_free(burst);
एसिंक्रोनस कमांड क्यू और फ़ेंस्ड एक्ज़ीक्यूशन
Android 11 और इसके बाद के वर्शन में, NNAPI ANeuralNetworksExecution_startComputeWithDependencies() तरीके से एसिंक्रोनस एक्ज़ीक्यूशन को शेड्यूल करने का एक और तरीका उपलब्ध कराता है. इस तरीके का इस्तेमाल करने पर, आकलन शुरू करने से पहले, एक्ज़ीक्यूशन के लिए सभी डिपेंडेंट इवेंट के सिग्नल मिलने का इंतज़ार किया जाता है. जब प्रोसेस पूरी हो जाती है और आउटपुट इस्तेमाल के लिए तैयार हो जाते हैं, तब रिटर्न किए गए इवेंट का सिग्नल मिलता है.
इवेंट को सिंक फ़ेंस से बैकअप किया जा सकता है. यह इस बात पर निर्भर करता है कि कौनसे डिवाइस, एक्ज़ीक्यूशन को हैंडल करते हैं. इवेंट का इंतज़ार करने और एक्ज़ीक्यूशन में इस्तेमाल किए गए संसाधनों को वापस पाने के लिए, आपको ANeuralNetworksEvent_wait() को कॉल करना होगा. ANeuralNetworksEvent_createFromSyncFenceFd() का इस्तेमाल करके, सिंक फ़ेंस को किसी इवेंट ऑब्जेक्ट में इंपोर्ट किया जा सकता है. साथ ही, ANeuralNetworksEvent_getSyncFenceFd() का इस्तेमाल करके, सिंक फ़ेंस को किसी इवेंट ऑब्जेक्ट से एक्सपोर्ट किया जा सकता है.
डाइनैमिक साइज़ वाले आउटपुट
ऐसे मॉडल के लिए जहां आउटपुट का साइज़, इनपुट डेटा पर निर्भर करता है—यानी कि जहां मॉडल के लागू होने के समय साइज़ तय नहीं किया जा सकता—ANeuralNetworksExecution_getOutputOperandRank और ANeuralNetworksExecution_getOutputOperandDimensions का इस्तेमाल करें.
यहां दिए गए कोड सैंपल में, ऐसा करने का तरीका बताया गया है:
// Get the rank of the output
uint32_t myOutputRank = 0;
ANeuralNetworksExecution_getOutputOperandRank(run1, 0, &myOutputRank);

// Get the dimensions of the output
std::vector<uint32_t> myOutputDimensions(myOutputRank);
ANeuralNetworksExecution_getOutputOperandDimensions(run1, 0, myOutputDimensions.data());
साफ़-सफ़ाई सेवा
क्लीनअप चरण, आपके कंप्यूटेशन के लिए इस्तेमाल किए गए इंटरनल रिसॉर्स को खाली करने का काम करता है.
// Cleanup
ANeuralNetworksCompilation_free(compilation);
ANeuralNetworksModel_free(model);
ANeuralNetworksMemory_free(mem1);
गड़बड़ी को मैनेज करना और सीपीयू फ़ॉलबैक
अगर पार्टिशन करने के दौरान कोई गड़बड़ी होती है, अगर कोई ड्राइवर किसी मॉडल के (किसी हिस्से) को कंपाइल नहीं कर पाता है या अगर कोई ड्राइवर कंपाइल किए गए मॉडल के (किसी हिस्से) को लागू नहीं कर पाता है, तो हो सकता है कि NNAPI एक या उससे ज़्यादा कार्रवाइयों के लिए, अपने सीपीयू को लागू करने की सुविधा का इस्तेमाल करे.
अगर NNAPI क्लाइंट में ऑपरेशन के ऑप्टिमाइज़ किए गए वर्शन (जैसे, TFLite) शामिल हैं, तो सीपीयू फ़ॉलबैक को बंद करना और क्लाइंट के ऑप्टिमाइज़ किए गए ऑपरेशन को लागू करके गड़बड़ियों को ठीक करना फ़ायदेमंद हो सकता है.
Android 10 में, अगर कंपाइलेशन के लिए ANeuralNetworksCompilation_createForDevices का इस्तेमाल किया जाता है, तो सीपीयू फ़ॉलबैक की सुविधा बंद हो जाएगी.
Android P में, अगर ड्राइवर पर NNAPI का एक्ज़ीक्यूशन नहीं हो पाता है, तो वह सीपीयू पर वापस चला जाता है.
Android 10 पर भी ऐसा ही होता है, जब ANeuralNetworksCompilation_createForDevices के बजाय ANeuralNetworksCompilation_create का इस्तेमाल किया जाता है.
पहले एक्ज़ीक्यूशन के लिए, उस सिंगल पार्टिशन का इस्तेमाल किया जाता है. अगर वह भी काम नहीं करता है, तो सीपीयू पर पूरे मॉडल को फिर से एक्ज़ीक्यूट करने की कोशिश की जाती है.
अगर पार्टिशनिंग या कंपाइलेशन की प्रोसेस पूरी नहीं हो पाती है, तो पूरे मॉडल को सीपीयू पर चलाने की कोशिश की जाएगी.
कुछ मामलों में, सीपीयू पर कुछ कार्रवाइयां काम नहीं करती हैं. ऐसे मामलों में, कंपाइलेशन या एक्ज़ीक्यूशन फ़ेल हो जाएगा.
सीपीयू फ़ॉलबैक की सुविधा बंद करने के बाद भी, हो सकता है कि मॉडल में कुछ ऐसे ऑपरेशन हों जो सीपीयू पर शेड्यूल किए गए हों. अगर सीपीयू, ANeuralNetworksCompilation_createForDevices को दिए गए प्रोसेसर की सूची में शामिल है और वह उन कार्रवाइयों के साथ काम करने वाला एकमात्र प्रोसेसर है या उन कार्रवाइयों के लिए सबसे अच्छी परफ़ॉर्मेंस देने का दावा करता है, तो उसे प्राइमरी (नॉन-फ़ॉलबैक) एक्ज़ीक्यूटर के तौर पर चुना जाएगा.
यह पक्का करने के लिए कि सीपीयू का इस्तेमाल न हो, ANeuralNetworksCompilation_createForDevices का इस्तेमाल करें. साथ ही, डिवाइसों की सूची से nnapi-reference को हटा दें.
Android P से, डीबग के लिए बिल्ड पर, एक्ज़ीक्यूशन के समय फ़ॉलबैक को बंद किया जा सकता है. इसके लिए, debug.nn.partition प्रॉपर्टी को 2 पर सेट करना होगा.
मेमोरी डोमेन
Android 11 और इसके बाद के वर्शन में, NNAPI उन मेमोरी डोमेन के साथ काम करता है जो ओपेक मेमोरी के लिए, ऐलोकेटर इंटरफ़ेस उपलब्ध कराते हैं. इससे ऐप्लिकेशन, डिवाइस की नेटिव मेमोरी को एक से दूसरे एक्ज़ीक्यूशन में पास कर सकते हैं. इससे NNAPI को एक ही ड्राइवर पर लगातार एक्ज़ीक्यूशन करते समय, डेटा को बेवजह कॉपी या ट्रांसफ़ॉर्म नहीं करना पड़ता.
मेमोरी डोमेन की सुविधा, उन टेंसर के लिए है जो ज़्यादातर ड्राइवर के अंदर होते हैं और जिन्हें क्लाइंट साइड पर बार-बार ऐक्सेस करने की ज़रूरत नहीं होती. ऐसे टेंसर के उदाहरणों में, सीक्वेंस मॉडल में मौजूद स्टेट टेंसर शामिल हैं. ऐसे टेंसर के लिए जिन्हें क्लाइंट साइड पर सीपीयू को बार-बार ऐक्सेस करने की ज़रूरत होती है, शेयर किए गए मेमोरी पूल का इस्तेमाल करें.
ओपेक मेमोरी को ऐलोकेट करने के लिए, यह तरीका अपनाएं:
नया मेमोरी डिस्क्रिप्टर बनाने के लिए,
ANeuralNetworksMemoryDesc_create()फ़ंक्शन को कॉल करें:// Create a memory descriptor ANeuralNetworksMemoryDesc* desc; ANeuralNetworksMemoryDesc_create(&desc);
ANeuralNetworksMemoryDesc_addInputRole()औरANeuralNetworksMemoryDesc_addOutputRole()को कॉल करके, इनपुट और आउटपुट की सभी भूमिकाएं तय करें.// Specify that the memory may be used as the first input and the first output // of the compilation ANeuralNetworksMemoryDesc_addInputRole(desc, compilation, 0, 1.0f); ANeuralNetworksMemoryDesc_addOutputRole(desc, compilation, 0, 1.0f);
इसके अलावा,
ANeuralNetworksMemoryDesc_setDimensions()को कॉल करके, मेमोरी डाइमेंशन की जानकारी दी जा सकती है.// Specify the memory dimensions uint32_t dims[] = {3, 4}; ANeuralNetworksMemoryDesc_setDimensions(desc, 2, dims);
ANeuralNetworksMemoryDesc_finish()को कॉल करके, डिस्क्रिप्टर की परिभाषा को फ़ाइनल करें.ANeuralNetworksMemoryDesc_finish(desc);
ANeuralNetworksMemory_createFromDesc()को डिस्क्रिप्टर पास करके, ज़रूरत के मुताबिक मेमोरी असाइन करें.// Allocate two opaque memories with the descriptor ANeuralNetworksMemory* opaqueMem; ANeuralNetworksMemory_createFromDesc(desc, &opaqueMem);
जब आपको मेमोरी डिस्क्रिप्टर की ज़रूरत न हो, तो उसे खाली कर दें.
ANeuralNetworksMemoryDesc_free(desc);
क्लाइंट, बनाए गए ANeuralNetworksMemory ऑब्जेक्ट का इस्तेमाल सिर्फ़ ANeuralNetworksExecution_setInputFromMemory() या ANeuralNetworksExecution_setOutputFromMemory() के साथ कर सकता है. ऐसा ANeuralNetworksMemoryDesc ऑब्जेक्ट में बताई गई भूमिकाओं के मुताबिक किया जा सकता है. ऑफ़सेट और लंबाई वाले आर्ग्युमेंट को 0 पर सेट करना ज़रूरी है. इससे पता चलता है कि पूरी मेमोरी का इस्तेमाल किया गया है. क्लाइंट, ANeuralNetworksMemory_copy() का इस्तेमाल करके, मेमोरी के कॉन्टेंट को साफ़ तौर पर सेट या एक्सट्रैक्ट भी कर सकता है.
आपके पास ऐसी ओपेक मेमोरी बनाने का विकल्प है जिनमें डाइमेंशन या रैंक की जानकारी न हो.
ऐसे में, अगर मौजूदा ड्राइवर के साथ काम नहीं करता है, तो ANEURALNETWORKS_OP_FAILED स्टेटस के साथ मेमोरी बनाने की प्रोसेस पूरी नहीं हो पाएगी. क्लाइंट को फ़ॉलबैक लॉजिक लागू करने के लिए बढ़ावा दिया जाता है. इसके लिए, Ashmem या BLOB-mode AHardwareBuffer की मदद से, ज़रूरत के मुताबिक बड़ा बफ़र तय किया जाता है.
जब NNAPI को ओपेक मेमोरी ऑब्जेक्ट को ऐक्सेस करने की ज़रूरत न हो, तो उससे जुड़े ANeuralNetworksMemory इंस्टेंस को खाली कर दें:
ANeuralNetworksMemory_free(opaqueMem);
परफ़ॉर्मेंस का आकलन करना
अपने ऐप्लिकेशन की परफ़ॉर्मेंस का आकलन करने के लिए, एक्ज़ीक्यूशन टाइम को मेज़र करें या प्रोफ़ाइलिंग करें.
एक्ज़ीक्यूशन का समय
रनटाइम के ज़रिए, स्क्रिप्ट को पूरा होने में लगने वाले कुल समय का पता लगाने के लिए, सिंक्रोनस एक्ज़ीक्यूशन एपीआई का इस्तेमाल किया जा सकता है. साथ ही, कॉल में लगने वाले समय को मेज़र किया जा सकता है. जब आपको सॉफ़्टवेयर स्टैक के निचले लेवल से, कोड को लागू करने में लगने वाले कुल समय का पता लगाना हो, तो ANeuralNetworksExecution_setMeasureTiming और ANeuralNetworksExecution_getDuration का इस्तेमाल करके, यह जानकारी हासिल की जा सकती है:
- एक्सेलरेटर पर एक्ज़ीक्यूशन का समय (ड्राइवर में नहीं, जो होस्ट प्रोसेसर पर चलता है).
- ड्राइवर में एक्ज़ीक्यूशन का समय. इसमें ऐक्सेलरेटर पर बिताया गया समय भी शामिल है.
ड्राइवर में प्रोग्राम चलाने के समय में, ओवरहेड शामिल नहीं होता. जैसे, रनटाइम और रनटाइम के लिए ड्राइवर के साथ कम्यूनिकेट करने के लिए ज़रूरी आईपीसी.
ये एपीआई, सबमिट किए गए काम और पूरे किए गए काम के बीच की अवधि को मेज़र करते हैं. ये एपीआई, अनुमान लगाने के लिए ड्राइवर या ऐक्सेलरेटर के समय को मेज़र नहीं करते. ऐसा हो सकता है कि कॉन्टेक्स्ट स्विच करने की वजह से, अनुमान लगाने में रुकावट आए.
उदाहरण के लिए, अगर अनुमान 1 शुरू होता है, तो ड्राइवर अनुमान 2 को पूरा करने के लिए काम करना बंद कर देता है. इसके बाद, वह अनुमान 1 को फिर से शुरू करता है और पूरा करता है. अनुमान 1 को पूरा करने में लगने वाले समय में, वह समय भी शामिल होगा जब अनुमान 2 को पूरा करने के लिए काम करना बंद कर दिया गया था.
समय की यह जानकारी, किसी ऐप्लिकेशन के प्रोडक्शन डिप्लॉयमेंट के लिए काम की हो सकती है. इससे ऑफ़लाइन इस्तेमाल के लिए टेलीमेट्री इकट्ठा की जा सकती है. समय के डेटा का इस्तेमाल करके, ऐप्लिकेशन में बदलाव किया जा सकता है, ताकि उसकी परफ़ॉर्मेंस को बेहतर बनाया जा सके.
इस सुविधा का इस्तेमाल करते समय, इन बातों का ध्यान रखें:
- समय की जानकारी इकट्ठा करने से, परफ़ॉर्मेंस पर असर पड़ सकता है.
- सिर्फ़ ड्राइवर ही यह हिसाब लगा सकता है कि उसने खुद पर या ऐक्सेलरेटर पर कितना समय बिताया. इसमें एनएनएपीआई रनटाइम और आईपीसी में बिताया गया समय शामिल नहीं होता.
- इन एपीआई का इस्तेमाल सिर्फ़ उस
ANeuralNetworksExecutionके साथ किया जा सकता है जिसेnumDevices = 1के साथANeuralNetworksCompilation_createForDevicesका इस्तेमाल करके बनाया गया हो. - समय की जानकारी देने के लिए, किसी ड्राइवर की ज़रूरत नहीं होती.
Android Systrace की मदद से अपने ऐप्लिकेशन की प्रोफ़ाइल बनाना
Android 10 से, NNAPI अपने-आप systrace इवेंट जनरेट करता है. इनका इस्तेमाल करके, अपने ऐप्लिकेशन की प्रोफ़ाइल बनाई जा सकती है.
NNAPI सोर्स में parse_systrace यूटिलिटी होती है. इससे आपके ऐप्लिकेशन से जनरेट हुए systrace इवेंट को प्रोसेस किया जाता है. साथ ही, एक टेबल व्यू जनरेट किया जाता है. इसमें मॉडल लाइफ़साइकल के अलग-अलग फ़ेज़ (इंस्टैंशिएशन, तैयारी, कंपाइलेशन, एक्ज़ीक्यूशन, और टर्मिनेशन) और ऐप्लिकेशन की अलग-अलग लेयर में बिताया गया समय दिखता है. आपके ऐप्लिकेशन को इन लेयर में बांटा गया है:
Application: ऐप्लिकेशन कोडRuntime: NNAPI रनटाइमIPC: NNAPI रनटाइम और ड्राइवर कोड के बीच इंटर प्रोसेस कम्यूनिकेशनDriver: ऐक्सेलरेटर ड्राइवर प्रोसेस.
प्रोफ़ाइलिंग विश्लेषण का डेटा जनरेट करना
मान लें कि आपने $ANDROID_BUILD_TOP पर एओएसपी सोर्स ट्री को देखा है और टारगेट ऐप्लिकेशन के तौर पर TFLite इमेज क्लासिफ़िकेशन के उदाहरण का इस्तेमाल किया है. ऐसे में, इन चरणों को पूरा करके एनएनएपीआई प्रोफ़ाइलिंग डेटा जनरेट किया जा सकता है:
- इस निर्देश की मदद से, Android systrace शुरू करें:
$ANDROID_BUILD_TOP/external/chromium-trace/systrace.py -o trace.html -a org.tensorflow.lite.examples.classification nnapi hal freq sched idle load binder_driver
-o trace.html पैरामीटर से पता चलता है कि ट्रेस, trace.html में लिखे जाएंगे. अपने ऐप्लिकेशन की प्रोफ़ाइल बनाते समय, आपको org.tensorflow.lite.examples.classification को अपने ऐप्लिकेशन मेनिफ़ेस्ट में बताई गई प्रोसेस के नाम से बदलना होगा.
इससे आपका एक शेल कंसोल व्यस्त रहेगा. कमांड को बैकग्राउंड में न चलाएं, क्योंकि यह इंटरैक्टिव तरीके से enter के बंद होने का इंतज़ार कर रहा है.
- सिस्ट्रेस कलेक्टर शुरू होने के बाद, अपना ऐप्लिकेशन शुरू करें और मानदंड की जांच करें.
हमारे मामले में, Android Studio से इमेज क्लासिफ़िकेशन ऐप्लिकेशन को शुरू किया जा सकता है. इसके अलावा, अगर ऐप्लिकेशन पहले से इंस्टॉल है, तो सीधे टेस्ट फ़ोन के यूज़र इंटरफ़ेस (यूआई) से भी इसे शुरू किया जा सकता है. कुछ NNAPI डेटा जनरेट करने के लिए, आपको ऐप्लिकेशन को NNAPI का इस्तेमाल करने के लिए कॉन्फ़िगर करना होगा. इसके लिए, ऐप्लिकेशन कॉन्फ़िगरेशन डायलॉग में टारगेट डिवाइस के तौर पर NNAPI को चुनें.
टेस्ट पूरा होने के बाद, पहले चरण से चालू कंसोल टर्मिनल पर
enterदबाकर, systrace को बंद करें.कुल आंकड़े जनरेट करने के लिए,
systrace_parserयूटिलिटी चलाएं:
$ANDROID_BUILD_TOP/frameworks/ml/nn/tools/systrace_parser/parse_systrace.py --total-times trace.html
पार्सर इन पैरामीटर को स्वीकार करता है:
- --total-times: इससे किसी लेयर में बिताया गया कुल समय दिखता है. इसमें, किसी अंडरलाइंग लेयर को किए गए कॉल पर, एक्ज़ीक्यूशन के इंतज़ार में बिताया गया समय भी शामिल होता है
- --print-detail: इससे systrace से इकट्ठा किए गए सभी इवेंट प्रिंट होते हैं
- --per-execution: इससे सभी फ़ेज़ के आंकड़ों के बजाय, सिर्फ़ एक्ज़ीक्यूशन और उसके सबफ़ेज़ (हर एक्ज़ीक्यूशन के समय के हिसाब से) प्रिंट होते हैं
- --json: इससे आउटपुट, JSON फ़ॉर्मैट में जनरेट होता है
आउटपुट का एक उदाहरण यहां दिया गया है:
===========================================================================================================================================
NNAPI timing summary (total time, ms wall-clock)                                                      Execution
                                                           ----------------------------------------------------
              Initialization   Preparation   Compilation           I/O       Compute      Results     Ex. total   Termination        Total
              --------------   -----------   -----------   -----------  ------------  -----------   -----------   -----------   ----------
Application              n/a         19.06       1789.25           n/a           n/a         6.70         21.37           n/a      1831.17*
Runtime                    -         18.60       1787.48          2.93         11.37         0.12         14.42          1.32      1821.81
IPC                     1.77             -       1781.36          0.02          8.86            -          8.88             -      1792.01
Driver                  1.04             -       1779.21           n/a           n/a          n/a          7.70             -      1787.95

Total                   1.77*        19.06*      1789.25*         2.93*        11.74*        6.70*        21.37*         1.32*     1831.17*
===========================================================================================================================================
* This total ignores missing (n/a) values and thus is not necessarily consistent with the rest of the numbers
अगर इकट्ठा किए गए इवेंट, ऐप्लिकेशन ट्रेस की पूरी जानकारी नहीं देते हैं, तो हो सकता है कि पार्सर काम न करे. खास तौर पर, ऐसा तब हो सकता है, जब किसी सेक्शन के खत्म होने की जानकारी देने के लिए जनरेट किए गए systrace इवेंट, ट्रेस में मौजूद हों. हालांकि, उनसे जुड़ा सेक्शन शुरू होने का इवेंट मौजूद न हो. आम तौर पर, ऐसा तब होता है, जब सिस्ट्रेस कलेक्टर को शुरू करने पर, प्रोफ़ाइलिंग के पिछले सेशन के कुछ इवेंट जनरेट हो रहे हों. इस मामले में, आपको प्रोफ़ाइल बनाने की प्रोसेस फिर से शुरू करनी होगी.
systrace_parser आउटपुट में अपने ऐप्लिकेशन कोड के आंकड़े जोड़ना
parse_systrace ऐप्लिकेशन, Android systrace की पहले से मौजूद सुविधा पर आधारित है. कस्टम इवेंट के नामों के साथ systrace API (Java के लिए, नेटिव ऐप्लिकेशन के लिए) का इस्तेमाल करके, अपने ऐप्लिकेशन में खास कार्रवाइयों के लिए ट्रेस जोड़े जा सकते हैं.
अपने कस्टम इवेंट को ऐप्लिकेशन लाइफ़साइकल के फ़ेज़ से जोड़ने के लिए, इवेंट के नाम से पहले इनमें से कोई एक स्ट्रिंग जोड़ें:
[NN_LA_PI]: ऐप्लिकेशन लेवल पर होने वाला इवेंट, जो इनिशलाइज़ेशन के लिए है[NN_LA_PP]: ऐप्लिकेशन लेवल पर इवेंट की तैयारी[NN_LA_PC]: कंपाइलेशन के लिए ऐप्लिकेशन लेवल इवेंट[NN_LA_PE]: एप्लिकेशन लेवल पर, एक्ज़ीक्यूशन के लिए इवेंट
यहां एक उदाहरण दिया गया है, जिसमें बताया गया है कि TFLite इमेज क्लासिफ़िकेशन के उदाहरण वाले कोड में बदलाव कैसे किया जा सकता है. इसके लिए, Execution फ़ेज़ के लिए runInferenceModel सेक्शन और Application लेयर जोड़ें. इसमें अन्य सेक्शन preprocessBitmap शामिल हैं, जिन्हें NNAPI ट्रेस में शामिल नहीं किया जाएगा. runInferenceModel सेक्शन, nnapi systrace parser से प्रोसेस किए गए systrace इवेंट का हिस्सा होगा:
Kotlin
/** Runs inference and returns the classification results. */ fun recognizeImage(bitmap: Bitmap): List{ // This section won’t appear in the NNAPI systrace analysis Trace.beginSection("preprocessBitmap") convertBitmapToByteBuffer(bitmap) Trace.endSection() // Run the inference call. // Add this method in to NNAPI systrace analysis. Trace.beginSection("[NN_LA_PE]runInferenceModel") long startTime = SystemClock.uptimeMillis() runInference() long endTime = SystemClock.uptimeMillis() Trace.endSection() ... return recognitions }
Java
/** Runs inference and returns the classification results. */ public ListrecognizeImage(final Bitmap bitmap) { // This section won’t appear in the NNAPI systrace analysis Trace.beginSection("preprocessBitmap"); convertBitmapToByteBuffer(bitmap); Trace.endSection(); // Run the inference call. // Add this method in to NNAPI systrace analysis. Trace.beginSection("[NN_LA_PE]runInferenceModel"); long startTime = SystemClock.uptimeMillis(); runInference(); long endTime = SystemClock.uptimeMillis(); Trace.endSection(); ... Trace.endSection(); return recognitions; }
सेवा की क्वालिटी
Android 11 और इसके बाद के वर्शन में, NNAPI की मदद से सेवा की क्वालिटी (क्यूओएस) को बेहतर बनाया जा सकता है. इसके लिए, ऐप्लिकेशन को अपने मॉडल की प्राथमिकताएं, किसी मॉडल को तैयार करने में लगने वाला ज़्यादा से ज़्यादा समय, और किसी कंप्यूटेशन को पूरा करने में लगने वाला ज़्यादा से ज़्यादा समय बताना होगा. Android 11 में, NNAPI के अतिरिक्त नतीजे के कोड भी शामिल किए गए हैं. इनकी मदद से, ऐप्लिकेशन को गड़बड़ियों को समझने में मदद मिलती है. जैसे, एक्ज़ीक्यूशन की समयसीमा पूरी न होना.
वर्कलोड की प्राथमिकता सेट करना
NNAPI वर्कलोड की प्राथमिकता सेट करने के लिए, ANeuralNetworksCompilation_finish() को कॉल करने से पहले, ANeuralNetworksCompilation_setPriority() को कॉल करें.
समयसीमाएं सेट करना
ऐप्लिकेशन, मॉडल कंपाइलेशन और अनुमान, दोनों के लिए समयसीमाएं सेट कर सकते हैं.
- कंपाइलेशन टाइम आउट सेट करने के लिए,
ANeuralNetworksCompilation_finish()को कॉल करने से पहलेANeuralNetworksCompilation_setTimeout()को कॉल करें. - अनुमान लगाने की प्रोसेस के टाइम आउट होने की अवधि सेट करने के लिए, कंपाइलेशन शुरू करने से पहले
ANeuralNetworksExecution_setTimeout()को कॉल करें.
ऑपरेंड के बारे में ज़्यादा जानकारी
इस सेक्शन में, ऑपरेंड इस्तेमाल करने के बारे में ऐडवांस जानकारी दी गई है.
क्वांटाइज़्ड टेंसर
क्वांटाइज़्ड टेंसर, फ़्लोटिंग पॉइंट वैल्यू के n-डाइमेंशनल कलेक्शन को दिखाने का एक कॉम्पैक्ट तरीका है.
NNAPI, 8-बिट वाले एसिमेट्रिक क्वांटाइज़्ड टेंसर के साथ काम करता है. इन टेंसर के लिए, हर सेल की वैल्यू को 8-बिट वाले पूर्णांक से दिखाया जाता है. टेंसर के साथ एक स्केल और एक ज़ीरो पॉइंट वैल्यू जुड़ी होती है. इनका इस्तेमाल, 8-बिट वाले पूर्णांकों को फ़्लोटिंग पॉइंट वैल्यू में बदलने के लिए किया जाता है.
फ़ॉर्मूला यह है:
(cellValue - zeroPoint) * scale
जहां zeroPoint वैल्यू 32-बिट का पूर्णांक है और स्केल 32-बिट की फ़्लोटिंग पॉइंट वैल्यू है.
32-बिट फ़्लोटिंग पॉइंट वैल्यू वाले टेंसर की तुलना में, 8-बिट क्वांटाइज़्ड टेंसर के दो फ़ायदे हैं:
- आपका ऐप्लिकेशन छोटा है, क्योंकि ट्रेन किए गए वेट, 32-बिट टेंसर के साइज़ का एक चौथाई हिस्सा लेते हैं.
- कंप्यूटेशन को अक्सर तेज़ी से पूरा किया जा सकता है. ऐसा इसलिए होता है, क्योंकि मेमोरी से कम डेटा फ़ेच करना पड़ता है. साथ ही, डीएसपी जैसे प्रोसेसर, पूर्णांक वाले गणित को बेहतर तरीके से हल कर पाते हैं.
फ़्लोटिंग पॉइंट मॉडल को क्वांटाइज़्ड मॉडल में बदला जा सकता है. हालांकि, हमारे अनुभव से पता चला है कि क्वांटाइज़्ड मॉडल को सीधे तौर पर ट्रेन करने से बेहतर नतीजे मिलते हैं. असल में, न्यूरल नेटवर्क हर वैल्यू की ज़्यादा जानकारी को मैनेज करना सीखता है. हर क्वांटाइज़्ड टेंसर के लिए, स्केल और zeroPoint वैल्यू, ट्रेनिंग प्रोसेस के दौरान तय की जाती हैं.
NNAPI में, क्वांटाइज़्ड टेंसर टाइप तय करने के लिए, ANeuralNetworksOperandType डेटा स्ट्रक्चर के टाइप फ़ील्ड को ANEURALNETWORKS_TENSOR_QUANT8_ASYMM पर सेट करें.
उस डेटा स्ट्रक्चर में, टेंसर के स्केल और zeroPoint की वैल्यू भी तय की जाती है.
8-बिट एसिमेट्रिक क्वांटाइज़्ड टेंसर के अलावा, NNAPI में ये भी काम करते हैं:
ANEURALNETWORKS_TENSOR_QUANT8_SYMM_PER_CHANNELइसका इस्तेमाल,CONV/DEPTHWISE_CONV/TRANSPOSED_CONVऑपरेशन के लिए वेट दिखाने के लिए किया जा सकता है.ANEURALNETWORKS_TENSOR_QUANT16_ASYMMइसका इस्तेमाल,QUANTIZED_16BIT_LSTMके इंटरनल स्टेट के लिए किया जा सकता है.ANEURALNETWORKS_TENSOR_QUANT8_SYMMयहANEURALNETWORKS_DEQUANTIZEके लिए इनपुट हो सकता है.
वैकल्पिक ऑपरेंड
कुछ ऑपरेशन, जैसे कि
ANEURALNETWORKS_LSH_PROJECTION,
वैकल्पिक ऑपरेंड लेते हैं. मॉडल में यह बताने के लिए कि वैकल्पिक ऑपरेंड को शामिल नहीं किया गया है, ANeuralNetworksModel_setOperandValue() फ़ंक्शन को कॉल करें. साथ ही, बफ़र के लिए NULL और लंबाई के लिए 0 पास करें.
अगर हर बार लागू करने पर, ऑपरेंड मौजूद है या नहीं, इस बारे में फ़ैसला अलग-अलग होता है, तो आपको यह बताना होगा कि ऑपरेंड को शामिल नहीं किया गया है. इसके लिए,
ANeuralNetworksExecution_setInput()
या
ANeuralNetworksExecution_setOutput()
फ़ंक्शन का इस्तेमाल करें. साथ ही, बफ़र के लिए NULL और लंबाई के लिए 0 पास करें.
अज्ञात रैंक के टेंसर
Android 9 (एपीआई लेवल 28) में, मॉडल ऑपरेंड के डाइमेंशन की जानकारी नहीं होती थी. हालांकि, रैंक (डाइमेंशन की संख्या) की जानकारी होती थी. Android 10 (एपीआई लेवल 29) में, अज्ञात रैंक के टेंसर जोड़े गए हैं. इनके बारे में ANeuralNetworksOperandType में बताया गया है.
NNAPI बेंचमार्क
NNAPI मानदंड, एओएसपी में platform/test/mlts/benchmark (मानदंड ऐप्लिकेशन) और platform/test/mlts/models (मॉडल और डेटासेट) पर उपलब्ध है.
बेंचमार्क, इंतज़ार के समय और सटीक होने का आकलन करता है. साथ ही, यह ड्राइवर की तुलना, सीपीयू पर चल रहे TensorFlow लाइट का इस्तेमाल करके किए गए काम से करता है. यह तुलना, एक जैसे मॉडल और डेटासेट के लिए की जाती है.
बेंचमार्क का इस्तेमाल करने के लिए, यह तरीका अपनाएं:
टारगेट Android डिवाइस को अपने कंप्यूटर से कनेक्ट करें और टर्मिनल विंडो खोलें. साथ ही, पक्का करें कि डिवाइस को adb के ज़रिए ऐक्सेस किया जा सकता हो.
अगर एक से ज़्यादा Android डिवाइस कनेक्ट हैं, तो टारगेट डिवाइस के एनवायरमेंट वैरिएबल
ANDROID_SERIALको एक्सपोर्ट करें.Android की टॉप-लेवल सोर्स डायरेक्ट्री पर जाएं.
ये कमांड दें:
lunch aosp_arm-userdebug # Or aosp_arm64-userdebug if available
./test/mlts/benchmark/build_and_run_benchmark.sh
बेंचमार्क रन के आखिर में, इसके नतीजे एचटीएमएल पेज के तौर पर दिखाए जाएंगे. यह पेज,
xdg-openको पास किया जाएगा.
NNAPI लॉग
NNAPI, सिस्टम लॉग में गड़बड़ी की जानकारी जनरेट करता है. लॉग का विश्लेषण करने के लिए, logcat यूटिलिटी का इस्तेमाल करें.
खास फ़ेज़ या कॉम्पोनेंट के लिए, ज़्यादा शब्दों में NNAPI लॉगिंग की सुविधा चालू करें. इसके लिए, debug.nn.vlog प्रॉपर्टी (adb shell का इस्तेमाल करके) को वैल्यू की इस सूची पर सेट करें. इन वैल्यू को स्पेस, कोलन या कॉमा लगाकर अलग करें:
model: मॉडल बनाया जा रहा हैcompilation: मॉडल को लागू करने का प्लान जनरेट करना और उसे कंपाइल करनाexecution: मॉडल को लागू करनाcpuexe: एनएनएपीआई सीपीयू का इस्तेमाल करके, ऑपरेशन को लागू करनाmanager: एनएनएपीआई एक्सटेंशन, उपलब्ध इंटरफ़ेस, और क्षमताओं से जुड़ी जानकारीallया1: ऊपर दिए गए सभी एलिमेंट
उदाहरण के लिए, पूरी तरह से वर्बोस लॉगिंग चालू करने के लिए, adb shell setprop debug.nn.vlog all निर्देश का इस्तेमाल करें. वर्बोस लॉगिंग को बंद करने के लिए, adb shell setprop debug.nn.vlog '""' निर्देश का इस्तेमाल करें.
चालू होने के बाद, ज़्यादा शब्दों में लॉग करने की सुविधा, INFO लेवल पर लॉग एंट्री जनरेट करती है. इसमें फ़ेज़ या कॉम्पोनेंट के नाम पर सेट किया गया टैग होता है.
debug.nn.vlog कंट्रोल किए गए मैसेज के अलावा, NNAPI एपीआई कॉम्पोनेंट अलग-अलग लेवल पर अन्य लॉग एंट्री उपलब्ध कराते हैं. हर एंट्री के लिए, एक खास लॉग टैग का इस्तेमाल किया जाता है.
कॉम्पोनेंट की सूची पाने के लिए, इस एक्सप्रेशन का इस्तेमाल करके सोर्स ट्री खोजें:
grep -R 'define LOG_TAG' | awk -F '"' '{print $2}' | sort -u | egrep -v "Sample|FileTag|test"
फ़िलहाल, इस एक्सप्रेशन से ये टैग मिलते हैं:
- BurstBuilder
- कॉलबैक
- CompilationBuilder
- CpuExecutor
- ExecutionBuilder
- ExecutionBurstController
- ExecutionBurstServer
- ExecutionPlan
- FibonacciDriver
- GraphDump
- IndexedShapeWrapper
- IonWatcher
- मैनेजर
- मेमोरी
- MemoryUtils
- MetaModel
- ModelArgumentInfo
- ModelBuilder
- NeuralNetworks
- OperationResolver
- कार्रवाइयां
- OperationsUtils
- PackageInfo
- TokenHasher
- TypeManager
- Utils
- ValidateHal
- VersionedInterfaces
logcat से दिखाए जाने वाले लॉग मैसेज के लेवल को कंट्रोल करने के लिए, एनवायरमेंट वैरिएबल ANDROID_LOG_TAGS का इस्तेमाल करें.
NNAPI के लॉग मैसेज का पूरा सेट दिखाने और अन्य मैसेज को बंद करने के लिए, ANDROID_LOG_TAGS को इस पर सेट करें:
BurstBuilder:V Callbacks:V CompilationBuilder:V CpuExecutor:V ExecutionBuilder:V ExecutionBurstController:V ExecutionBurstServer:V ExecutionPlan:V FibonacciDriver:V GraphDump:V IndexedShapeWrapper:V IonWatcher:V Manager:V MemoryUtils:V Memory:V MetaModel:V ModelArgumentInfo:V ModelBuilder:V NeuralNetworks:V OperationResolver:V OperationsUtils:V Operations:V PackageInfo:V TokenHasher:V TypeManager:V Utils:V ValidateHal:V VersionedInterfaces:V *:S.
इस निर्देश का इस्तेमाल करके, ANDROID_LOG_TAGS को सेट किया जा सकता है:
export ANDROID_LOG_TAGS=$(grep -R 'define LOG_TAG' | awk -F '"' '{ print $2 ":V" }' | sort -u | egrep -v "Sample|FileTag|test" | xargs echo -n; echo ' *:S')
ध्यान दें कि यह सिर्फ़ एक फ़िल्टर है, जो logcat पर लागू होता है. ज़्यादा जानकारी वाले लॉग जनरेट करने के लिए, आपको अब भी प्रॉपर्टी debug.nn.vlog को all पर सेट करना होगा.