Android Bench 2.0: Đẩy mạnh ranh giới bằng các nhiệm vụ có phạm vi kéo dài đầy thách thức
Đọc trong 3 phút
Khi ra mắt Android Bench lần đầu, chúng tôi đã xây dựng một nền tảng nghiêm ngặt để đánh giá cách các mô hình ngôn ngữ lớn (LLM) hỗ trợ nhà phát triển thực hiện các nhiệm vụ thực tế trên Android. Khi các mô hình AI và tác nhân AI phát triển nhanh chóng, chúng tôi đã cập nhật phương pháp của mình, chẳng hạn như điều chỉnh khung điểm chuẩn cho phù hợp với khung Harbor. Hôm nay, chúng tôi sẽ phát hành nhóm tác vụ có phạm vi kéo dài (LHT) đầu tiên. Đây là những tác vụ có độ phức tạp cao, khiến một kỹ sư phải mất nhiều ngày hoặc thậm chí một tuần để hoàn thành. Chúng tôi cũng sẽ ra mắt tính năng đánh giá dựa trên tác nhân, bắt đầu từ các tác nhân của những nhà cung cấp mô hình tương ứng. Sự bổ sung này mang đến cho chúng ta Android Bench 2.0 – một bản nâng cấp lớn được thiết kế để đánh giá các mô hình và tác nhân AI dựa trên quy mô, sự mơ hồ và khả năng giải quyết vấn đề phức tạp gồm nhiều bước mà bạn phải giải quyết hằng ngày.
Từ các bản sửa lỗi gia tăng đến các nhiệm vụ có phạm vi kéo dài
Phiên bản đầu tiên của Android Bench, cùng với các điểm chuẩn lập trình AI ban đầu tương tự, tập trung vào những thay đổi gia tăng đối với các kho lưu trữ hiện có, trong nhiều trường hợp chỉ giới hạn ở các bản sửa lỗi hoặc yêu cầu về tính năng nhỏ hơn. Điều này phản ánh khả năng của trợ lý AI vào thời điểm đó, cũng như cách bạn sử dụng trợ lý này.
Để tiếp tục giúp bạn tìm được các mô hình và tác nhân lập trình phù hợp nhất với quy trình phát triển của mình, chúng tôi đã nâng cao tiêu chuẩn đánh giá để phù hợp với công việc bạn giao cho AI. Android Bench 2.0 phản ánh những thách thức đầy tham vọng này bằng các LHT bao gồm việc nâng cấp phần phụ thuộc, thêm tính năng mới, xây dựng ứng dụng từ đầu hoặc chuyển đổi ứng dụng đa nền tảng sang Android.
Các nhiệm vụ phức tạp đòi hỏi phải có quy trình đánh giá và chấm điểm chi tiết hơn
Đối với các nhiệm vụ kỹ thuật kéo dài nhiều ngày, việc chấm điểm đạt hoặc không đạt không phản ánh được toàn bộ bức tranh.
Ví dụ: một tác nhân có thể cải tiến 40 màn hình thành Jetpack Compose, thiết lập bảng cơ sở dữ liệu và đáp ứng 90% yêu cầu, nhưng không đáp ứng được một câu nhận định về trường hợp hiếm gặp. Hệ thống chấm điểm nhị phân đánh giá lần chạy này là 0%, che khuất khả năng kiến trúc của mô hình. Chúng tôi đang chuyển sang phương pháp chấm điểm liên tục để cung cấp tín hiệu có ý nghĩa hơn, cả cho việc phát triển mô hình và giúp bạn hiểu cách AI có thể hỗ trợ bạn.
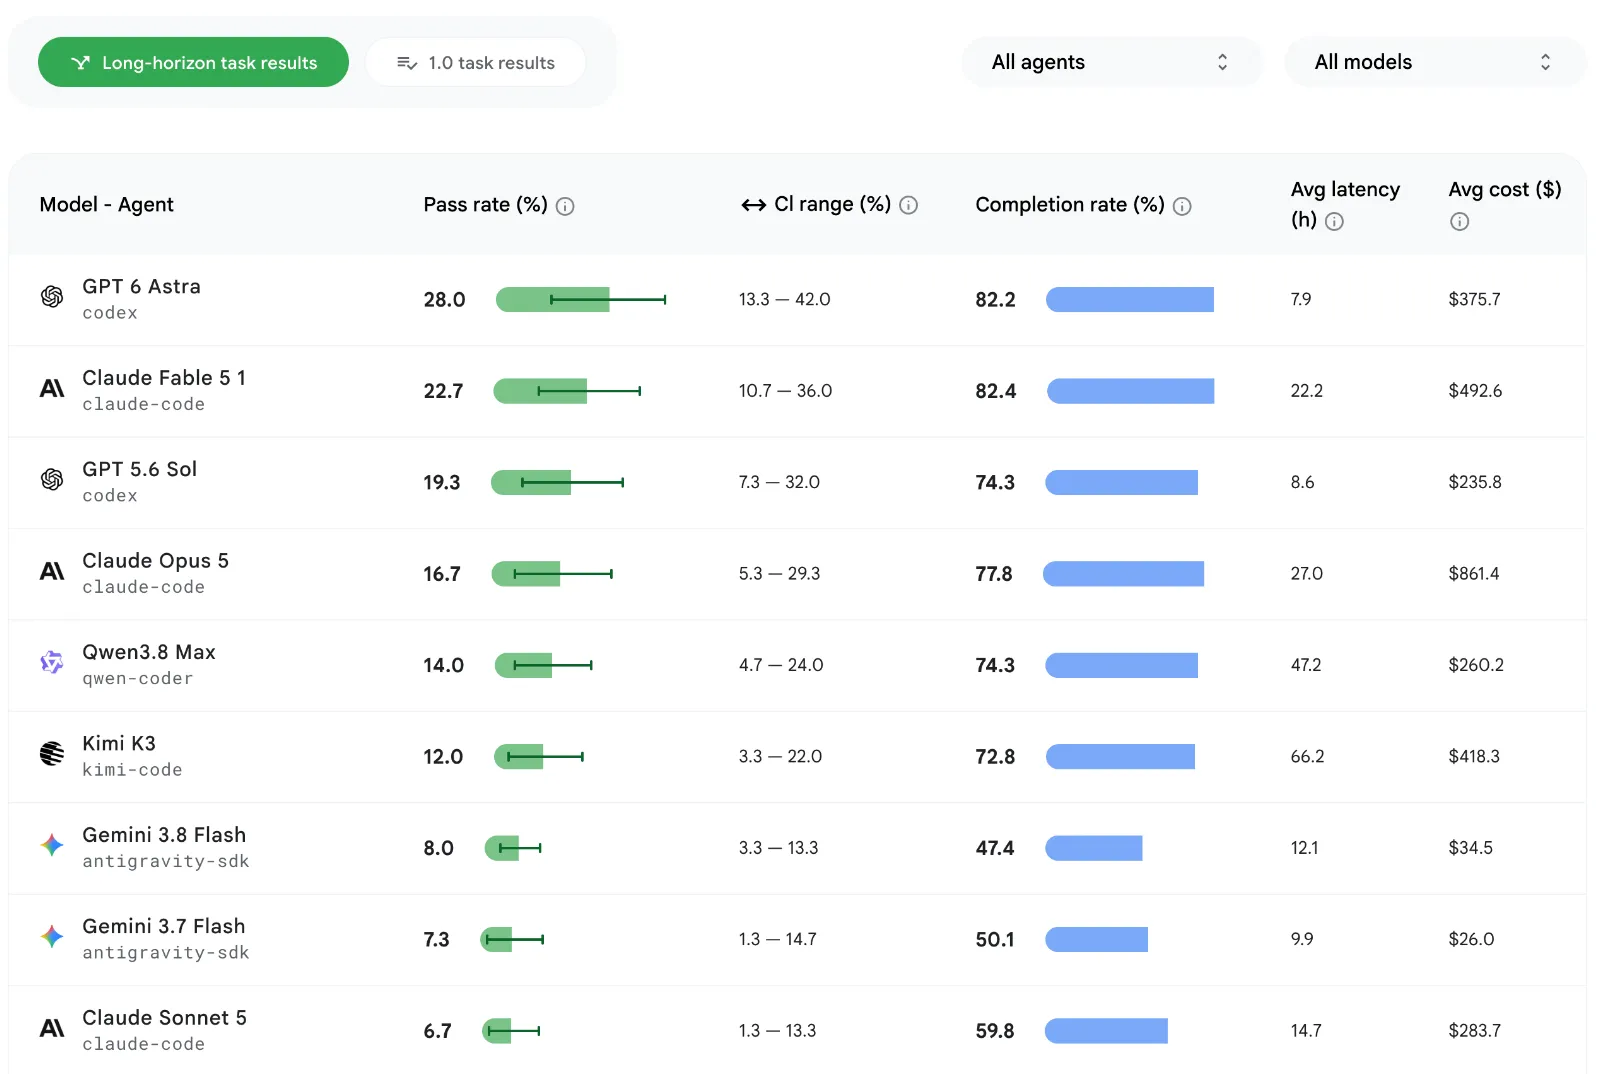
Chúng tôi tính toán tỷ lệ hoàn thành này thông qua việc kết hợp nhiều yếu tố như chức năng, độ trung thực về hình ảnh và việc tránh hồi quy. Chúng tôi cũng áp dụng hình phạt trừ điểm khách quan đối với những trường hợp không tuân thủ hướng dẫn đánh giá hoặc các quy định ràng buộc về cấu trúc. Hãy xem bảng xếp hạng mới nhất và nhấp vào chế độ xem thẻ của từng mô hình để xem các thông tin khác như tỷ lệ vượt qua, tỷ lệ hoàn thành và chi phí trung bình cho mỗi mô hình và mỗi nhiệm vụ.
Tỷ lệ vượt qua cao nhất đối với LHT là khoảng 28%, thấp hơn nhiều so với tỷ lệ ~91% đối với các nhiệm vụ ban đầu trong điểm chuẩn.
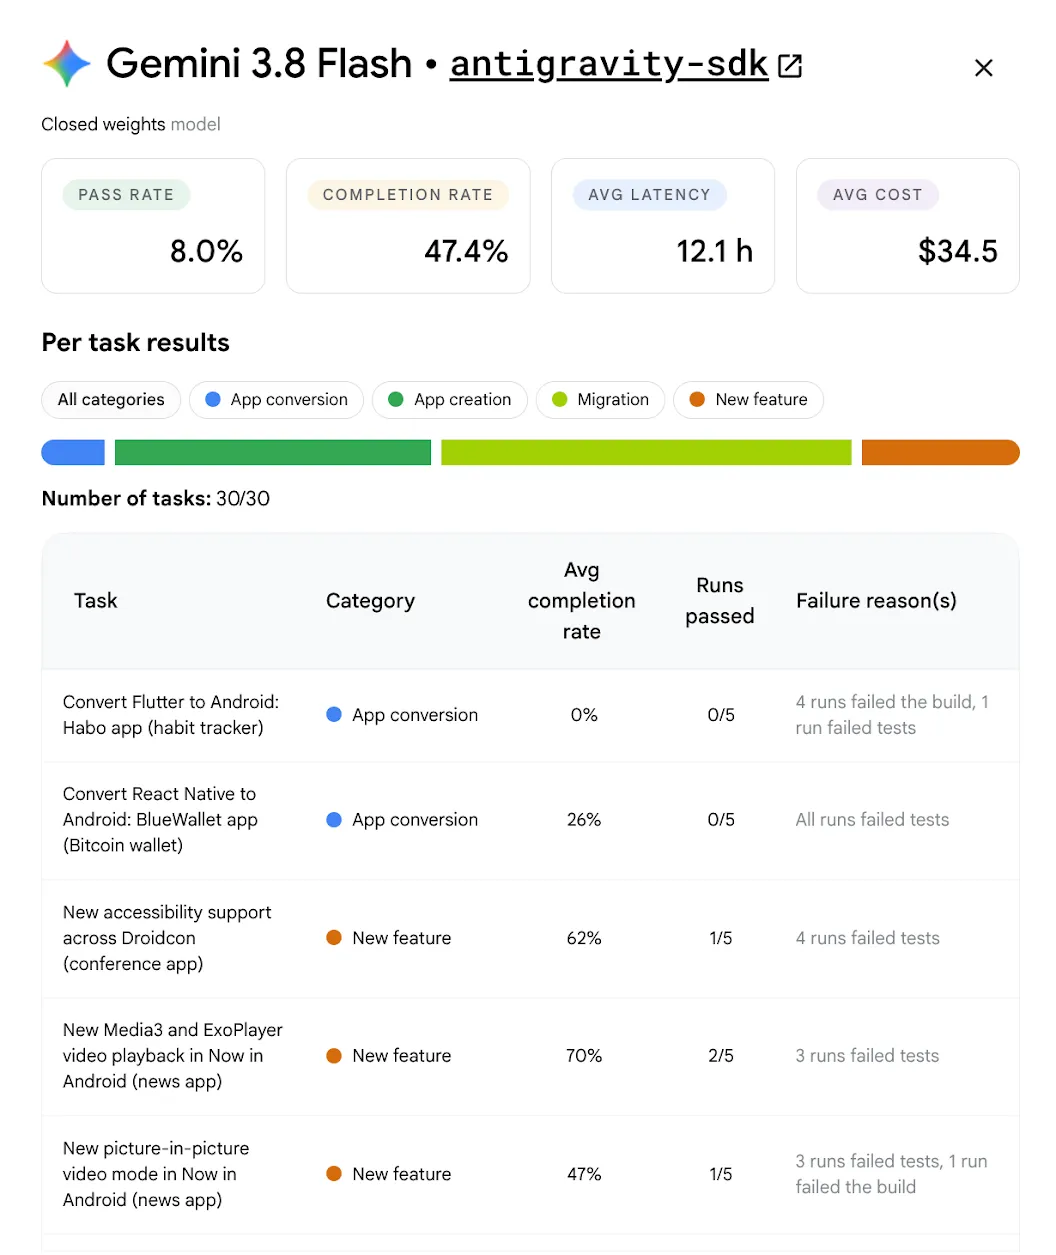
Các nhiệm vụ có phạm vi kéo dài giúp khám phá thông tin chi tiết hữu ích cho trợ lý AI
Ngoài việc đo lường mức độ hiệu quả của AI khi xử lý các nhiệm vụ dài hạn, tập dữ liệu LHT còn giúp chúng tôi tìm hiểu thêm về điểm mạnh và điểm yếu của các mô hình được thử nghiệm, đồng thời cung cấp cho bạn hướng dẫn thực tế hơn.
Trên các cấp mô hình, AI viết mã mới tốt hơn là tái cấu trúc mã hiện có. Việc tái cấu trúc và di chuyển trở nên phức tạp hơn vì thành công phụ thuộc vào độ phức tạp của cấu trúc chứ không phải khối lượng mã.
Các mô hình cho thấy khả năng mạnh mẽ trong các phép biến đổi tất định, đã được thiết lập rõ ràng, chẳng hạn như chuyển đổi Java sang Kotlin, hoán đổi Retrofit cho Ktor hoặc giới thiệu một lớp ViewModel. Họ áp dụng các mẫu này một cách nhất quán, ngay cả trên hơn 125 tệp và hơn 8.000 dòng mã.
Tuy nhiên, các mô hình gặp khó khăn khi nhiệm vụ yêu cầu xác thực trong thời gian chạy (chẳng hạn như thiếu biểu đồ chèn phần phụ thuộc), liên quan đến các thay đổi có thể gây lỗi cho khung hoặc gặp phải lỗ hổng kiến thức về các thư viện chưa phát hành. Việc chuyển ứng dụng nhiều nền tảng sang Android vẫn là một thách thức chưa có lời giải – không có mô hình nào đạt tỷ lệ vượt qua 100% và các mô hình tiên phong chỉ đạt tỷ lệ hoàn thành tối đa 80%.
Giới thiệu về tính năng đánh giá tác nhân
Để giúp bạn hiểu rõ hơn về hiệu suất của các mô hình khi được tích hợp vào quy trình làm việc của tác nhân, chúng tôi sẽ thêm các tác nhân thường dùng vào quy trình đánh giá. Chúng tôi sẽ bắt đầu bằng việc chạy các mô hình mới dựa trên LHT với các tác nhân của nhà cung cấp mô hình tương ứng. Ví dụ: chúng tôi đã chạy GPT 5.6 Sol trên Codex và Gemini 3.8 Flash trên Google Antigravity. Sự kết hợp này cho thấy cách thiết kế bộ khung tác động tích cực đến kết quả của nhà phát triển, vì chúng tôi nhận thấy việc lưu vào bộ nhớ đệm câu lệnh và cửa sổ công cụ thu gọn có thể giúp giảm số lượng mã thông báo.
Trong tương lai, chúng tôi sẽ mở rộng tính năng này bằng cách làm nổi bật kết quả trên nhiều kiểu kết hợp mô hình và nhân viên hỗ trợ, giúp bạn khám phá những kiểu kết hợp phù hợp nhất với bạn và nhóm của bạn.
Chúng tôi đầu tư vào hoạt động đo lường này vì việc bạn có thể sử dụng tác nhân và mô hình mà bạn chọn để phát triển Android là rất quan trọng. Chúng tôi sẽ chia sẻ thêm thông tin với bạn trong những tuần tới.
Đã thêm mô hình mới
Ngoài ra, chúng tôi sẽ tiếp tục mở rộng bảng xếp hạng để đảm bảo bạn có dữ liệu mới nhất cho các quyết định phát triển của mình. Chúng tôi đã thêm Gemini 3.8 Flash, Gemini 3.7 Flash, GPT-6 của OpenAI, Fable 5.1 của Anthropic, Kimi K3 và Qwen 3.8 Max, trong đó GPT-6 Astra của OpenAI đứng đầu với tỷ lệ vượt qua là 28%.
Trong tương lai
Android Bench 2.0 mang đến một môi trường mạnh mẽ để đo lường AI cho hoạt động phát triển Android. Bằng cách kết hợp các nhiệm vụ có phạm vi kéo dài, đánh giá đa phương thức, tác nhân và chấm điểm liên tục, chúng tôi hy vọng sẽ hỗ trợ các nhóm nghiên cứu AI xây dựng những cộng sự lập trình AI có năng lực và đáng tin cậy hơn, đồng thời cung cấp cho bạn thông tin minh bạch hơn về các lựa chọn phát triển AI.
Hãy xem bảng xếp hạng mới cập nhật cùng với phương pháp mới cập nhật. Ý kiến phản hồi của bạn ảnh hưởng trực tiếp đến cách chúng tôi phát triển Android Bench. Vì vậy, hãy tiếp tục chia sẻ ý kiến phản hồi của bạn với chúng tôi trên GitHub, cũng như các kênh mạng xã hội của chúng tôi như X và LinkedIn.
-
 Tin tức về sản phẩm
Hôm nay, tại Hội nghị Nhà phát triển Android, chúng tôi xin thông báo về việc cung cấp rộng rãi nhiều công cụ và API được thiết kế để loại bỏ những trở ngại hằng ngày và giúp bạn linh hoạt hơn trong việc xây dựng các ứng dụng Android tuyệt vời.
Matthew McCullough • Thời gian đọc: 4 phút -
 Tin tức về sản phẩm
Khi quá trình phát triển tác nhân AI tăng tốc, kỹ thuật Android đang đạt đến một ranh giới mới đầy thú vị: chuyển từ tính năng hoàn thành mã hỗ trợ sang các tác nhân thực thi từ đầu đến cuối dưới sự chỉ đạo của bạn. Bạn có toàn quyền lựa chọn và linh hoạt trong việc sử dụng các mô hình và tác nhân.
Jason Buchel • Đọc trong 3 phút -
 Tin tức về sản phẩm
Là nhà phát triển Android, bạn có nhiều lựa chọn về tác nhân, LLM, công cụ và giao diện dòng lệnh (CLI) mà bạn sử dụng để phát triển ứng dụng. Mục tiêu của chúng tôi là giúp bạn xây dựng các ứng dụng Android đẹp mắt, chất lượng cao, bất kể bạn chọn cách xây dựng nào.
Simona Milanovic • Thời gian đọc: 4 phút
Nhận thông tin chi tiết mới nhất về hoạt động phát triển Android trong hộp thư đến của bạn hằng tuần.