

WorkManager ti consente di creare e mettere in coda una catena di lavoro che specifica più attività dipendenti e definisce l'ordine in cui devono essere eseguite. Questa funzionalità è particolarmente utile quando devi eseguire diverse attività in un ordine specifico.
Per creare una catena di lavoro, puoi utilizzare
WorkManager.beginWith(OneTimeWorkRequest)
o
WorkManager.beginWith(List<OneTimeWorkRequest>)
, che restituiscono ciascuno un'istanza di
WorkContinuation.
Un WorkContinuation può quindi essere utilizzato per aggiungere istanze OneTimeWorkRequest dipendenti utilizzando then(OneTimeWorkRequest) o then(List<OneTimeWorkRequest>).
Ogni chiamata di WorkContinuation.then(...) restituisce una nuova istanza di WorkContinuation. Se aggiungi un List di OneTimeWorkRequest istanze, queste richieste possono essere eseguite in parallelo.
Infine, puoi utilizzare il metodo WorkContinuation.enqueue() per enqueue() la catena di WorkContinuation.
Vediamo un esempio. In questo esempio, sono configurati tre diversi job worker da eseguire (potenzialmente in parallelo). I risultati di questi worker vengono poi uniti e passati a un job worker di memorizzazione nella cache. Infine, l'output di questo job viene passato a un worker di caricamento, che carica i risultati su un server remoto.
Kotlin
WorkManager.getInstance(myContext)
   // Candidates to run in parallel
   .beginWith(listOf(plantName1, plantName2, plantName3))
   // Dependent work (only runs after all previous work in chain)
   .then(cache)
   .then(upload)
   // Call enqueue to kick things off
   .enqueue()
Java
WorkManager.getInstance(myContext)
   // Candidates to run in parallel
   .beginWith(Arrays.asList(plantName1, plantName2, plantName3))
   // Dependent work (only runs after all previous work in chain)
   .then(cache)
   .then(upload)
   // Call enqueue to kick things off
   .enqueue();
Input Mergers
Quando concateni le istanze OneTimeWorkRequest, l'output delle richieste di lavoro principali viene passato come input alle richieste secondarie. Nell'esempio precedente, gli output di plantName1, plantName2 e plantName3 verrebbero passati come input alla richiesta cache.
Per gestire gli input di più richieste di lavoro principali, WorkManager utilizza
InputMerger.
Esistono due diversi tipi di InputMerger forniti da WorkManager:
OverwritingInputMergertenta di aggiungere all'output tutte le chiavi di tutti gli input. In caso di conflitti, sovrascrive le chiavi impostate in precedenza.ArrayCreatingInputMergertenta di unire gli input, creando array quando necessario.
Se hai un caso d'uso più specifico, puoi scrivere il tuo creando una sottoclasse di InputMerger.
OverwritingInputMerger
OverwritingInputMerger è il metodo di unione predefinito. Se si verificano conflitti di chiavi nell'unione, il valore più recente di una chiave sovrascriverà le versioni precedenti nei dati di output risultanti.
Ad esempio, se gli input della pianta hanno ciascuno una chiave corrispondente ai rispettivi nomi delle variabili ("plantName1", "plantName2" e "plantName3"), i dati passati al worker cache avranno tre coppie chiave-valore.
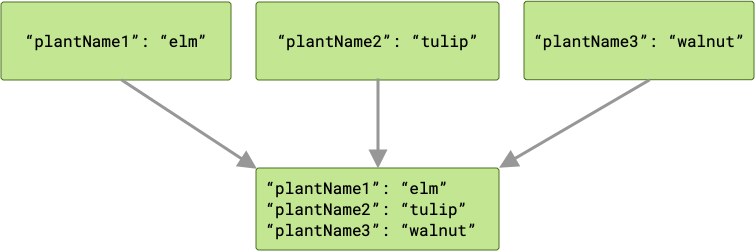
In caso di conflitto, il worker che completa l'operazione per ultimo "vince" e il suo valore viene passato a cache.
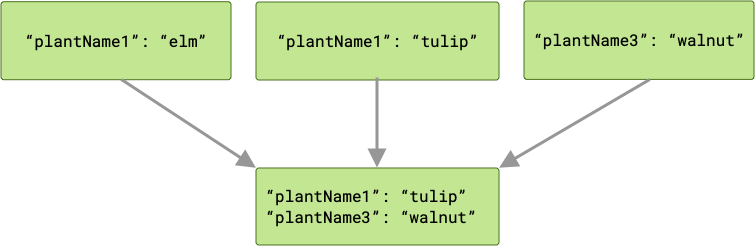
Poiché le richieste di lavoro vengono eseguite in parallelo, non hai garanzie sull'ordine in cui vengono eseguite. Nell'esempio precedente, plantName1 potrebbe contenere un valore pari a "tulip" o "elm", a seconda di quale valore è stato scritto per ultimo. Se esiste la possibilità di un conflitto di chiavi e devi conservare tutti i dati di output in un'unione, ArrayCreatingInputMerger potrebbe essere un'opzione migliore.
ArrayCreatingInputMerger
Per l'esempio precedente, dato che vogliamo conservare gli output di tutti i worker con nome di pianta, dobbiamo utilizzare un ArrayCreatingInputMerger.
Kotlin
val cache: OneTimeWorkRequest = OneTimeWorkRequestBuilder<PlantWorker>()
   .setInputMerger(ArrayCreatingInputMerger::class)
   .setConstraints(constraints)
   .build()
Java
OneTimeWorkRequest cache = new OneTimeWorkRequest.Builder(PlantWorker.class)
       .setInputMerger(ArrayCreatingInputMerger.class)
       .setConstraints(constraints)
       .build();
ArrayCreatingInputMerger associa ogni chiave a un array. Se ogni chiave è univoca, il risultato è una serie di array con un solo elemento.
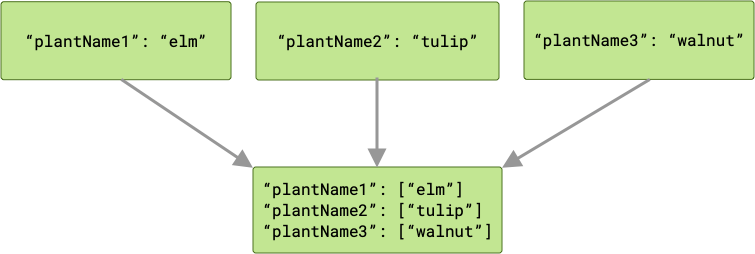
In caso di collisioni di chiavi, i valori corrispondenti vengono raggruppati in un array.
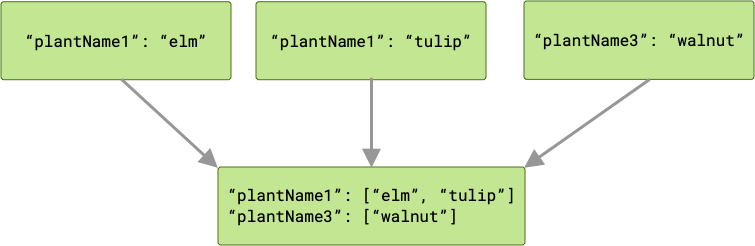
Concatenamento e stati di lavoro
Le catene di OneTimeWorkRequest vengono eseguite in sequenza, a condizione che il loro lavoro venga completato correttamente (ovvero che restituiscano un Result.success()). Le richieste di lavoro potrebbero non riuscire o essere annullate durante l'esecuzione, con effetti a valle sulle richieste di lavoro dipendenti.
Quando il primo OneTimeWorkRequest viene inserito in coda in una catena di richieste di lavoro, tutte le richieste di lavoro successive vengono bloccate fino al completamento del lavoro della prima richiesta di lavoro.
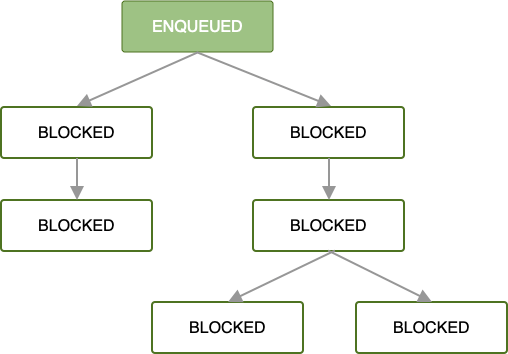
Una volta inserita in coda e soddisfatti tutti i vincoli di lavoro, la prima richiesta di lavoro inizia l'esecuzione. Se il lavoro viene completato correttamente nella directory principale OneTimeWorkRequest o List<OneTimeWorkRequest> (ovvero restituisce un Result.success()), verrà inserito in coda il successivo insieme di richieste di lavoro dipendenti.
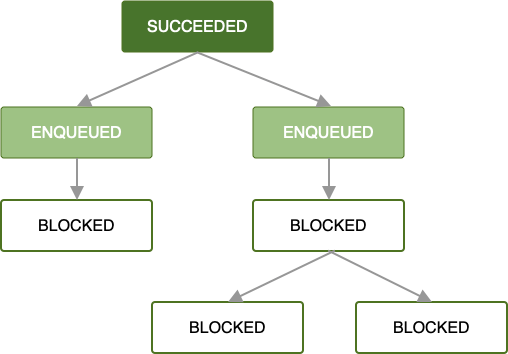
Se ogni richiesta di lavoro viene completata correttamente, questo stesso pattern si propaga nel resto della catena di richieste di lavoro fino a quando non viene completato tutto il lavoro nella catena. Sebbene questo sia il caso più semplice e spesso preferito, gli stati di errore sono altrettanto importanti da gestire.
Quando si verifica un errore mentre un worker sta elaborando la tua richiesta di lavoro, puoi riprovare a eseguire la richiesta in base a una policy di backoff definita da te. Se riprovi una richiesta che fa parte di una catena, verrà ripetuta solo quella richiesta con i dati di input forniti. Le attività in esecuzione in parallelo non saranno interessate.
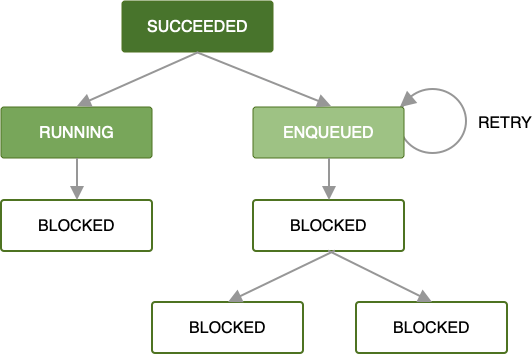
Per saperne di più sulla definizione di strategie di ripetizione personalizzate, consulta Criterio di ripetizione e backoff.
Se la policy di ripetizione non è definita o è esaurita, o se raggiungi uno stato in cui un OneTimeWorkRequest restituisce Result.failure(), la richiesta di lavoro e tutte le richieste di lavoro dipendenti vengono contrassegnate come FAILED.
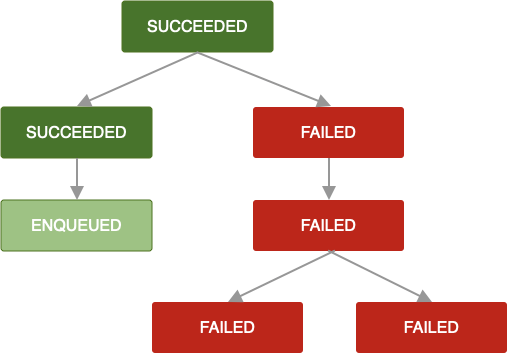
La stessa logica si applica quando un OneTimeWorkRequest viene annullato. Anche le richieste di lavoro dipendenti vengono contrassegnate come CANCELLED e il relativo lavoro non verrà eseguito.
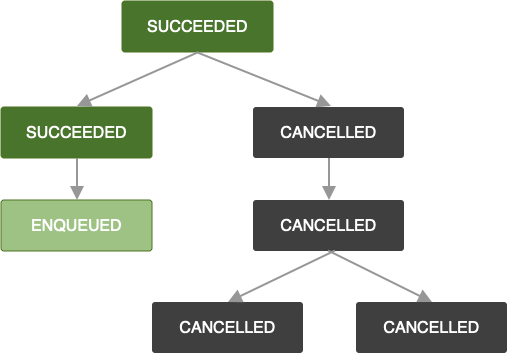
Tieni presente che se aggiungi altre richieste di lavoro a una catena che ha richieste di lavoro non riuscite o annullate, anche la richiesta di lavoro appena aggiunta verrà contrassegnata rispettivamente come FAILED o CANCELLED. Se vuoi estendere il lavoro di una catena esistente, consulta APPEND_OR_REPLACE in ExistingWorkPolicy.
Quando crei catene di richieste di lavoro, le richieste di lavoro dipendenti devono definire policy di ripetizione per garantire che il lavoro venga sempre completato in modo tempestivo. Le richieste di lavoro non riuscite potrebbero comportare catene incomplete e/o uno stato imprevisto.
Per saperne di più, consulta Annullamento e interruzione del lavoro.