Ewolucja sposobu pomiaru modeli LLM na Androidzie: nowa era Android Bench
Czas czytania: 3 min

W marcu wprowadziliśmy Android Bench – naszą tabelę wyników modeli LLM w rzeczywistych zadaniach związanych z programowaniem na Androida. Naszym celem było zapewnienie przejrzystości w zakresie możliwości modeli w programowaniu na Androida oraz zachęcenie do ich ulepszania, aby zapewnić Ci bardziej przydatne opcje AI w codziennej pracy. Od tego czasu ulepszyliśmy ten test porównawczy na podstawie Waszych opinii, m.in. oceniliśmy modele o otwartej architekturze i dodaliśmy do tabeli wyników wymiary kosztów i wydajności.
Możliwości AI stale się rozwijają, więc pomiary muszą za nimi nadążać. W ramach lipcowej wersji wprowadziliśmy platformę Harbor, która zawiera zaktualizowaną wersję agenta testowego używanego do oceny modeli.
W tej lipcowej wersji oprócz zmiany sposobu oceny dodajemy do tabeli wyników 8 nowych modeli: Claude Fable 5, Claude Sonnet 5, Claude Opus 4.8, GLM 5.2, Kimi K2.7 Code, MiniMax M3, Qwen 3.7 Plus i Qwen 3.7 Max. Udostępniamy też możliwości, dzięki którym społeczność deweloperów Androida może przyczynić się do rozwoju tego benchmarku.
Ulepszanie naszej metodologii za pomocą platformy Harbor
Projektując Android Bench, oparliśmy naszą metodologię na wiodących standardach branżowych dostępnych w tym czasie. Użyliśmy ogólnego agenta do testów porównawczych mini-swe-agent w wersji 1 i dostosowaliśmy go do niuansów programowania na Androida, aby uzyskać pomiar bazowy możliwości modeli w przypadku typowych zadań związanych z programowaniem na Androida.
Aby nadal dostarczać Ci najnowocześniejsze oceny, które dokładnie mierzą możliwości najnowszych modeli w zakresie programowania aplikacji na Androida, ujednolicamy nasz test porównawczy, dostosowując go do platformy Harbor. Harbor określa standardy i integracje, które ułatwiają przeprowadzenie testu porównawczego, ocenę preferowanej konfiguracji i udostępnianie wyników, co zapewnia większą przejrzystość i widoczność.
Ta aktualizacja umożliwia nam dokładniejszą ocenę modeli i ich możliwości. Ponownie przeprowadziliśmy test porównawczy na wszystkich modelach, aby ustalić zaktualizowaną wartość bazową. Oznacza to niewielką zmianę w punktacji, ale nadal będziesz mieć możliwość wyświetlania historycznych wyników w archiwum na naszej stronie.
Chcemy, aby Android Bench był dla Ciebie przydatny, dlatego będziemy go stale aktualizować w miarę rozwoju naszych ocen i branży.
Rozszerzenie tabeli wyników o 8 nowych modeli
W ramach naszego zobowiązania do aktualizowania tabeli wyników dodaliśmy do tabeli wyników Android Bench modele Claude Fable 5, Claude Sonnet 5, Claude Opus 4.8, GLM 5.2, Kimi K2.7 Code, MiniMax M3, Qwen 3.7 Plus i Qwen 3.7 Max.
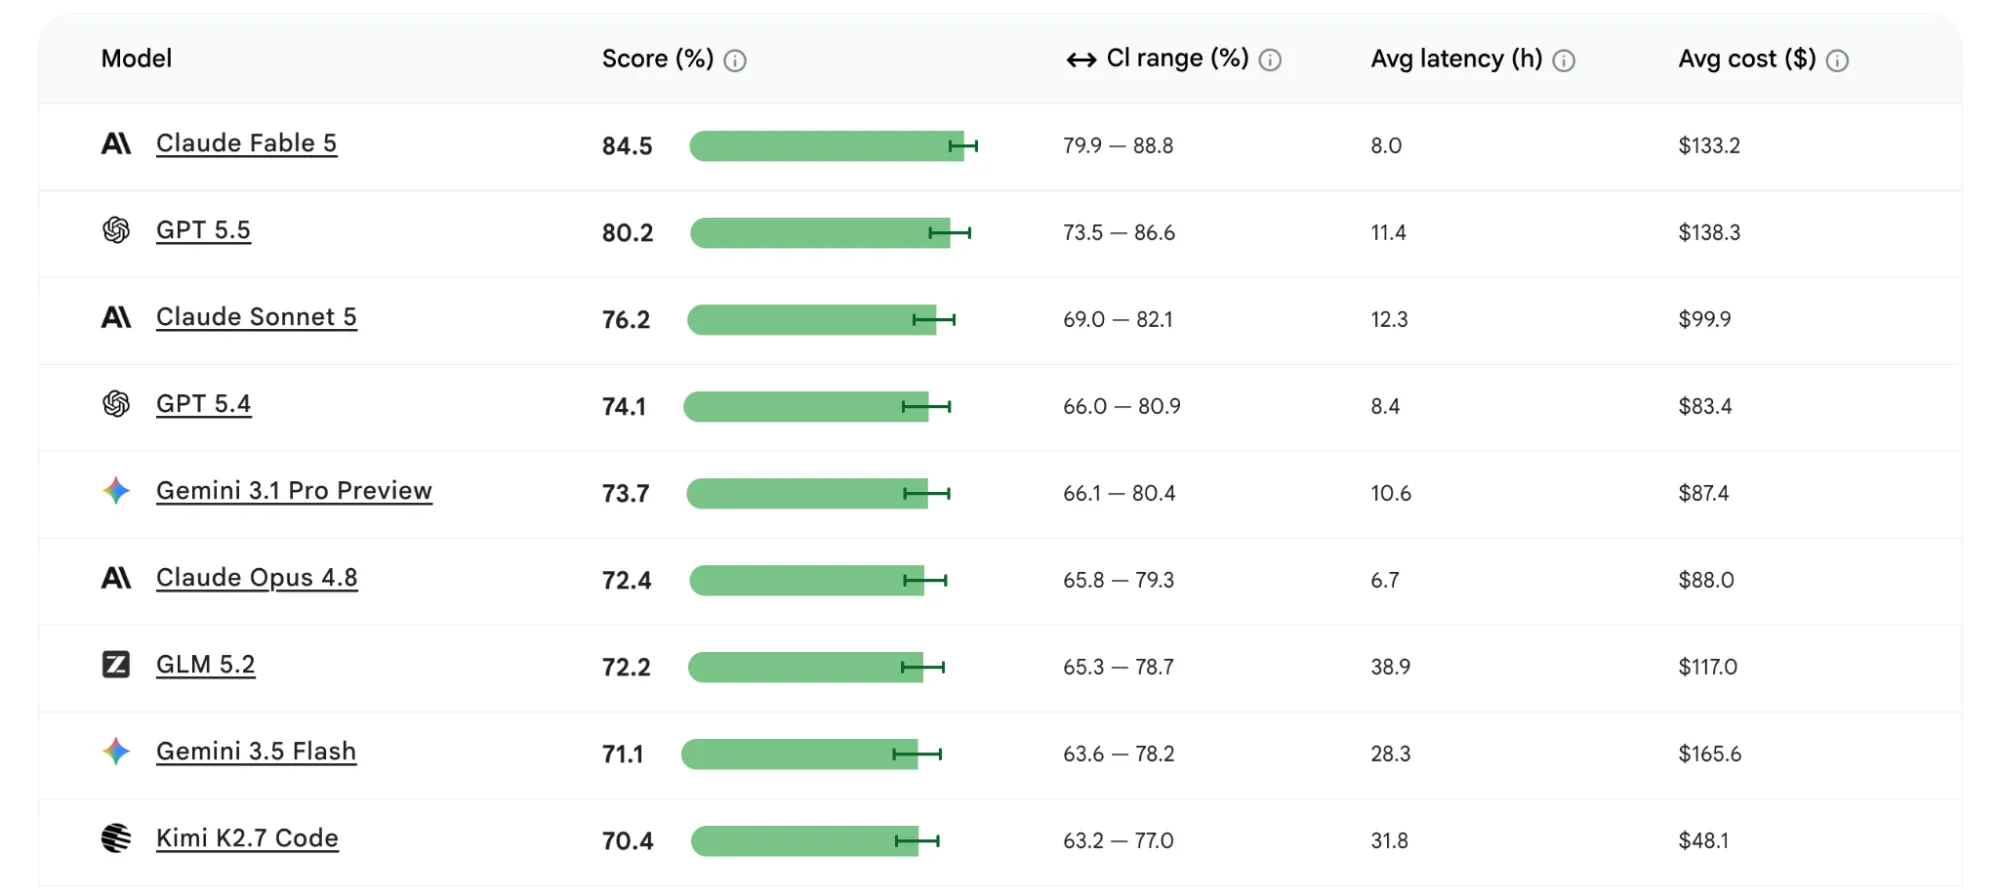
Na szczycie tabeli wyników znajduje się Claude Fable 5 z wynikiem 84,5, a za nim GPT 5.5 z wynikiem 80,2. Na 3 miejscu jest Claude Sonnet 5 z wynikiem 76,2.
W przypadku porównania tylko modeli o otwartej architekturze na pierwszym miejscu znajduje się GLM 5.2 z wynikiem 72,2, a za nim Kimi K2.7 Code z wynikiem 70,4.
Na zaktualizowanej tablicy wyników możesz sprawdzić skuteczność i wydajność modeli, aby zobaczyć, jak radzą sobie z wyzwaniami związanymi z Androidem, takimi jak migracje Jetpack Compose, sieci na urządzeniach do noszenia i aktualizacje interfejsu API platformy.
Otwarcie Android Bench na współtworzenie przez społeczność
Od początku cenimy otwarte i przejrzyste podejście, dlatego udostępniliśmy naszą pierwotną metodologię i platformę testową publicznie w GitHubie. Poprosiliście nas o możliwość przesyłania opinii o naszym zbiorze danych, dlatego rozszerzamy współpracę i dajemy społeczności programistów na Androida szansę na kształtowanie Android Bench.
Od dziś możesz wspierać projekt Android Bench na 2 sposoby:
- Projektuj i przesyłaj własne zadania związane z tworzeniem aplikacji na Androida, aby ocenić, jak modele radzą sobie w scenariuszach, które są dla Ciebie ważne.
- Przeprowadzaj i udostępniaj oceny porównawcze, testując wybrane modele na naszym zbiorze danych lub własnych zadaniach niestandardowych.
Sprawdzimy przesłane zadania i ocenimy, czy zostaną dodane do testu porównawczego. Chcemy stworzyć punkt odniesienia, który będzie odzwierciedlać różnorodne, codzienne realia globalnej społeczności deweloperów Androida.
Co dalej
Wraz z rosnącą liczbą opcji rozwoju agentów utrzymywanie najnowocześniejszego punktu odniesienia zapewnia, że pomoc AI, na której polegasz, staje się coraz inteligentniejsza, bardziej przydatna i skuteczniejsza. Aby zapoznać się z zadaniami, przejdź do naszego repozytorium GitHub. Zachęcamy do przesłania zadania do sprawdzenia przez nasz zespół. Możesz też zapoznać się z Harbor Hub, aby przejrzeć zbiór danych lub przesłać oceny.
Jak zawsze, zaktualizowaną tablicę wyników znajdziesz na naszej stronie. Możesz też zapoznać się z metodologią.
-

 Wiadomości o usługach
Jako programiści aplikacji na Androida macie wiele możliwości wyboru agentów, modeli LLM, narzędzi i interfejsów wiersza poleceń (CLI), których używacie do tworzenia aplikacji. Naszym celem jest pomaganie Ci w tworzeniu atrakcyjnych aplikacji na Androida o wysokiej jakości, niezależnie od tego, jak je tworzysz.
Simona Milanovic • Czas czytania: 4 min -
 Wiadomości o usługach
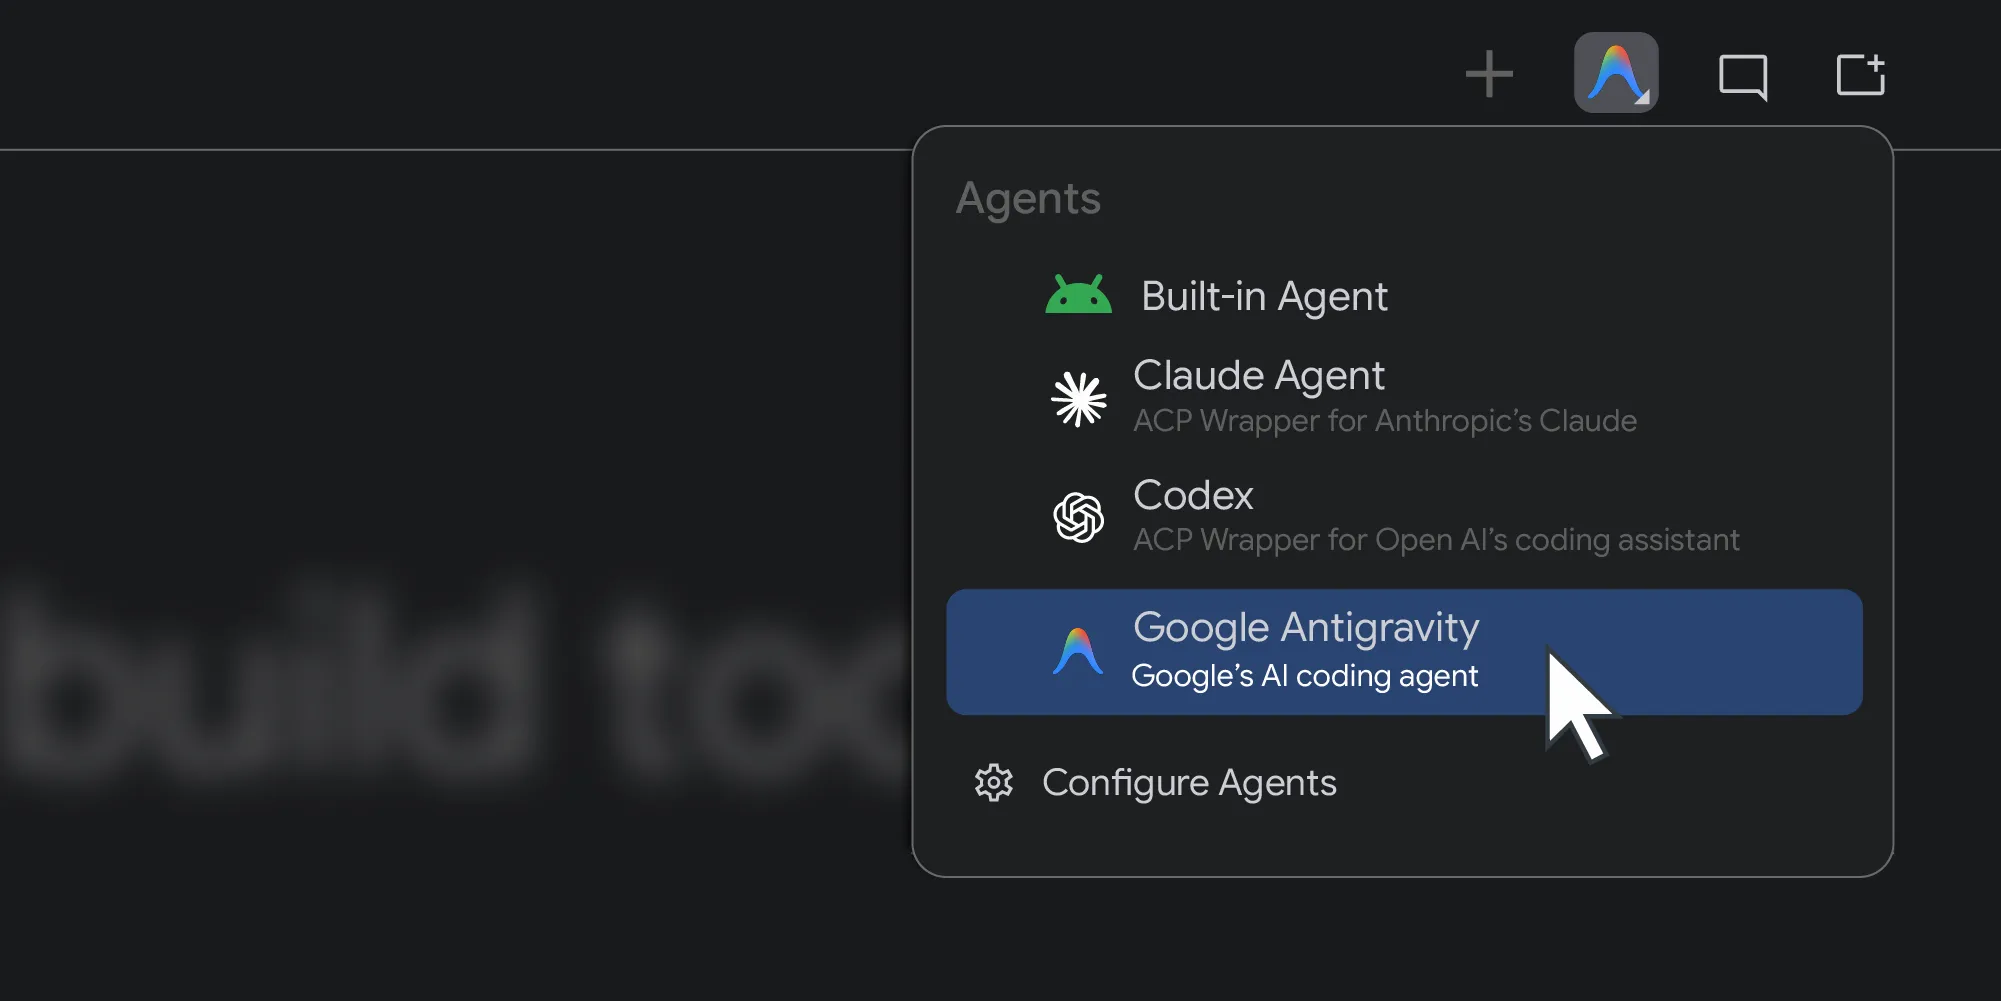
W ubiegłym roku Android Studio zostało otwarte na dowolny model AI. Dziś robimy kolejny krok i wprowadzamy obsługę wybranych przez Ciebie agentów kodujących.
Matthew Warner • Czas czytania: 3 minuty -
 Wiadomości o usługach
Dziś udostępniamy pierwszy zestaw zadań długoterminowych (LHT), czyli bardzo złożonych zadań, których wykonanie zajmuje inżynierowi kilka dni, a nawet tydzień. Wprowadzamy też ocenę agentów, zaczynając od agentów od odpowiednich dostawców modeli.
Matthew McCullough • Czas czytania: 3 minuty
Otrzymuj co tydzień najnowsze informacje o tworzeniu aplikacji na Androida na swoją skrzynkę odbiorczą.