הצוות של סביבת זמן ריצה ל-Android (ART) צמצם את משך הזמן לקימפול ב-18% בלי לפגוע בקוד המקומפל או ברגרסיות של שיא הזיכרון. השיפור הזה היה חלק מהיוזמה שלנו לשנת 2025 לשפר את משך הזמן לקימפול בלי לפגוע בשימוש בזיכרון או באיכות של הקוד המקומפל.
אופטימיזציה של משך הזמן לקימפול חיונית ל-ART. לדוגמה, כשמבצעים הידור JIT, זה משפיע ישירות על היעילות של האפליקציות ועל הביצועים הכוללים של המכשיר. הידורים מהירים יותר מקצרים את הזמן עד שהאופטימיזציות מתחילות לפעול, וכך חוויית המשתמש חלקה ומהירה יותר. בנוסף, גם ב-JIT וגם ב-AOT, שיפורים במהירות של זמן הקימפול מובילים לצריכת משאבים נמוכה יותר במהלך תהליך הקימפול, וזה משפר את חיי הסוללה ואת הטמפרטורה של המכשיר, במיוחד במכשירים פשוטים יותר.
חלק מהשיפורים האלה במהירות הקימפול הושקו בגרסת Android של יוני 2025, והשאר יהיו זמינים בגרסת Android של סוף השנה. בנוסף, כל משתמשי Android בגרסאות 12 ומעלה יכולים לקבל את השיפורים האלה דרך עדכוני Mainline.
אופטימיזציה של המהדר שמבצע אופטימיזציה
אופטימיזציה של קומפיילר היא תמיד משחק של פשרות. אי אפשר לקבל מהירות בחינם, צריך לוותר על משהו. הצבנו לעצמנו מטרה ברורה ומאתגרת: להפוך את המקמפל למהיר יותר, אבל לעשות את זה בלי לגרום לרגרסיות בזיכרון, וחשוב מכך, בלי לפגוע באיכות הקוד שהוא מייצר. אם הקומפיילר מהיר יותר אבל האפליקציות פועלות לאט יותר, נכשלנו.
המשאב היחיד שהיינו מוכנים להשקיע היה זמן הפיתוח שלנו, כדי לחקור לעומק ולמצוא פתרונות חכמים שעומדים בקריטריונים המחמירים האלה. בואו נבחן מקרוב איך אנחנו פועלים כדי למצוא תחומים שצריך לשפר, ואיך אנחנו מוצאים את הפתרונות הנכונים לבעיות השונות.
איך למצוא אופטימיזציות אפשריות שכדאי לבצע
כדי לבצע אופטימיזציה של מדד, צריך קודם למדוד אותו. אחרת, לא תוכלו לדעת אם שיפרתם אותו או לא. למזלנו, משך הזמן לקימפול די עקבי, כל עוד נוקטים כמה אמצעי זהירות, כמו שימוש באותו מכשיר למדידה לפני ואחרי השינוי, ומוודאים שהמכשיר לא מוגבל מבחינה תרמית. בנוסף, יש לנו גם מדידות דטרמיניסטיות כמו נתונים סטטיסטיים של קומפיילר שעוזרים לנו להבין מה קורה מאחורי הקלעים.
המשאב שהיינו צריכים להקריב בשביל השיפורים האלה היה זמן הפיתוח שלנו, אז רצינו שתהיה לנו אפשרות לבצע איטרציות כמה שיותר מהר. זה אומר שבחרנו כמה אפליקציות מייצגות (שילוב של אפליקציות של Google, אפליקציות של צד שלישי ומערכת ההפעלה Android עצמה) כדי ליצור אב טיפוס של פתרונות. לאחר מכן, וידאנו שההטמעה הסופית הייתה מוצלחת באמצעות בדיקות ידניות ואוטומטיות נרחבות.
עם קובצי ה-APK האלה שנבחרו בקפידה, הפעלנו הידור ידני באופן מקומי, קיבלנו פרופיל של ההידור והשתמשנו ב-pprof כדי לראות איפה אנחנו משקיעים את הזמן שלנו.
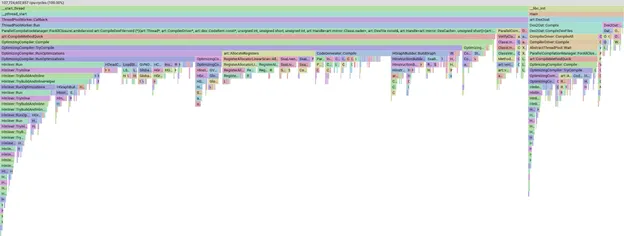
דוגמה לתרשים להבות של פרופיל ב-pprof
הכלי pprof הוא כלי חזק מאוד שמאפשר לנו לחתוך, לסנן ולמיין את הנתונים כדי לראות, למשל, אילו שלבים או שיטות של המהדר לוקחים הכי הרבה זמן. לא נפרט על pprof עצמו, רק נציין שאם העמודה גדולה יותר, זה אומר שההידור נמשך זמן רב יותר.
אחת מהתצוגות האלה היא "מלמטה למעלה", שבה אפשר לראות אילו שיטות לוקחות הכי הרבה זמן. בתמונה הבאה אפשר לראות שיטה שנקראת Kill, שאחראית ליותר מ-1% ממשך הזמן לקימפול. בהמשך הפוסט בבלוג נדון גם בכמה מהשיטות המובילות האחרות.
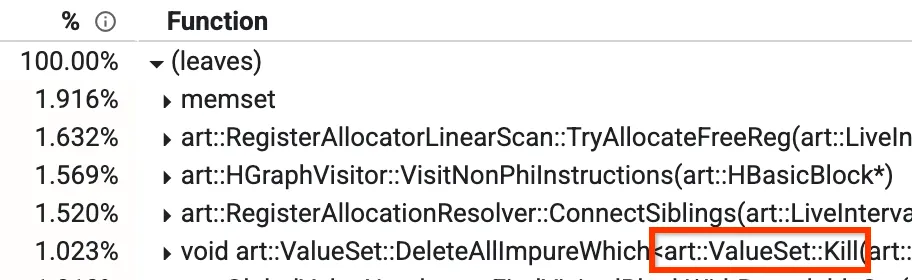
תצוגה מלמטה למעלה של פרופיל
במהדר האופטימיזציה שלנו, יש שלב שנקרא Global Value Numbering (GVN). אתם לא צריכים לדאוג לגבי מה שהיא עושה באופן כללי, אבל החלק הרלוונטי הוא לדעת שיש לה שיטה שנקראת "Kill" שתמחק כמה צמתים בהתאם למסנן. זה לוקח זמן כי צריך לעבור על כל הצמתים ולבדוק אותם אחד אחד. שמנו לב שיש מקרים שבהם אנחנו יודעים מראש שהבדיקה תיכשל, לא משנה אילו צמתים פעילים באותו שלב. במקרים כאלה, אנחנו יכולים לדלג על החזרה לגמרי, להוריד אותה מ-1.023% ל-0.3% בערך ולשפר את זמן הריצה של GVN ב-15% בערך.
הטמעת אופטימיזציות משתלמות
הסברנו איך למדוד ולזהות איפה מושקע הזמן, אבל זו רק ההתחלה. השלב הבא הוא לבצע אופטימיזציה של הזמן שמוקדש לקומפילציה.
בדרך כלל, במקרה כמו של Kill שמופיע למעלה, נבדוק איך אנחנו עוברים על הצמתים ונבצע את הפעולה מהר יותר. לדוגמה, על ידי ביצוע פעולות במקביל או שיפור האלגוריתם עצמו. למעשה, זה מה שניסינו בהתחלה, ורק כשלא מצאנו שום דבר לעשות, היה לנו רגע של "רגע, חכו…" והבנו שהפתרון הוא (במקרים מסוימים) לא לחזור על הפעולה בכלל! כשמבצעים אופטימיזציות כאלה, קל לפספס את התמונה הגדולה.
במקרים אחרים, השתמשנו בכמה שיטות שונות, כולל:
- שימוש ביוריסטיקה כדי להחליט אם אופטימיזציה לא תניב תוצאות משמעותיות, ולכן אפשר לדלג עליה
- שימוש במבני נתונים נוספים כדי לשמור במטמון נתונים מחושבים
- שינוי מבני הנתונים הקיימים כדי להגביר את המהירות
- חישוב תוצאות באופן עצל כדי להימנע ממחזורים במקרים מסוימים
- להשתמש בהפשטה הנכונה – תכונות מיותרות יכולות להאט את הקוד
- להימנע ממעקב אחרי מצביע שנמצא בשימוש תכוף דרך הרבה טעינות
איך אפשר לדעת אם כדאי ליישם את האופטימיזציות?
זה הקטע, לא צריך. אחרי שמזהים אזור שצורך הרבה זמן לקימפול, ואחרי שמקדישים זמן פיתוח כדי לנסות לשפר אותו, לפעמים פשוט לא מוצאים פתרון. יכול להיות שאין מה לעשות, שההטמעה תימשך יותר מדי זמן, שהיא תגרום לנסיגה משמעותית במדד אחר, שהיא תגביר את המורכבות של ה-code base וכו'. על כל אופטימיזציה מוצלחת שאתם רואים בפוסט הזה בבלוג, יש אינספור אופטימיזציות אחרות שלא הניבו פרי.
אם אתם נמצאים במצב דומה, נסו להעריך עד כמה אתם יכולים לשפר את המדד במינימום מאמץ. זה אומר, לפי הסדר:
- הערכה לפי מדדים שכבר אספתם, או פשוט לפי תחושת בטן
- הערכה באמצעות אב טיפוס מהיר ופשוט
- מטמיעים פתרון.
אל תשכחו להעריך את החסרונות של הפתרון שלכם. לדוגמה, אם אתם מתכוונים להסתמך על מבני נתונים נוספים, כמה זיכרון אתם מוכנים לנצל?
בחינה מעמיקה
בלי להכביר במילים, בואו נסתכל על כמה מהשינויים שהטמענו.
ביצענו שינוי כדי לשפר שיטה שנקראת FindReferenceInfoOf. השיטה הזו ביצעה חיפוש לינארי של וקטור כדי למצוא רשומה. עדכנו את מבנה הנתונים הזה כך שיכלול אינדקס לפי מזהה ההוראה, כדי ש-FindReferenceInfoOf יהיה O(1) במקום O(n). בנוסף, הקצינו מראש את הווקטור כדי למנוע שינוי גודל. הגדלנו מעט את הזיכרון כי היינו צריכים להוסיף שדה נוסף שספר כמה רשומות הוספנו לווקטור, אבל זו הייתה הקרבה קטנה כי הזיכרון המקסימלי לא גדל. השינוי הזה האיץ את שלב LoadStoreAnalysis ב-34-66%, וכתוצאה מכך שיפר את משך הזמן לקימפול ב-0.5-1.8% בערך.
יש לנו הטמעה מותאמת אישית של HashSet שבה אנחנו משתמשים בכמה מקומות. יצירת מבנה הנתונים הזה נמשכה זמן רב, וגילינו למה. לפני הרבה שנים, מבנה הנתונים הזה שימש רק בכמה מקומות שהשתמשו ב-HashSet גדולים מאוד, והוא עבר שינוי כדי לבצע אופטימיזציה לכך. עם זאת, כיום הוא משמש בכיוון ההפוך עם מעט מאוד כניסות ועם תוחלת חיים קצרה. זה אומר שבזבזנו מחזורי עיבוד על יצירת HashSet ענק, אבל השתמשנו בו רק לכמה רשומות לפני שהשלכנו אותו. השינוי הזה שיפר את משך הזמן לקימפול בכ-1.3% עד 2%. בונוס נוסף: השימוש בזיכרון ירד בכ-0.5-1% כי לא השתמשנו במבני נתונים גדולים כמו קודם.
שיפרנו את משך הזמן לקימפול בכ-0.5-1% על ידי העברת מבני נתונים באמצעות הפניה ל-lambda כדי להימנע מהעתקה שלהם. זה משהו שפספסנו בבדיקה המקורית, והוא נשאר בבסיס הקוד שלנו במשך שנים. בזכות בדיקת הפרופילים ב-pprof, שמנו לב שהשיטות האלה יוצרות ומשמידות הרבה מבני נתונים, מה שהוביל אותנו לחקור ולשפר אותן.
האצנו את השלב שבו נכתב הפלט המקומפל באמצעות שמירת ערכים מחושבים במטמון, מה שהוביל לשיפור של כ-1.3% עד 2.8% במשך הזמן הכולל לקימפול. לצערנו, הניהול הנוסף של הנתונים היה מוגזם, והבדיקה האוטומטית שלנו התריעה על רגרסיה בזיכרון. מאוחר יותר, בדקנו שוב את אותו קוד והטמענו גרסה חדשה שלא רק טיפלה ברגרסיה בזיכרון, אלא גם שיפרה את משך הזמן לקימפול ב-0.5% עד 1.8% נוספים. בשינוי השני הזה היינו צריכים לשנות את המבנה ולדמיין מחדש איך השלב הזה אמור לעבוד, כדי להיפטר מאחד משני מבני הנתונים.
יש לנו שלב במהדר האופטימיזציה שלנו שמשלב בקשות להפעלת פונקציות כדי לשפר את הביצועים. כדי לבחור אילו שיטות להטמיע, אנחנו משתמשים גם בהיוריסטיקה לפני שאנחנו מבצעים חישוב כלשהו, וגם בבדיקות סופיות אחרי ביצוע העבודה אבל ממש לפני שאנחנו מסיימים את ההטמעה. אם אחד מהם מזהה שההטמעה לא משתלמת (לדוגמה, אם יתווספו יותר מדי הוראות חדשות), אנחנו לא מטמיעים את הפעלת ה-method.
העברנו שתי בדיקות מהקטגוריה "בדיקות סופיות" לקטגוריה "היוריסטיקה" כדי להעריך אם הטמעה תצליח או לא לפני שנבצע חישוב שדורש זמן רב. מכיוון שמדובר בהערכה, היא לא מושלמת, אבל וידאנו שההיוריסטיקה החדשה שלנו מכסה 99.9% ממה שהיה מוטמע לפני כן בלי להשפיע על הביצועים. אחת מההיוריסטיקות החדשות האלה הייתה קשורה לאוגרי DEX הדרושים (שיפור של כ-0.2-1.3%), והשנייה הייתה קשורה למספר ההוראות (שיפור של כ-2%).
יש לנו הטמעה מותאמת אישית של BitVector שבה אנחנו משתמשים בכמה מקומות. החלפנו את המחלקה BitVector שניתן לשנות את הגודל שלה ב-BitVectorView פשוט יותר, עבור וקטורים מסוימים של ביטים בגודל קבוע. כך אפשר להימנע מחלק מההפניות העקיפות ומבדיקות הטווח בזמן הריצה, ולהאיץ את הבנייה של אובייקטים של וקטור ביטים.
בנוסף, המחלקה BitVectorView הוגדרה כתבנית בסוג האחסון הבסיסי (במקום להשתמש תמיד ב-uint32_t כמו ב-BitVector הישן). ההגדרה הזו מאפשרת לפעולות מסוימות, כמו Union(), לעבד פי שניים יותר ביטים ביחד בפלטפורמות של 64 ביט. הדגימות של הפונקציות המושפעות הופחתו ביותר מ-1% בסך הכול במהלך הידור של Android OS. השינוי הזה בוצע בכמה שלבים [1, 2, 3, 4, 5, 6]
אם נדבר בפירוט על כל האופטימיזציות, נהיה כאן כל היום! אם אתם רוצים לבצע אופטימיזציות נוספות, כדאי לעיין בשינויים אחרים שהטמענו:
- הוספת ניהול חשבונות כדי לשפר את משך הזמן לקימפול ב-0.6% עד 1.6%.
- חישוב נתונים באופן עצל כדי להימנע ממחזורים, אם אפשר.
- לארגן את הקוד מחדש כדי לדלג על עבודת החישוב מראש כשלא יהיה בה שימוש.
- הימנעו משרשראות טעינה תלויות כשאפשר להשיג את המקצה בקלות ממקומות אחרים.
- עוד מקרה של הוספת בדיקה כדי למנוע עבודה מיותרת.
- הימנעו מהסתעפות תכופה בסוג הרגיסטר (ליבה/FP) במקצה הרגיסטרים.
- מוודאים שחלק מהמערכים מאותחלים בזמן הקימפול. אל תסתמכו על clang כדי לעשות את זה.
- לנקות כמה לולאות. כדאי להשתמש בלולאות טווח ש-clang יכול לבצע להן אופטימיזציה טובה יותר, כי הוא לא צריך לטעון מחדש את המצביעים הפנימיים של הקונטיינר בגלל תופעות לוואי של הלולאה. מומלץ להימנע מקריאה לפונקציה הווירטואלית `HInstruction::GetInputRecords()` בלולאה דרך `InputAt(.)` המוטבעת לכל קלט.
- הימנעו מפונקציות Accept() לתבנית המבקר על ידי ניצול אופטימיזציה של המהדר.
סיכום
ההתמקדות שלנו בשיפור מהירות הקימפול של ART הניבה שיפורים משמעותיים, שהפכו את Android למערכת חלקה ויעילה יותר, וגם תרמו לחיי סוללה ארוכים יותר ולטמפרטורה נמוכה יותר של המכשיר. הזיהוי וההטמעה של אופטימיזציות הוכיחו שאפשר לשפר משמעותית את משך הזמן לקימפול בלי לפגוע בשימוש בזיכרון או באיכות הקוד.
התהליך כלל יצירת פרופילים באמצעות כלים כמו pprof, נכונות לחזור על פעולות, ולפעמים אפילו לנטוש דרכים פחות יעילות. המאמצים המשותפים של צוות ART לא רק הפחיתו את משך הזמן לקימפול באחוז משמעותי, אלא גם הניחו את היסודות להתקדמות עתידית.
כל השיפורים האלה זמינים בעדכון של Android לסוף שנת 2025, וב-Android מגרסה 12 ומעלה דרך עדכוני Mainline. אנחנו מקווים שההסבר המעמיק הזה על תהליך האופטימיזציה שלנו מספק תובנות חשובות לגבי המורכבות והיתרונות של הנדסת קומפיילרים.
-
 חדשות על המוצר
אחרי יותר משנה של הכנות משותפות עם מובילים בתחום, שותפים אזוריים, מפיצי אפליקציות וקהילות Android, אמצעי ההגנה על המשתמשים הופעלו בהצלחה ב-30 בספטמבר בחנויות המשתתפות בברזיל, אינדונזיה, סינגפור ותאילנד.
Matthew Forsythe • משך הקריאה: 2 דקות -
 חדשות על המוצר
כדי לספק את החוויות האלה לשחקנים ולוודא שהמשחקים שלך ייראו מצוין בכל גודל מסך, Google Play מציגה דרישות איכות חדשות למשחקים במסכים גדולים
Aurash Mahbod • משך הקריאה: 4 דקות -
 חדשות על המוצר
גרסת נובמבר 2026 של Jetpack Compose היא גרסה יציבה. הגרסה הזו כוללת את גרסה 1.13 במודולים העיקריים של Compose (ראו את המיפוי המלא של BOM), ומציגה עדכונים לטקסט, לגרפיקה, לפריסות, לביצועים ועוד – לצד כמה שינויים חשובים בהתנהגות ובהוצאה משימוש שחשוב לשים לב אליהם.
Meghan Mehta • משך הקריאה: 10 דקות
רוצים לקבל טיפים עדכניים לפיתוח Android ישירות לאימייל כל שבוע?