我们希望帮助您更快速、更轻松地构建高质量 Android 应用,而让您触手可及地使用 AI 技术,正是我们帮助您提高工作效率的一种方式。我们知道,您希望 AI 能够真正理解 Android 平台的细微差别,因此我们一直在衡量 LLM 在执行 Android 开发任务时的表现。今天,我们发布了首个版本的 Android Bench,这是我们面向 Android 开发的官方 LLM 排行榜。
我们的目标是为模型创建者提供一个基准,用于评估 LLM 在 Android 开发方面的能力。通过为高质量 Android 开发建立清晰、可靠的基准,我们帮助模型创建者识别差距并加速改进,从而使开发者能够更高效地工作,并有更多实用的模型可供选择以获得 AI 辅助,最终在整个 Android 生态系统中打造出更高质量的应用。
围绕实际 Android 开发任务设计
我们针对一系列常见的 Android 开发领域,精心挑选了一组任务,并以此创建了基准。它由难度各异的真实挑战组成,这些挑战来自公开的 GitHub Android 代码库。这些场景包括解决不同 Android 版本之间的破坏性更改、处理特定领域的任务(例如穿戴式设备上的网络连接),以及迁移到最新版本的 Jetpack Compose 等。
每次评估都会尝试让 LLM 修复任务中报告的问题,然后我们会使用单元测试或插桩测试进行验证。这种不限模型的方法使我们能够衡量模型在复杂代码库中导航、理解依赖项以及解决您每天遇到的各种问题的能力。
我们与 JetBrains 等多家 LLM 制造商一起验证了此方法。
“衡量 AI 对 Android 的影响是一项巨大的挑战,因此很高兴看到一个如此完善且切合实际的框架。虽然我们一直在积极进行自我基准测试,但 Android Bench 仍是一个独特且受欢迎的新工具。这种方法正是 Android 开发者目前所需要的严格评估。”
- Kirill Smelov,JetBrains AI 集成负责人。
首批 Android Bench 结果
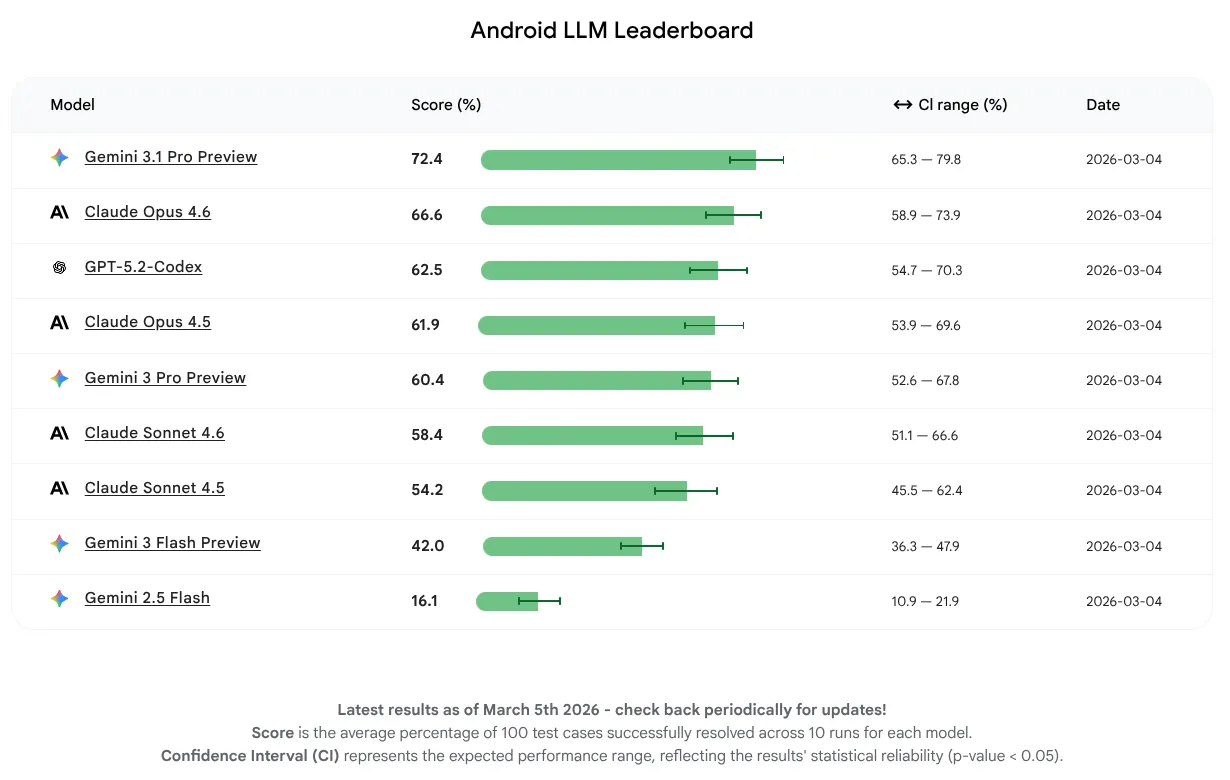
对于此初始版本,我们希望纯粹衡量模型性能,而不是专注于智能体或工具的使用。这些模型能够成功完成 16-72% 的任务。这个范围很广,表明一些 LLM 已经具备了扎实的 Android 知识基础,而另一些 LLM 则有更大的提升空间。无论这些模型目前处于何种水平,我们都期待它们能持续改进,因为我们正在鼓励 LLM 构建者针对 Android 开发优化其模型。
在首个版本中,平均得分最高的 LLM 是 Gemini 3.1 Pro,紧随其后的是 Claude Opus 4.6。您可以在最新稳定版 Android Studio 中使用 API 密钥,尝试我们评估过的所有模型,为您的 Android 项目提供 AI 辅助。
为开发者和 LLM 制造商提供透明度
我们重视开放和透明,因此在 GitHub 上公开了我们的方法、数据集和自动化测试框架。
任何公开基准测试都面临一个挑战,即数据污染风险,即模型可能在训练过程中接触过评估任务。我们已采取措施,确保结果反映的是真正的推理,而不是记忆或猜测,包括对智能体轨迹进行全面的人工审核,或集成 Canary 字符串以阻止训练。
展望未来,我们将继续改进我们的方法,以保持数据集的完整性,同时也会在未来的基准版本中做出改进,例如增加任务的数量和复杂性。
我们期待 Android Bench 能够长期改进 AI 辅助功能。我们的愿景是弥合概念与优质代码之间的鸿沟。我们正在为未来奠定基础,让您无论有何奇思妙想,都能在 Android 上实现。
-
 产品资讯
今天,在 Android 开发者峰会上,我们宣布广泛推出许多工具和 API,旨在消除日常开发中的阻碍,让您能够更灵活地构建出色的 Android 应用。
Matthew McCullough • 阅读用时:4 分钟 -
 产品资讯
今天,我们发布了第一组长跨度任务 (LHT),这些任务非常复杂,工程师需要几天甚至一周的时间才能完成。我们还将引入智能体评估,首先从相应模型提供商的智能体开始。
-
 产品资讯
今天,我们发布了 Android 17,并将其推送到大多数受支持的 Pixel 设备。未来几个月,敬请期待搭载 Android 17 的新设备。
Matthew McCullough • 阅读用时:13 分钟
每周通过电子邮件接收最新的 Android 开发洞见。