在首次推出 Android Bench 时,我们构建了一个严谨的基础,用于评估大语言模型 (LLM) 如何协助开发者完成实际的 Android 任务。随着 AI 模型和智能体的快速发展,我们一直在更新我们的方法,例如使我们的基准框架与 Harbor 框架保持一致。今天,我们将发布第一组长跨度任务 (LHT),这些任务非常复杂,工程师需要花费数天甚至一周的时间才能完成。我们还将引入智能体评估,首先从相应模型提供商的智能体开始。此次新增功能带来了 Android Bench 2.0,这是一次重大升级,旨在评估 AI 模型和智能体在处理您每天面临的大规模、模糊性和复杂多步骤问题解决方面的能力。
从增量式修补到长跨度任务
Android Bench 的第一个迭代版本以及类似的早期 AI 编码基准,主要关注对现有代码库的增量更改,在许多情况下仅限于问题修复或较小的功能请求。这反映了当时 AI 辅助功能的能力以及您的使用方式。
为了继续帮助您找到最适合您开发工作流的模型和编码智能体,我们提高了评估标准,以匹配您委托给 AI 的工作。Android Bench 2.0 模拟了这些具有挑战性的任务,包括升级依赖项、添加新功能、从头开始构建应用,或将跨平台应用转换为 Android 应用。
复杂任务需要更细致的评估和评分
在多日工程任务中,二元通过或失败评分无法反映全貌。
例如,一个智能体可能成功将 40 个界面重构为 Jetpack Compose,设置了数据库表,并满足了 90% 的要求,但却未能通过一个边缘情况断言。二元评分会将此运行评为 0%,从而掩盖了模型的架构能力。我们正在转向连续评分,以便提供更有意义的信号,这既有助于模型开发,也有助于您了解 AI 如何为您提供帮助。
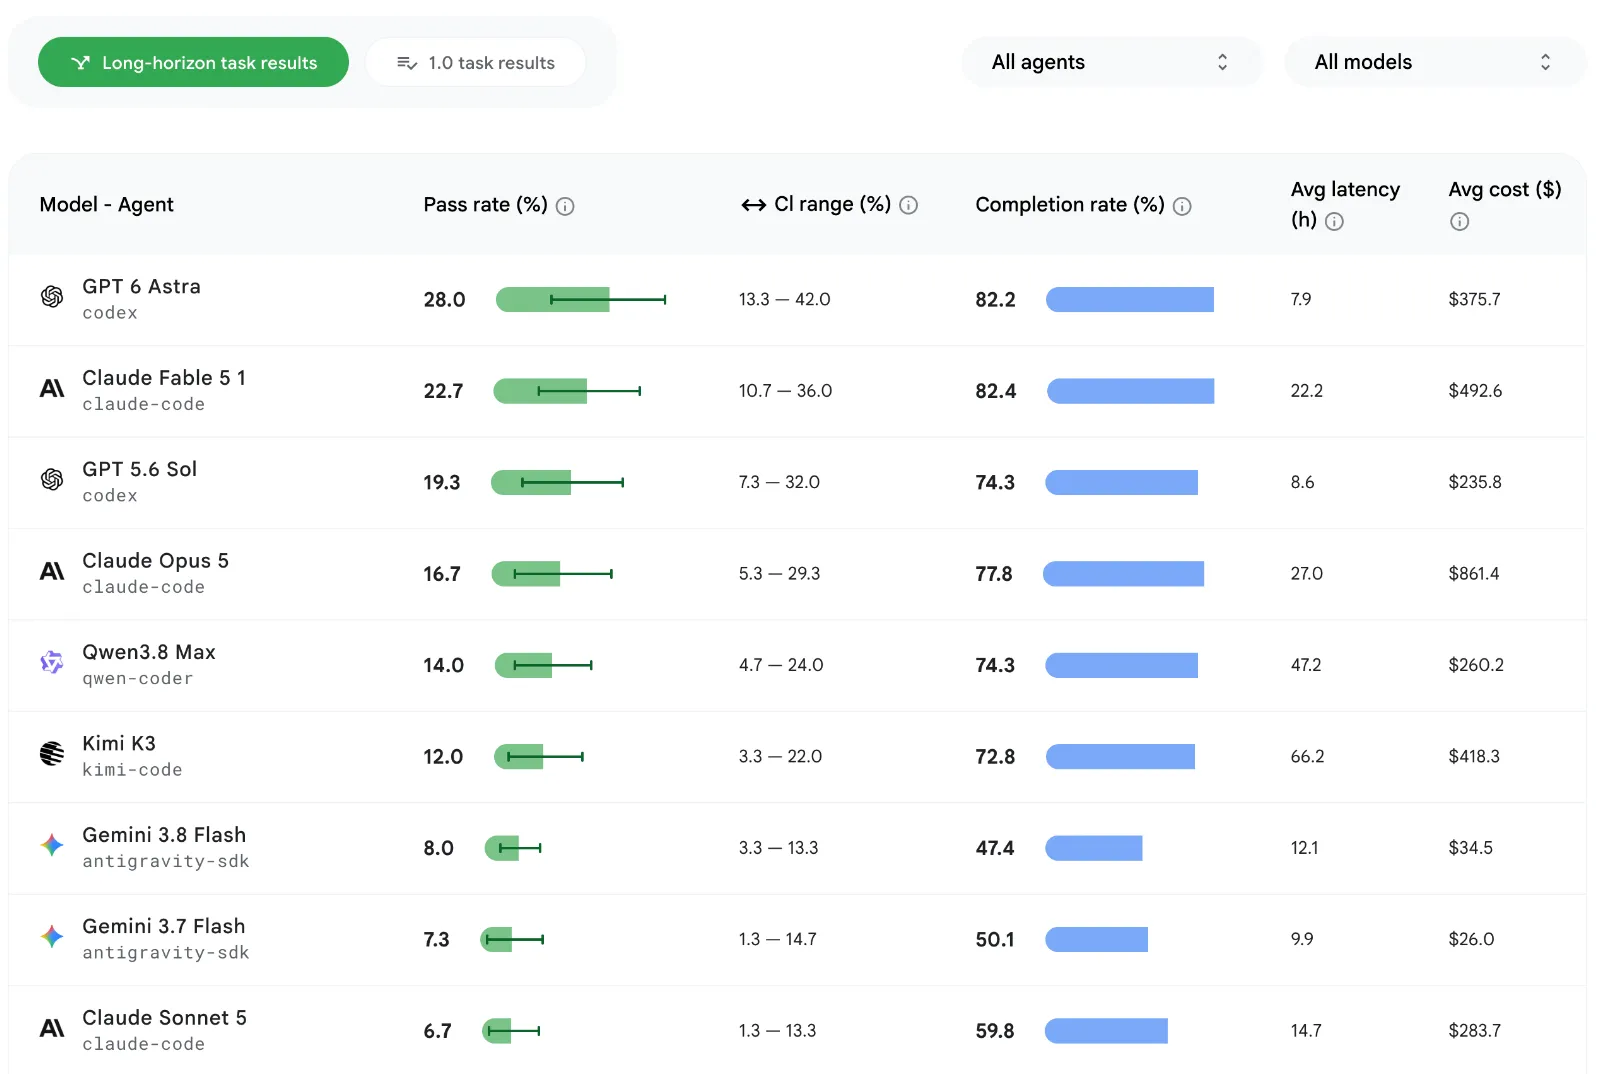
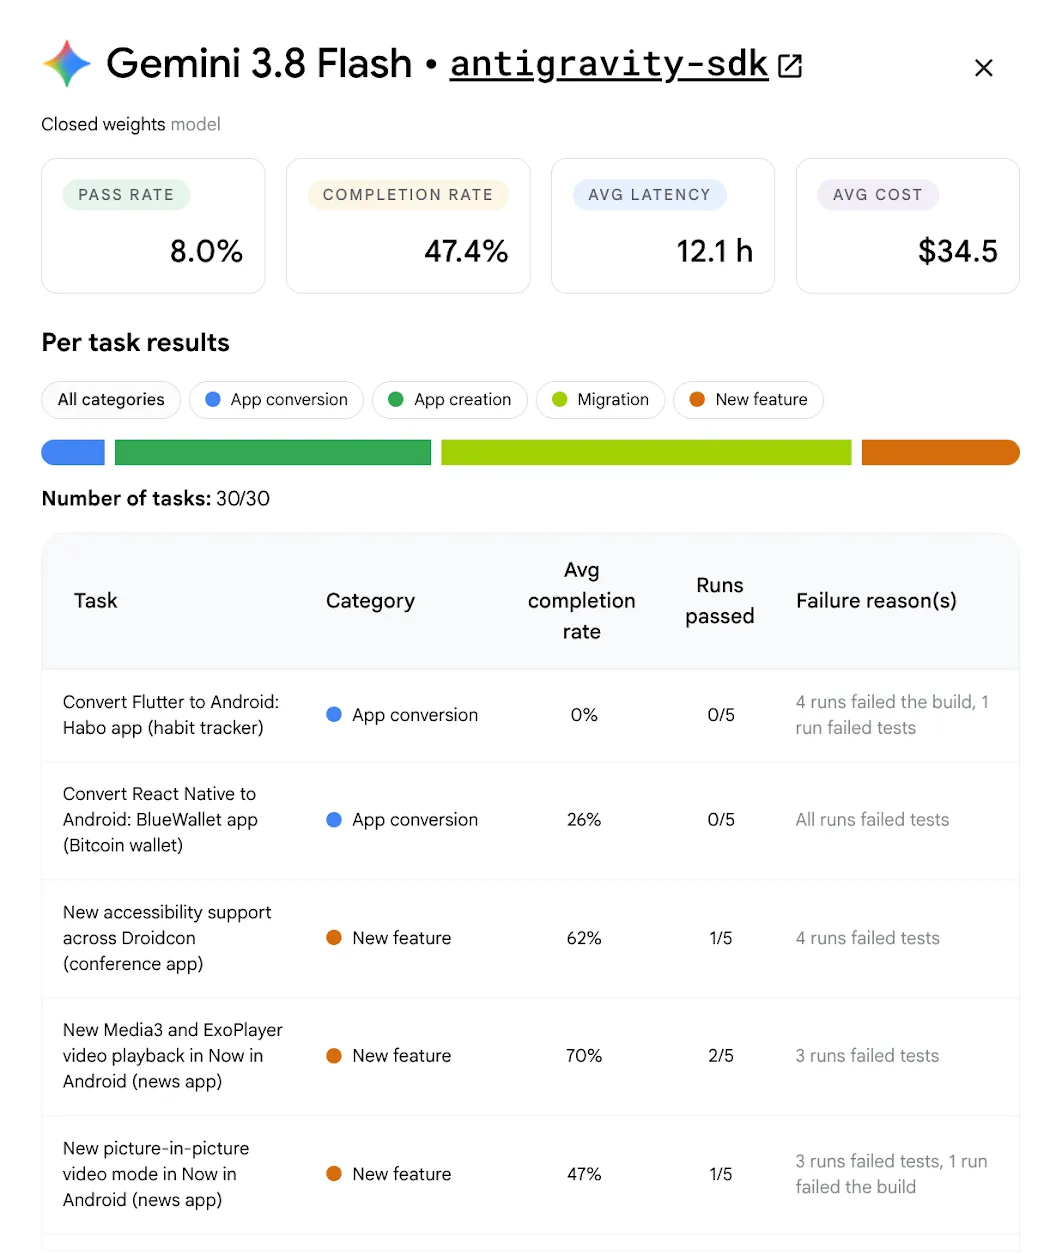
我们会综合考虑功能、视觉保真度和避免回归等因素来计算此完成率。此外,如果偏离评估说明或结构限制,我们也会客观地扣分。查看更新后的排行榜,然后点击每个模型的卡片视图,即可查看其他元素,例如每个模型和每项任务的通过率、完成率和平均费用。
LHT 的最高通过率约为 28%,远低于基准中原始任务的约 91%。
长跨度任务可为 AI 辅助功能提供实用分析
除了衡量 AI 处理长时间运行任务的效果之外,LHT 数据集还有助于我们详细了解受测模型的优缺点,并为您提供更实用的指导。
在各个模型层级中,AI 在编写新代码方面比重构现有代码表现更好。重构和迁移变得更加棘手,因为成功与否取决于架构的复杂性,而不是代码量。
模型在成熟、确定性的转换方面表现出强大的能力,例如将 Java 转换为 Kotlin、将 Retrofit 替换为 Ktor,或引入 ViewModel 层。即使在 125 多个文件和 8,000 多行代码中,它们也能始终如一地应用这些模式。
不过,如果任务需要运行时验证(例如缺少依赖项注入图)、涉及破坏性框架更改,或遇到未发布库的知识空白,模型就会遇到困难。将跨平台应用移植到 Android 仍然是一项艰巨的挑战,没有一个模型能达到 100% 的通过率,前沿模型的完成率最高也只有 80%。
智能体评估简介
为了帮助您更好地了解模型在集成到智能体工作流中的表现,我们在评估中添加了常用智能体。我们首先会使用来自相应模型提供商的智能体,针对 LHT 运行新模型。例如,我们在 Codex 上运行 GPT 5.6 Sol,在 Google Antigravity 上运行 Gemini 3.8 Flash。这种搭配展示了框架设计如何对开发者成果产生积极影响,因为我们已经看到提示缓存和紧凑工具窗口可以减少 token 数量。
未来,我们还将扩展此功能,突出显示各种模型和智能体组合的结果,帮助您发现最适合您和您团队的组合。
我们之所以投入精力进行这项评测,是因为我们认为,让您能够使用自己选择的智能体和模型进行 Android 开发非常重要。在接下来的几周内,我们将与您分享更多相关信息。
已添加新模型
此外,我们还在不断扩展排行榜,确保您能获得最新数据,从而做出明智的开发决策。我们添加了 Gemini 3.8 Flash、Gemini 3.7 Flash、OpenAI 的 GPT-6、Anthropic 的 Fable 5.1、Kimi K3 和 Qwen 3.8 Max,其中 OpenAI 的 GPT-6 Astra 以 28% 的通过率位居榜首。
展望未来
Android Bench 2.0 提供了一个强大的环境,用于衡量 AI 在 Android 开发中的表现。通过结合长跨度任务、多模态评估、智能体和持续评分,我们希望赋能 AI 调研团队,打造更强大、更可靠的 AI 编程助手,并让您更清晰地了解 AI 开发选项。
查看更新后的排行榜以及更新后的方法。您的反馈将直接影响 Android Bench 的发展方向,因此请继续通过 GitHub 以及 X 和 LinkedIn 等社交渠道与我们分享您的反馈。
-
 产品资讯
今天,在 Android 开发者峰会上,我们宣布广泛推出许多工具和 API,旨在消除日常开发中的阻碍,让您能够更灵活地构建出色的 Android 应用。
Matthew McCullough • 阅读用时:4 分钟 -
 产品资讯
随着智能体开发不断加速,Android 工程领域正迈向一个令人振奋的新境界:从辅助性代码补全,跃升至智能体在您的指挥下执行端到端任务。您可以完全自主、灵活地选择要使用的模型和智能体。
Jason Buchel • 阅读用时:3 分钟 -

 产品资讯
作为 Android 开发者,您在应用开发过程中有多种智能体、大语言模型、工具和命令行界面 (CLI) 可供选择。我们的目标是帮助您打造精美、优质的 Android 应用,无论您选择何种开发方式。
Simona Milanovic • 阅读用时:4 分钟
每周通过电子邮件接收最新的 Android 开发洞见。