Funktionsweise: die sperrenfreie MessageQueue von Android 17
Lesezeit: 16 Minuten
In Android 17 erhalten Apps, die auf SDK 37 oder höher ausgerichtet sind, eine neue Implementierung von MessageQueue, die ohne Sperren auskommt. Die neue Implementierung verbessert die Leistung und reduziert die Anzahl der verpassten Frames, kann aber Clients beeinträchtigen, die private Felder und Methoden von MessageQueue reflektieren. Weitere Informationen zur Verhaltensänderung und dazu, wie Sie die Auswirkungen minimieren können, finden Sie in der Dokumentation zur Verhaltensänderung von MessageQueue. In diesem technischen Blogpost finden Sie einen Überblick über die neue Architektur von MessageQueue und erfahren, wie Sie Probleme mit Sperrkonflikten mit Perfetto analysieren können.
Der Looper steuert den UI-Thread jeder Android-App. Es ruft Aufgaben aus einer MessageQueue ab, leitet sie an einen Handler weiter und wiederholt den Vorgang. Zwei Jahrzehnte lang hat MessageQueue eine einzelne Monitorsperre (d.h. einen synchronized-Codeblock) verwendet, um den Status zu schützen.
Android 17 führt ein wichtiges Update für diese Komponente ein: eine sperrfreie Implementierung namens DeliQueue.
In diesem Beitrag wird erläutert, wie sich Sperren auf die UI-Leistung auswirken, wie Sie diese Probleme mit Perfetto analysieren und welche spezifischen Algorithmen und Optimierungen verwendet werden, um den Android-Hauptthread zu verbessern.
Das Problem: Lock Contention und Priority Inversion
Die alte MessageQueue-Funktion diente als Prioritätswarteschlange, die durch eine einzelne Sperre geschützt war. Wenn ein Hintergrundthread eine Nachricht postet, während der Hauptthread die Warteschlange verwaltet, blockiert der Hintergrundthread den Hauptthread.
Wenn zwei oder mehr Threads um die exklusive Verwendung desselben Locks konkurrieren, spricht man von Lock-Konflikten. Diese Konflikte können zu einer Prioritätsumkehr führen, was wiederum zu Rucklern auf der Benutzeroberfläche und anderen Leistungsproblemen führen kann.
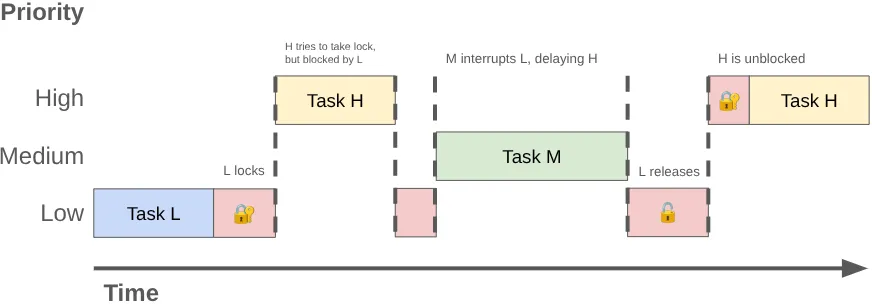
Eine Prioritätsumkehr kann auftreten, wenn ein Thread mit hoher Priorität (z. B. der UI-Thread) auf einen Thread mit niedriger Priorität warten muss. Betrachten Sie diese Sequenz:
- Ein Hintergrundthread mit niedriger Priorität fordert die Sperre
MessageQueuean, um das Ergebnis seiner Arbeit zu posten. - Ein Thread mit mittlerer Priorität wird ausführbar und der Planer des Kernels weist ihm CPU-Zeit zu, wodurch der Thread mit niedriger Priorität vorzeitig beendet wird.
- Der UI-Thread mit hoher Priorität schließt seine aktuelle Aufgabe ab und versucht, aus der Warteschlange zu lesen. Er wird jedoch blockiert, da der Thread mit niedriger Priorität die Sperre hat.
Der Thread mit niedriger Priorität blockiert den UI-Thread und die Arbeit mit mittlerer Priorität verzögert ihn weiter.
Konflikte mit Perfetto analysieren
Sie können diese Probleme mit Perfetto diagnostizieren. In einem Standard-Trace wechselt ein Thread, der durch eine Monitorsperre blockiert ist, in den Ruhemodus. Perfetto zeigt dann ein Segment an, das den Inhaber der Sperre angibt.
Suchen Sie beim Abfragen von Tracedaten nach Segmenten mit dem Namen „monitor contention with …“, gefolgt vom Namen des Threads, der das Lock besitzt, und der Codestelle, an der das Lock erworben wurde.
Fallstudie: Launcher-Ruckeln
Sehen wir uns zur Veranschaulichung einen Trace an, bei dem ein Nutzer auf einem Pixel Smartphone unmittelbar nach dem Aufnehmen eines Fotos in der Kamera-App beim Navigieren zum Startbildschirm ein Ruckeln bemerkt hat. Unten sehen Sie einen Screenshot von Perfetto mit den Ereignissen, die zum verpassten Frame geführt haben:
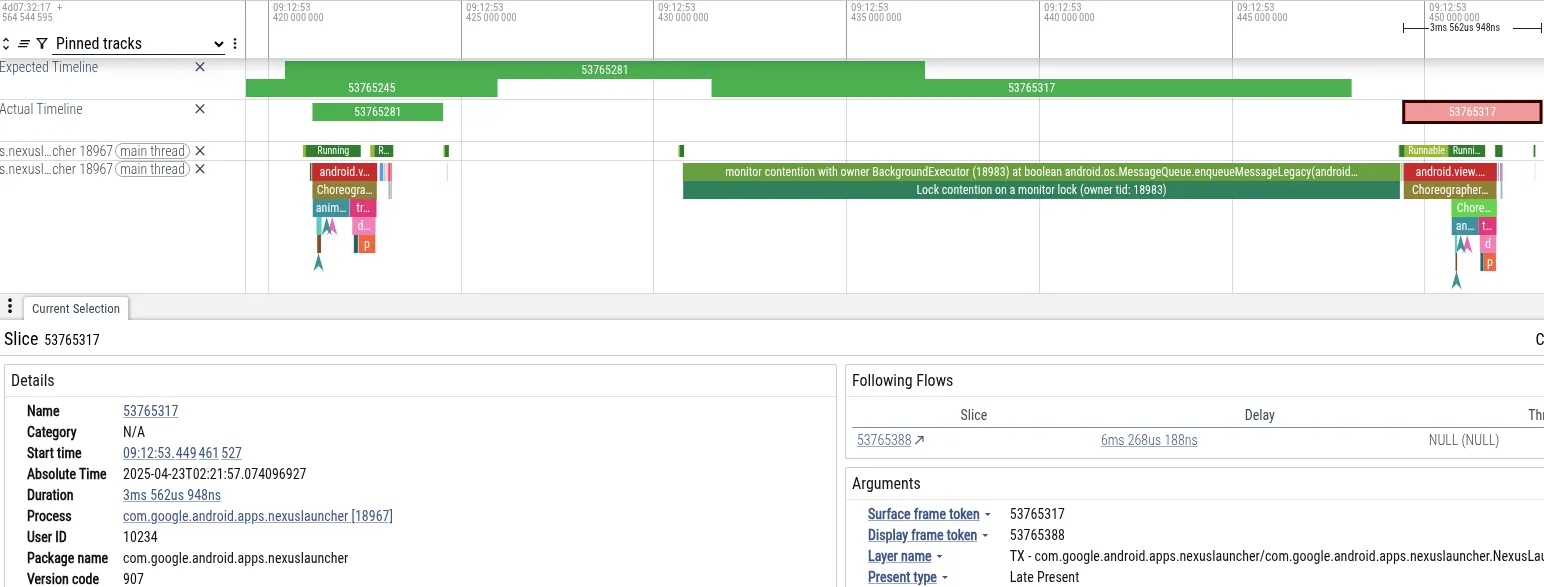
- Symptom:Der Hauptthread des Launchers hat die Frame-Deadline verpasst. Es wurde 18 ms lang blockiert, was das für das Rendern mit 60 Hz erforderliche Zeitlimit von 16 ms überschreitet.
- Diagnose:Perfetto hat gezeigt, dass der Hauptthread durch die
MessageQueue-Sperre blockiert wird. Ein „BackgroundExecutor“-Thread hatte die Sperre. - Ursache:Der BackgroundExecutor wird mit Process.THREAD_PRIORITY_BACKGROUND (sehr niedrige Priorität) ausgeführt. Es wurde eine nicht dringende Aufgabe ausgeführt (Prüfung der Nutzungslimits für Apps). Gleichzeitig haben Threads mit mittlerer Priorität CPU-Zeit verwendet, um Daten von der Kamera zu verarbeiten. Der OS-Scheduler hat den BackgroundExecutor-Thread vorzeitig beendet, um die Kamera-Threads auszuführen.
Diese Sequenz führte dazu, dass der UI-Thread des Launchers (hohe Priorität) indirekt durch den Arbeitsthread der Kamera (mittlere Priorität) blockiert wurde, wodurch der Hintergrundthread des Launchers (niedrige Priorität) die Sperre nicht aufheben konnte.
Traces mit PerfettoSQL abfragen
Mit PerfettoSQL können Sie Trace-Daten nach bestimmten Mustern abfragen. Das ist nützlich, wenn Sie eine große Anzahl von Traces von Nutzergeräten oder Tests haben und nach bestimmten Traces suchen, die ein Problem aufzeigen.
Mit dieser Abfrage werden beispielsweise MessageQueue-Konflikte gefunden, die mit ausgelassenen Frames (Ruckeln) zusammenfallen:
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.frames.jank_type;

SELECT
  process_name,
  -- Convert duration from nanoseconds to milliseconds
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM android_monitor_contention
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"

-- Only look at app processes that had jank
AND upid IN (
  SELECT DISTINCT(upid)
  FROM actual_frame_timeline_slice
  WHERE android_is_app_jank_type(jank_type) = TRUE
)
GROUP BY process_name
ORDER BY SUM(dur) DESC;
In diesem komplexeren Beispiel werden Tracedaten aus mehreren Tabellen zusammengeführt, um Konflikte in der MessageQueue während des App-Starts zu erkennen:
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.startup.startups;

-- Join package and process information for startups
DROP VIEW IF EXISTS startups;
CREATE VIEW startups AS
SELECT startup_id, ts, dur, upid
FROM android_startups
JOIN android_startup_processes USING(startup_id);

-- Intersect monitor contention with startups in the same process.
DROP TABLE IF EXISTS monitor_contention_during_startup;
CREATE VIRTUAL TABLE monitor_contention_during_startup
USING SPAN_JOIN(android_monitor_contention PARTITIONED upid, startups PARTITIONED upid);

SELECT
  process_name,
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM monitor_contention_during_startup
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"
GROUP BY process_name
ORDER BY SUM(dur) DESC;
Sie können Ihr bevorzugtes LLM verwenden, um PerfettoSQL-Abfragen zu schreiben, mit denen Sie andere Muster finden.
Bei Google verwenden wir BigTrace, um PerfettoSQL-Abfragen für Millionen von Traces auszuführen. Dabei haben wir festgestellt, dass es sich bei den Einzelfällen, die wir gesehen hatten, tatsächlich um ein systemisches Problem handelte. Die Daten zeigten, dass MessageQueue Sperrkonflikte Nutzer im gesamten Ökosystem betreffen, was die Notwendigkeit einer grundlegenden architektonischen Änderung untermauerte.
Lösung: Sperrfreie Nebenläufigkeit
Wir haben das Problem der MessageQueue-Konkurrenz behoben, indem wir eine sperrenfreie Datenstruktur implementiert haben. Dabei werden atomare Speichervorgänge anstelle von exklusiven Sperren verwendet, um den Zugriff auf den gemeinsamen Status zu synchronisieren. Eine Datenstruktur oder ein Algorithmus ist sperrenfrei, wenn mindestens ein Thread unabhängig vom Scheduling-Verhalten der anderen Threads immer Fortschritte machen kann. Diese Eigenschaft ist im Allgemeinen schwer zu erreichen und für den meisten Code in der Regel nicht lohnenswert.
Die atomaren Primitiven
Sperrfreie Software basiert häufig auf atomaren Lese-Änderungs-Schreib-Primitiven, die von der Hardware bereitgestellt werden.
Auf ARM64-CPUs älterer Generationen verwendeten atomare Operationen eine Load-Link/Store-Conditional-Schleife (LL/SC). Die CPU lädt einen Wert und markiert die Adresse. Wenn ein anderer Thread in diese Adresse schreibt, schlägt der Speichervorgang fehl und die Schleife wird wiederholt. Da die Threads es immer wieder versuchen und erfolgreich sein können, ohne auf einen anderen Thread warten zu müssen, ist dieser Vorgang sperrfrei.
ARM64 LL/SC loop example
retry:
    ldxr    x0, [x1]        // Load exclusive from address x1 to x0
    add     x0, x0, #1      // Increment value by 1
    stxr    w2, x0, [x1]    // Store exclusive.
                            // w2 gets 0 on success, 1 on failure
cbnz w2, retry // If w2 is non-zero (failed), branch to retr(Im Compiler Explorer ansehen)
Neuere ARM-Architekturen (ARMv8.1) unterstützen Large System Extensions (LSE), die Anweisungen in Form von Compare-And-Swap (CAS) oder Load-And-Add (siehe unten) enthalten. In Android 17 haben wir den Android Runtime-Compiler (ART) so erweitert, dass er erkennt, wenn LSE unterstützt wird, und optimierte Anweisungen ausgibt:
/ ARMv8.1 LSE atomic example
ldadd   x0, x1, [x2]    // Atomic load-add.
                        // Faster, no loop required.
In unseren Benchmarks erreicht Code mit hoher Konfliktrate, der CAS verwendet, eine etwa dreifache Beschleunigung gegenüber der LL/SC-Variante.
Die Programmiersprache Java bietet atomare Primitive über java.util.concurrent.atomic, die auf diesen und anderen speziellen CPU-Anweisungen basieren.
Die Datenstruktur: DeliQueue
Um die Sperrenkonflikte in MessageQueue zu beheben, haben unsere Entwickler eine neue Datenstruktur namens DeliQueue entwickelt. Bei DeliQueue wird das Einfügen von Message von der Verarbeitung von Message getrennt:
- Die Liste der
Messages(Treiber-Stack): Ein sperrfreier Stack. Jeder Thread kann hier ohne Konflikte neueMessagesübertragen. - Prioritätswarteschlange (Min-Heap): Ein Heap mit
Messages, der ausschließlich dem Looper-Thread gehört. Daher sind für den Zugriff keine Synchronisierung oder Sperren erforderlich.
In die Warteschlange einreihen: in einen Treiber-Stack einfügen
Die Liste der Messages wird in einem Treiber-Stack [1] verwaltet, einem sperrfreien Stack, der eine CAS-Schleife zum Aktualisieren des Head-Zeigers verwendet.
public class TreiberStack <E> {
    AtomicReference<Node<E>> top =
            new AtomicReference<Node<E>>();
    public void push(E item) {
        Node<E> newHead = new Node<E>(item);
        Node<E> oldHead;
        do {
            oldHead = top.get();
            newHead.next = oldHead;
        } while (!top.compareAndSet(oldHead, newHead));
    }

    public E pop() {
        Node<E> oldHead;
        Node<E> newHead;
        do {
            oldHead = top.get();
            if (oldHead == null) return null;
            newHead = oldHead.next;
        } while (!top.compareAndSet(oldHead, newHead));
        return oldHead.item;
    }
}
Quellcode basierend auf Java Concurrency in Practice [2], online verfügbar und als Public Domain veröffentlicht
Jeder Producer kann jederzeit neue Messages in den Stack übertragen. Das ist so, als würde man an der Frischetheke eine Nummer ziehen. Ihre Nummer wird dadurch bestimmt, wann Sie gekommen sind, aber die Reihenfolge, in der Sie Ihr Essen bekommen, muss nicht übereinstimmen. Da es sich um einen verknüpften Stack handelt, ist jeder Message ein Sub-Stack. Sie können sehen, wie die Message-Warteschlange zu einem bestimmten Zeitpunkt aussah, indem Sie den Head verfolgen und vorwärts iterieren. Sie sehen keine neuen Messages, die oben hinzugefügt werden, auch wenn sie während des Durchlaufs hinzugefügt werden.
Aus der Warteschlange entfernen: Bulk-Übertragung in einen Min-Heap
Um das nächste zu verarbeitende Message zu finden, verarbeitet das Looper neue Messages aus dem Treiber-Stack, indem es den Stack von oben nach unten durchläuft, bis es das letzte Message findet, das es zuvor verarbeitet hat. Während der Looper den Stack durchläuft, fügt er Messages in den nach Frist geordneten Min-Heap ein. Da der Looper der alleinige Inhaber des Heaps ist, ordnet und verarbeitet er Messages ohne Sperren oder atomare Operationen.
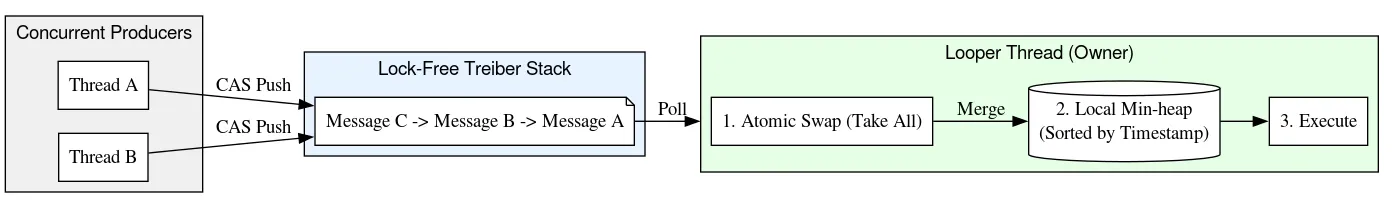
Beim Durchlaufen des Stacks erstellt der Looper auch Links von gestapelten Messages zurück zu ihren Vorgängern, wodurch eine doppelt verknüpfte Liste entsteht. Das Erstellen der verknüpften Liste ist sicher, da Links, die im Stack nach unten zeigen, über den Treiber-Stack-Algorithmus mit CAS hinzugefügt werden und Links, die im Stack nach oben zeigen, nur vom Thread Looper gelesen und geändert werden. Diese Backlinks werden dann verwendet, um Messages von beliebigen Punkten im Stack in O(1)-Zeit zu entfernen.
Dieses Design bietet eine Einfügung von O(1) für Producer (Threads, die Arbeit in die Warteschlange stellen) und eine amortisierte Verarbeitung von O(log N) für den Consumer (die Looper).
Die Verwendung eines Min-Heaps zum Sortieren von Messages behebt auch einen grundlegenden Fehler im alten MessageQueue, bei dem Messages in einer einfach verketteten Liste (mit dem Stamm an der Spitze) gespeichert wurden. In der alten Implementierung war das Entfernen vom Kopf O(1), aber das Einfügen hatte im schlimmsten Fall O(N) – was bei überlasteten Warteschlangen schlecht skalierte. Umgekehrt skalieren das Einfügen in den Min-Heap und das Entfernen daraus logarithmisch. Das sorgt für eine wettbewerbsfähige durchschnittliche Leistung, aber vor allem für hervorragende Tail-Latenzen.
Legacy (gesperrt) MessageQueue | DeliQueue | |
| Einfügen | O(N) | O(1) für den aufrufenden Thread O(logN) für |
| Vom Kopf entfernen | O(1) | O(logN) |
In der alten Warteschlangenimplementierung verwendeten Ersteller und Verbraucher eine Sperre, um den exklusiven Zugriff auf die zugrunde liegende einfach verknüpfte Liste zu koordinieren. In DeliQueue verarbeitet der Treiber-Stack den gleichzeitigen Zugriff und der einzelne Consumer übernimmt die Sortierung der Arbeitswarteschlange.
Entfernung: Konsistenz über Tombstones
DeliQueue ist eine hybride Datenstruktur, die einen sperrenfreien Treiber-Stack mit einem Single-Thread-Min-Heap verbindet. Diese beiden Strukturen ohne globale Sperre synchron zu halten, ist eine besondere Herausforderung: Eine Nachricht kann physisch im Stack vorhanden, aber logisch aus der Warteschlange entfernt sein.
Um dieses Problem zu lösen, verwendet DeliQueue eine Technik namens „Tombstoning“. Jede Message verfolgt ihre Position im Stack über die Rückwärts- und Vorwärtszeiger, ihren Index im Array des Heaps und ein boolesches Flag, das angibt, ob sie entfernt wurde. Wenn ein Message bereit zur Ausführung ist, wird das Flag „removed“ des Looper-Threads per CAS-Operation geändert und der Thread wird aus dem Heap und Stack entfernt.
Wenn ein anderer Thread einen Message entfernen muss, wird er nicht sofort aus der Datenstruktur extrahiert. Stattdessen werden die folgenden Schritte ausgeführt:
- Logisches Entfernen: Der Thread verwendet CAS, um das Entfernungsflag von
Messageatomar von „false“ auf „true“ zu setzen. DieMessageverbleibt in der Datenstruktur als Nachweis für die ausstehende Entfernung, ein sogenannter „Tombstone“. Sobald eineMessagezum Entfernen markiert ist, wird sie von DeliQueue so behandelt, als ob sie nicht mehr in der Warteschlange vorhanden wäre, wenn sie gefunden wird. - Verzögerte Bereinigung: Das tatsächliche Entfernen aus der Datenstruktur liegt in der Verantwortung des
Looper-Threads und wird auf einen späteren Zeitpunkt verschoben. Anstatt den Stack oder Heap zu ändern, fügt der Remover-Thread dasMessageeinem anderen lock-free Freelist-Stack hinzu. - Strukturelles Entfernen: Nur der
Looperkann mit dem Heap interagieren oder Elemente aus dem Stack entfernen. Wenn er aktiviert wird, löscht er die Freiliste und verarbeitet die darin enthaltenenMessages. JedesMessagewird dann vom Stapel entkoppelt und aus dem Heap entfernt.
Bei diesem Ansatz wird die gesamte Verwaltung des Heaps in einem einzelnen Thread ausgeführt. Dadurch wird die Anzahl der erforderlichen gleichzeitigen Vorgänge und Speichersperren minimiert, wodurch der kritische Pfad schneller und einfacher wird.
Traversal: benign Java memory model data races
Die meisten APIs für die Parallelverarbeitung, z. B. Future in der Java-Standardbibliothek oder Job und Deferred in Kotlin, enthalten einen Mechanismus zum Abbrechen von Vorgängen, bevor sie abgeschlossen sind. Eine Instanz einer dieser Klassen entspricht 1:1 einer zugrunde liegenden Arbeitseinheit. Wenn Sie cancel für ein Objekt aufrufen, werden die damit verbundenen spezifischen Vorgänge abgebrochen.
Heutige Android-Geräte haben Multi-Core-CPUs und eine gleichzeitige, generationenbasierte automatische Speicherbereinigung. Als Android entwickelt wurde, war es jedoch zu teuer, für jede Arbeitseinheit ein Objekt zuzuweisen. Daher unterstützt Handler von Android die Stornierung über zahlreiche Überladungen von removeMessages. Anstatt eine bestimmte Message zu entfernen, werden alle Messages entfernt, die den angegebenen Kriterien entsprechen. In der Praxis müssen Sie dazu alle Message-Elemente durchlaufen, die vor dem Aufruf von removeMessages eingefügt wurden, und die übereinstimmenden Elemente entfernen.
Beim Vorwärts-Iterieren benötigt ein Thread nur einen geordneten atomaren Vorgang, um den aktuellen Kopf des Stacks zu lesen. Danach werden normale Feldlesevorgänge verwendet, um die nächste Message zu finden. Wenn der Looper-Thread die next-Felder ändert, während Messages entfernt werden, sind der Schreibvorgang von Looper und der Lesevorgang eines anderen Threads nicht synchronisiert. Dies ist ein Data Race. Normalerweise ist eine Racebedingung ein schwerwiegender Fehler, der zu großen Problemen in Ihrer App führen kann, z. B. Lecks, Endlosschleifen, Abstürze und Einfrieren. Unter bestimmten, engen Bedingungen können Datenrennen im Java-Speichermodell jedoch unbedenklich sein. Angenommen, wir beginnen mit einem Stapel von:

Wir führen einen atomaren Lesevorgang des Kopfes durch und sehen A. Der nächste Zeiger von A zeigt auf B. Während wir B verarbeiten, entfernt der Looper möglicherweise B und C, indem er A so aktualisiert, dass es auf C und dann auf D verweist.
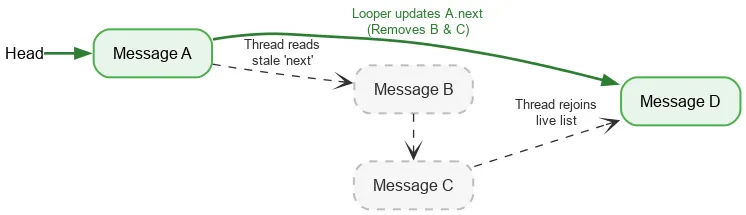
Obwohl B und C logisch entfernt wurden, behält B seinen nächsten Zeiger auf C und C auf D bei. Der Lesethread durchläuft weiterhin die entfernten Knoten und wird schließlich bei D wieder mit dem Live-Stack verbunden.
Da DeliQueue so konzipiert ist, dass es Konflikte zwischen dem Durchlaufen und dem Entfernen von Elementen verarbeiten kann, ist eine sichere, sperrenfreie Iteration möglich.
Beenden: Native refcount
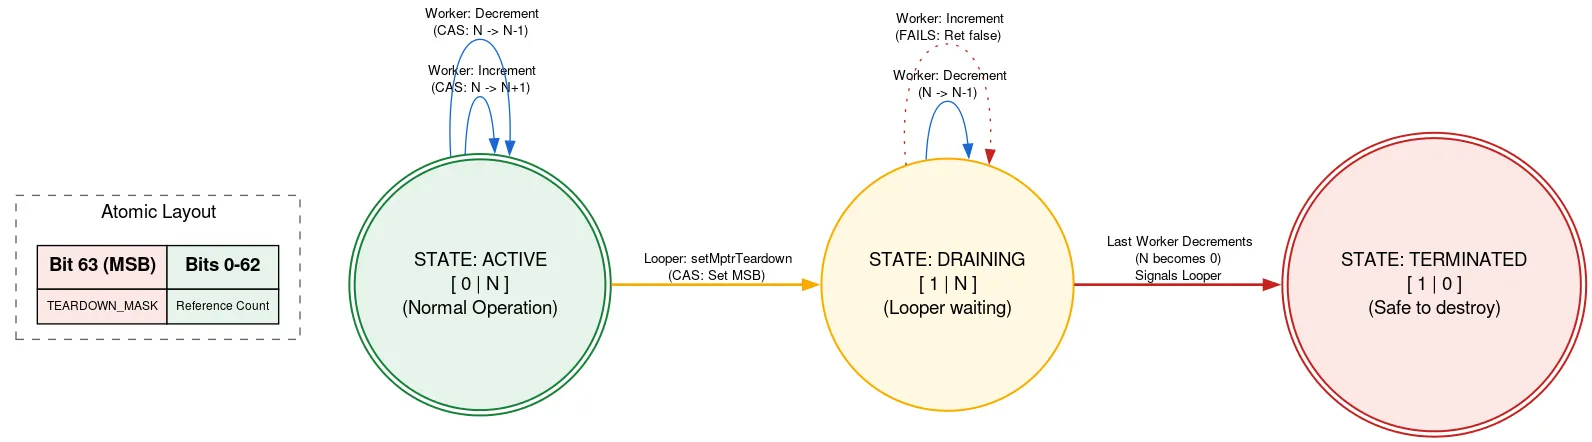
Looper wird durch eine native Zuweisung unterstützt, die manuell freigegeben werden muss, sobald Looper beendet wurde. Wenn ein anderer Thread Messages hinzufügt, während die Looper beendet wird, kann die native Zuweisung nach der Freigabe verwendet werden, was eine Verletzung der Speichersicherheit darstellt. Wir verhindern dies mithilfe eines getaggten Referenzzählers, bei dem ein Bit des Atomvorgangs verwendet wird, um anzugeben, ob Looper beendet wird.
Vor der Verwendung der nativen Zuweisung liest ein Thread den atomaren Referenzzähler. Wenn das Beenden-Bit gesetzt ist, wird zurückgegeben, dass Looper beendet wird und die native Zuweisung nicht verwendet werden darf. Andernfalls wird versucht, die Anzahl der aktiven Threads mithilfe der nativen Zuweisung zu erhöhen. Nachdem die erforderlichen Schritte ausgeführt wurden, wird der Zähler dekrementiert. Wenn das Beenden-Bit nach der Erhöhung, aber vor der Verringerung festgelegt wurde und die Anzahl jetzt null ist, wird der Looper-Thread reaktiviert.
Wenn der Thread Looper beendet werden kann, wird das Beendigungsbit im atomaren Wert mit CAS festgelegt. Wenn der Referenzzähler 0 war, kann die native Zuweisung freigegeben werden. Andernfalls wird er geparkt und erst wieder aktiviert, wenn der letzte Nutzer der nativen Zuweisung den Referenzzähler verringert. Bei diesem Ansatz wartet der Looper-Thread auf den Fortschritt anderer Threads, aber nur, wenn er beendet wird. Das passiert nur einmal und ist nicht leistungskritisch. Der andere Code für die Verwendung der nativen Zuweisung bleibt vollständig sperrfrei.
Die Implementierung ist komplex und es gibt viele weitere Tricks. Weitere Informationen zu DeliQueue finden Sie im Quellcode.
Optimierung: Programmierung ohne Verzweigungen
Während der Entwicklung und des Testens von DeliQueue hat das Team viele Benchmarks durchgeführt und den neuen Code sorgfältig profiliert. Ein Problem, das mit dem Tool „simpleperf“ erkannt wurde, waren Pipeline-Flushes, die durch den Message-Vergleichscode verursacht wurden.
Ein Standardkomparator verwendet bedingte Sprünge. Die Bedingung für die Entscheidung, welches Message zuerst kommt, ist unten vereinfacht dargestellt:
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    if (m1 == m2) {
        return 0;
    }

    // Primary queue order is by when.
    // Messages with an earlier when should come first in the queue.
    final long whenDiff = m1.when - m2.when;
    if (whenDiff > 0) return 1;
    if (whenDiff < 0) return -1;

    // Secondary queue order is by insert sequence.
    // If two messages were inserted with the same `when`, the one inserted
    // first should come first in the queue.
    final long insertSeqDiff = m1.insertSeq - m2.insertSeq;
    if (insertSeqDiff > 0) return 1;
    if (insertSeqDiff < 0) return -1;

    return 0;
}
Dieser Code wird zu bedingten Sprüngen (b.le- und cbnz-Anweisungen) kompiliert. Wenn die CPU auf eine bedingte Verzweigung stößt, kann sie erst wissen, ob die Verzweigung genommen wird, wenn die Bedingung berechnet wurde. Sie weiß also nicht, welche Anweisung als Nächstes gelesen werden soll, und muss raten. Dazu verwendet sie eine Technik namens Verzweigungsvorhersage. In einem Fall wie der binären Suche ist die Verzweigungsrichtung bei jedem Schritt unvorhersehbar unterschiedlich, sodass wahrscheinlich die Hälfte der Vorhersagen falsch ist. Die Sprungvorhersage ist bei Such- und Sortieralgorithmen (z. B. bei einem Min-Heap) oft ineffektiv, da die Kosten für eine falsche Vorhersage höher sind als die Verbesserung durch eine richtige Vorhersage. Wenn die Verzweigungsvorhersage falsch liegt, muss sie die Arbeit verwerfen, die sie nach der Annahme des vorhergesagten Werts geleistet hat, und noch einmal mit dem tatsächlich eingeschlagenen Pfad beginnen. Das wird als Pipeline-Flush bezeichnet.
Um dieses Problem zu finden, haben wir unsere Benchmarks mit dem Leistungszähler branch-misses profiliert, der Stacktraces aufzeichnet, bei denen die Verzweigungsvorhersage falsch ist. Anschließend haben wir die Ergebnisse mit Google pprof visualisiert, wie unten dargestellt:
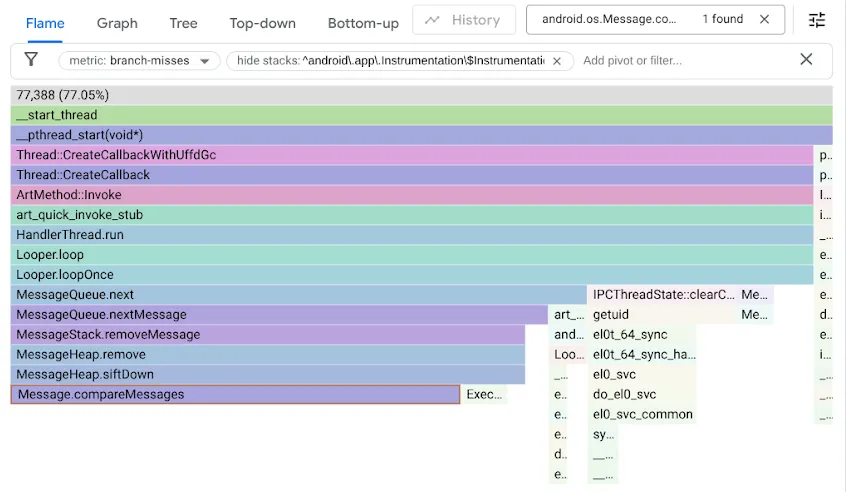
Der ursprüngliche MessageQueue-Code verwendete eine einfach verkettete Liste für die geordnete Warteschlange. Beim Einfügen wird die Liste in sortierter Reihenfolge als lineare Suche durchlaufen. Dabei wird beim ersten Element angehalten, das sich hinter dem Einfügepunkt befindet, und das neue Message davor verknüpft. Um den Kopf zu entfernen, musste nur die Verknüpfung aufgehoben werden. DeliQueue verwendet einen Min-Heap, bei dem Mutationen das Umsortieren einiger Elemente (Sifting up oder down) mit logarithmischer Komplexität in einer ausgeglichenen Datenstruktur erfordern, in der jede Vergleichsoperation mit gleicher Wahrscheinlichkeit den Durchlauf zu einem linken oder rechten untergeordneten Element lenkt. Der neue Algorithmus ist asymptotisch schneller, aber es gibt einen neuen Engpass, da der Suchcode die Hälfte der Zeit bei Verzweigungsfehlern hängen bleibt.
Als wir feststellten, dass Branch-Misses unseren Heap-Code verlangsamten, optimierten wir den Code mithilfe von branchloser Programmierung:
// Branchless Logic
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    final long when1 = m1.when;
    final long when2 = m2.when;
    final long insertSeq1 = m1.insertSeq;
    final long insertSeq2 = m2.insertSeq;

    // signum returns the sign (-1, 0, 1) of the argument,
    // and is implemented as pure arithmetic:
    // ((num >> 63) | (-num >>> 63))
    final int whenSign = Long.signum(when1 - when2);
    final int insertSeqSign = Long.signum(insertSeq1 - insertSeq2);

    // whenSign takes precedence over insertSeqSign,
    // so the formula below is such that insertSeqSign only matters
    // as a tie-breaker if whenSign is 0.
    return whenSign * 2 + insertSeqSign;
}
Um die Optimierung zu verstehen, disassemblieren Sie die beiden Beispiele im Compiler Explorer und verwenden Sie LLVM-MCA, einen CPU-Simulator, der eine geschätzte Zeitachse der CPU-Zyklen generieren kann.
The original code:
Index     01234567890123
[0,0]     DeER .    .  .   sub  x0, x2, x3
[0,1]     D=eER.    .  .   cmp  x0, #0
[0,2]     D==eER    .  .   cset w0, ne
[0,3]     .D==eER   .  .   cneg w0, w0, lt
[0,4]     .D===eER  .  .   cmp  w0, #0
[0,5]     .D====eER .  .   b.le #12
[0,6]     . DeE---R .  .   mov  w1, #1
[0,7]     . DeE---R .  .   b    #48
[0,8]     . D==eE-R .  .   tbz  w0, #31, #12
[0,9]     .  DeE--R .  .   mov  w1, #-1
[0,10]    .  DeE--R .  .   b    #36
[0,11]    .  D=eE-R .  .   sub  x0, x4, x5
[0,12]    .   D=eER .  .   cmp  x0, #0
[0,13]    .   D==eER.  .   cset w0, ne
[0,14]    .   D===eER  .   cneg w0, w0, lt
[0,15]    .    D===eER .   cmp  w0, #0
[0,16]    .    D====eER.   csetm        w1, lt
[0,17]    .    D===eE-R.   cmp  w0, #0
[0,18]    .    .D===eER.   csinc        w1, w1, wzr, le
[0,19]    .    .D====eER   mov  x0, x1
[0,20]    .    .DeE----R   ret
Beachten Sie den bedingten Zweig b.le, der den Vergleich der insertSeq-Felder vermeidet, wenn das Ergebnis bereits aus dem Vergleich der when-Felder bekannt ist.
The branchless code:
Index     012345678
[0,0]     DeER .  .   sub       x0, x2, x3
[0,1]     DeER .  .   sub       x1, x4, x5
[0,2]     D=eER.  .   cmp       x0, #0
[0,3]     .D=eER  .   cset      w0, ne
[0,4]     .D==eER .   cneg      w0, w0, lt
[0,5]     .DeE--R .   cmp       x1, #0
[0,6]     . DeE-R .   cset      w1, ne
[0,7]     . D=eER .   cneg      w1, w1, lt
[0,8]     . D==eeER   add       w0, w1, w0, lsl #1
[0,9]     .  DeE--R   ret
Hier benötigt die verzweigungslose Implementierung weniger Zyklen und Anweisungen als selbst der kürzeste Pfad durch den verzweigten Code – sie ist in allen Fällen besser. Die schnellere Implementierung und die Eliminierung falsch vorhergesagter Verzweigungen führten in einigen unserer Benchmarks zu einer fünffachen Verbesserung.
Diese Methode ist jedoch nicht immer anwendbar. Bei branchlosen Ansätzen ist in der Regel Arbeit erforderlich, die verworfen wird. Wenn die Verzweigung die meiste Zeit vorhersagbar ist, kann diese verschwendete Arbeit Ihren Code verlangsamen. Außerdem führt das Entfernen eines Zweigs häufig zu einer Datenabhängigkeit. Moderne CPUs führen mehrere Vorgänge pro Zyklus aus, können eine Anweisung jedoch erst ausführen, wenn die Eingaben aus einer vorherigen Anweisung bereit sind. Im Gegensatz dazu kann eine CPU über Daten in Verzweigungen spekulieren und vorarbeiten, wenn eine Verzweigung richtig vorhergesagt wird.
Testen und Validieren
Die Korrektheit von sperrenfreien Algorithmen zu überprüfen, ist bekanntermaßen schwierig.
Zusätzlich zu den Standard-Unittests für die kontinuierliche Validierung während der Entwicklung haben wir auch strenge Stresstests geschrieben, um Warteschlangeninvarianten zu überprüfen und zu versuchen, Datenrennen zu induzieren, falls sie vorhanden sind. In unseren Testlaboren konnten wir Millionen von Testinstanzen auf emulierten Geräten und auf echter Hardware ausführen.
Mit der Instrumentierung von Java ThreadSanitizer (JTSan) können wir dieselben Tests verwenden, um auch einige Race Conditions in unserem Code zu erkennen. JTSan hat in DeliQueue keine problematischen Datenrennen gefunden, aber überraschenderweise zwei Nebenläufigkeitsfehler im Robolectric-Framework erkannt, die wir umgehend behoben haben.
Um die Fehlerbehebung zu verbessern, haben wir neue Analysetools entwickelt. Unten sehen Sie ein Beispiel für ein Problem im Android-Plattformcode, bei dem ein Thread einen anderen Thread mit Message überlastet, was zu einem großen Rückstand führt, der in Perfetto dank der von uns hinzugefügten Instrumentierungsfunktion MessageQueue sichtbar ist.
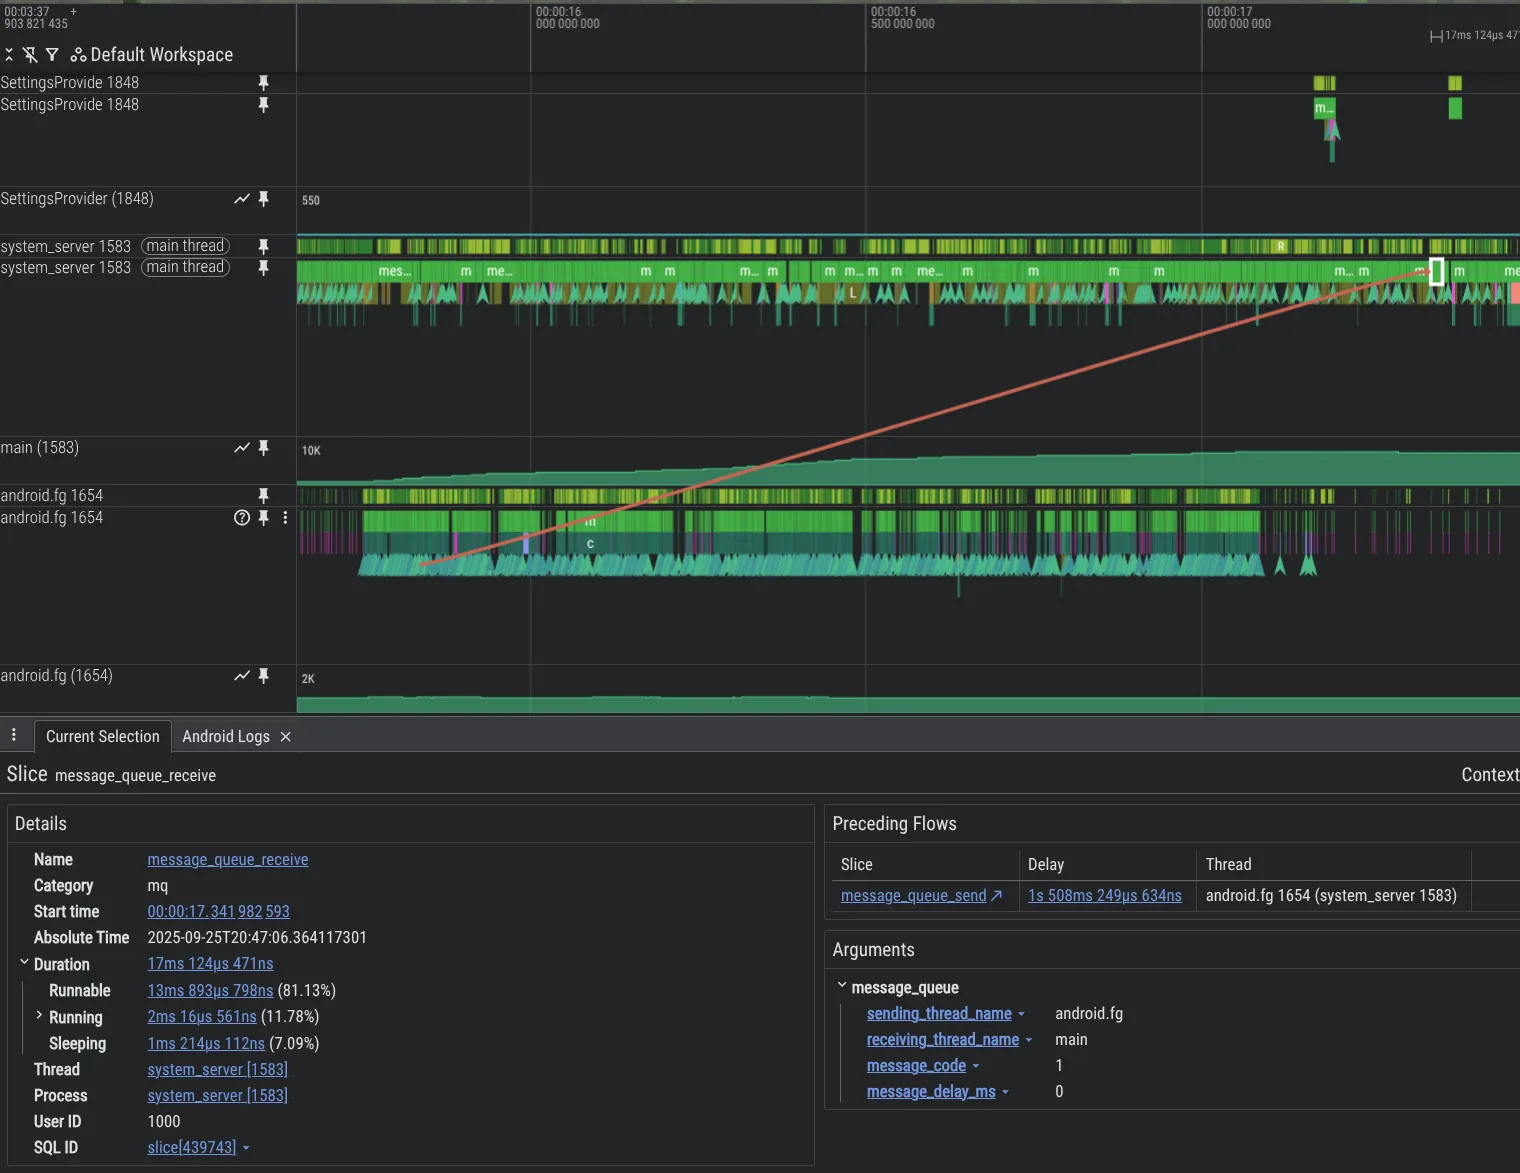
Wenn Sie das MessageQueue-Tracing im system_server-Prozess aktivieren möchten, fügen Sie Folgendes in Ihre Perfetto-Konfiguration ein:
data_sources {
  config {
    name: "track_event"
    target_buffer: 0  # Change this per your buffers configuration
    track_event_config {
      enabled_categories: "mq"
    }
  }
}
Auswirkungen
DeliQueue verbessert die System- und App-Leistung, indem Sperren aus MessageQueue entfernt werden.
- Synthetische Benchmarks:Das Einfügen von Multithreads in ausgelastete Warteschlangen ist dank verbesserter Parallelität (Treiber-Stack) und schnellerem Einfügen (Min-Heap) bis zu 5.000-mal schneller als bei der alten
MessageQueue. - In Perfetto-Traces, die von internen Betatestern erfasst wurden, sehen wir eine Reduzierung der Zeit, die der Hauptthread der App in der Sperrkonkurrenz verbringt, um 15 %.
- Auf denselben Testgeräten führt die reduzierte Sperrkonkurrenz zu erheblichen Verbesserungen der Nutzerfreundlichkeit, z. B.:
- -4% verpasste Frames in Apps.
- –7,7% verpasste Frames bei Interaktionen mit der System-UI und dem Launcher
- -9,1 % bei der Zeit vom App-Start bis zum ersten gezeichneten Frame, im 95.Perzentil.
Weiteres Vorgehen
DeliQueue wird in Android 17 für Apps eingeführt. App-Entwickler sollten sich den Artikel „Preparing your app for the new lock-free MessageQueue“ im Blog für Android-Entwickler ansehen, um zu erfahren, wie sie ihre Apps testen können.
Verweise
[1] Treiber, R.K., 1986. Systemprogrammierung: Umgang mit Parallelität. International Business Machines Incorporated, Thomas J. Watson Research Center.
[2] Goetz, B., Peierls, T., Bloch, J., Bowbeer, J., Holmes, D., & Lea, D. (2006). Java Concurrency in Practice. Addison-Wesley Professional.
-
 Produktneuigkeiten
Heute haben wir euch gezeigt, wie wir unsere Vision „Mehr als nur ein Store“ weiterentwickeln. Der Tab „Mein Play“ ist die persönliche Anlaufstelle für über 250 Millionen monatlich aktive Nutzer. Unsere einheitliche Gaming-Plattform verbindet über 700 Millionen Spielerprofile. Google Play ist überall für Nutzer verfügbar.
Paul Feng • Lesezeit: 3 Minuten -
 Produktneuigkeiten
Als Android-Entwickler haben Sie viele Möglichkeiten, wenn es um die Agenten, LLMs, Tools und Befehlszeilen (CLI) geht, die Sie für die App-Entwicklung verwenden. Unser Ziel ist es, Sie bei der Entwicklung ansprechender, hochwertiger Android-Apps zu unterstützen, unabhängig davon, wie Sie sie entwickeln.
Simona Milanovic • Lesezeit: 4 Minuten -
 Produktneuigkeiten
Wir erweitern unsere Abo-Plattform auf Google Play kontinuierlich, damit Sie Ihren Umsatz steigern, sich an neue Geschäftsmodelle anpassen und Ihre Nutzer dort erreichen können, wo sie sich gerade befinden.
Sheenam Mittal • Lesezeit: 4 Minuten
Lassen Sie sich Woche für Woche die neuesten Informationen zur Android-Entwicklung zusenden.