Android Bench 2.0: przesuwanie granic dzięki wymagającym, długofalowym zadaniom
Czas czytania: 3 min
Gdy po raz pierwszy wprowadziliśmy Android Bench, stworzyliśmy solidne podstawy do oceny, jak duże modele językowe (LLM) pomagają deweloperom w realizacji rzeczywistych zadań na Androidzie. W miarę szybkiego rozwoju modeli i agentów AI aktualizujemy naszą metodologię, np. dostosowujemy nasze testy porównawcze do platformy Harbor. Dzisiaj udostępniamy pierwszy zestaw zadań długofalowych (LHT), które są bardzo złożone i wymagają od inżyniera kilku dni, a nawet tygodnia pracy. Wprowadzamy też ocenę agentów, zaczynając od agentów od odpowiednich dostawców modeli. Dzięki temu powstał Android Bench 2.0 – ulepszony zestaw testów, który pozwala oceniać modele AI i agenty pod kątem skali, niejednoznaczności i złożoności wieloetapowego rozwiązywania problemów, z którymi mierzysz się na co dzień.
Od drobnych poprawek po długofalowe zadania
Pierwsza wersja Android Bench, podobnie jak inne wczesne testy porównawcze kodowania AI, skupiała się na przyrostowych zmianach w istniejących repozytoriach, w wielu przypadkach ograniczonych do poprawek błędów lub mniejszych próśb o dodanie funkcji. Było to odzwierciedleniem możliwości pomocy AI w danym momencie, a także sposobu, w jaki z niej korzystano.
Aby nadal pomagać Ci w znajdowaniu modeli i agentów kodowania najlepiej dopasowanych do Twojego procesu programowania, podnieśliśmy poprzeczkę naszych ocen, aby odpowiadały pracy, którą zlecasz AI. Android Bench 2.0 odzwierciedla te ambitne wyzwania za pomocą zadań LHT, które obejmują uaktualnianie zależności, dodawanie nowych funkcji, tworzenie aplikacji od podstaw lub konwertowanie aplikacji na wielu platformach na Androida.
Złożone zadania wymagają bardziej szczegółowej oceny i punktacji.
W przypadku wielodniowych zadań inżynieryjnych ocena binarna (zaliczone lub niezaliczone) nie daje pełnego obrazu.
Agent może na przykład przekształcić 40 ekranów w Jetpack Compose, skonfigurować tabele bazy danych i spełnić 90% wymagań, ale nie zaliczyć pojedynczej asercji w przypadku skrajnym. Ocena binarna ocenia ten wynik na 0%, co ukrywa możliwości architektoniczne modelu. Przechodzimy na ciągłą ocenę, aby zapewnić bardziej przydatne informacje zarówno na potrzeby rozwoju modelu, jak i zrozumienia, jak AI może Ci pomóc.
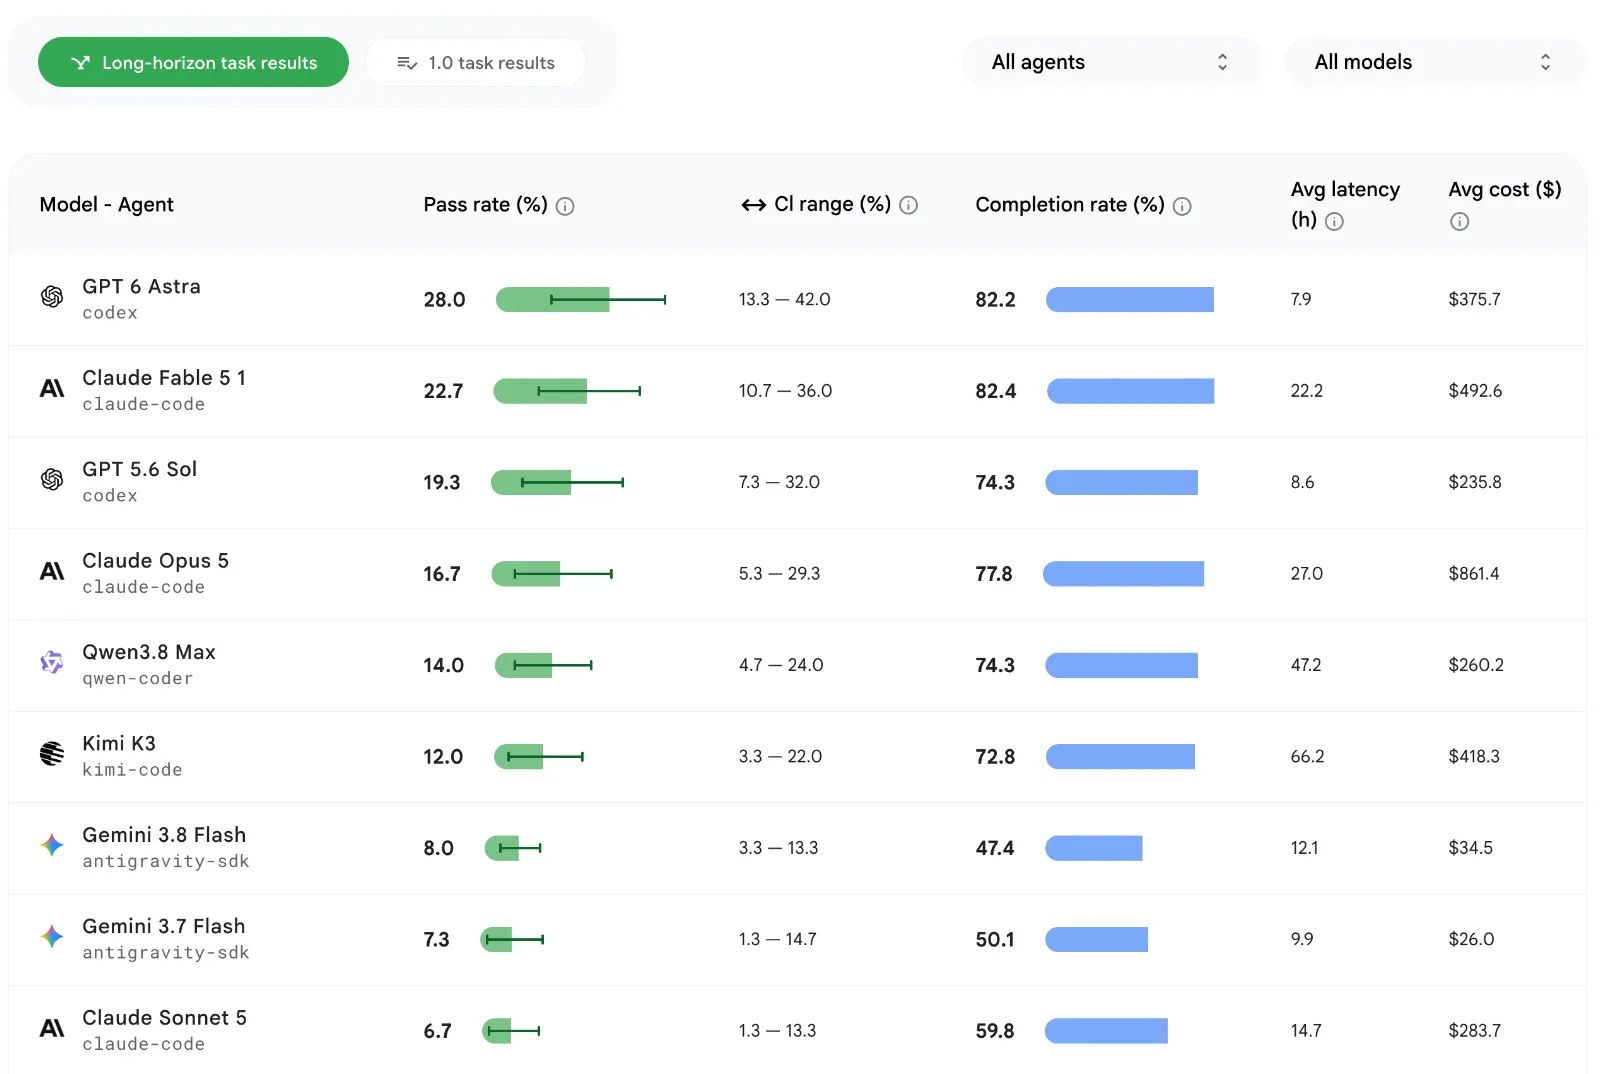
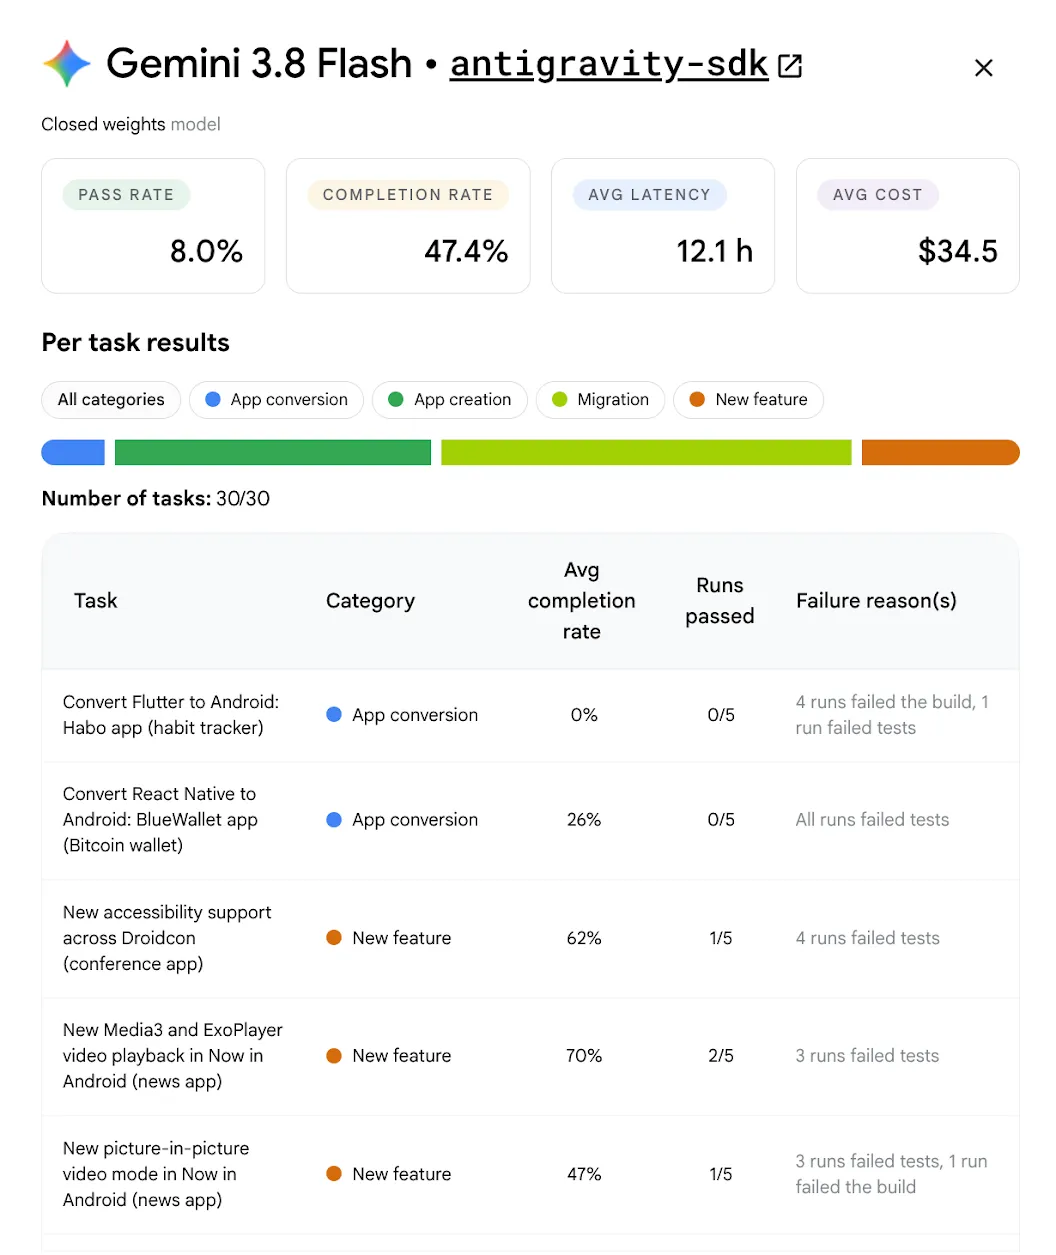
Współczynnik ukończenia obliczamy na podstawie różnych czynników, takich jak funkcjonalność, wierność wizualna i unikanie regresji. Stosujemy też obiektywne kary punktowe za odstępstwa od instrukcji oceny lub ograniczeń strukturalnych. Sprawdź zaktualizowaną tabelę wyników i kliknij widok karty każdego modelu, aby zobaczyć dodatkowe elementy, takie jak współczynnik pozytywnych wyników, współczynnik realizacji i średnie koszty na model i na zadanie.
Najwyższy wskaźnik zdawalności w przypadku zadań LHT wynosi około 28%, czyli znacznie mniej niż około 91% w przypadku pierwotnych zadań w teście porównawczym.
Długofalowe zadania pozwalają uzyskać pomocne statystyki dotyczące pomocy AI
Oprócz pomiaru skuteczności AI w przypadku długotrwałych zadań zbiór danych LHT pomaga nam dowiedzieć się więcej o mocnych i słabych stronach testowanych modeli, dzięki czemu możemy oferować bardziej praktyczne wskazówki.
We wszystkich poziomach modeli AI lepiej radzi sobie z pisaniem nowego kodu niż z refaktoryzacją istniejącego. Refaktoryzacja i migracja stają się trudniejsze, ponieważ sukces zależy od złożoności architektury, a nie od ilości kodu.
Modele wykazują duże możliwości w zakresie dobrze ugruntowanych, deterministycznych przekształceń, takich jak konwersja Javy na Kotlina, zamiana Retrofit na Ktor czy wprowadzenie warstwy ViewModel. Stosują te wzorce konsekwentnie, nawet w ponad 125 plikach i 8000 wierszach kodu.
Modele mają jednak trudności, gdy zadania wymagają weryfikacji w czasie działania (np. brakujące wykresy wstrzykiwania zależności), obejmują zmiany w środowisku, które powodują błędy, lub napotykają luki w wiedzy dotyczące nieopublikowanych bibliotek. Przenoszenie aplikacji na wiele platform na Androida pozostaje otwartym wyzwaniem – żaden model nie osiąga 100% skuteczności, a modele graniczne osiągają maksymalnie 80% współczynnika realizacji.
Przedstawiamy oceny agentów
Aby pomóc Ci lepiej zrozumieć, jak modele działają po zintegrowaniu z przepływami pracy opartymi na agentach, dodajemy do naszej oceny powszechnie używane agenty. Zaczynamy od uruchomienia nowych modeli w LHT z agentami od odpowiedniego dostawcy modelu. Na przykład uruchomiliśmy GPT 5.6 Sol na Codex, a Gemini 3.8 Flash na Google Antigravity. To połączenie pokazuje, jak projekt platformy pozytywnie wpływa na wyniki deweloperów, ponieważ buforowanie promptów i kompaktowe okno narzędzia mogą prowadzić do zmniejszenia liczby tokenów.
W przyszłości rozszerzymy tę funkcję, aby wyróżniać wyniki w różnych kombinacjach modeli i agentów, co pomoże Ci odkryć, które kombinacje najlepiej sprawdzają się w przypadku Ciebie i Twojego zespołu.
Inwestujemy w te pomiary, ponieważ ważne jest, aby można było używać wybranego agenta i modelu do tworzenia aplikacji na Androida. W najbliższych tygodniach podamy więcej informacji.
Dodaliśmy nowe modele
Nadal rozwijamy też naszą tabelę wyników, aby zapewnić Ci dostęp do najbardziej aktualnych danych, które pomogą Ci podejmować decyzje dotyczące rozwoju. Dodaliśmy modele Gemini 3.8 Flash, Gemini 3.7 Flash, GPT-6 od OpenAI, Fable 5.1 od Anthropic, Kimi K3 i Qwen 3.8 Max. Na pierwszym miejscu znalazł się model GPT-6 Astra od OpenAI ze wskaźnikiem zaliczenia na poziomie 28%.
Perspektywy
Android Bench 2.0 zapewnia solidne środowisko do pomiaru AI na potrzeby programowania na Androida. Mamy nadzieję, że dzięki połączeniu długofalowych zadań, oceny multimodalnej, agentów i ciągłej oceny zespoły badawcze AI będą mogły tworzyć bardziej wydajnych i niezawodnych partnerów do kodowania AI, a użytkownicy zyskają większą przejrzystość w zakresie opcji rozwoju AI.
Zapoznaj się ze zaktualizowaną tabelą wyników i zaktualizowaną metodologią. Twoja opinia ma bezpośredni wpływ na to, jak rozwijamy Android Bench, dlatego prosimy o dalsze dzielenie się z nami swoimi spostrzeżeniami na GitHubie oraz w naszych kanałach społecznościowych, takich jak X i LinkedIn.
-
 Wiadomości o usłudze
Dzisiaj, podczas Android Dev Summit, ogłaszamy szeroką dostępność wielu narzędzi i interfejsów API, które mają na celu usunięcie codziennych problemów i zapewnienie większej elastyczności podczas tworzenia świetnych aplikacji na Androida.
Matthew McCullough • Czas czytania: 4 min -
 Wiadomości o usłudze
W miarę jak rozwój agentów przyspiesza, inżynieria Androida osiąga nowy, ekscytujący etap: przechodzi od wspomagającego uzupełniania kodu do agentów wykonujących kompleksowe zadania pod Twoim kierunkiem. Masz pełną swobodę i elastyczność w wyborze modeli i agentów, których używasz.
Jason Buchel • Czas czytania: 3 min -

 Wiadomości o usłudze
Deweloperzy aplikacji na Androida mają do wyboru wiele opcji, jeśli chodzi o agenty, LLM, narzędzia i interfejsy wiersza poleceń (CLI) używane do tworzenia aplikacji. Naszym celem jest pomaganie Ci w tworzeniu pięknych, wysokiej jakości aplikacji na Androida, niezależnie od tego, jak je tworzysz.
Simona Milanovic • Czas czytania: 4 min
Otrzymuj co tydzień najnowsze informacje o tworzeniu aplikacji na Androida na swoją skrzynkę odbiorczą.