Cara Pengoptimalan Perintah Otomatis Meningkatkan Kualitas untuk Prompt API GenAI ML Kit
Waktu baca: 3 menit
Pengoptimalan Perintah Otomatis (APO)
Untuk membantu menghadirkan kasus penggunaan Prompt API ML Kit Anda ke produksi, kami dengan senang hati mengumumkan Pengoptimalan Perintah Otomatis (APO) yang menargetkan model Di Perangkat di Vertex AI. Pengoptimalan Perintah Otomatis adalah alat yang membantu Anda menemukan perintah yang optimal untuk kasus penggunaan Anda secara otomatis.
Era AI di Perangkat bukan lagi sekadar janji, melainkan kenyataan produksi. Dengan rilis Gemini Nano v3, kami menghadirkan kemampuan pemahaman bahasa dan multimodal yang belum pernah ada sebelumnya langsung ke genggaman pengguna. Melalui rangkaian model Gemini Nano, kami memiliki cakupan luas perangkat yang didukung di seluruh Ekosistem Android. Namun, bagi developer yang membangun aplikasi cerdas generasi berikutnya, akses ke model yang canggih hanyalah langkah pertama. Tantangan sebenarnya terletak pada penyesuaian: Bagaimana Anda menyesuaikan model dasar dengan performa tingkat pakar untuk kasus penggunaan spesifik Anda tanpa melanggar batasan hardware seluler?
Di sisi server, LLM yang lebih besar cenderung sangat mumpuni dan memerlukan lebih sedikit adaptasi domain. Bahkan saat diperlukan, opsi yang lebih canggih seperti penyesuaian LoRA (Low-Rank Adaptation) dapat menjadi opsi yang layak. Namun, arsitektur unik Android AICore memprioritaskan model sistem bersama yang hemat memori. Artinya, men-deploy adaptor LoRA kustom untuk setiap aplikasi akan menimbulkan tantangan pada layanan sistem bersama ini.
Namun, ada jalur alternatif yang dapat memberikan dampak yang sama. Dengan memanfaatkan Pengoptimalan Perintah Otomatis (APO) di Vertex AI, developer dapat mencapai kualitas yang mendekati fine-tuning, sekaligus bekerja dengan lancar dalam lingkungan eksekusi Android native. Dengan berfokus pada petunjuk sistem yang unggul, APO memungkinkan developer menyesuaikan perilaku model dengan ketahanan dan skalabilitas yang lebih besar daripada solusi fine-tuning tradisional.
Catatan: Gemini Nano V3 adalah versi yang dioptimalkan kualitasnya dari model Gemma 3N yang sangat diakui. Setiap pengoptimalan perintah yang dilakukan pada model Gemma 3N open source juga akan berlaku untuk Gemini Nano V3. Di perangkat yang didukung, API GenAI ML Kit memanfaatkan model nano-v3 untuk memaksimalkan kualitas bagi Developer Android
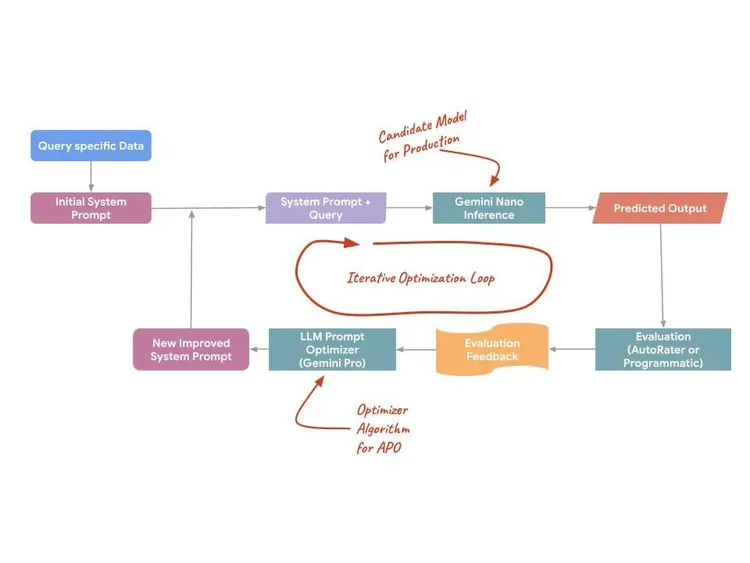
APO memperlakukan perintah bukan sebagai teks statis, melainkan sebagai platform yang dapat diprogram dan dioptimalkan. Fitur ini memanfaatkan model sisi server (seperti Gemini Pro dan Flash) untuk mengusulkan perintah, mengevaluasi variasi, dan menemukan perintah yang optimal untuk tugas spesifik Anda. Proses ini menggunakan tiga mekanisme teknis khusus untuk memaksimalkan performa:
- Analisis Error Otomatis: APO menganalisis pola error dari data pelatihan untuk mengidentifikasi kelemahan tertentu dalam perintah awal secara otomatis.
- Semantic Instruction Distillation: Teknik ini menganalisis contoh pelatihan dalam jumlah besar untuk menyaring "maksud sebenarnya" dari suatu tugas, sehingga menghasilkan petunjuk yang lebih akurat mencerminkan distribusi data yang sebenarnya.
- Pengujian Kandidat Paralel: Alih-alih menguji satu ide dalam satu waktu, APO membuat dan menguji banyak kandidat perintah secara paralel untuk mengidentifikasi kualitas maksimum global.
Mengapa APO Dapat Mendekati Kualitas Fine-Tuning
Ada kesalahpahaman umum bahwa fine-tuning selalu memberikan kualitas yang lebih baik daripada prompting. Untuk model dasar modern seperti Gemini Nano v3, rekayasa perintah dapat memberikan dampak yang signifikan:
- Mempertahankan kemampuan Umum: Fine-tuning ( PEFT/LoRA) memaksa bobot model untuk mengindeks secara berlebihan pada distribusi data tertentu. Hal ini sering menyebabkan "catastrophic forgetting", yaitu kondisi saat model menjadi lebih baik dalam sintaksis spesifik Anda, tetapi lebih buruk dalam logika dan keamanan umum. APO tidak mengubah bobot, sehingga mempertahankan kemampuan model dasar.
- Pemahaman Perintah & Penemuan Strategi: Gemini Nano v3 telah dilatih secara ketat untuk mengikuti petunjuk sistem yang kompleks. APO memanfaatkan hal ini dengan menemukan struktur petunjuk yang tepat untuk membuka kemampuan laten model, yang sering kali menemukan strategi yang mungkin sulit ditemukan oleh engineer manusia.
Untuk memvalidasi pendekatan ini, kami mengevaluasi APO di berbagai workload produksi. Validasi kami telah menunjukkan peningkatan akurasi sebesar 5-8% yang konsisten di berbagai kasus penggunaan.Di beberapa fitur di perangkat yang di-deploy, APO memberikan peningkatan kualitas yang signifikan.
| Kasus Penggunaan | Jenis Tugas | Deskripsi Tugas | Metrik | Peningkatan APO |
| Klasifikasi topik | Klasifikasi teks | Mengklasifikasikan artikel berita ke dalam topik seperti keuangan, olahraga, dll. | Akurasi | +5% |
| Klasifikasi niat | Klasifikasi teks | Mengklasifikasikan kueri layanan pelanggan ke dalam intent | Akurasi | +8,0% |
| Terjemahan halaman web | Penerjemahan teks | Menerjemahkan halaman web dari bahasa Inggris ke bahasa lokal | BLEU | +8,57% |
Alur Kerja Developer yang Lancar dan Menyeluruh
Ada kesalahpahaman umum bahwa fine-tuning selalu memberikan kualitas yang lebih baik daripada prompting. Untuk model dasar modern seperti Gemini Nano v3, rekayasa perintah dapat memberikan dampak yang signifikan:
- Mempertahankan kemampuan Umum: Fine-tuning ( PEFT/LoRA) memaksa bobot model untuk mengindeks secara berlebihan pada distribusi data tertentu. Hal ini sering menyebabkan "catastrophic forgetting", yaitu kondisi saat model menjadi lebih baik dalam sintaksis spesifik Anda, tetapi lebih buruk dalam logika dan keamanan umum. APO tidak mengubah bobot, sehingga mempertahankan kemampuan model dasar.
- Pemahaman Perintah & Penemuan Strategi: Gemini Nano v3 telah dilatih secara ketat untuk mengikuti petunjuk sistem yang kompleks. APO memanfaatkan hal ini dengan menemukan struktur petunjuk yang tepat untuk membuka kemampuan laten model, yang sering kali menemukan strategi yang mungkin sulit ditemukan oleh engineer manusia.
Untuk memvalidasi pendekatan ini, kami mengevaluasi APO di berbagai workload produksi. Validasi kami telah menunjukkan peningkatan akurasi sebesar 5-8% yang konsisten di berbagai kasus penggunaan.Di beberapa fitur di perangkat yang di-deploy, APO memberikan peningkatan kualitas yang signifikan.
Kesimpulan
Peluncuran Automated Prompt Optimization (APO) menandai titik balik untuk AI generatif di perangkat. Dengan menjembatani kesenjangan antara model dasar dan performa tingkat pakar, kami memberi developer alat untuk membangun aplikasi seluler yang lebih tangguh. Baik Anda baru memulai dengan Pengoptimalan Zero-Shot atau melakukan penskalaan ke produksi dengan penyempurnaan Berbasis Data, jalur menuju kecerdasan di perangkat yang berkualitas tinggi kini lebih jelas. Luncurkan kasus penggunaan di perangkat Anda ke produksi sekarang dengan Prompt API ML Kit dan Pengoptimalan Perintah Otomatis Vertex AI.
Link yang relevan:
-
 Berita Produk
Di Google, kami berkomitmen untuk menghadirkan model AI tercanggih langsung ke perangkat Android di saku Anda. Hari ini, kami dengan senang hati mengumumkan rilis model terbuka tercanggih terbaru kami: Gemma 4.
Caren Chang, David Chou • Waktu baca: 3 menit -
 Berita Produk
AI mempermudah pembuatan pengalaman aplikasi yang dipersonalisasi yang mengubah konten menjadi format yang tepat bagi pengguna. Sebelumnya, kami memungkinkan developer untuk berintegrasi dengan Gemini Nano melalui API GenAI ML Kit yang disesuaikan untuk kasus penggunaan tertentu seperti pembuatan ringkasan dan deskripsi gambar.
Caren Chang, Chengji Yan, Penny Li • Waktu baca: 2 menit -
 Berita Produk
Hari ini, di Android Dev Summit, kami mengumumkan ketersediaan luas berbagai alat dan API yang dirancang untuk menghilangkan hambatan sehari-hari dan memberi Anda lebih banyak fleksibilitas untuk membuat aplikasi Android yang hebat.
Matthew McCullough • Waktu baca: 4 menit
Dapatkan insight pengembangan Android terbaru yang dikirim ke kotak masuk Anda setiap minggu.