Evolución de la medición de LLM para Android: la nueva era de Android Bench
Lectura de 3 min

En marzo, presentamos Android Bench, nuestra tabla de clasificación de LLM para tareas de desarrollo de Android del mundo real. Nuestro objetivo era brindar transparencia sobre las capacidades de los modelos en el desarrollo de Android y fomentar las mejoras en los modelos para ofrecerte opciones de IA más útiles para tu flujo de trabajo diario. Desde entonces, mejoramos la comparativa según tus comentarios, lo que incluye la evaluación de modelos de peso abierto y la incorporación de dimensiones de costo y eficiencia al ranking.
Sin embargo, las capacidades de la IA evolucionan constantemente, y las mediciones deben hacer lo mismo. Como parte de nuestro lanzamiento de julio, adoptamos el framework de Harbor, que incluye una versión actualizada del agente de comparativas que se usa para evaluar modelos.
Junto con este cambio en nuestra evaluación, en esta versión de julio agregamos 8 modelos nuevos (Claude Fable 5, Claude Sonnet 5, Claude Opus 4.8, GLM 5.2, Kimi K2.7 Code, MiniMax M3, Qwen 3.7 Plus y Qwen 3.7 Max) a la tabla de clasificación. También compartiremos oportunidades para que tú, la comunidad de desarrolladores de Android, contribuyas a la comparativa.
Actualizamos nuestra metodología con el marco de trabajo de Harbor
Cuando diseñamos Android Bench, basamos nuestra metodología en los principales estándares de la industria disponibles en ese momento. Usamos mini-swe-agent v1, un agente de comparativas de uso general, y lo adaptamos a los matices del desarrollo para Android para proporcionar una medición de referencia de las capacidades de los modelos para las tareas comunes de desarrollo para Android.
Para seguir proporcionándote evaluaciones de vanguardia que midan con precisión las capacidades más recientes del modelo en el desarrollo de Android, estandarizaremos nuestra comparativa con el marco de trabajo Harbor. Harbor define estándares e integraciones que facilitan que cualquier persona ejecute la comparativa, evalúe su configuración preferida o comparta resultados, lo que te brinda mayor transparencia y visibilidad.
Esta actualización nos permite evaluar los modelos y sus capacidades de manera más rigurosa, y volvimos a ejecutar la comparativa en todos los modelos para establecer una referencia actualizada. Esto significa que habrá un pequeño cambio en la puntuación, pero aún podrás ver las puntuaciones históricas en el archivo de nuestro sitio web.
Queremos asegurarnos de que Android Bench te sea útil, por lo que lo actualizaremos continuamente a medida que maduren nuestras evaluaciones y la industria.
Ampliamos el ranking con 8 modelos nuevos
Como parte de nuestro compromiso de mantener actualizada la tabla de clasificación, agregamos Claude Fable 5, Claude Sonnet 5, Claude Opus 4.8, GLM 5.2, Kimi K2.7 Code, MiniMax M3, Qwen 3.7 Plus y Qwen 3.7 Max a la tabla de clasificación de Android Bench.
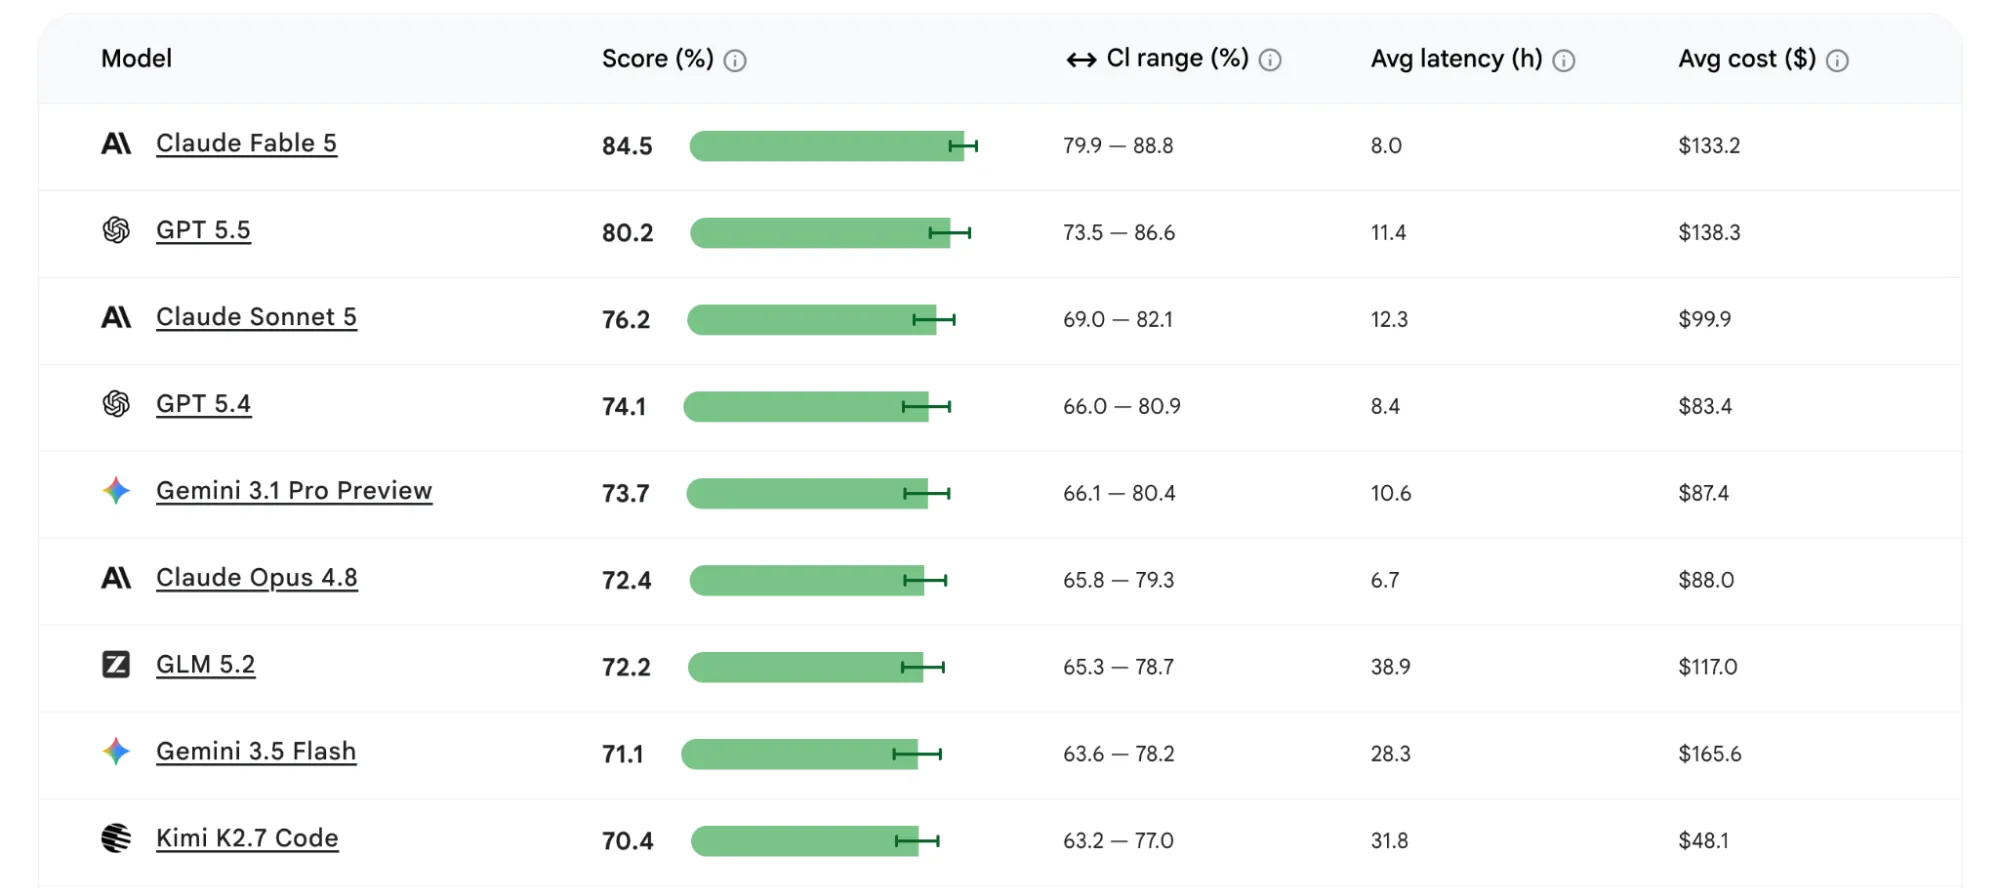
Verás que Claude Fable 5 está en la parte superior de la tabla de clasificación con una puntuación de 84.5, seguido de GPT 5.5 con 80.2 y Claude Sonnet 5 en el 3ᵉʳ lugar con una puntuación de 76.2.
Cuando solo se comparan los modelos de código abierto, GLM 5.2 ocupa el primer lugar con 72.2, seguido de Kimi K2.7 Code con una puntuación de 70.4.
Puedes consultar las métricas de rendimiento y eficiencia de los modelos en el ranking actualizado para ver cómo estos modelos nuevos y anteriores abordan los desafíos específicos de Android, como las migraciones de Jetpack Compose, las redes de dispositivos wearables y las actualizaciones de la API de la plataforma.
Apertura de Android Bench a las contribuciones de la comunidad
Desde el principio, valoramos un enfoque abierto y transparente, por lo que pusimos a disposición del público nuestra metodología original y nuestro banco de pruebas en GitHub. Nos pediste una forma de proporcionar comentarios sobre nuestro conjunto de datos, por lo que ahora llevamos la colaboración un paso más allá y les brindamos a ustedes, la comunidad de desarrolladores de Android, la oportunidad de darle forma a Android Bench.
A partir de hoy, puedes colaborar con Android Bench de dos maneras:
- Diseña y envía tus propias tareas de desarrollo para Android para evaluar cómo los modelos manejan las situaciones que te interesan.
- Ejecuta y comparte evaluaciones comparativas de primera mano, y prueba tus modelos preferidos con nuestro conjunto de datos o tus propias tareas personalizadas.
Revisaremos las tareas enviadas y evaluaremos si se agregarán a la comparativa. Esperamos crear un parámetro de referencia que refleje realmente las realidades diversas y cotidianas de la comunidad global de desarrolladores de Android.
Con la mirada puesta en el futuro
Con cada vez más opciones para el desarrollo de agentes, mantener una comparativa de vanguardia garantiza que la asistencia de IA en la que confías siga siendo más inteligente, útil y eficaz. Visita nuestro repositorio de GitHub para consultar las tareas. Te invitamos a enviar una tarea a nuestro equipo para que la revise. También puedes consultar Harbor Hub para explorar el conjunto de datos o enviar evaluaciones.
Como siempre, puedes consultar el ranking actualizado o leer la metodología en nuestro sitio web.
-

 Novedades del producto
Como desarrolladores de Android, tienen muchas opciones cuando se trata de los agentes, los LLMs, las herramientas y las interfaces de línea de comandos (CLI) que usan para el desarrollo de apps. Nuestro objetivo es ayudarte a crear apps para Android atractivas y de alta calidad, independientemente de cómo elijas desarrollarlas.
Simona Milanovic • Lectura de 4 min -
 Novedades del producto
El año pasado, Android Studio se abrió a cualquier modelo de IA. Hoy, damos el siguiente paso y presentamos la compatibilidad con los agentes de programación que elijas.
Matthew Warner • Lectura de 3 min -
 Novedades del producto
Hoy lanzamos el primer conjunto de tareas de largo alcance (LHT), que son tareas de gran complejidad que a un ingeniero le llevan varios días o incluso una semana completar. También presentamos la evaluación agentiva, que comienza con los agentes de los proveedores de modelos correspondientes.
Matthew McCullough • Lectura de 3 min
Recibe la información más reciente sobre el desarrollo de Android en tu bandeja de entrada todas las semanas.