Android Bench 2.0: Ampliamos los límites con tareas desafiantes a largo plazo
Lectura de 3 min

Cuando lanzamos Android Bench por primera vez, creamos una base rigurosa para evaluar cómo los modelos de lenguaje grandes (LLM) ayudan a los desarrolladores con tareas de Android del mundo real. A medida que los modelos y agentes de IA evolucionan rápidamente, actualizamos nuestra metodología, por ejemplo, alineando nuestro marco de referencia con el marco de Harbor. Hoy lanzamos el primer conjunto de tareas de largo horizonte (LHT), que son tareas de gran complejidad que a un ingeniero le llevan varios días o incluso una semana completar. También presentamos la evaluación agentiva, que comienza con los agentes de los proveedores de modelos correspondientes. Esta incorporación nos lleva a Android Bench 2.0, una actualización importante diseñada para evaluar modelos y agentes de IA en función de la escala, la ambigüedad y la resolución de problemas complejos de varios pasos que abordas todos los días.
Desde correcciones incrementales hasta tareas a largo plazo
La primera iteración de Android Bench, junto con otras comparativas de codificación con IA iniciales similares, se centró en los cambios incrementales en los repositorios existentes, en muchos casos limitados a correcciones de errores o solicitudes de funciones más pequeñas. Esto reflejaba las capacidades de la asistencia de IA en ese momento, así como la forma en que la usabas.
Para seguir ayudándote a encontrar los modelos y los agentes de programación más adecuados para tu flujo de trabajo de desarrollo, elevamos el nivel de nuestras evaluaciones para que coincidan con el trabajo que delegas en la IA. Android Bench 2.0 refleja estos ambiciosos desafíos con LHT que incluyen la actualización de dependencias, la adición de funciones nuevas, la compilación de apps desde cero o la conversión de una app multiplataforma a Android.
Las tareas complejas requieren una evaluación y una puntuación más detalladas
En las tareas de ingeniería de varios días, la calificación binaria de aprobado o reprobado no capta la imagen completa.
Por ejemplo, un agente podría refactorizar 40 pantallas a Jetpack Compose, configurar tablas de bases de datos y cumplir con el 90% de los requisitos, pero fallar en una sola aserción de caso límite. Las tasas de puntuación binaria de esta ejecución son del 0%, lo que oculta las capacidades arquitectónicas del modelo. Pasaremos a la puntuación continua para proporcionar un indicador más significativo, tanto para el desarrollo del modelo como para que comprendas cómo puede ayudarte la IA.
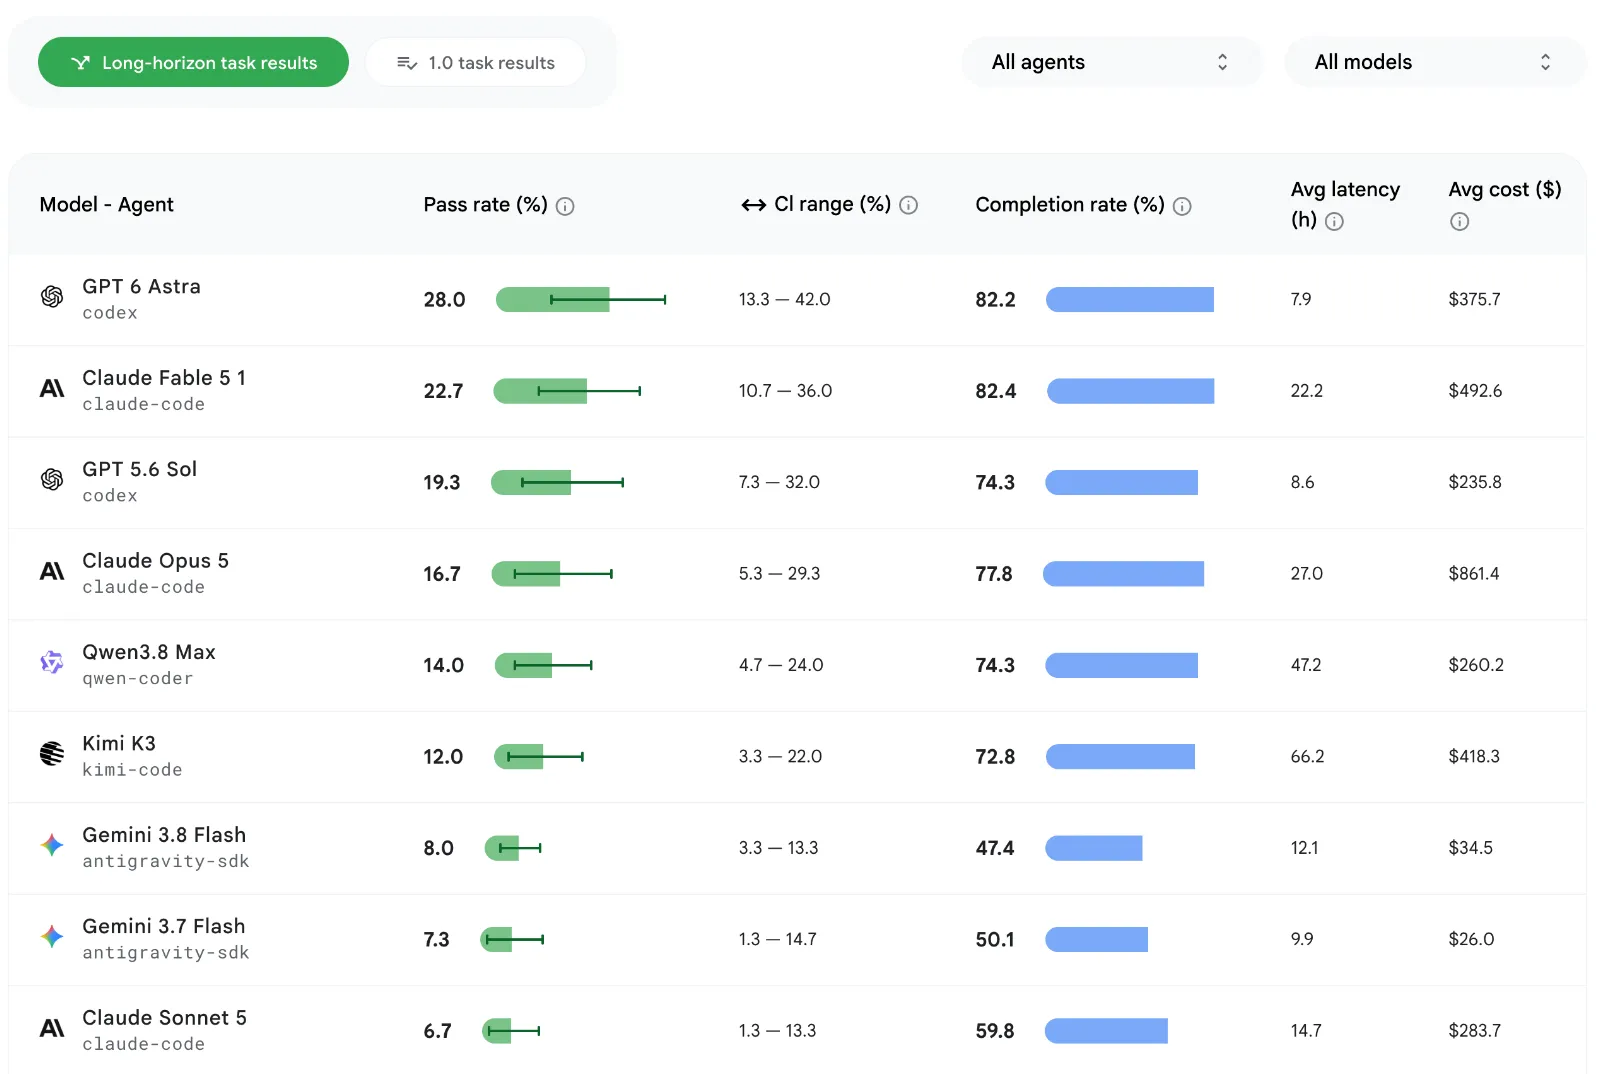
Calculamos este porcentaje de finalización a través de una combinación de factores, como la funcionalidad, la fidelidad visual y la prevención de regresiones. También aplicamos penalizaciones de puntuación objetivas por desviaciones de las instrucciones de evaluación o las restricciones estructurales. Consulta el ranking actualizado y haz clic en la vista de tarjeta de cada modelo para ver elementos adicionales, como la tasa de aprobación, la tasa de finalización y los costos promedio por modelo y por tarea.
La tasa de aprobación más alta para las LHT es de alrededor del 28%, mucho más baja que el ~91% de las tareas originales en la comparativa.

Las tareas a largo plazo revelan estadísticas útiles para la asistencia de IA
Además de medir qué tan bien la IA maneja las tareas de larga duración, el conjunto de datos de LHT nos ayuda a obtener más información sobre las fortalezas y debilidades de los modelos probados, y te ofrecemos orientación más práctica.
En todos los niveles de modelos, la IA hace un mejor trabajo escribiendo código nuevo que refactorizando código existente. Las refactorizaciones y las migraciones se vuelven más difíciles porque el éxito depende de la complejidad de la arquitectura en lugar del volumen de código.
Los modelos muestran capacidades sólidas en transformaciones determinísticas y bien establecidas, como convertir Java a Kotlin, intercambiar Retrofit por Ktor o introducir una capa de ViewModel. Aplican estos patrones de manera coherente, incluso en más de 125 archivos y más de 8,000 líneas de código.
Sin embargo, los modelos tienen dificultades cuando las tareas requieren validación en el tiempo de ejecución (como la falta de gráficos de inyección de dependencias), implican cambios en el marco de trabajo o presentan brechas de conocimiento con bibliotecas no lanzadas. Portar apps multiplataforma a Android sigue siendo un desafío abierto: ningún modelo alcanza una tasa de aprobación del 100%, y los modelos de vanguardia alcanzan, como máximo, una tasa de finalización del 80%.
Presentamos las evaluaciones de agentes
Para ayudarte a comprender mejor el rendimiento de los modelos cuando se integran en tus flujos de trabajo basados en agentes, agregaremos agentes de uso frecuente a nuestra evaluación. Para comenzar, ejecutaremos modelos nuevos en LHT con agentes del proveedor de modelos correspondiente. Por ejemplo, ejecutamos GPT 5.6 Sol en Codex y Gemini 3.8 Flash en Google Antigravity. Este ejemplo muestra cómo el diseño del arnés influye de forma positiva en los resultados de los desarrolladores, ya que observamos que el almacenamiento en caché de instrucciones y la ventana de herramientas compacta pueden generar reducciones de tokens.
En el futuro, ampliaremos esta función para destacar también los resultados en varias combinaciones de modelos y agentes, y así ayudarte a descubrir qué combinaciones funcionan mejor para ti y tu equipo.
Invertimos en esta medición porque es importante que puedas usar el agente y el modelo que elijas para el desarrollo de Android. Compartiremos más información en las próximas semanas.
Se agregaron modelos nuevos
Además, seguimos expandiendo nuestro ranking para asegurarnos de que tengas los datos más actualizados para tus decisiones de desarrollo. Agregamos Gemini 3.8 Flash, Gemini 3.7 Flash, GPT-6 de OpenAI, Fable 5.1 de Anthropic, Kimi K3 y Qwen 3.8 Max, con GPT-6 Astra de OpenAI en la parte superior con un índice de aprobación del 28%.
Con la mirada puesta en el futuro
Android Bench 2.0 ofrece un entorno sólido para medir la IA en el desarrollo de Android. Al combinar tareas a largo plazo, evaluación multimodal, agentes y puntuación continua, esperamos capacitar a los equipos de investigación de IA para que creen socios de programación de IA más capaces y confiables, y esperamos brindarte más transparencia sobre tus opciones para el desarrollo de IA.
Consulta el ranking actualizado junto con la metodología actualizada. Tus comentarios influyen directamente en la evolución de Android Bench, así que sigue compartiéndolos con nosotros en GitHub y en nuestros canales de redes sociales, como X y LinkedIn.
-

 Novedades sobre productos
En marzo, presentamos Android Bench, nuestra tabla de clasificación de LLM para tareas de desarrollo de Android del mundo real. Desde entonces, mejoramos la comparativa según tus comentarios, lo que incluye la evaluación de modelos de peso abierto y la incorporación de dimensiones de costo y eficiencia al ranking.
Zoe Lopez-Latorre • Lectura de 3 minutos -
 Novedades sobre productos
Hoy lanzamos Android 17 y lo ponemos a disposición de la mayoría de los dispositivos Pixel compatibles. Busca dispositivos nuevos con Android 17 en los próximos meses.
Matthew McCullough • Lectura de 13 min -
 Novedades sobre productos
Google I/O 26 incluye 17 anuncios clave para los desarrolladores de Android que se centran en la productividad impulsada por agentes, Compose First como nuestro estándar de IU y el desarrollo adaptable y de medios de alto rendimiento para el ecosistema en expansión.
Matthew McCullough • Lectura de 8 min
Recibe la información más reciente sobre el desarrollo de Android en tu bandeja de entrada todas las semanas.