Android Bench 2.0: ก้าวข้ามขีดจำกัดด้วยงานระยะยาวที่ท้าทาย
ใช้เวลาอ่าน 3 นาที
เมื่อเปิดตัว Android Bench เป็นครั้งแรก เราได้สร้างรากฐานที่เข้มงวดสำหรับการประเมินว่าโมเดลภาษาขนาดใหญ่ (LLM) ช่วยเหลือนักพัฒนาแอปในงาน Android ในชีวิตจริงได้อย่างไร เนื่องจากโมเดล AI และ Agent มีการพัฒนาอย่างรวดเร็ว เราจึงได้อัปเดตวิธีการของเรา เช่น การปรับเฟรมเวิร์กการเปรียบเทียบให้สอดคล้องกับเฟรมเวิร์ก Harbor วันนี้เราจะเปิดตัวงานระยะยาว (LHT) ชุดแรก ซึ่งเป็นงานที่มีความซับซ้อนสูงซึ่งวิศวกรต้องใช้เวลาหลายวันหรือแม้แต่ 1 สัปดาห์จึงจะเสร็จสมบูรณ์ นอกจากนี้ เรายังเปิดตัวการประเมิน Agent โดยเริ่มจาก Agent ของผู้ให้บริการโมเดลที่เกี่ยวข้อง การเพิ่มนี้ทำให้เราได้ Android Bench 2.0 ซึ่งเป็นการอัปเกรดครั้งสำคัญที่ออกแบบมาเพื่อประเมินโมเดล AI และ Agent เทียบกับขนาด ความกำกวม และการแก้ปัญหาหลายขั้นตอนที่ซับซ้อนซึ่งคุณต้องรับมือทุกวัน
ตั้งแต่การแก้ไขแบบค่อยเป็นค่อยไปไปจนถึงงานระยะยาว
Android Bench เวอร์ชันแรก รวมถึงการเปรียบเทียบการเขียนโค้ด AI ในช่วงแรกๆ ที่คล้ายกัน มุ่งเน้นไปที่การเปลี่ยนแปลงที่เพิ่มขึ้นในที่เก็บที่มีอยู่ ซึ่งในหลายกรณีจำกัดอยู่เพียงการแก้ไขข้อบกพร่องหรือคำขอฟีเจอร์ขนาดเล็ก ซึ่งเป็นภาพสะท้อนความสามารถของความช่วยเหลือจาก AI ในขณะนั้น รวมถึงวิธีที่คุณใช้ความช่วยเหลือดังกล่าว
เราได้ยกระดับการประเมินให้สอดคล้องกับงานที่คุณมอบหมายให้ AI เพื่อช่วยคุณค้นหาโมเดลและ Agent การเขียนโค้ดที่เหมาะกับเวิร์กโฟลว์การพัฒนาของคุณมากที่สุดต่อไป Android Bench 2.0 สะท้อนความท้าทายที่ทะเยอทะยานเหล่านี้ด้วย LHT ซึ่งรวมถึงการอัปเกรดทรัพยากร Dependency, การเพิ่มฟีเจอร์ใหม่, การสร้างแอปตั้งแต่ต้น หรือการแปลงแอปข้ามแพลตฟอร์มเป็น Android
งานที่ซับซ้อนต้องมีการประเมินและการให้คะแนนที่ละเอียดมากขึ้น
ในงานด้านวิศวกรรมที่ใช้เวลาหลายวัน การให้คะแนนแบบผ่านหรือไม่ผ่านเพียงอย่างเดียวอาจไม่สามารถแสดงภาพรวมทั้งหมดได้
ตัวอย่างเช่น Agent อาจเปลี่ยนโครงสร้างภายในโค้ด 40 หน้าจอเป็น Jetpack Compose, ตั้งค่าตารางฐานข้อมูล และผ่านข้อกำหนด 90% แต่ไม่ผ่านการยืนยันกรณีสุดโต่งเพียงกรณีเดียว การให้คะแนนแบบไบนารีจะให้คะแนนการรันนี้เป็น 0% ซึ่งบดบังความสามารถทางสถาปัตยกรรมของโมเดล เรากำลังเปลี่ยนไปใช้การให้คะแนนอย่างต่อเนื่องเพื่อให้สัญญาณที่มีความหมายมากขึ้น ทั้งสำหรับการพัฒนาโมเดลและการทำความเข้าใจว่า AI จะช่วยคุณได้อย่างไร
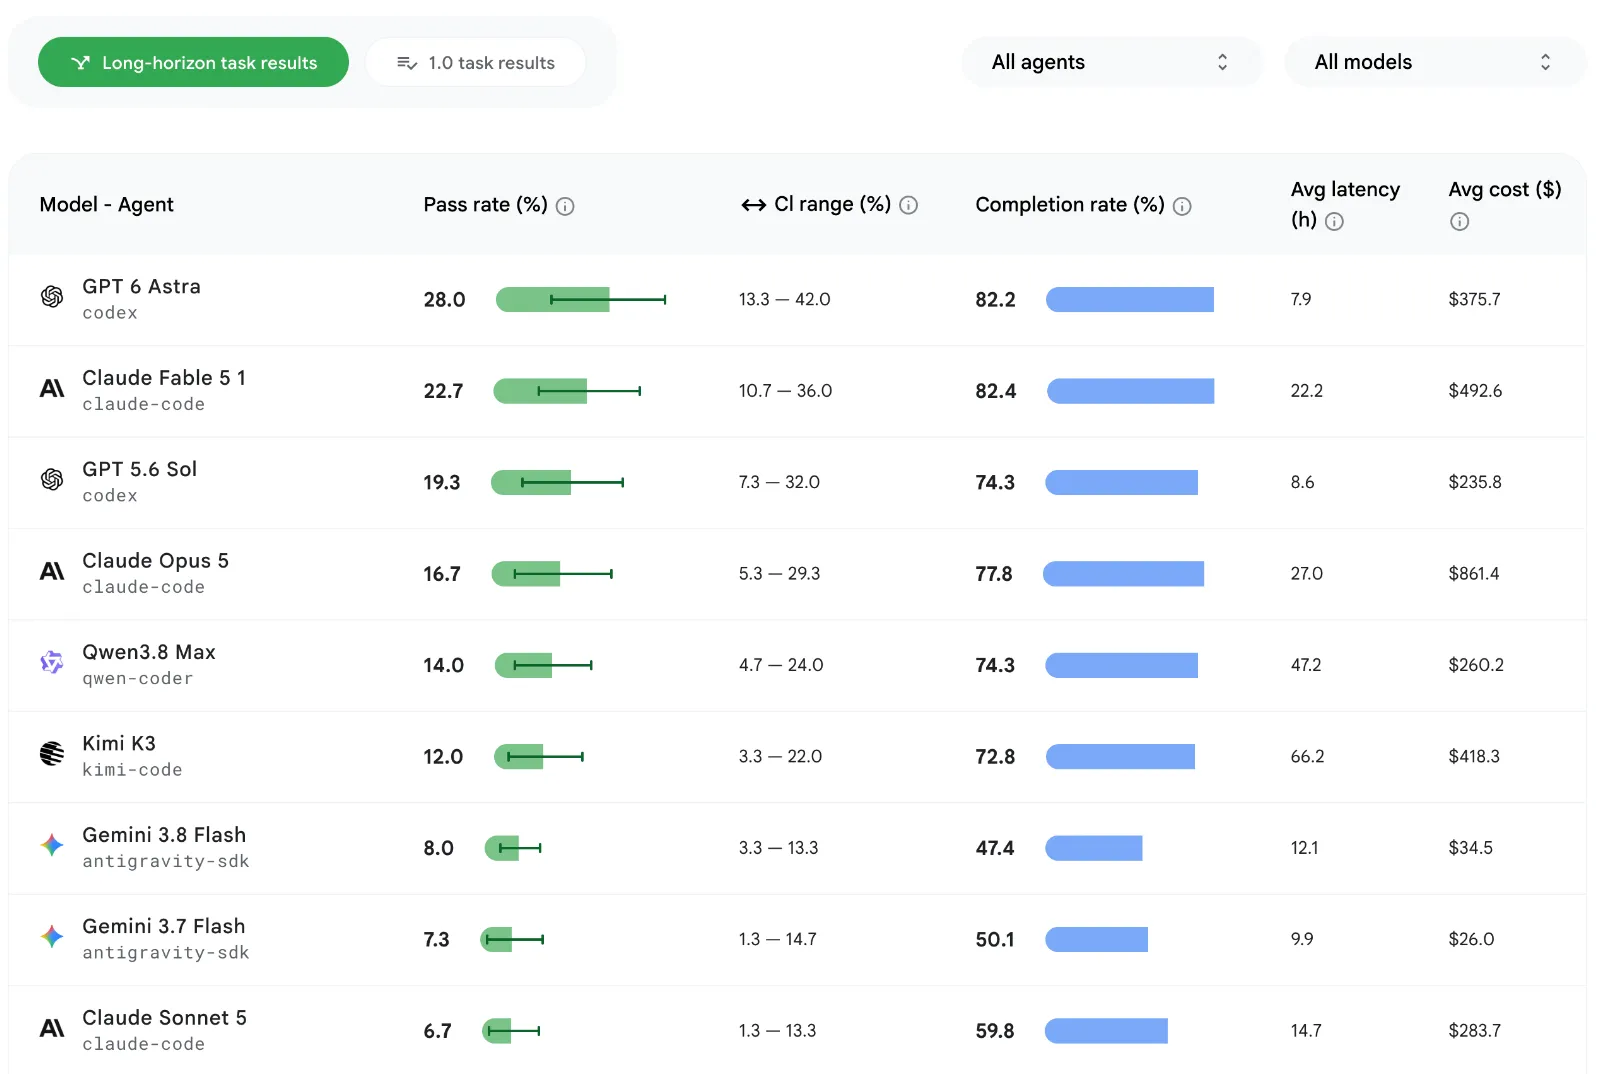
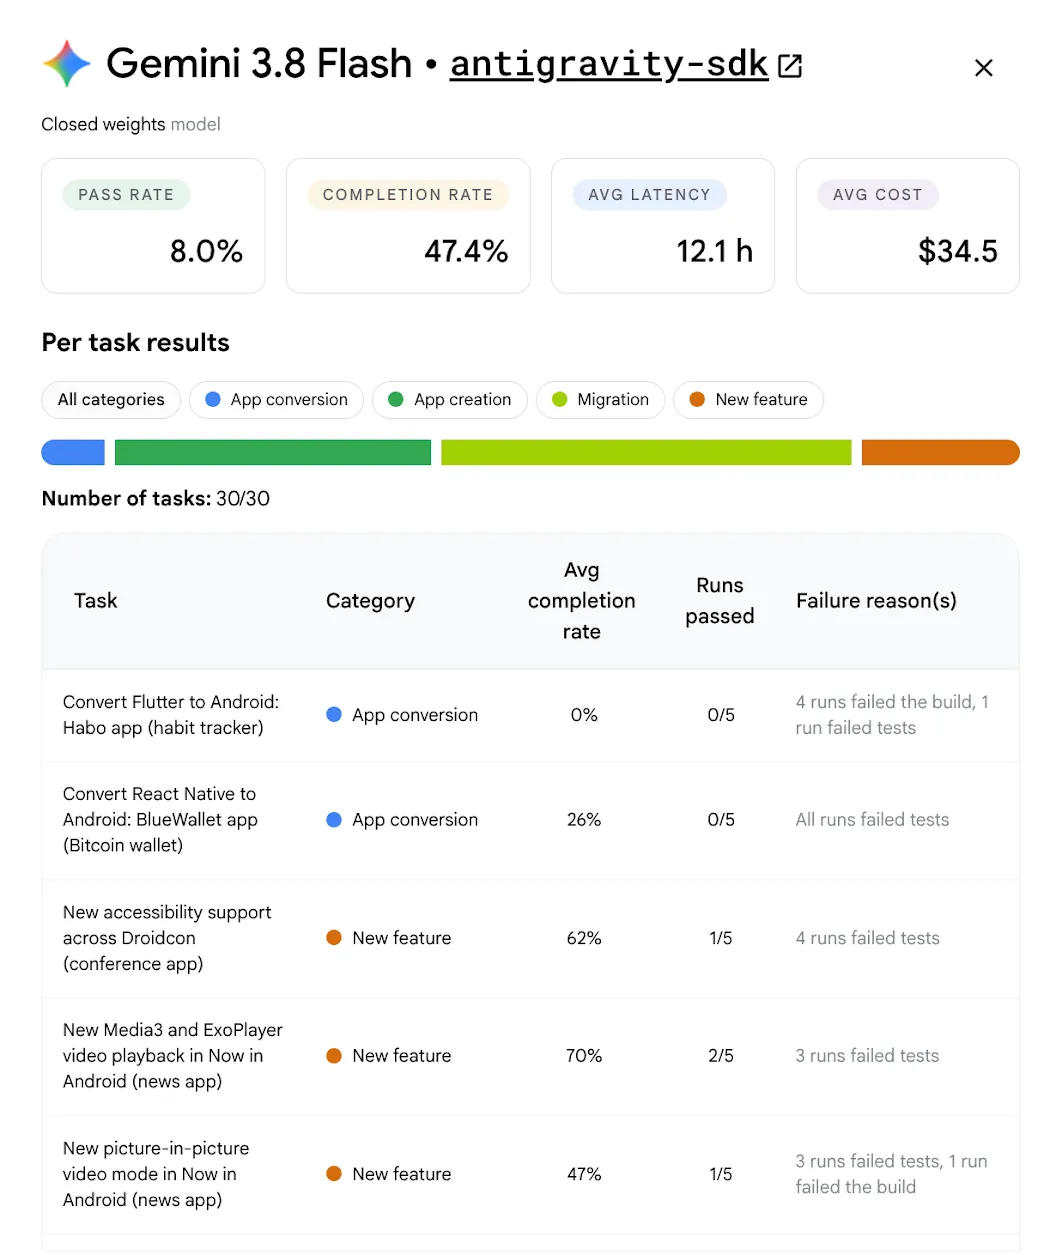
เราคำนวณอัตราความสำเร็จนี้ผ่านการผสมผสานปัจจัยต่างๆ เช่น ฟังก์ชันการทำงาน ความถูกต้องของภาพ และการหลีกเลี่ยงการถดถอย นอกจากนี้ เรายังใช้การลงโทษด้วยการหักคะแนนตามวัตถุประสงค์สำหรับการเบี่ยงเบนจากวิธีการประเมินหรือข้อจำกัดด้านโครงสร้าง ดูตารางอันดับที่อัปเดตแล้ว และคลิกมุมมองการ์ดของแต่ละโมเดลเพื่อดูองค์ประกอบเพิ่มเติม เช่น อัตราการผ่าน อัตราความสำเร็จ และต้นทุนเฉลี่ยต่อโมเดลและต่องาน
อัตราการผ่านสูงสุดสำหรับ LHT อยู่ที่ประมาณ 28% ซึ่งต่ำกว่าอัตราประมาณ 91% สำหรับงานเดิมในการเปรียบเทียบมาก
งานระยะยาวจะช่วยค้นพบข้อมูลเชิงลึกที่เป็นประโยชน์สำหรับความช่วยเหลือจาก AI
นอกเหนือจากการวัดประสิทธิภาพของ AI ในการจัดการงานที่ใช้เวลานานแล้ว ชุดข้อมูล LHT ยังช่วยให้เราเรียนรู้เพิ่มเติมเกี่ยวกับจุดแข็งและจุดอ่อนของโมเดลที่ทดสอบ และเราจะให้คำแนะนำที่นำไปใช้ได้จริงมากขึ้น
ในโมเดลระดับต่างๆ AI จะเขียนโค้ดใหม่ได้ดีกว่าการเปลี่ยนโครงสร้างภายในโค้ดที่มีอยู่ การปรับโครงสร้างและการย้ายข้อมูลจะมีความซับซ้อนมากขึ้น เนื่องจากความสำเร็จขึ้นอยู่กับความซับซ้อนของสถาปัตยกรรมมากกว่าปริมาณโค้ด
โมเดลแสดงความสามารถที่แข็งแกร่งในการเปลี่ยนรูปแบบเชิงกำหนดที่ได้รับการยอมรับเป็นอย่างดี เช่น การแปลง Java เป็น Kotlin, การสลับ Retrofit เป็น Ktor หรือการแนะนำเลเยอร์ ViewModel โดยใช้รูปแบบเหล่านี้อย่างสม่ำเสมอ แม้ในไฟล์มากกว่า 125 ไฟล์และโค้ดมากกว่า 8,000 บรรทัด
อย่างไรก็ตาม โมเดลอาจประสบปัญหาเมื่อต้องทำงานที่ต้องมีการตรวจสอบรันไทม์ (เช่น กราฟการแทรกทรัพยากร Dependency ที่ขาดหายไป) เกี่ยวข้องกับการเปลี่ยนแปลงเฟรมเวิร์กที่ทำให้เกิดข้อผิดพลาด หรือพบช่องว่างด้านความรู้เกี่ยวกับไลบรารีที่ยังไม่ได้เผยแพร่ การพอร์ตแอปข้ามแพลตฟอร์มไปยัง Android ยังคงเป็นความท้าทายที่ยังไม่มีคำตอบ โดยไม่มีโมเดลใดที่มีอัตราการผ่าน 100% และ Frontier Model มีอัตราความสำเร็จสูงสุดเพียง 80%
ขอแนะนำการประเมิน Agent
เรากำลังเพิ่ม Agent ที่ใช้กันโดยทั่วไปลงในการประเมิน เพื่อช่วยให้คุณเข้าใจประสิทธิภาพของโมเดลได้ดียิ่งขึ้นเมื่อผสานรวมเข้ากับเวิร์กโฟลว์ Agent เราจะเริ่มต้นด้วยการเรียกใช้โมเดลใหม่กับ LHT โดยใช้ Agent จากผู้ให้บริการโมเดลที่เกี่ยวข้อง ตัวอย่างเช่น เราเรียกใช้ GPT 5.6 Sol บน Codex และ Gemini 3.8 Flash บน Google Antigravity การจับคู่นี้แสดงให้เห็นว่าการออกแบบ Harness ส่งผลดีต่อผลลัพธ์ของนักพัฒนาซอฟต์แวร์อย่างไร เนื่องจากเราได้เห็นแล้วว่าการแคชพรอมต์และการสร้างหน้าต่างเครื่องมือขนาดกะทัดรัดสามารถลดจำนวนโทเค็นได้
เราจะขยายฟีเจอร์นี้ในอนาคตโดยไฮไลต์ผลลัพธ์จากการผสมผสานโมเดลและ Agent ต่างๆ เพื่อช่วยให้คุณค้นพบการผสมผสานที่เหมาะกับคุณและทีมมากที่สุด
เราลงทุนในการวัดผลนี้เนื่องจากเป็นสิ่งสำคัญสำหรับคุณที่จะสามารถใช้ Agent และโมเดลที่ต้องการสำหรับนักพัฒนาแอป Android ได้ และเราจะมีข้อมูลเพิ่มเติมที่จะแชร์กับคุณในอีกไม่กี่สัปดาห์ข้างหน้า
เพิ่มโมเดลใหม่แล้ว
นอกจากนี้ เรายังขยายลีดเดอร์บอร์ดอย่างต่อเนื่องเพื่อให้คุณมีข้อมูลล่าสุดสำหรับการตัดสินใจด้านการพัฒนา เราได้เพิ่ม Gemini 3.8 Flash, Gemini 3.7 Flash, GPT-6 ของ OpenAI, Fable 5.1 ของ Anthropic, Kimi K3 และ Qwen 3.8 Max โดยมี GPT-6 Astra ของ OpenAI อยู่ในอันดับสูงสุดด้วยอัตราการผ่าน 28%
มองไปข้างหน้า
Android Bench 2.0 มอบสภาพแวดล้อมที่มีประสิทธิภาพสำหรับการวัด AI สำหรับการพัฒนา Android การรวมงานระยะยาว การประเมินแบบหลายโมดัล เอเจนต์ และการให้คะแนนอย่างต่อเนื่องจะช่วยให้ทีมวิจัย AI สามารถสร้างคู่หูเขียนโค้ด AI ที่มีความสามารถและเชื่อถือได้มากขึ้น และเราหวังว่าจะช่วยให้คุณมีความโปร่งใสมากขึ้นเกี่ยวกับตัวเลือกสำหรับการพัฒนา AI
ดูลีดเดอร์บอร์ดที่อัปเดตแล้วพร้อมกับวิธีการที่อัปเดตแล้ว ความคิดเห็นของคุณมีผลโดยตรงต่อวิธีที่เราพัฒนา Android Bench ดังนั้นโปรดแชร์ความคิดเห็นกับเราต่อไปใน GitHub รวมถึงช่องทางโซเชียลของเรา เช่น X และ LinkedIn
-
 ข่าวสารเกี่ยวกับผลิตภัณฑ์
วันนี้ที่งาน Android Dev Summit เราขอประกาศความพร้อมให้บริการในวงกว้างของเครื่องมือและ API จำนวนมากที่ออกแบบมาเพื่อลดความยุ่งยากในชีวิตประจำวันและช่วยให้คุณสร้างแอป Android ที่ยอดเยี่ยมได้อย่างยืดหยุ่นมากขึ้น
Matthew McCullough • ใช้เวลาอ่าน 4 นาที -
 ข่าวสารเกี่ยวกับผลิตภัณฑ์
เมื่อการพัฒนา Agent เร็วขึ้น วิศวกรรม Android ก็กำลังก้าวเข้าสู่พรมแดนใหม่ที่น่าตื่นเต้น นั่นคือการเปลี่ยนจากการเติมโค้ดแบบช่วยเหลือไปเป็น Agent ที่ดำเนินการตั้งแต่ต้นจนจบภายใต้คำสั่งของคุณ คุณมีตัวเลือกและความยืดหยุ่นอย่างเต็มที่ในโมเดลและ Agent ที่ใช้
Jason Buchel • ใช้เวลาอ่าน 3 นาที -

 ข่าวสารเกี่ยวกับผลิตภัณฑ์
ในฐานะนักพัฒนาแอป Android คุณมีตัวเลือกมากมายสำหรับ Agent, LLM, เครื่องมือ และอินเทอร์เฟซบรรทัดคำสั่ง (CLI) ที่ใช้ในการพัฒนาแอป เป้าหมายของเราคือการช่วยคุณสร้างแอป Android ที่สวยงามและมีคุณภาพสูง ไม่ว่าคุณจะเลือกสร้างด้วยวิธีใดก็ตาม
Simona Milanovic • ใช้เวลาอ่าน 4 นาที
รับข้อมูลเชิงลึกเกี่ยวกับการพัฒนา Android ล่าสุดที่ส่งไปยังกล่องจดหมายของคุณทุกสัปดาห์