Android Bench를 처음 출시했을 때 Google은 대규모 언어 모델 (LLM)이 실제 Android 작업에서 개발자를 어떻게 지원하는지 평가하기 위한 엄격한 기반을 구축했습니다. AI 모델과 에이전트가 빠르게 발전함에 따라 Google은 벤치마크 프레임워크를 Harbor 프레임워크에 맞추는 등 방법론을 업데이트해 왔습니다. 오늘 Google은 첫 번째 장기 작업 (LHT) 세트를 출시합니다. 이는 엔지니어가 완료하는 데 며칠 또는 일주일이 걸리는 매우 복잡한 작업입니다. 또한 해당 모델 제공업체의 에이전트를 시작으로 에이전트 평가를 도입합니다. 이러한 추가를 통해 Android Bench 2.0이 탄생했습니다. 이는 개발자가 매일 직면하는 규모, 모호성, 복잡한 다단계 문제 해결을 기준으로 AI 모델과 에이전트를 평가하도록 설계된 주요 업그레이드입니다.
점진적 수정에서 장기 작업까지
Android Bench의 첫 번째 버전은 유사한 초기 AI 코딩 벤치마크와 함께 기존 저장소의 점진적인 변경에 중점을 두었으며, 대부분의 경우 버그 수정이나 소규모 기능 요청으로 제한되었습니다. 이는 당시 AI 어시스턴트의 기능과 사용 방식을 반영한 것입니다.
개발 워크플로에 가장 적합한 모델과 코딩 에이전트를 찾을 수 있도록 AI에 위임하는 작업에 맞게 평가 기준을 높였습니다. Android Bench 2.0은 종속 항목 업그레이드, 새 기능 추가, 앱 처음부터 빌드, 크로스 플랫폼 앱을 Android로 변환하는 등의 LHT를 통해 이러한 야심 찬 과제를 반영합니다.
복잡한 작업에는 더 세밀한 평가와 채점이 필요합니다.
여러 날에 걸쳐 진행되는 엔지니어링 작업에서는 합격 또는 불합격이라는 이분법적 평가로는 전체적인 상황을 파악할 수 없습니다.
예를 들어 에이전트가 40개의 화면을 Jetpack Compose로 리팩터링하고 데이터베이스 테이블을 설정하고 요구사항의 90% 를 통과할 수 있지만 단일 극단적 상황 어설션에 실패할 수 있습니다. 바이너리 채점은 이 실행을 0%로 평가하여 모델의 아키텍처 기능을 가립니다. Google은 모델 개발과 AI가 어떻게 도움이 될 수 있는지에 대한 이해를 위해 더 의미 있는 신호를 제공하고자 연속 점수 산정 방식으로 전환하고 있습니다.
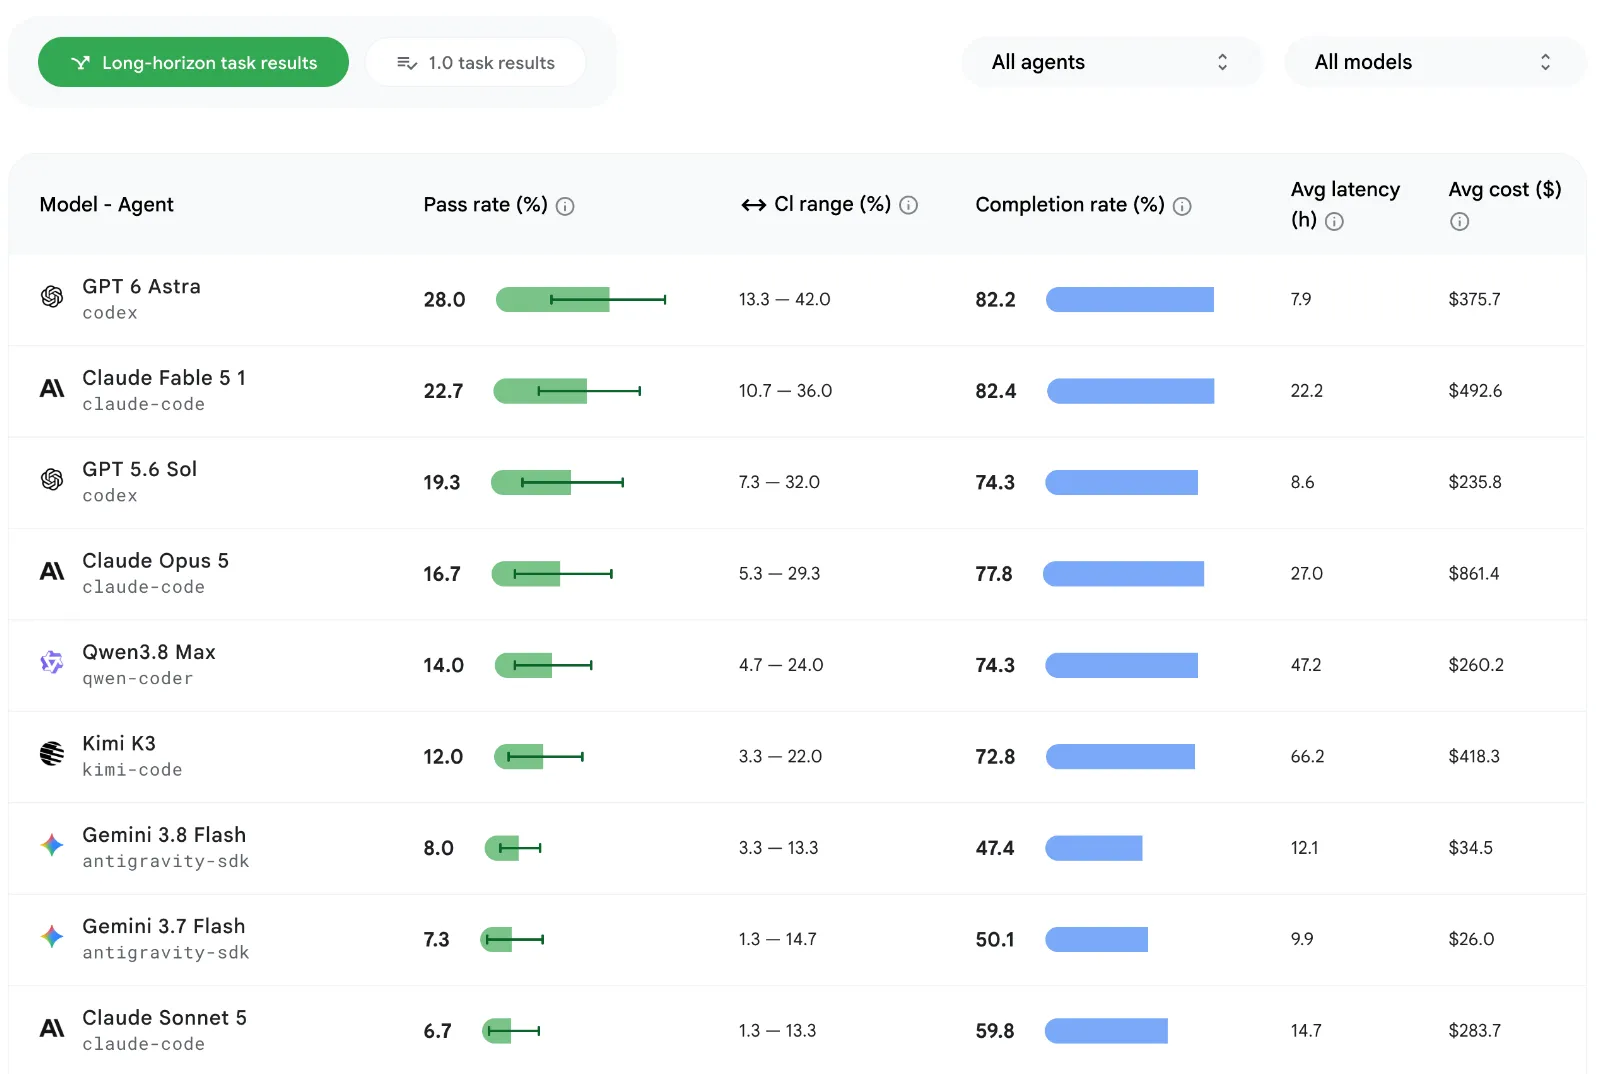
이 완료율은 기능, 시각적 충실도, 회귀 방지 등의 요소를 조합하여 계산됩니다. 또한 평가 안내 또는 구조적 제약 조건을 위반하는 경우 객관적인 점수 페널티를 적용합니다. 업데이트된 리더보드를 확인하고 각 모델의 카드 뷰를 클릭하여 통과율, 완료율, 모델 및 작업당 평균 비용과 같은 추가 요소를 확인하세요.
LHT의 최고 통과율은 약 28%로, 벤치마크의 원래 작업 통과율인 약 91% 보다 훨씬 낮습니다.

장기 작업은 AI 지원에 유용한 인사이트를 제공합니다.
LHT 데이터 세트는 AI가 장기 실행 작업을 얼마나 잘 처리하는지 측정하는 것 외에도 테스트된 모델의 장단점을 자세히 파악하는 데 도움이 되며, Google은 더 실용적인 가이드를 제공합니다.
모든 모델 등급에서 AI는 기존 코드를 리팩터링하는 것보다 새 코드를 작성하는 데 더 뛰어난 성능을 발휘합니다. 성공 여부가 코드 양이 아닌 아키텍처 복잡성에 따라 달라지므로 리팩터링과 마이그레이션이 더 까다로워집니다.
모델은 Java를 Kotlin으로 변환하거나, Retrofit을 Ktor로 교체하거나, ViewModel 레이어를 도입하는 등 잘 정립된 결정론적 변환에서 강력한 기능을 보여줍니다. 125개가 넘는 파일과 8,000줄이 넘는 코드에서도 이러한 패턴을 일관되게 적용합니다.
하지만 런타임 검증이 필요한 작업 (예: 누락된 종속 항목 삽입 그래프), 프레임워크 변경사항을 중단하는 작업, 출시되지 않은 라이브러리와의 지식 격차가 발생하는 작업에서는 모델이 어려움을 겪습니다. 크로스 플랫폼 앱을 Android로 이식하는 것은 여전히 해결되지 않은 과제입니다. 100% 통과율을 달성한 모델은 없으며, 프런티어 모델의 완료율은 최대 80% 에 불과합니다.
에이전트 평가 소개
에이전트 워크플로에 통합된 모델의 성능을 더 잘 파악할 수 있도록 일반적으로 사용되는 에이전트를 평가에 추가하고 있습니다. 먼저 해당 모델 제공업체의 상담사와 함께 LHT를 대상으로 새 모델을 실행합니다. 예를 들어 Codex에서 GPT 5.6 Sol을 실행하고 Google Antigravity에서 Gemini 3.8 Flash를 실행했습니다. 이러한 조합은 프롬프트 캐싱과 컴팩트 도구 창이 토큰 감소로 이어질 수 있음을 보여주듯이, 하네스 설계가 개발자 결과에 긍정적인 영향을 미친다는 것을 보여줍니다.
향후에는 다양한 모델과 에이전트 조합의 결과를 강조 표시하여 나와 내 팀에 가장 적합한 조합을 찾을 수 있도록 이 기능을 확장할 예정입니다.
Google은 Android 개발에 원하는 에이전트와 모델을 사용할 수 있는 것이 중요하기 때문에 이 측정에 투자하고 있으며, 앞으로 몇 주 내에 더 많은 정보를 공유해 드릴 예정입니다.
새로운 모델 추가됨
또한 개발 결정에 최신 데이터를 활용할 수 있도록 리더보드를 계속 확장하고 있습니다. Gemini 3.8 Flash, Gemini 3.7 Flash, OpenAI의 GPT-6, Anthropic의 Fable 5.1, Kimi K3, Qwen 3.8 Max가 추가되었으며, OpenAI의 GPT-6 Astra가 28% 의 통과율로 1위를 차지했습니다.
향후 계획
Android Bench 2.0은 Android 개발을 위한 AI를 측정할 수 있는 강력한 환경을 제공합니다. 장기 작업, 멀티모달 평가, 에이전트, 지속적인 채점을 결합하여 AI 연구팀이 더 유능하고 신뢰할 수 있는 AI 코딩 파트너를 구축할 수 있도록 지원하고, AI 개발 옵션에 대한 투명성을 높이고자 합니다.
업데이트된 방법론과 함께 업데이트된 리더보드를 확인하세요. 보내주신 의견은 Android Bench의 발전 방향에 직접적으로 반영됩니다. GitHub와 X, LinkedIn과 같은 소셜 채널을 통해 계속해서 의견을 공유해 주세요.
-
 제품 소식
오늘 Android Dev Summit에서 Google은 일상적인 불편을 해소하고 뛰어난 Android 앱을 빌드할 수 있는 유연성을 높이기 위해 설계된 다양한 도구와 API를 광범위하게 제공한다고 발표했습니다.
Matthew McCullough • 읽는 데 4분 소요 -
 제품 소식
에이전트형 개발이 가속화됨에 따라 Android 엔지니어링은 흥미로운 새로운 영역에 도달하고 있습니다. 바로 보조 코드 완성에서 개발자의 지시에 따라 엔드 투 엔드로 실행되는 에이전트로의 전환입니다. 사용하는 모델과 에이전트를 완전히 자유롭게 선택할 수 있습니다.
Jason Buchel • 읽는 데 3분 소요 -

 제품 소식
Android 개발자는 앱 개발에 사용할 에이전트, LLM, 도구, 명령줄 인터페이스 (CLI)를 선택할 때 다양한 옵션을 사용할 수 있습니다. Google의 목표는 개발자가 어떤 방식을 선택하든 아름답고 품질이 우수한 Android 앱을 빌드할 수 있도록 지원하는 것입니다.
Simona Milanovic • 읽는 데 4분 소요
Android 개발 관련 최신 정보를 이메일로 받아 보세요.