Android Bench 2.0: spingersi oltre i limiti con attività a lungo termine impegnative
Tempo di lettura: 3 min
Quando abbiamo lanciato Android Bench, abbiamo creato una base rigorosa per valutare in che modo i modelli linguistici di grandi dimensioni (LLM) assistono gli sviluppatori con attività Android reali. Man mano che i modelli di AI e gli agenti si evolvono rapidamente, aggiorniamo la nostra metodologia, ad esempio allineando il nostro framework di benchmark al framework Harbor. Oggi rilasciamo il primo set di attività a lungo termine (LHT), ovvero attività di grande complessità che richiedono a un ingegnere diversi giorni o addirittura una settimana per essere completate. Stiamo anche introducendo la valutazione agentica, a partire dagli agenti dei fornitori di modelli corrispondenti. Questa aggiunta ci porta ad Android Bench 2.0, un importante upgrade progettato per valutare i modelli di AI e gli agenti in base alla scalabilità, all'ambiguità e alla complessa risoluzione dei problemi in più passaggi che affronti ogni giorno.
Dalle correzioni incrementali alle attività a lungo termine
La prima iterazione di Android Bench, insieme a benchmark di programmazione AI simili, si è concentrata su modifiche incrementali ai repository esistenti, in molti casi limitate a correzioni di bug o richieste di funzionalità più piccole. Questo rifletteva le capacità dell'Assistenza AI in quel momento, nonché il modo in cui la utilizzavi.
Per continuare ad aiutarti a trovare i modelli e gli agenti di programmazione più adatti al tuo workflow di sviluppo, abbiamo alzato l'asticella delle nostre valutazioni per adattarle al lavoro che deleghi all'AI. Android Bench 2.0 rispecchia queste sfide ambiziose con LHT che includono l'upgrade delle dipendenze, l'aggiunta di nuove funzionalità, la creazione di app da zero o la conversione di un'app multipiattaforma in Android.
Le attività complesse richiedono una valutazione e un punteggio più sfumati
Nelle attività di programmazione di più giorni, la valutazione binaria di superamento o mancato superamento non fornisce un quadro completo.
Ad esempio, un agente potrebbe rifattorizzare 40 schermate in Jetpack Compose, configurare tabelle di database e superare il 90% dei requisiti, ma non riuscire a soddisfare una singola asserzione di un caso limite. Il punteggio binario valuta questa esecuzione come 0%, oscurando le capacità architetturali del modello. Stiamo passando alla valutazione continua per fornire un segnale più significativo, sia per lo sviluppo del modello sia per la tua comprensione di come l'AI può aiutarti.
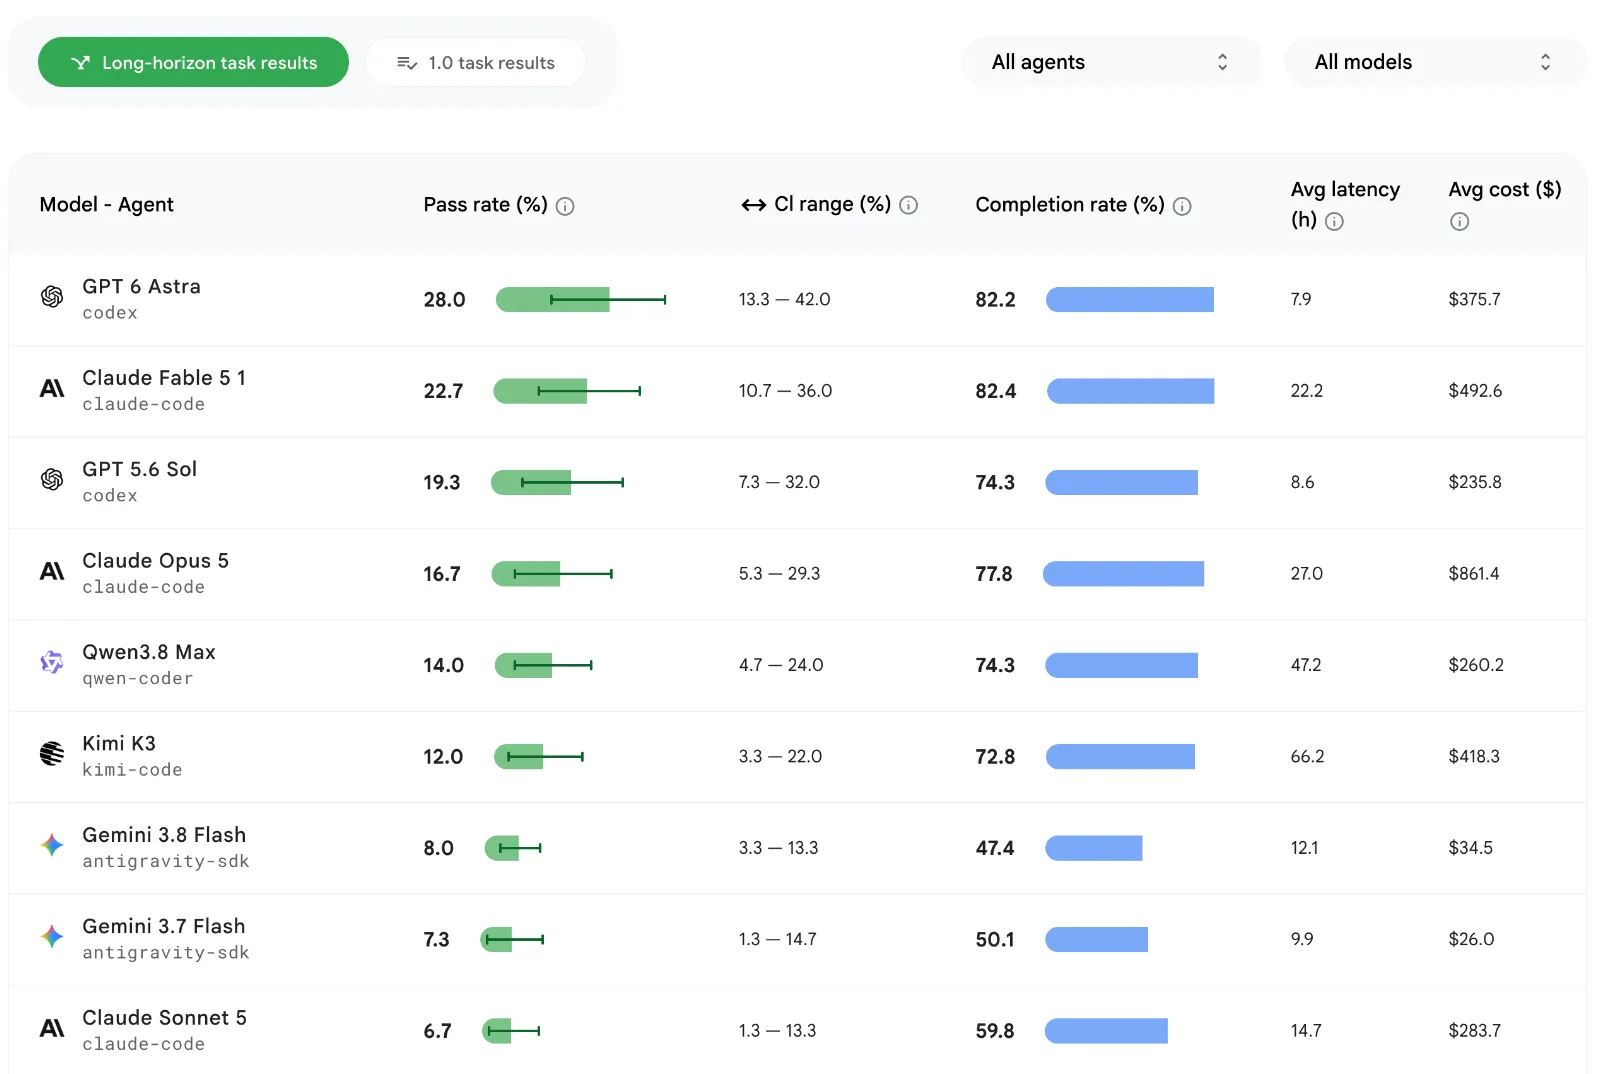
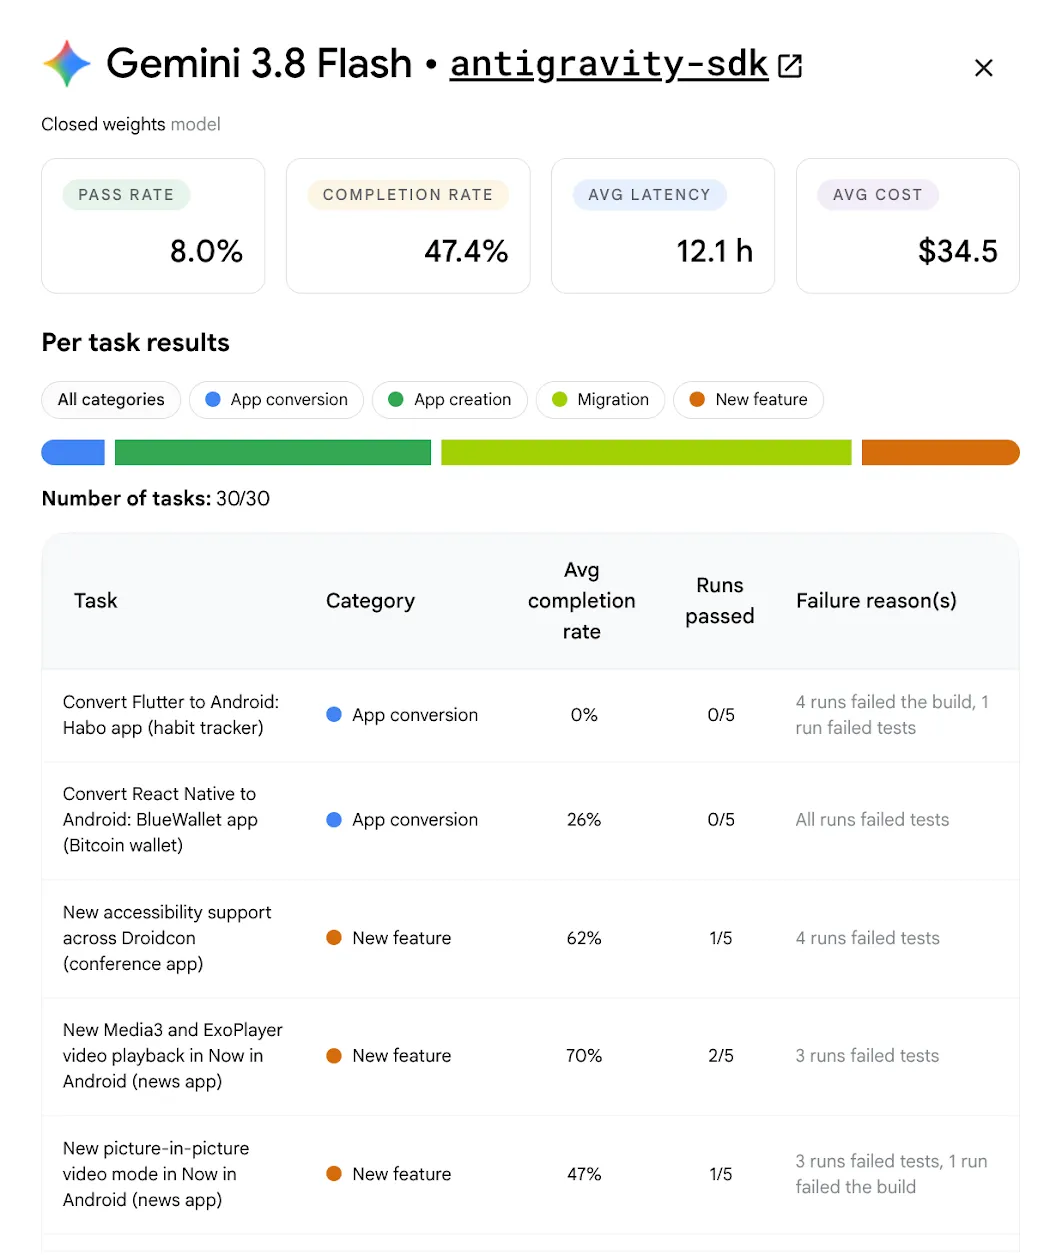
Calcoliamo questa percentuale di completamento attraverso una combinazione di fattori come funzionalità, fedeltà visiva ed evitando regressioni. Applichiamo anche penalità di punteggio oggettive per le deviazioni dalle istruzioni di valutazione o dai vincoli strutturali. Dai un'occhiata alla classifica aggiornata e fai clic sulla visualizzazione schede di ogni modello per vedere altri elementi, come la percentuale di superamento, la percentuale di completamento e i costi medi per modello e per attività.
La percentuale di superamento più alta per gli LHT è di circa il 28%, molto inferiore al ~91% per le attività originali nel benchmark.
Le attività a lungo termine forniscono insight utili per l'assistenza AI
Oltre a misurare l'efficacia dell'AI nella gestione di attività di lunga durata, il set di dati LHT ci aiuta a saperne di più sui punti di forza e di debolezza dei modelli testati e ci consente di offrirti indicazioni più pratiche.
In tutti i livelli dei modelli, l'AI è più efficace nella scrittura di nuovo codice rispetto al refactoring del codice esistente. Le rifattorizzazioni e le migrazioni diventano più complicate perché il successo dipende dalla complessità dell'architettura piuttosto che dal volume del codice.
I modelli mostrano forti capacità su trasformazioni ben consolidate e deterministiche, come la conversione di Java in Kotlin, la sostituzione di Retrofit con Ktor o l'introduzione di un livello ViewModel. Applicano questi pattern in modo coerente, anche su oltre 125 file e più di 8000 righe di codice.
Tuttavia, i modelli hanno difficoltà quando le attività richiedono la convalida di runtime (come i grafici di dependency injection mancanti), comportano modifiche del framework che causano errori o presentano lacune di conoscenza con librerie non rilasciate. Il porting di app multipiattaforma su Android rimane una sfida aperta: nessun modello raggiunge una percentuale di superamento del 100% e i modelli pionieristici raggiungono al massimo una percentuale di completamento dell'80%.
Introduzione alle valutazioni degli agenti
Per aiutarti a comprendere meglio il rendimento dei modelli quando vengono integrati nei tuoi Agentic Workflow, stiamo aggiungendo alla nostra valutazione gli agenti di uso comune. Inizieremo eseguendo i nuovi modelli su LHT con agenti del provider di modelli corrispondente. Ad esempio, abbiamo eseguito GPT 5.6 Sol su Codex e Gemini 3.8 Flash su Google Antigravity. Questo abbinamento mostra come la progettazione dell'harness influisca positivamente sui risultati degli sviluppatori, poiché abbiamo visto che la memorizzazione nella cache dei prompt e la finestra degli strumenti compatta possono comportare una riduzione dei token.
In futuro, amplieremo questa funzionalità evidenziando anche i risultati di varie combinazioni di modelli e agenti, per aiutarti a scoprire quali combinazioni funzionano meglio per te e il tuo team.
Investiamo in questa misurazione perché è importante che tu possa utilizzare l'agente e il modello che preferisci per lo sviluppo Android. Avremo altre informazioni da condividere con te nelle prossime settimane.
Nuovi modelli aggiunti
Inoltre, continuiamo ad ampliare la nostra classifica per assicurarci che tu abbia i dati più aggiornati per le tue decisioni di sviluppo. Abbiamo aggiunto Gemini 3.8 Flash, Gemini 3.7 Flash, GPT-6 di OpenAI, Fable 5.1 di Anthropic, Kimi K3 e Qwen 3.8 Max, con GPT-6 Astra di OpenAI in cima con un tasso di superamento del 28%.
Prospettive future
Android Bench 2.0 offre un ambiente solido per misurare l'AI per lo sviluppo Android. Combinando attività a lungo termine, valutazione multimodale, agenti e punteggio continuo, speriamo di consentire ai team di ricerca sull'AI di creare partner di programmazione AI più capaci e affidabili e di fornire maggiore trasparenza sulle opzioni per lo sviluppo dell'AI.
Dai un'occhiata alla classifica aggiornata e alla metodologia aggiornata. Il tuo feedback influenza direttamente il modo in cui facciamo evolvere Android Bench, quindi continua a condividere il tuo feedback con noi su GitHub, nonché sui nostri canali social come X e LinkedIn.
-
 Novità sui prodotti
Oggi, all'Android Dev Summit, annunciamo l'ampia disponibilità di molti strumenti e API progettati per rimuovere gli attriti quotidiani e offrirti maggiore flessibilità per creare app per Android di qualità.
Matthew McCullough • Tempo di lettura: 4 min -
 Novità sui prodotti
Con l'accelerazione dello sviluppo agentico, l'ingegneria Android sta raggiungendo una nuova entusiasmante frontiera: il passaggio dal completamento del codice assistito agli agenti che eseguono end-to-end sotto la tua direzione. Hai la massima scelta e flessibilità nei modelli e negli agenti che utilizzi.
Jason Buchel • Tempo di lettura: 3 min -

 Novità sui prodotti
In qualità di sviluppatore Android, hai molte opzioni per quanto riguarda gli agenti, gli LLM, gli strumenti e le interfacce a riga di comando (CLI) che utilizzi per lo sviluppo di app. Il nostro obiettivo è aiutarti a creare app per Android di alta qualità e dall'aspetto accattivante, indipendentemente dal modo in cui scegli di crearle.
Simona Milanovic • Tempo di lettura: 4 min
Ricevi gli ultimi approfondimenti sullo sviluppo Android direttamente nella tua casella di posta ogni settimana.