Android Bench 2.0 : repousser les limites avec des tâches complexes à long horizon
Temps de lecture : 3 min
Lorsque nous avons lancé Android Bench, nous avons établi une base rigoureuse pour évaluer la manière dont les grands modèles de langage (LLM) aident les développeurs à effectuer des tâches Android réelles. Les modèles et agents d'IA évoluant rapidement, nous avons mis à jour notre méthodologie, par exemple en alignant notre framework de benchmark sur le framework Harbor. Aujourd'hui, nous publions le premier ensemble de tâches à long horizon (LHT), qui sont des tâches d'une grande complexité qui prennent plusieurs jours, voire une semaine, à un ingénieur. Nous introduisons également l'évaluation agentique, en commençant par les agents des fournisseurs de modèles correspondants. Cet ajout nous amène à Android Bench 2.0, une mise à niveau majeure conçue pour évaluer les modèles et les agents d'IA par rapport à l'échelle, à l'ambiguïté et à la résolution de problèmes complexes en plusieurs étapes auxquels vous êtes confronté chaque jour.
Des corrections incrémentales aux tâches à long horizon
La première itération d'Android Bench, ainsi que d'autres benchmarks de codage d'IA précoces, se sont concentrés sur les modifications incrémentielles apportées aux dépôts existants, souvent limitées à des corrections de bugs ou à des demandes de fonctionnalités mineures. Cela reflétait les capacités de l'assistance IA à ce moment-là, ainsi que la façon dont vous l'utilisiez.
Pour continuer à vous aider à trouver les modèles et les agents de codage les mieux adaptés à votre workflow de développement, nous avons relevé le niveau de nos évaluations pour qu'il corresponde au travail que vous déléguez à l'IA. Android Bench 2.0 reflète ces défis ambitieux avec des LHT qui incluent la mise à niveau des dépendances, l'ajout de nouvelles fonctionnalités, la création d'applications à partir de zéro ou la conversion d'une application multiplateforme vers Android.
Les tâches complexes nécessitent une évaluation et une notation plus nuancées
Pour les tâches d'ingénierie qui s'étalent sur plusieurs jours, une évaluation binaire de réussite ou d'échec ne permet pas d'avoir une vue d'ensemble.
Par exemple, un agent peut refactoriser 40 écrans vers Jetpack Compose, configurer des tables de base de données et répondre à 90 % des exigences, mais échouer à une seule assertion de cas limite. La notation binaire attribue un score de 0 % à cette exécution, ce qui masque les capacités architecturales du modèle. Nous passons à un système de notation continue pour fournir un signal plus pertinent, à la fois pour le développement de modèles et pour vous aider à comprendre comment l'IA peut vous aider.
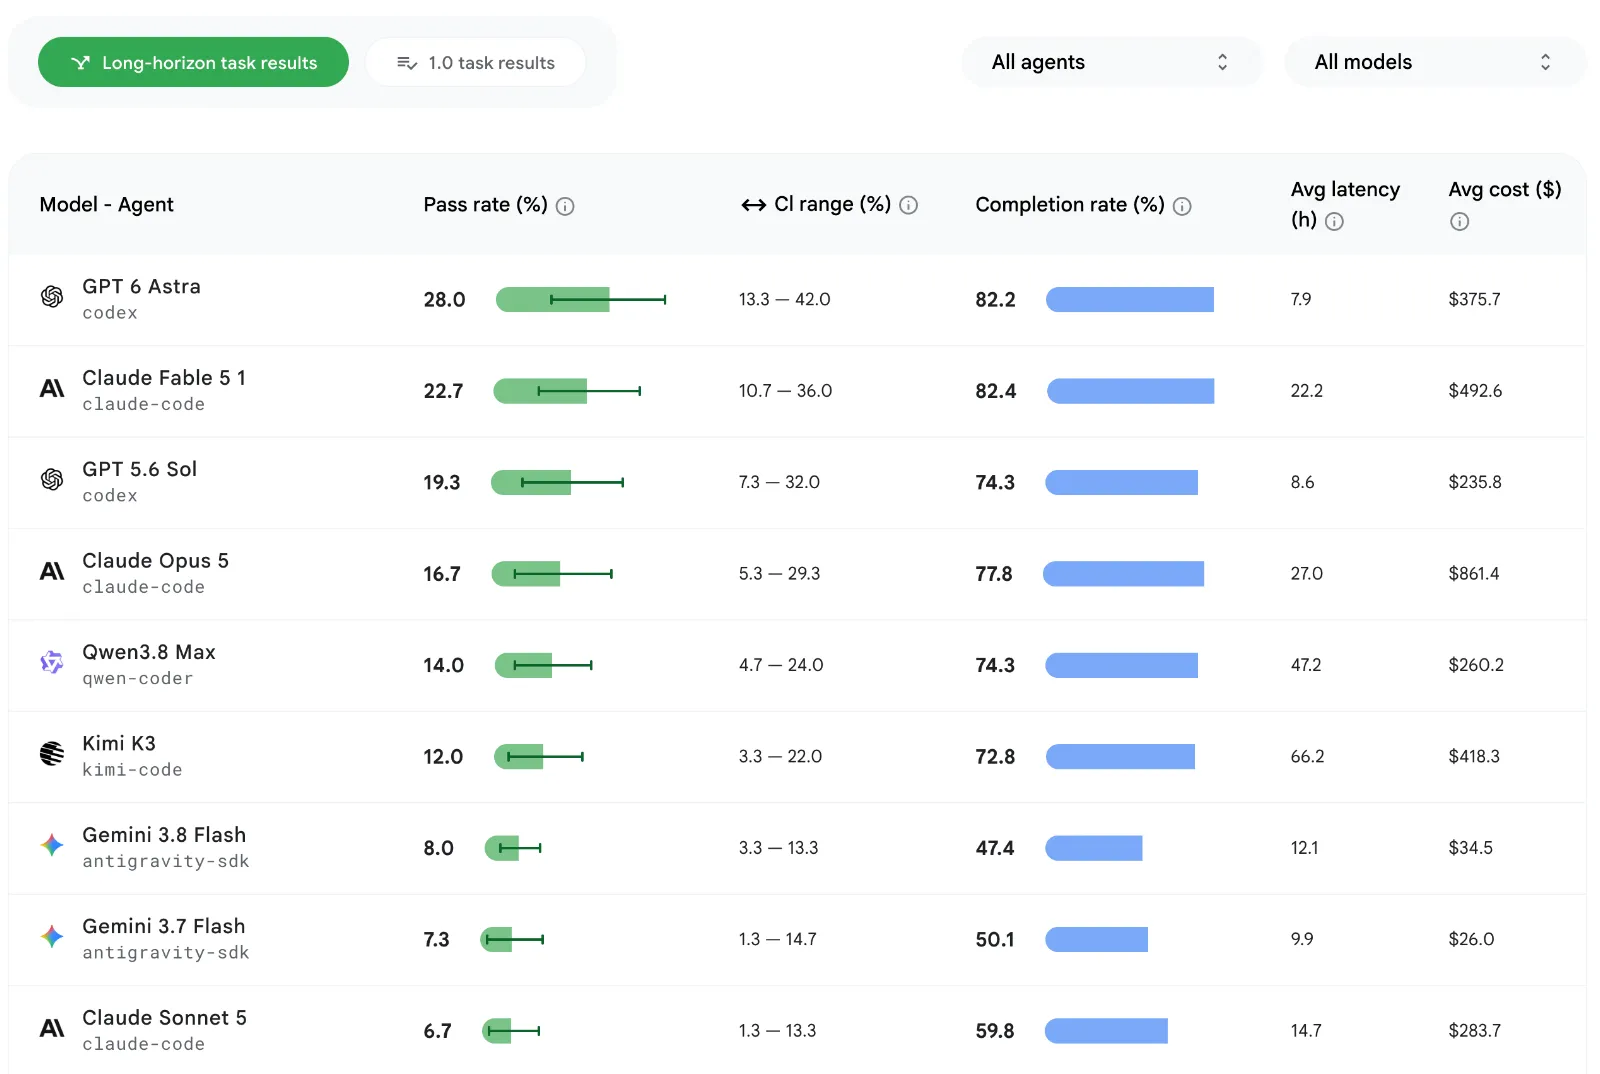
Nous calculons ce taux de complétion en combinant des facteurs tels que la fonctionnalité, la fidélité visuelle et l'absence de régressions. Nous appliquons également des pénalités de notation objectives en cas d'écart par rapport aux instructions d'évaluation ou aux contraintes structurelles. Consultez le classement mis à jour et cliquez sur la vue Fiche de chaque modèle pour afficher des éléments supplémentaires tels que le taux de réussite, le taux d'achèvement et les coûts moyens par modèle et par tâche.
Le taux de réussite le plus élevé pour les LHT est d'environ 28 %, ce qui est bien inférieur aux quelque 91 % pour les tâches d'origine du benchmark.
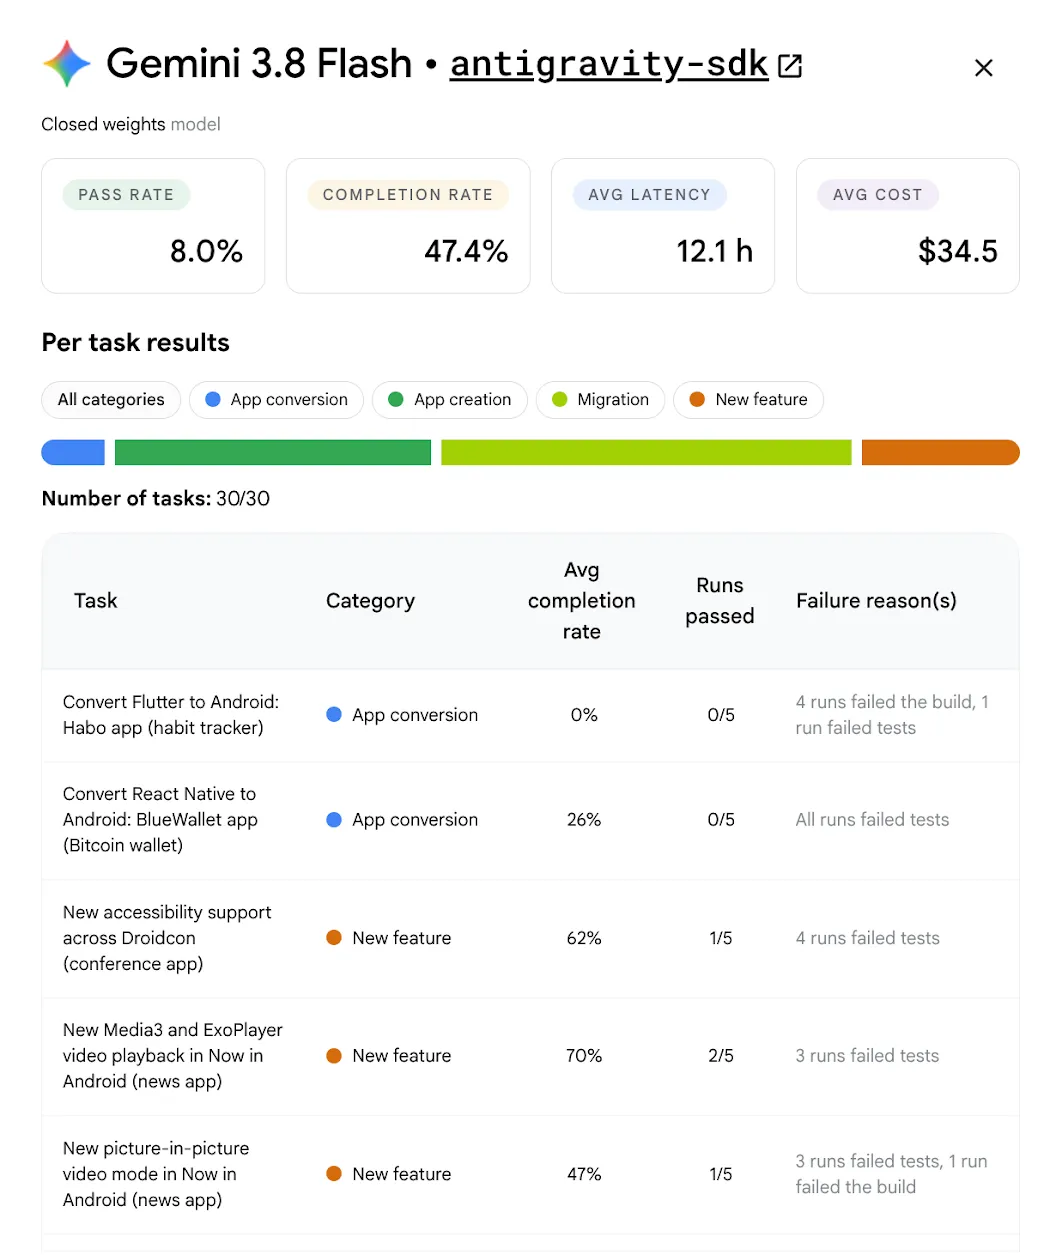
Les tâches à long horizon révèlent des insights utiles pour l'assistance IA
Au-delà de la mesure de la capacité de l'IA à gérer des tâches de longue durée, l'ensemble de données LHT nous aide à en savoir plus sur les forces et les faiblesses des modèles testés, et nous vous proposons des conseils plus pratiques.
Quel que soit le niveau du modèle, l'IA est plus efficace pour écrire du code que pour refactoriser du code existant. Les refactorisations et les migrations deviennent plus complexes, car leur réussite dépend de la complexité de l'architecture plutôt que du volume de code.
Les modèles présentent de solides capacités pour les transformations déterministes bien établies, telles que la conversion de Java en Kotlin, le remplacement de Retrofit par Ktor ou l'introduction d'une couche ViewModel. Ils appliquent ces modèles de manière cohérente, même sur plus de 125 fichiers et 8 000 lignes de code.
Cependant, les modèles ont du mal lorsque les tâches nécessitent une validation au moment de l'exécution (comme des graphiques d'injection de dépendances manquants), impliquent des modifications de framework incompatibles ou se heurtent à des lacunes de connaissances avec des bibliothèques non publiées. Le portage d'applications multiplates-formes vers Android reste un défi de taille : aucun modèle n'atteint un taux de réussite de 100 %, et les modèles de frontière atteignent au maximum un taux de réussite de 80 %.
Présentation des évaluations d'agents
Pour vous aider à mieux comprendre les performances des modèles lorsqu'ils sont intégrés à vos workflows agentiques, nous ajoutons des agents couramment utilisés à notre évaluation. Nous commençons par exécuter de nouveaux modèles sur les LHT avec des agents du fournisseur de modèles correspondant. Par exemple, nous avons exécuté GPT 5.6 Sol sur Codex et Gemini 3.8 Flash sur Google Antigravity. Cette association montre l'impact positif de la conception du banc d'essai sur les résultats des développeurs, car nous avons vu que la mise en cache des prompts et l'affichage compact des fenêtres d'outils peuvent entraîner une réduction du nombre de jetons.
Nous étendrons cette fonctionnalité à l'avenir en mettant également en avant les résultats de différentes combinaisons de modèles et d'agents, afin de vous aider à découvrir celles qui fonctionnent le mieux pour vous et votre équipe.
Nous investissons dans cette mesure, car il est important que vous puissiez utiliser l'agent et le modèle de votre choix pour le développement Android. Nous vous en dirons plus dans les semaines à venir.
Nouveaux modèles ajoutés
De plus, nous continuons d'étendre notre classement pour vous assurer de disposer des données les plus récentes pour vos décisions de développement. Nous avons ajouté Gemini 3.8 Flash, Gemini 3.7 Flash, GPT-6 d'OpenAI, Fable 5.1 d'Anthropic, Kimi K3 et Qwen 3.8 Max. GPT-6 Astra d'OpenAI arrive en tête avec un taux de réussite de 28 %.
À venir
Android Bench 2.0 offre un environnement robuste pour mesurer l'IA pour le développement Android. En combinant des tâches à long horizon, une évaluation multimodale, des agents et un scoring continu, nous espérons permettre aux équipes de recherche en IA de créer des partenaires de code IA plus performants et plus fiables, et vous offrir plus de transparence sur vos options de développement d'IA.
Consultez le classement mis à jour ainsi que la méthodologie mise à jour. Vos commentaires influencent directement l'évolution d'Android Bench. Continuez donc à nous faire part de vos commentaires sur GitHub, ainsi que sur nos réseaux sociaux comme X et LinkedIn.
-
 Actualités sur les produits
Aujourd'hui, lors du Sommet des développeurs Android, nous annonçons la disponibilité générale de nombreux outils et API conçus pour éliminer les frictions quotidiennes et vous offrir plus de flexibilité pour créer d'excellentes applications Android.
Matthew McCullough • Temps de lecture : 4 min -
 Actualités sur les produits
À mesure que le développement agentique s'accélère, l'ingénierie Android atteint une nouvelle frontière passionnante : passer de la complétion de code assistée à des agents qui s'exécutent de bout en bout sous votre direction. Vous avez le choix et la flexibilité totale concernant les modèles et les agents que vous utilisez.
Jason Buchel • Temps de lecture : 3 min -
 Actualités sur les produits
En tant que développeur Android, vous disposez de nombreux choix concernant les agents, les LLM, les outils et les interfaces de ligne de commande (CLI) que vous utilisez pour développer des applications. Notre objectif est de vous aider à créer des applications Android esthétiques et de haute qualité, quelle que soit la méthode que vous choisissez.
Simona Milanovic • Temps de lecture : 4 min
Recevez chaque semaine les dernières informations sur le développement Android dans votre boîte de réception.