Android Bench 2.0: Neue Maßstäbe mit anspruchsvollen langfristigen Aufgaben
Lesezeit: 3 Minuten
Als wir Android Bench eingeführt haben, haben wir eine solide Grundlage für die Bewertung der Unterstützung von Entwicklern durch Large Language Models (LLMs) bei realen Android-Aufgaben geschaffen. Da sich KI-Modelle und ‑Agenten rasant weiterentwickeln, haben wir unsere Methodik aktualisiert und beispielsweise unser Benchmark-Framework an das Harbor-Framework angepasst. Heute veröffentlichen wir die ersten langfristigen Aufgaben (Long-Horizon Tasks, LHT). Das sind sehr komplexe Aufgaben, für die ein Entwickler mehrere Tage oder sogar eine Woche benötigt. Außerdem führen wir die agentische Bewertung ein, beginnend mit Agenten von entsprechenden Modellanbietern. Mit dieser Ergänzung sind wir jetzt bei Android Bench 2.0 angelangt – einem wichtigen Upgrade, mit dem KI-Modelle und ‑Agenten im Hinblick auf die Skalierbarkeit, Mehrdeutigkeit und komplexe mehrstufige Problemlösung bewertet werden können, mit denen Sie täglich zu tun haben.
Von inkrementellen Fehlerbehebungen bis hin zu langfristigen Aufgaben
Die erste Version von Android Bench und ähnliche frühe KI-Benchmarks für die Programmierung konzentrierten sich auf inkrementelle Änderungen an bestehenden Repositories, die in vielen Fällen auf Fehlerkorrekturen oder kleinere Feature Requests beschränkt waren. Dies war ein Spiegelbild der damaligen Fähigkeiten der KI-Unterstützung und der Art und Weise, wie Sie sie verwendet haben.
Damit Sie auch weiterhin die Modelle und KI-Agenten finden, die am besten zu Ihrem Entwicklungs-Workflow passen, haben wir die Anforderungen unserer Bewertungen erhöht, um sie an die Arbeit anzupassen, die Sie an die KI delegieren. Android Bench 2.0 spiegelt diese anspruchsvollen Herausforderungen mit LHTs wider, die das Aktualisieren von Abhängigkeiten, das Hinzufügen neuer Funktionen, das Erstellen von Apps von Grund auf oder das Konvertieren einer plattformübergreifenden App zu Android umfassen.
Komplexe Aufgaben erfordern eine differenziertere Bewertung und Benotung.
Bei mehrtägigen Engineering-Aufgaben reicht eine binäre Bewertung (bestanden oder nicht bestanden) nicht aus, um ein vollständiges Bild zu erhalten.
Ein KI-Agent könnte beispielsweise 40 Bildschirme in Jetpack Compose refaktorieren, Datenbanktabellen einrichten und 90 % der Anforderungen erfüllen, aber bei einer einzelnen Edge-Case-Assertion scheitern. Bei der binären Bewertung wird dieser Durchlauf mit 0 % bewertet, wodurch die architektonischen Fähigkeiten des Modells verschleiert werden. Wir stellen auf eine kontinuierliche Bewertung um, um ein aussagekräftigeres Signal zu liefern, sowohl für die Modellentwicklung als auch für Ihr Verständnis davon, wie KI Ihnen helfen kann.
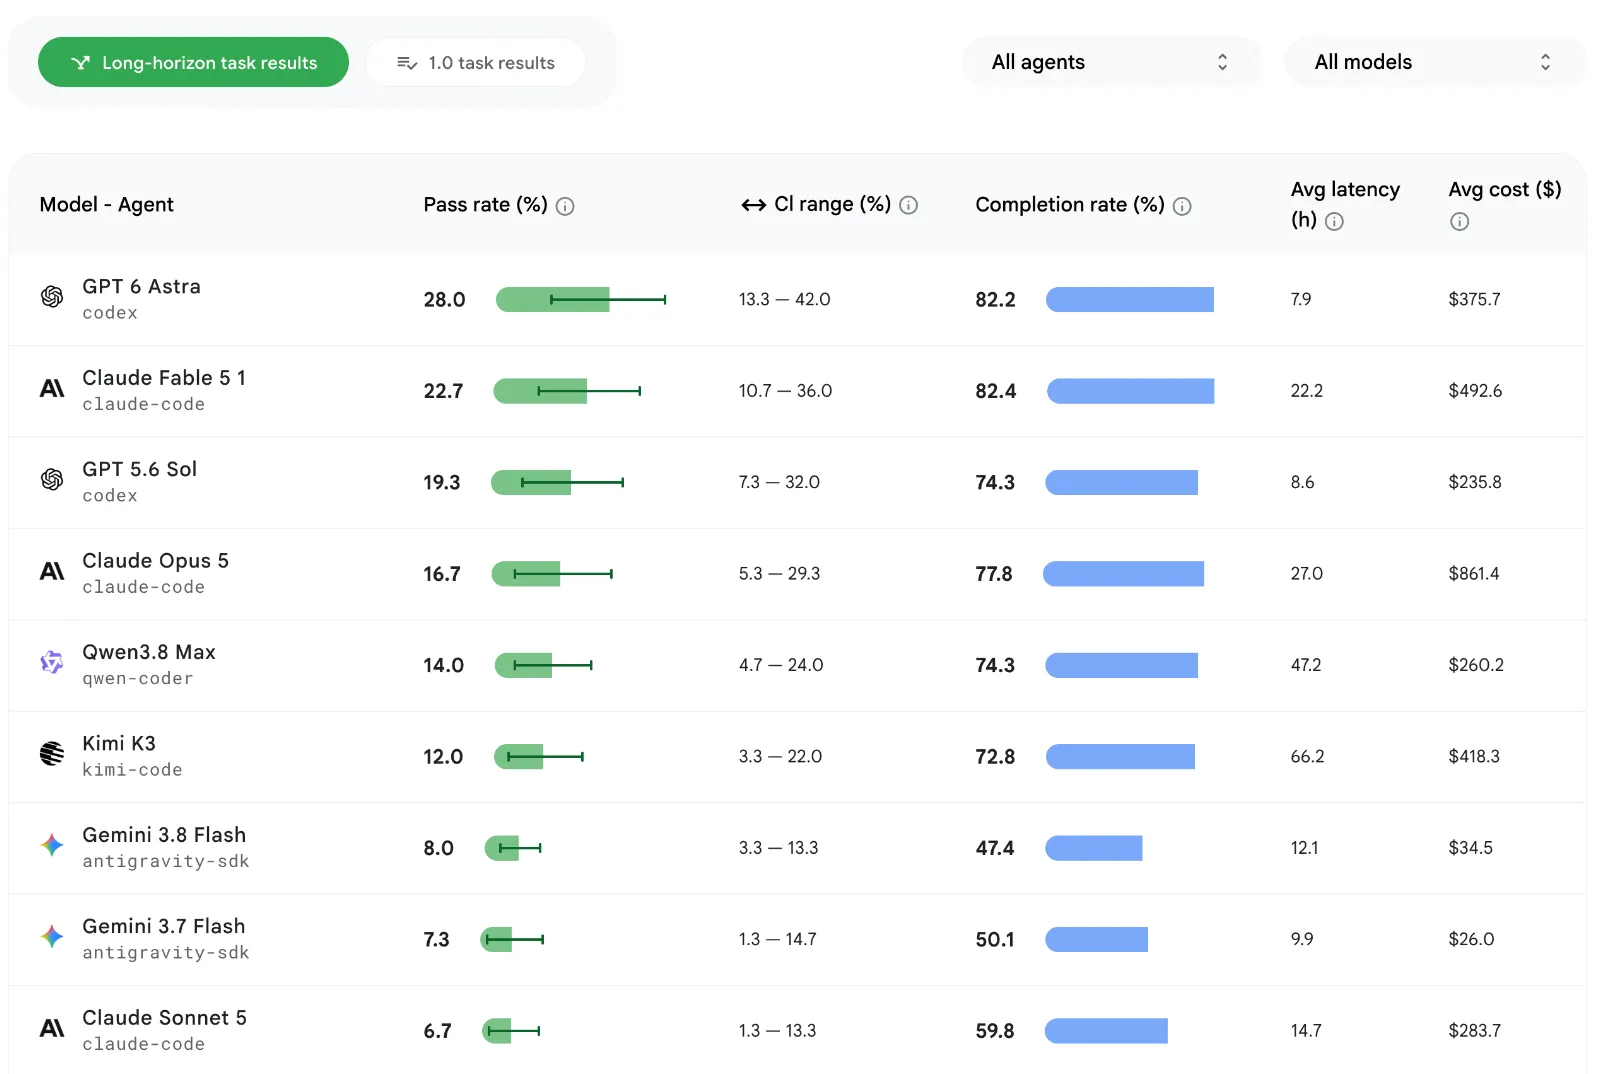
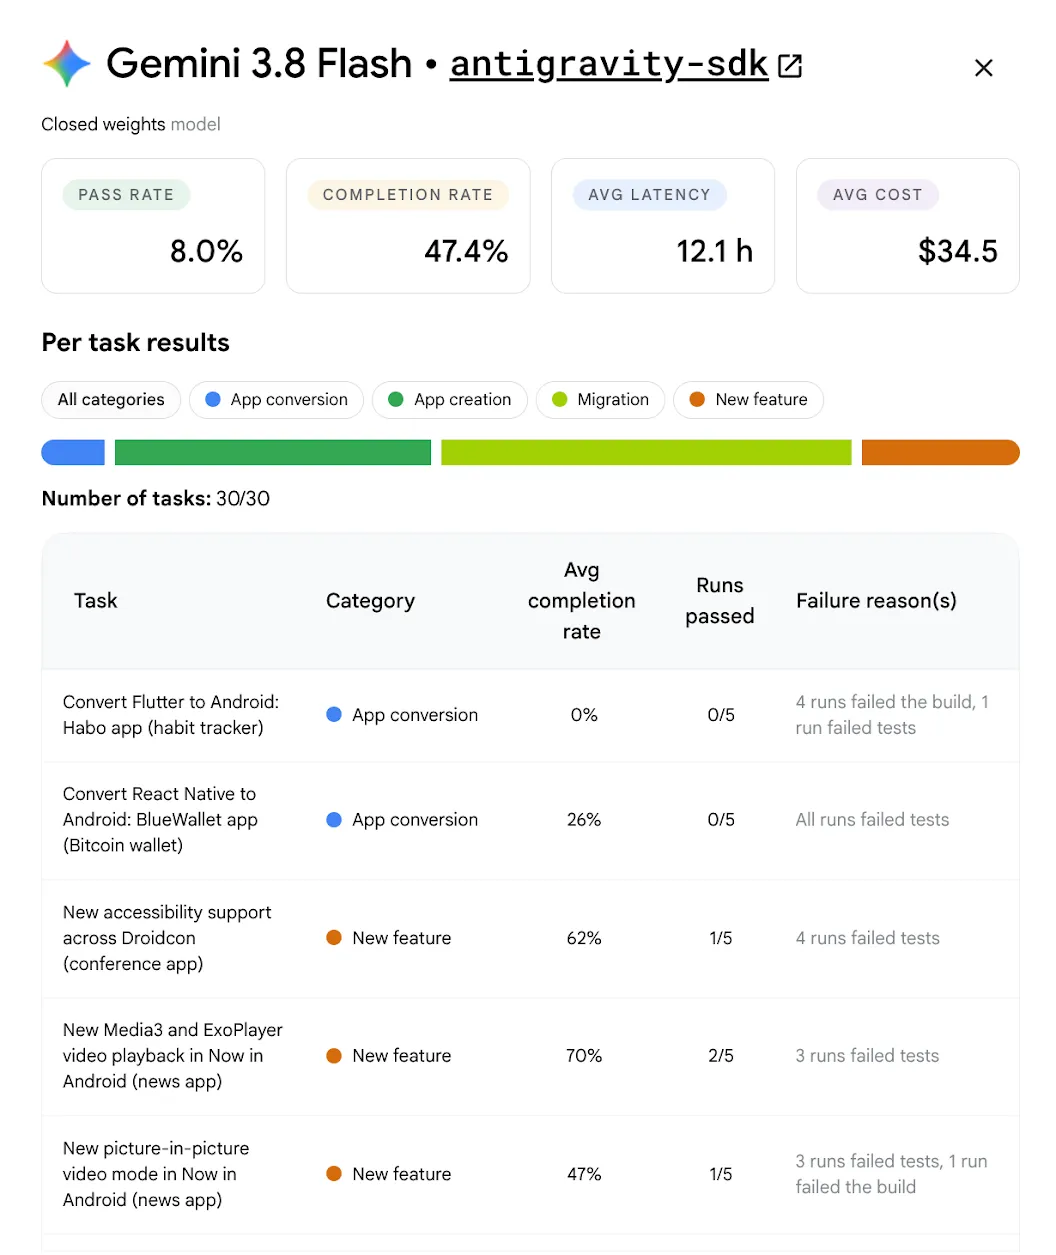
Wir berechnen diese Abschlussrate anhand einer Kombination von Faktoren wie Funktionalität, visueller Wiedergabetreue und Vermeidung von Regressionen. Außerdem wenden wir objektive Punktabzüge für Abweichungen von den Bewertungsanweisungen oder strukturellen Einschränkungen an. Sehen Sie sich die aktualisierte Bestenliste an und klicken Sie auf die Kartenansicht der einzelnen Modelle, um zusätzliche Elemente wie die Erfolgsquote, die Abschlussrate und die durchschnittlichen Kosten pro Modell und Aufgabe zu sehen.
Die höchste Erfolgsquote für LHTs liegt bei etwa 28 % und damit deutlich unter den rund 91 % für die ursprünglichen Aufgaben im Benchmark.
Langfristige Aufgaben liefern hilfreiche Informationen für die KI-Unterstützung
Mit dem LHT-Dataset können wir nicht nur messen, wie gut die KI langwierige Aufgaben bewältigt, sondern auch mehr über die Stärken und Schwächen der getesteten Modelle erfahren und Ihnen praktische Tipps geben.
Über alle Modellstufen hinweg ist KI besser darin, neuen Code zu schreiben, als vorhandenen Code zu refaktorieren. Refaktorierungen und Migrationen werden schwieriger, da der Erfolg eher von der architektonischen Komplexität als vom Codevolumen abhängt.
Die Modelle zeigen starke Fähigkeiten bei etablierten, deterministischen Transformationen, z. B. beim Konvertieren von Java zu Kotlin, beim Ersetzen von Retrofit durch Ktor oder beim Einführen einer ViewModel-Ebene. Diese Muster werden konsistent angewendet, sogar über mehr als 125 Dateien und mehr als 8.000 Codezeilen hinweg.
Modelle haben jedoch Schwierigkeiten, wenn Aufgaben eine Laufzeitvalidierung erfordern (z. B. fehlende Dependency-Injection-Diagramme), wenn es zu grundlegenden Änderungen am Framework kommt oder wenn es Wissenslücken bei unveröffentlichten Bibliotheken gibt. Die Portierung plattformübergreifender Apps auf Android bleibt eine Herausforderung. Kein Modell erreicht eine Erfolgsquote von 100 % und Frontier-Modelle erreichen maximal eine Abschlussquote von 80 %.
Einführung in die Bewertung von KI-Agenten
Damit Sie besser nachvollziehen können, wie Modelle in Ihren Agentic Workflows funktionieren, fügen wir unserer Bewertung häufig verwendete Agenten hinzu. Wir beginnen damit, neue Modelle mit Agenten des entsprechenden Modellanbieters gegen LHTs auszuführen. Wir haben beispielsweise GPT 5.6 Sol auf Codex und Gemini 3.8 Flash auf Google Antigravity ausgeführt. Diese Kombination zeigt, wie sich das Design des Harness positiv auf die Entwicklerergebnisse auswirkt, da Prompt-Caching und kompakte Toolfenster zu einer Reduzierung der Tokens führen können.
In Zukunft werden wir diese Funktion erweitern und auch Ergebnisse für verschiedene Kombinationen aus Modellen und KI-Agenten hervorheben. So können Sie herausfinden, welche Kombinationen für Sie und Ihr Team am besten geeignet sind.
Wir investieren in diese Messung, weil es wichtig ist, dass Sie den Agenten und das Modell Ihrer Wahl für die Android-Entwicklung verwenden können. In den kommenden Wochen werden wir Ihnen weitere Informationen dazu geben.
Neue Modelle hinzugefügt
Außerdem erweitern wir unsere Bestenliste kontinuierlich, damit Sie immer die aktuellsten Daten für Ihre Entwicklungsentscheidungen haben. Wir haben Gemini 3.8 Flash, Gemini 3.7 Flash, GPT-6 von OpenAI, Fable 5.1 von Anthropic, Kimi K3 und Qwen 3.8 Max hinzugefügt. GPT-6 Astra von OpenAI lag mit einer Erfolgsquote von 28 % an der Spitze.
Zukunftspläne
Android Bench 2.0 bietet eine robuste Umgebung zum Messen von KI für die Android-Entwicklung. Durch die Kombination von langfristigen Aufgaben, multimodaler Bewertung, Agents und kontinuierlicher Bewertung möchten wir KI-Forschungsteams in die Lage versetzen, leistungsfähigere und zuverlässigere KI-Coding-Assistenten zu entwickeln. Außerdem möchten wir Ihnen mehr Transparenz über Ihre Optionen für die KI-Entwicklung bieten.
Sehen Sie sich die aktualisierte Bestenliste und die aktualisierte Methodik an. Ihr Feedback hat direkten Einfluss darauf, wie wir Android Bench weiterentwickeln. Bitte teilen Sie uns Ihr Feedback weiterhin auf GitHub sowie auf unseren Social-Media-Kanälen wie X und LinkedIn mit.
-
 Produktneuigkeiten
Heute kündigen wir auf dem Android Dev Summit die allgemeine Verfügbarkeit vieler Tools und APIs an, die die tägliche Arbeit erleichtern und Ihnen mehr Flexibilität bei der Entwicklung großartiger Android-Apps bieten sollen.
Matthew McCullough • Lesezeit: 4 Minuten -
 Produktneuigkeiten
Mit der rasanten Entwicklung von KI-Agenten erreicht die Android-Entwicklung einen spannenden neuen Meilenstein: von der unterstützenden Codevervollständigung hin zu KI-Agenten, die unter Ihrer Anleitung End-to-End-Aufgaben ausführen. Sie haben die volle Auswahl und Flexibilität bei den Modellen und Agenten, die Sie verwenden.
Jason Buchel • Lesezeit: 3 Minuten -
 Produktneuigkeiten
Als Android-Entwickler haben Sie viele Möglichkeiten, wenn es um die Agenten, LLMs, Tools und Befehlszeilen (CLI) geht, die Sie für die App-Entwicklung verwenden. Unser Ziel ist es, Sie bei der Entwicklung ansprechender, hochwertiger Android-Apps zu unterstützen, unabhängig davon, wie Sie diese entwickeln.
Simona Milanovic • Lesezeit: 4 Minuten
Lassen Sie sich Woche für Woche die neuesten Informationen zur Android-Entwicklung zusenden.