Как работает очередь сообщений без блокировки в Android 17
Время на чтение: 16 минут
В Android 17 приложения, использующие SDK версии 37 или более поздней, получат новую реализацию MessageQueue, в которой не используются блокировки. Новая реализация повышает производительность и уменьшает количество пропущенных кадров, но может нарушить работу клиентов, которые используют частные поля и методы MessageQueue. Чтобы узнать больше об изменении поведения и о том, как уменьшить его влияние, ознакомьтесь с документацией по изменению поведения MessageQueue. В этой статье технического блога рассказывается о новой архитектуре MessageQueue и о том, как анализировать проблемы с блокировкой с помощью Perfetto.
Looper управляет потоком UI каждого приложения для Android. Он получает задачи из MessageQueue, отправляет их в Handler и повторяет этот процесс. В течение двух десятилетий MessageQueue использовал для защиты своего состояния одну блокировку монитора (то есть блок кода synchronized).
В Android 17 этот компонент был значительно обновлен: теперь он называется DeliQueue и не использует блокировку.
В этой статье рассказывается, как блокировки влияют на производительность интерфейса, как анализировать эти проблемы с помощью Perfetto, а также о конкретных алгоритмах и оптимизациях, используемых для улучшения основного потока Android.
Проблема: конкуренция за блокировку и инверсия приоритетов
Устаревшая функция MessageQueue работала как очередь с приоритетами, защищенная одной блокировкой. Если фоновый поток публикует сообщение, пока основной поток выполняет обслуживание очереди, фоновый поток блокирует основной поток.
Когда два или более потоков конкурируют за эксклюзивное использование одной и той же блокировки, это называется конфликтом блокировки. Такое соперничество может привести к инверсии приоритетов, из-за чего интерфейс будет работать нестабильно и возникнут другие проблемы с производительностью.
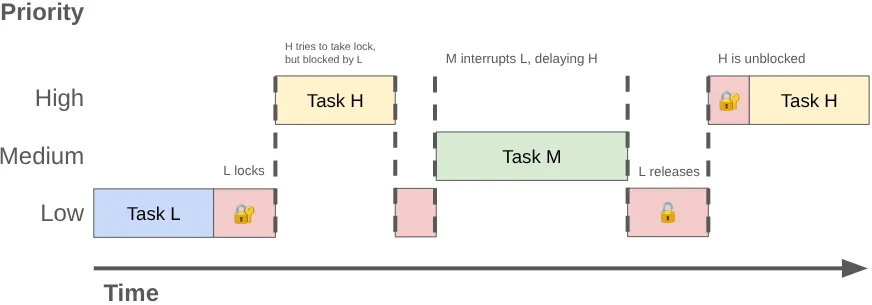
Инверсия приоритета может произойти, когда поток с высоким приоритетом (например, поток UI) вынужден ждать поток с низким приоритетом. Рассмотрим следующую последовательность:
- Фоновый поток с низким приоритетом получает блокировку
MessageQueue, чтобы опубликовать результат своей работы. - Поток среднего приоритета становится готовым к выполнению, и планировщик ядра выделяет ему время процессора, прерывая поток низкого приоритета.
- Поток интерфейса высокого приоритета завершает текущую задачу и пытается прочитать данные из очереди, но блокируется, поскольку поток низкого приоритета удерживает блокировку.
Поток с низким приоритетом блокирует поток UI, а задача со средним приоритетом ещё больше задерживает его.
Анализ конфликтов с помощью Perfetto
Вы можете диагностировать эти проблемы с помощью Perfetto. В стандартной трассировке поток, заблокированный на мониторе, переходит в спящий режим, а Perfetto показывает фрагмент, указывающий на владельца блокировки.
При запросе данных трассировки ищите фрагменты с названием "monitor contention with …" (конфликт монитора с…), за которым следует название потока, владеющего блокировкой, и место в коде, где она была получена.
Пример использования: временное зависание панели запуска
Чтобы проиллюстрировать это, давайте проанализируем трассировку, в которой пользователь столкнулся с временным зависанием при переходе на главный экран телефона Pixel сразу после того, как сделал фотографию в приложении камеры. Ниже приведен скриншот Perfetto, на котором показаны события, предшествовавшие пропущенному кадру:
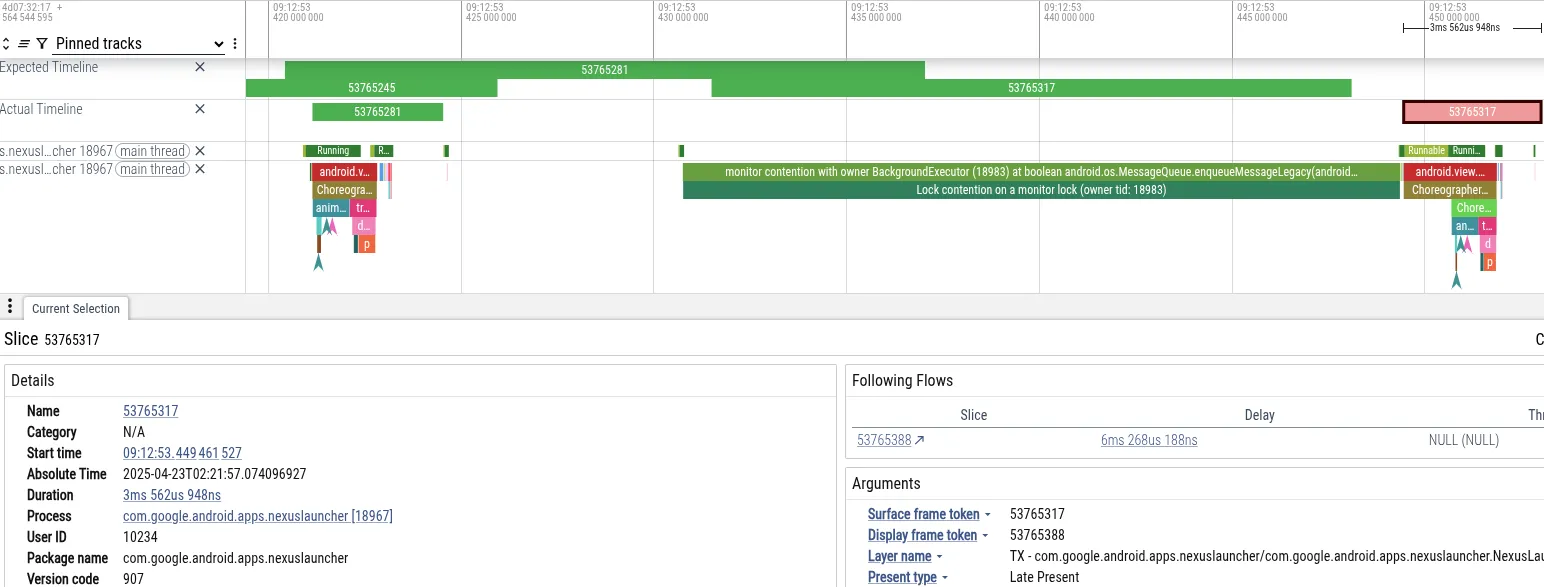
- Симптом. Основной поток программы запуска не успел обработать кадр в отведенное время. Он был заблокирован на 18 мс, что превышает крайний срок в 16 мс, необходимый для отрисовки с частотой 60 Гц.
- Диагностика. Perfetto показал, что основной поток заблокирован на блокировке
MessageQueue. Блокировка принадлежала потоку BackgroundExecutor. - Основная причина. BackgroundExecutor работает с Process.THREAD_PRIORITY_BACKGROUND (очень низким приоритетом). Выполнялась несрочная задача (проверка ограничений на использование приложений). В то же время потоки со средним приоритетом использовали время процессора для обработки данных с камеры. Планировщик ОС прервал поток BackgroundExecutor, чтобы запустить потоки камеры.
Из-за этой последовательности действий поток UI запуска (высокий приоритет) оказался косвенно заблокирован рабочим потоком камеры (средний приоритет), который не позволял фоновому потоку запуска (низкий приоритет) снять блокировку.
Запросы к трассировкам с помощью PerfettoSQL
Вы можете использовать PerfettoSQL, чтобы запрашивать данные трассировки для определенных шаблонов. Это полезно, если у вас много трассировок с устройств пользователей или тестов и вы ищете определенные трассировки, которые демонстрируют проблему.
Например, следующий запрос позволяет найти конфликты MessageQueue, совпадающие с пропущенными кадрами (рывками):
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.frames.jank_type;

SELECT
  process_name,
  -- Convert duration from nanoseconds to milliseconds
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM android_monitor_contention
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"

-- Only look at app processes that had jank
AND upid IN (
  SELECT DISTINCT(upid)
  FROM actual_frame_timeline_slice
  WHERE android_is_app_jank_type(jank_type) = TRUE
)
GROUP BY process_name
ORDER BY SUM(dur) DESC;
В этом более сложном примере показано, как объединить данные трассировки из нескольких таблиц, чтобы выявить конфликты MessageQueue во время запуска приложения:
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.startup.startups;

-- Join package and process information for startups
DROP VIEW IF EXISTS startups;
CREATE VIEW startups AS
SELECT startup_id, ts, dur, upid
FROM android_startups
JOIN android_startup_processes USING(startup_id);

-- Intersect monitor contention with startups in the same process.
DROP TABLE IF EXISTS monitor_contention_during_startup;
CREATE VIRTUAL TABLE monitor_contention_during_startup
USING SPAN_JOIN(android_monitor_contention PARTITIONED upid, startups PARTITIONED upid);

SELECT
  process_name,
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM monitor_contention_during_startup
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"
GROUP BY process_name
ORDER BY SUM(dur) DESC;
Вы можете использовать свою любимую БЯМ, чтобы написать запросы PerfettoSQL и найти другие закономерности.
В Google мы используем BigTrace для выполнения запросов PerfettoSQL по миллионам трассировок. В результате мы подтвердили, что наблюдаемые нами случаи были не единичными, а системными. Данные показали, что MessageQueueконфликт блокировок влияет на пользователей во всей экосистеме, что подтверждает необходимость фундаментальных изменений в архитектуре.
Решение: параллельное выполнение без блокировок
Мы решили проблему с конфликтами MessageQueue, реализовав структуру данных без блокировок, в которой для синхронизации доступа к общему состоянию используются атомарные операции с памятью, а не эксклюзивные блокировки. Структура данных или алгоритм не блокируются, если хотя бы один поток всегда может продвигаться вперед независимо от поведения планировщика других потоков. Обычно этого свойства сложно достичь, и в большинстве случаев оно не стоит усилий.
Атомарные примитивы
В программном обеспечении без блокировок часто используются атомарные примитивы чтения-модификации-записи, предоставляемые оборудованием.
На процессорах ARM64 более ранних поколений атомарные операции выполнялись с помощью цикла Load-Link/Store-Conditional (LL/SC). Процессор загружает значение и отмечает адрес. Если другой поток записывает данные по этому адресу, сохранение не удается и цикл повторяется. Поскольку потоки могут продолжать попытки и успешно завершить их, не дожидаясь другого потока, эта операция не требует блокировки.
ARM64 LL/SC loop example
retry:
    ldxr    x0, [x1]        // Load exclusive from address x1 to x0
    add     x0, x0, #1      // Increment value by 1
    stxr    w2, x0, [x1]    // Store exclusive.
                            // w2 gets 0 on success, 1 on failure
cbnz w2, retry // If w2 is non-zero (failed), branch to retr(посмотреть в Compiler Explorer)
Более новые архитектуры ARM (ARMv8.1) поддерживают расширения для больших систем (LSE), которые включают инструкции в форме Compare-And-Swap (CAS) или Load-And-Add (показано ниже). В Android 17 мы добавили в компилятор Android Runtime (ART) поддержку обнаружения LSE и создания оптимизированных инструкций:
/ ARMv8.1 LSE atomic example
ldadd   x0, x1, [x2]    // Atomic load-add.
                        // Faster, no loop required.
В наших тестах код с высокой конкуренцией, использующий CAS, работает примерно в три раза быстрее, чем вариант с LL/SC.
Язык программирования Java предлагает атомарные примитивы через java.util.concurrent.atomic, которые опираются на эти и другие специализированные инструкции ЦП.
Структура данных: DeliQueue
Чтобы устранить конфликты блокировок в MessageQueue, наши инженеры разработали новую структуру данных под названием DeliQueue. DeliQueue разделяет вставку Message и обработку Message:
- Список
Messages(стек Treiber): стек без блокировок. Любой поток может без конфликтов помещать в эту очередь новые значенияMessages. - Очередь приоритетов (минимальная куча): куча из
Messages, предназначенная для обработки и принадлежащая потоку Looper (поэтому для доступа к ней не требуется синхронизация или блокировка).
Enqueue: добавление в стек Treiber
Список Messages хранится в стеке Трайбера [1] – стеке без блокировки, который использует цикл CAS для обновления указателя на вершину.
public class TreiberStack <E> {
    AtomicReference<Node<E>> top =
            new AtomicReference<Node<E>>();
    public void push(E item) {
        Node<E> newHead = new Node<E>(item);
        Node<E> oldHead;
        do {
            oldHead = top.get();
            newHead.next = oldHead;
        } while (!top.compareAndSet(oldHead, newHead));
    }

    public E pop() {
        Node<E> oldHead;
        Node<E> newHead;
        do {
            oldHead = top.get();
            if (oldHead == null) return null;
            newHead = oldHead.next;
        } while (!top.compareAndSet(oldHead, newHead));
        return oldHead.item;
    }
}
Исходный код на основе книги "Параллельное программирование на Java" [2], доступной онлайн и опубликованной в общественном достоянии.
Любой производитель может в любой момент добавить в стек новые Message. Это похоже на получение талона в магазине: ваш номер зависит от того, когда вы пришли, но порядок обслуживания может быть другим. Поскольку это связанный стек, каждый элемент Message является подстеком. Вы можете узнать, какой была очередь Message в любой момент времени, отслеживая начало и переходя к следующему элементу. Новые элементы Message не будут добавляться сверху, даже если они добавляются во время вашего обхода.
Dequeue: массовый перенос в минимальную кучу
Чтобы найти следующий объект Message для обработки, Looper обрабатывает новые объекты Message из стека Treiber, начиная с верхнего элемента и перебирая их, пока не найдет последний обработанный объект Message. По мере того как Looper перемещается вниз по стеку, он вставляет Message в минимальную кучу, упорядоченную по сроку. Поскольку куча принадлежит исключительно Looper, он упорядочивает и обрабатывает Message без блокировок и атомарных операций.
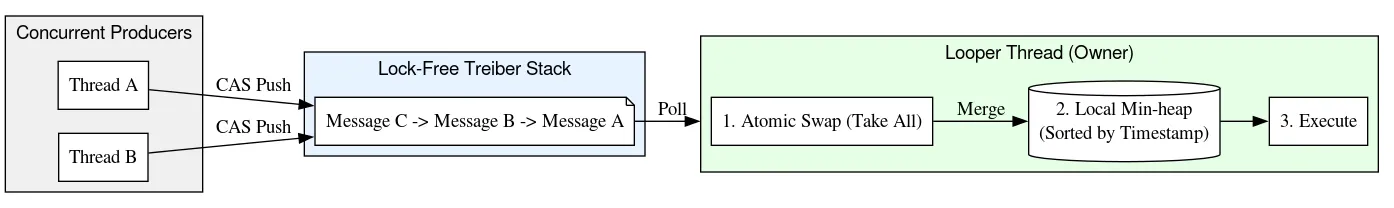
При переходе по стеку Looper также создает ссылки от сложенных Message на их предшественников, образуя таким образом двусвязный список. Создание связанного списка безопасно, поскольку ссылки, указывающие вниз по стеку, добавляются с помощью алгоритма стека Treiber с CAS, а ссылки вверх по стеку только считываются и изменяются потоком Looper. Эти обратные ссылки используются для удаления Message из произвольных точек стека за время O(1).
Такая структура обеспечивает вставку O(1) для производителей (потоков, отправляющих задания в очередь) и амортизированную обработку O(log N) для потребителя (Looper).
Использование минимальной кучи для упорядочивания Message также устраняет фундаментальный недостаток устаревшей версии MessageQueue, в которой Message хранились в односвязном списке (с корнем вверху). В устаревшей реализации удаление из начала очереди выполнялось за время O(1), а вставка – за время O(N), поэтому при перегрузке очереди производительность снижалась. Вставка и удаление из минимальной кучи, напротив, масштабируются логарифмически, обеспечивая конкурентоспособную среднюю производительность и особенно хорошие результаты при больших задержках.
Устаревшая версия (заблокировано) MessageQueue | DeliQueue | |
| Вставить | O(N) | O(1) для цепочки вызовов O(logN) для потока |
| Сними головной убор | O(1) | O(logN) |
В устаревшей реализации очереди производители и потребитель использовали блокировку для координации эксклюзивного доступа к базовому односвязному списку. В DeliQueue стек Treiber обрабатывает одновременный доступ, а единственный потребитель управляет очередью задач.
Удаление: согласованность с помощью надгробий
DeliQueue – это гибридная структура данных, сочетающая неблокируемый стек Трайбера с однопоточной минимальной кучей. Синхронизация этих двух структур без глобальной блокировки представляет собой уникальную проблему: письмо может физически присутствовать в стеке, но логически удалено из очереди.
Чтобы решить эту проблему, DeliQueue использует метод, который называется "надгробие". Каждый элемент Message отслеживает свое положение в стеке с помощью указателей вперед и назад, свой индекс в массиве кучи и логический флаг, указывающий, был ли он удален. Когда Message готов к выполнению, поток Looper с помощью CAS устанавливает флаг удаления, а затем удаляет из кучи и стека.
Когда другому потоку нужно удалить Message, он не сразу извлекает его из структуры данных. шаблона:
- Логическое удаление: поток использует CAS, чтобы атомарно установить флаг удаления
Messageиз false в true.Messageостается в структуре данных как свидетельство того, что его удаление запланировано. Это так называемый "надгробный камень". После того какMessageпомечен для удаления, DeliQueue считает, что его больше нет в очереди. - Отложенная очистка. Фактическое удаление из структуры данных выполняется потоком
Looperпозже. Вместо того чтобы изменять стек или кучу, поток удаления добавляетMessageв другой стек freelist без блокировки. - Структурное удаление. Только
Looperможет взаимодействовать с кучей или удалять элементы из стека. Когда устройство просыпается, оно очищает список и обрабатывает содержащиеся в немMessages. После этого каждый файлMessageотвязывается от стека и удаляется из кучи.
При таком подходе управление кучей выполняется в одном потоке. Это позволяет сократить количество одновременно выполняемых операций и барьеров памяти, что делает критический путь быстрее и проще.
Переход: безопасные гонки данных в модели памяти Java
Большинство API для параллельного выполнения, например Future в стандартной библиотеке Java или Job и Deferred в Kotlin, включают механизм отмены работы до ее завершения. Экземпляр одного из этих классов соответствует единице выполняемой работы, а вызов cancel для объекта отменяет связанные с ним операции.
Современные устройства Android оснащены многоядерными процессорами и поддерживают параллельную поколенческую сборку мусора. Но когда Android только разрабатывался, выделять по объекту на каждую задачу было слишком дорого. Поэтому в Android Handler поддерживает отмену с помощью многочисленных перегрузок removeMessages – вместо того чтобы удалить определенный Message, он удаляет все Message, соответствующие указанным критериям. На практике это означает, что нужно перебрать все элементы Message, вставленные до вызова removeMessages, и удалить те из них, которые соответствуют условию.
При переходе вперед потоку требуется только одна упорядоченная атомарная операция для чтения текущего верхнего элемента стека. После этого для поиска следующего значения Message используются обычные операции чтения полей. Если поток Looper изменяет поля next при удалении Message, запись Looper и чтение другого потока не синхронизируются. Это состояние гонки. Обычно гонка данных – это серьезная ошибка, которая может привести к утечкам, бесконечным циклам, сбоям, зависаниям и другим проблемам в приложении. Однако в определенных узких условиях гонки данных могут быть безопасными в рамках модели памяти Java. Предположим, что у нас есть стопка из:

Мы выполняем атомарное чтение заголовка и видим значение A. Следующий указатель A указывает на B. Пока мы обрабатываем B, объект looper может удалить B и C, обновив A так, чтобы она указывала на C, а затем на D.
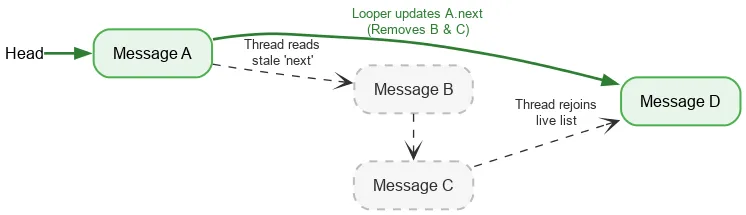
Несмотря на то что элементы B и C логически удалены, указатель next элемента B по-прежнему указывает на C, а указатель next элемента C – на D. Поток чтения продолжает проходить через отсоединенные удаленные узлы и в конечном итоге присоединяется к активному стеку в D.
Благодаря тому, что DeliQueue может обрабатывать конфликты между обходом и удалением, мы можем обеспечить безопасную итерацию без блокировок.
Выход: нативный счетчик ссылок
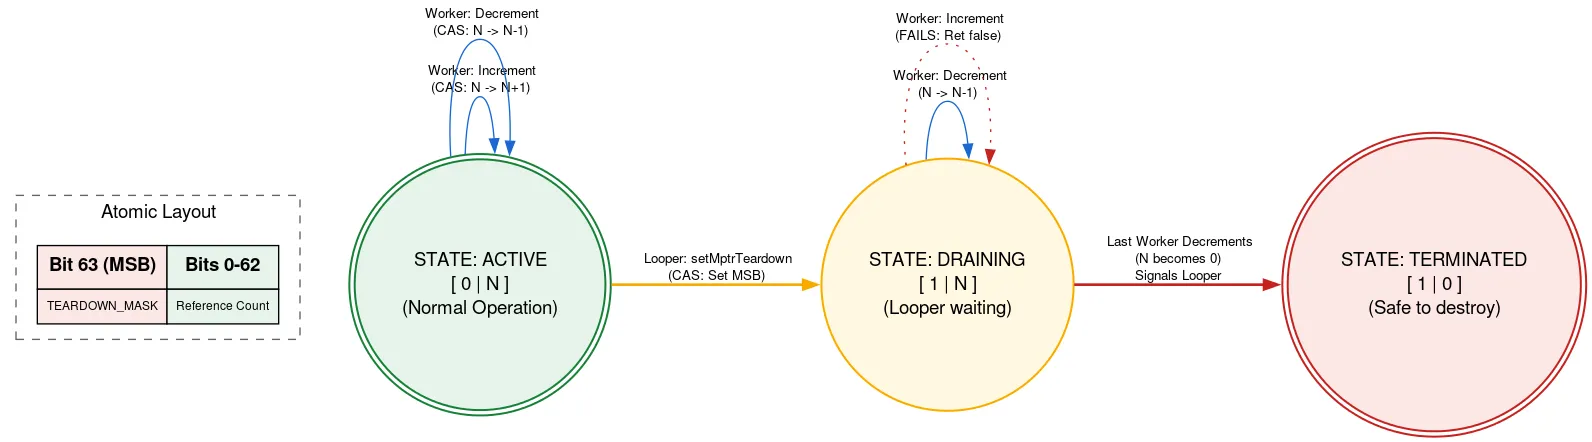
Looper поддерживается нативным распределением, которое необходимо освободить вручную после выхода из Looper. Если другой поток добавляет Messages, пока Looper завершает работу, он может использовать собственное распределение после освобождения памяти, что является нарушением безопасности памяти. Мы предотвращаем это с помощью тегированного счетчика ссылок, в котором один бит атомарного объекта используется для указания того, завершает ли работу Looper.
Перед использованием собственного распределения поток считывает атомарный счетчик ссылок. Если установлен бит выхода, возвращается сообщение о том, что Looper выходит из системы и нельзя использовать собственное распределение. В противном случае CAS пытается увеличить количество активных потоков, используя собственное распределение. После выполнения необходимых действий счетчик уменьшается. Если бит выхода был установлен после увеличения, но до уменьшения, и счетчик теперь равен нулю, то он пробуждает поток Looper.
Когда поток Looper готов к завершению, он использует CAS, чтобы установить бит завершения в атомарном объекте. Если счетчик ссылок равен 0, можно освободить выделенную память. В противном случае он переходит в режим ожидания, зная, что будет разбужен, когда последний пользователь собственного выделения уменьшит счетчик ссылок. Это означает, что поток Looper ожидает завершения других потоков, но только при выходе. Это происходит только один раз и не влияет на производительность. Благодаря этому остальной код для использования нативного распределения полностью свободен от блокировок.
В реализации есть много других хитростей и сложностей. Чтобы узнать больше о DeliQueue, изучите исходный код.
Оптимизация: программирование без ветвлений
Во время разработки и тестирования DeliQueue команда провела множество тестов и тщательно проанализировала новый код. Одна из проблем, выявленных с помощью инструмента simpleperf, – это сброс конвейера, вызванный кодом компаратора Message.
Стандартный компаратор использует условные переходы, а условие для определения того, какое из значений Message идет первым, упрощено следующим образом:
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    if (m1 == m2) {
        return 0;
    }

    // Primary queue order is by when.
    // Messages with an earlier when should come first in the queue.
    final long whenDiff = m1.when - m2.when;
    if (whenDiff > 0) return 1;
    if (whenDiff < 0) return -1;

    // Secondary queue order is by insert sequence.
    // If two messages were inserted with the same `when`, the one inserted
    // first should come first in the queue.
    final long insertSeqDiff = m1.insertSeq - m2.insertSeq;
    if (insertSeqDiff > 0) return 1;
    if (insertSeqDiff < 0) return -1;

    return 0;
}
Этот код компилируется в условные переходы (инструкции b.le и cbnz). Когда ЦП сталкивается с условным переходом, он не может узнать, будет ли он выполнен, пока не будет вычислено условие. Поэтому он не знает, какую инструкцию читать дальше, и должен угадать, используя метод предсказания ветвлений. В случае с двоичным поиском направление ветви на каждом шаге будет непредсказуемо меняться, поэтому, скорее всего, половина прогнозов окажется неверной. Предсказание ветвлений часто неэффективно в алгоритмах поиска и сортировки (например, в алгоритме, используемом в минимальной куче), поскольку цена ошибки выше, чем выигрыш от правильного предсказания. Если предсказатель переходов ошибся, он должен отменить все действия, выполненные после того, как было сделано предположение, и начать заново с пути, который был выбран на самом деле. Это называется очисткой конвейера.
Чтобы найти эту проблему, мы профилировали наши контрольные показатели с помощью счетчика производительности branch-misses, который записывает трассировки стека, где предсказатель ветвлений ошибается. Затем мы визуализировали результаты с помощью Google pprof, как показано ниже:
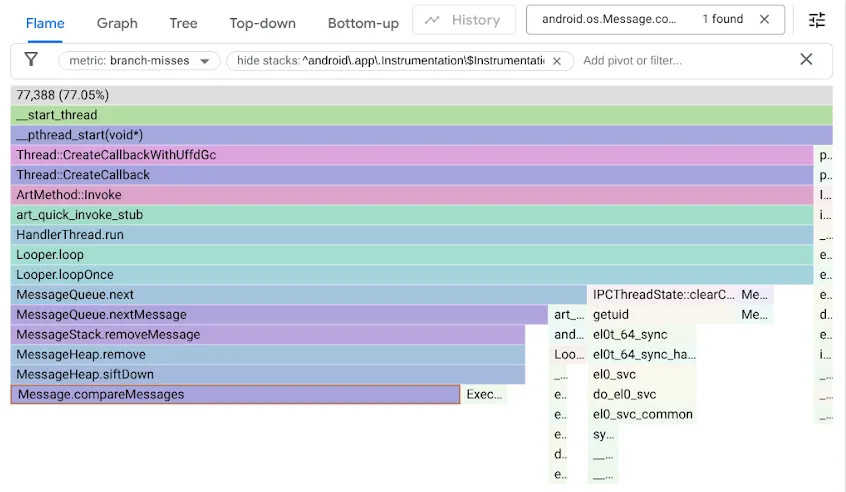
Напомним, что в исходном коде MessageQueue для упорядоченной очереди использовался односвязный список. При вставке список будет просматриваться в отсортированном порядке как при линейном поиске. Процесс остановится на первом элементе, который находится после точки вставки, и новый элемент Message будет связан с ним. Чтобы удалить элемент из заголовка, достаточно отменить связь с ним. DeliQueue использует минимальную кучу, в которой при изменении порядка элементов (просеивании вверх или вниз) требуется логарифмическая сложность в сбалансированной структуре данных, где любое сравнение с равной вероятностью может направить обход к левому или правому дочернему элементу. Новый алгоритм асимптотически быстрее, но при этом выявляет новое узкое место, поскольку код поиска в половине случаев останавливается из-за промахов ветвления.
Понимая, что промахи ветвей замедляют работу кода кучи, мы оптимизировали код, используя программирование без ветвей:
// Branchless Logic
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    final long when1 = m1.when;
    final long when2 = m2.when;
    final long insertSeq1 = m1.insertSeq;
    final long insertSeq2 = m2.insertSeq;

    // signum returns the sign (-1, 0, 1) of the argument,
    // and is implemented as pure arithmetic:
    // ((num >> 63) | (-num >>> 63))
    final int whenSign = Long.signum(when1 - when2);
    final int insertSeqSign = Long.signum(insertSeq1 - insertSeq2);

    // whenSign takes precedence over insertSeqSign,
    // so the formula below is such that insertSeqSign only matters
    // as a tie-breaker if whenSign is 0.
    return whenSign * 2 + insertSeqSign;
}
Чтобы понять, как работает оптимизация, разберите два примера в Compiler Explorer и используйте LLVM-MCA – симулятор ЦП, который может генерировать оценку временной шкалы циклов ЦП.
The original code:
Index     01234567890123
[0,0]     DeER .    .  .   sub  x0, x2, x3
[0,1]     D=eER.    .  .   cmp  x0, #0
[0,2]     D==eER    .  .   cset w0, ne
[0,3]     .D==eER   .  .   cneg w0, w0, lt
[0,4]     .D===eER  .  .   cmp  w0, #0
[0,5]     .D====eER .  .   b.le #12
[0,6]     . DeE---R .  .   mov  w1, #1
[0,7]     . DeE---R .  .   b    #48
[0,8]     . D==eE-R .  .   tbz  w0, #31, #12
[0,9]     .  DeE--R .  .   mov  w1, #-1
[0,10]    .  DeE--R .  .   b    #36
[0,11]    .  D=eE-R .  .   sub  x0, x4, x5
[0,12]    .   D=eER .  .   cmp  x0, #0
[0,13]    .   D==eER.  .   cset w0, ne
[0,14]    .   D===eER  .   cneg w0, w0, lt
[0,15]    .    D===eER .   cmp  w0, #0
[0,16]    .    D====eER.   csetm        w1, lt
[0,17]    .    D===eE-R.   cmp  w0, #0
[0,18]    .    .D===eER.   csinc        w1, w1, wzr, le
[0,19]    .    .D====eER   mov  x0, x1
[0,20]    .    .DeE----R   ret
Обратите внимание на условную ветвь b.le, которая позволяет избежать сравнения полей insertSeq, если результат уже известен после сравнения полей when.
The branchless code:
Index     012345678
[0,0]     DeER .  .   sub       x0, x2, x3
[0,1]     DeER .  .   sub       x1, x4, x5
[0,2]     D=eER.  .   cmp       x0, #0
[0,3]     .D=eER  .   cset      w0, ne
[0,4]     .D==eER .   cneg      w0, w0, lt
[0,5]     .DeE--R .   cmp       x1, #0
[0,6]     . DeE-R .   cset      w1, ne
[0,7]     . D=eER .   cneg      w1, w1, lt
[0,8]     . D==eeER   add       w0, w1, w0, lsl #1
[0,9]     .  DeE--R   ret
В этом случае реализация без ветвления требует меньше циклов и инструкций, чем даже самый короткий путь в коде с ветвлением, то есть она лучше во всех случаях. Более быстрая реализация и устранение неправильно спрогнозированных ветвей привели к пятикратному улучшению некоторых наших показателей!
Однако этот метод не всегда применим. Безусловные переходы обычно требуют выполнения работы, которая будет отброшена, и если ветвь предсказуема большую часть времени, эта бесполезная работа может замедлить ваш код. Кроме того, при удалении ветки часто возникает зависимость данных. Современные процессоры выполняют несколько операций за цикл, но не могут выполнить инструкцию, пока не будут готовы входные данные из предыдущей инструкции. В отличие от этого, процессор может предполагать, какие данные будут использоваться в ветвях, и выполнять работу заранее, если ветвь будет выбрана правильно.
Тестирование и проверка
Проверять корректность алгоритмов без блокировок очень сложно.
Помимо стандартных модульных тестов для непрерывной проверки в процессе разработки мы также написали строгие стресс-тесты, чтобы проверить инварианты очереди и попытаться вызвать гонки данных, если они существуют. В наших лабораториях мы можем запускать миллионы тестовых экземпляров на эмулируемых устройствах и реальном оборудовании.
С помощью инструментария Java ThreadSanitizer (JTSan) мы можем использовать те же тесты для обнаружения некоторых гонок данных в нашем коде. JTSan не обнаружил в DeliQueue проблемных гонок данных, но, к нашему удивлению, выявил две ошибки параллелизма в фреймворке Robolectric, которые мы оперативно исправили.
Чтобы улучшить возможности отладки, мы создали новые инструменты анализа. Ниже приведен пример проблемы в коде платформы Android, где один поток перегружает другой поток с помощью Message, что приводит к большому отставанию, которое видно в Perfetto благодаря функции MessageQueue, которую мы добавили.
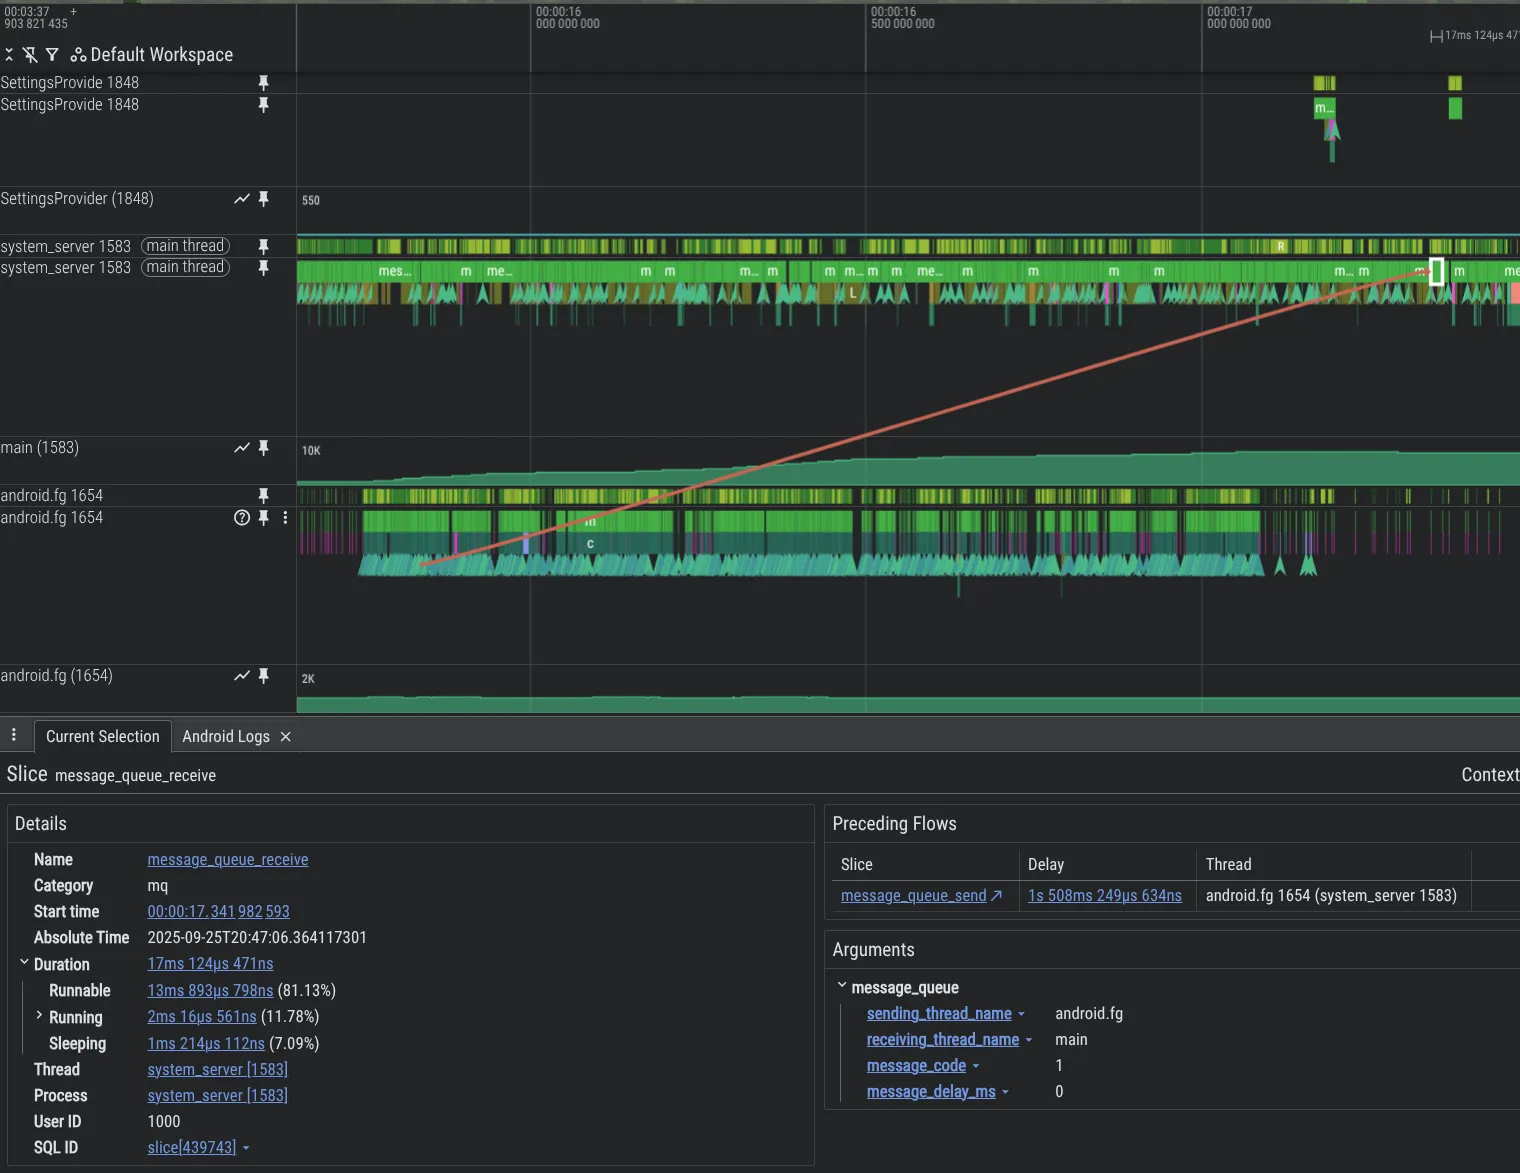
Чтобы включить трассировку MessageQueue в процессе system_server, добавьте в конфигурацию Perfetto следующее:
data_sources {
  config {
    name: "track_event"
    target_buffer: 0  # Change this per your buffers configuration
    track_event_config {
      enabled_categories: "mq"
    }
  }
}
Влияние изменений
DeliQueue повышает производительность системы и приложений, удаляя блокировки из MessageQueue.
- Синтетические тесты. Многопоточная вставка в занятые очереди выполняется до в 5000 раз быстрее,чем в устаревшей версии
MessageQueue, благодаря улучшенной параллельности (стек Treiber) и более быстрой вставке (минимальная куча). - В трассировках Perfetto, полученных от внутренних бета-тестировщиков, мы видим, что время, затрачиваемое основным потоком приложения на борьбу за блокировку, сократилось на 15 %.
- На тех же тестовых устройствах уменьшение конфликтов блокировок приводит к значительному улучшению пользовательского опыта, например:
- На 4% меньше пропущенных кадров в приложениях.
- На 7,7% меньше пропущенных кадров при взаимодействии с интерфейсом системы и панелью запуска.
- Время от запуска приложения до отрисовки первого кадра сократилось на 9, 1 % (95-й процентиль).
Дальнейшие действия
DeliQueue будет доступен в приложениях на устройствах с Android 17. Чтобы узнать, как тестировать приложения, разработчикам следует ознакомиться с информацией о подготовке приложений к новому режиму без блокировки экрана MessageQueue в блоге для разработчиков Android.
Ссылки
[1] Treiber, R.K., 1986. Системное программирование: параллелизм. International Business Machines Incorporated, Thomas J. исследовательский центр Watson Research Center.
[2] Goetz, B., Peierls, T., Bloch, J., Bowbeer, J., Holmes, D., & Lea, D. (2006). Java Concurrency in Practice. Addison-Wesley Professional.
-

 Новости продуктов
У разработчиков Android есть множество вариантов выбора агентов, больших языковых моделей (LLM), инструментов и интерфейсов командной строки (CLI), которые можно использовать для разработки приложений. Наша цель – помочь вам создавать красивые и качественные приложения для Android, независимо от того, как вы это делаете.
Simona Milanovic • Время на чтение: 4 минуты -
 Новости продуктов
Мы постоянно расширяем возможности платформы подписок в Google Play, чтобы помочь вам развивать бизнес, адаптироваться к новым бизнес-моделям и привлекать пользователей.
Sheenam Mittal • Время на чтение: 4 минуты -
 Новости продуктов
В прошлом году мы открыли Android Studio для любых моделей ИИ. Сегодня мы делаем следующий шаг и добавляем поддержку агентов для написания кода.
Matthew Warner • Время на чтение: 3 минуты
Получайте свежие новости о разработке приложений для Android на свою электронную почту каждую неделю.