در Android 17، برنامههایی که کیت توسعه نرمافزار ۳۷ یا بالاتر را هدفیابی میکنند پیادهسازی جدیدی از MessageQueue دریافت خواهند کرد که در آن پیادهسازی بدون قفل است. پیادهسازی جدید عملکرد را بهبود میبخشد و تعداد قابهای ازدسترفته را کاهش میدهد، اما ممکن است مشتریانی را که فیلدها و روشهای خصوصی MessageQueue را منعکس میکنند ازکار بیندازد. برای کسب اطلاعات بیشتر درباره تغییر رفتار و نحوه کاهش تأثیر آن، به اسناد تغییر رفتار MessageQueue مراجعه کنید. این پست وبلاگ فنی نمای کلی از معماری مجدد MessageQueue و نحوه تجزیهوتحلیل مشکلات رقابت قفل بااستفاده از Perfetto را ارائه میدهد.
Looper رشته واسط کاربر هر برنامه Android را هدایت میکند. کار را از MessageQueue میکشد، آن را به Handler میفرستد، و تکرار میکند. برای دو دهه، MessageQueue از یک قفل پایشگر واحد (یعنی یک بلوک کد synchronized) برای محافظت از وضعیت خود استفاده میکرد.
Android 17 بهروزرسانی مهمی را برای این عنصر معرفی میکند: پیادهسازی بدون قفلی بهنام DeliQueue.
این پست توضیح میدهد که قفلها چگونه بر عملکرد رابط کاربری تأثیر میگذارند، چگونه این مشکلات را با Perfetto تجزیهوتحلیل کنیم، و الگوریتمها و بهینهسازیهای خاصی که برای بهبود رشته اصلی Android استفاده میشود.
مشکل: رقابت بر سر قفل و وارونگی اولویت
تابع قدیمی MessageQueue بهعنوان صف اولویتدار محافظتشده با یک قفل واحد عمل میکرد. اگر رشته پسزمینهای پیامی را پست کند درحالیکه رشته اصلی درحال انجام نگهداری صف است، رشته پسزمینه رشته اصلی را مسدود میکند.
وقتی دو یا چند رشته برای استفاده انحصاری از یک قفل یکسان رقابت میکنند، به این وضعیت رقابت قفل گفته میشود. این رقابت میتواند باعث وارونگی اولویت شود و به لرزش میانای کاربر و سایر مشکلات عملکردی منجر شود.
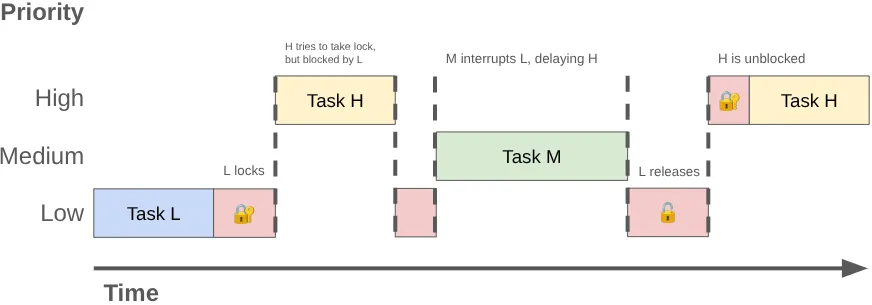
وارونگی اولویت زمانی رخ میدهد که رشتهای با اولویت بالا (مثل رشته UI) مجبور شود منتظر رشتهای با اولویت پایین بماند. این توالی را درنظر بگیرید:
- رشته پسزمینهای با اولویت پایین قفل
MessageQueueرا برای پست کردن نتیجه کاری که انجام داده است بهدست میآورد. - رشتهای با اولویت متوسط قابل اجرا میشود و زمان واحد پردازش مرکزی توسط زمانبند هسته به آن اختصاص داده میشود و رشته با اولویت پایین را پیشدستانه متوقف میکند.
- رشته رابط کاربری اولویت بالا کار فعلیاش را تمام میکند و تلاش میکند از صف بخواند، اما چون رشته اولویت پایین قفل را دراختیار دارد، مسدود میشود.
رشته با اولویت پایین رشته واسط کاربر را مسدود میکند و کار با اولویت متوسط آن را بیشتر بهتأخیر میاندازد.
تجزیهوتحلیل رقابت با Perfetto
میتوانید این مشکلات را بااستفاده از Perfetto تشخیص دهید. در ردیابی استاندارد، رشتهای که در قفل پایشگر مسدود شده است وارد حالت خواب میشود و Perfetto برش نشاندهنده مالک قفل را نشان میدهد.
وقتی دادههای ردگیری را پُرسمان میکنید، بهدنبال برشهایی با نام «monitor contention with …» باشید که پساز آن نام رشتهای که مالک قفل است و سایت کدی که قفل در آن بهدست آمده است ذکر شده است.
مطالعه موردی: لرزش «راهانداز»
برای نمونه، ردیابی را تجزیهوتحلیل میکنیم که در آن کاربر بلافاصله پساز گرفتن عکس در برنامه دوربین، هنگام پیمایش صفحه اصلی در تلفن Pixel دچار لرزش شده است. در زیر، نماگرفت Perfetto را میبینیم که رویدادهای منتهی به قاب ازدسترفته را نشان میدهد:
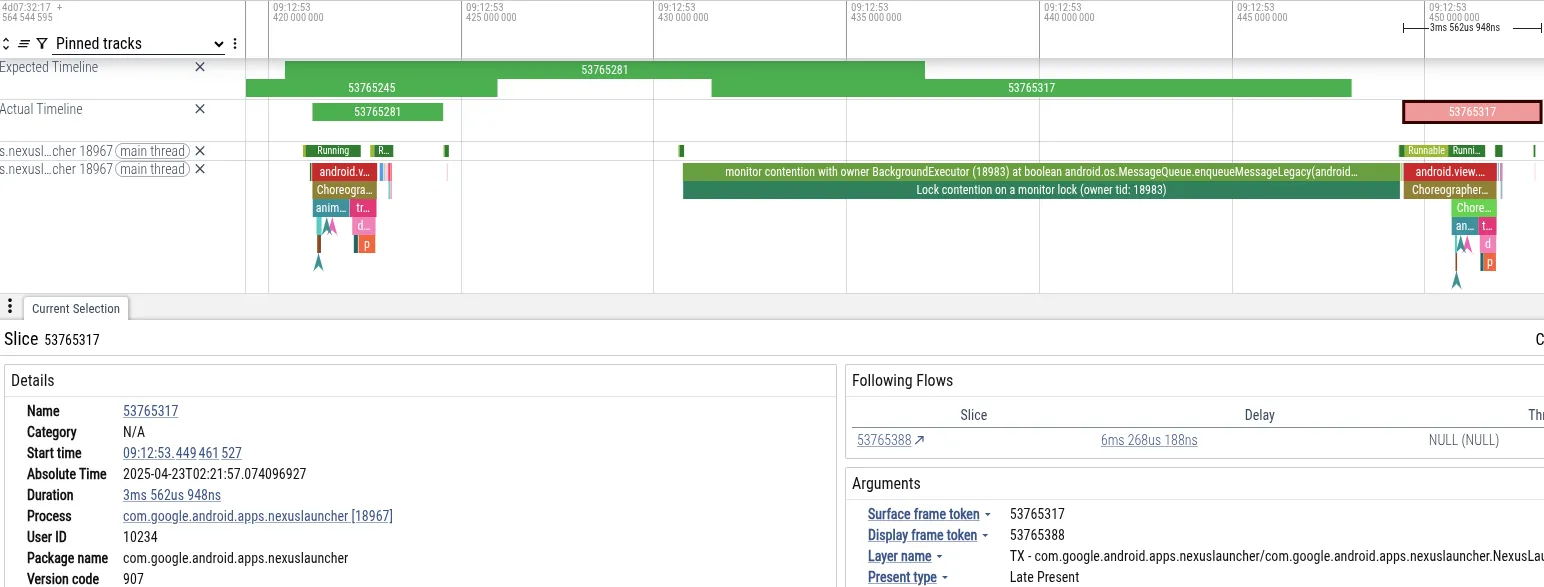
- نشانگان: رشته اصلی «راهانداز» مهلت قاب خود را ازدست داد. ۱۸ میلیثانیه مسدود شد که از مهلت ۱۶ میلیثانیه موردنیاز برای پرداز ۶۰ هرتز فراتر میرود.
- تشخیص: Perfetto نشان داد که رشته اصلی در قفل
MessageQueueمسدود شده است. رشته «BackgroundExecutor» مالک قفل بود. - علت اصلی: «اجراکننده پسزمینه» در Process.THREAD_PRIORITY_BACKGROUND (اولویت بسیار پایین) اجرا میشود. وظیفهای غیرفوری انجام داد (بررسی محدودیتهای استفاده از برنامه). همزمان، رشتههای با اولویت متوسط از زمان واحد پردازش مرکزی برای پردازش دادههای دوربین استفاده میکردند. برنامهریز سیستمعامل رشته BackgroundExecutor را برای اجرای رشتههای دوربین پیشگیری کرد.
این توالی باعث شد رشته میانای کاربر «راهانداز» (اولویت بالا) بهطور غیرمستقیم توسط رشته کارگر دوربین (اولویت متوسط) مسدود شود، که این رشته کارگر دوربین مانع از آزاد شدن قفل توسط رشته پسزمینه «راهانداز» (اولویت پایین) میشد.
پُرسمان کردن ردگیریها با PerfettoSQL
میتوانید از PerfettoSQL برای پُرسمان دادههای ردیابی برای الگوهای خاص استفاده کنید. این کار زمانی مفید است که تعداد زیادی ردگیری از دستگاههای کاربر یا آزمایشها داشته باشید و بهدنبال ردگیریهای خاصی باشید که مشکلی را نشان دهند.
برای مثال، این پُرسمان MessageQueue رقابت همزمان با قابهای افتاده (لرزش) را پیدا میکند:
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.frames.jank_type;

SELECT
  process_name,
  -- Convert duration from nanoseconds to milliseconds
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM android_monitor_contention
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"

-- Only look at app processes that had jank
AND upid IN (
  SELECT DISTINCT(upid)
  FROM actual_frame_timeline_slice
  WHERE android_is_app_jank_type(jank_type) = TRUE
)
GROUP BY process_name
ORDER BY SUM(dur) DESC;
در این مثال پیچیدهتر، دادههای ردیابی را که در چندین جدول گسترده شده است بههم بپیوندید تا MessageQueue رقابت را درطول راهاندازی برنامه شناسایی کنید:
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.startup.startups;

-- Join package and process information for startups
DROP VIEW IF EXISTS startups;
CREATE VIEW startups AS
SELECT startup_id, ts, dur, upid
FROM android_startups
JOIN android_startup_processes USING(startup_id);

-- Intersect monitor contention with startups in the same process.
DROP TABLE IF EXISTS monitor_contention_during_startup;
CREATE VIRTUAL TABLE monitor_contention_during_startup
USING SPAN_JOIN(android_monitor_contention PARTITIONED upid, startups PARTITIONED upid);

SELECT
  process_name,
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM monitor_contention_during_startup
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"
GROUP BY process_name
ORDER BY SUM(dur) DESC;
میتوانید از LLM موردعلاقهتان برای نوشتن پُرسمانهای PerfettoSQL استفاده کنید تا الگوهای دیگر را پیدا کنید.
در Google، از BigTrace برای اجرای پُرسمانهای PerfettoSQL در میلیونها ردیابی استفاده میکنیم. با انجام این کار، تأیید کردیم که آنچه بهصورت حکایتی دیدهایم، درواقع یک مشکل سیستمی است. دادهها نشان داد که MessageQueue رقابت قفل بر کاربران در سراسر بومسازگان تأثیر میگذارد و نیاز به تغییر اساسی در معماری را تأیید میکند.
راهحل: همزمان بدون قفل
ما مشکل رقابت MessageQueue را با پیادهسازی ساختار داده بدون قفل، بااستفاده از عملیات حافظه اتمی بهجای قفلهای انحصاری برای همگامسازی دسترسی به وضعیت مشترک، برطرف کردیم. ساختار داده یا الگوریتم زمانی بدون قفل است که حداقل یک رشته بتواند همیشه بدون توجه به رفتار زمانبندی رشتههای دیگر پیشرفت کند. دستیابی به این ویژگی معمولاً دشوار است و معمولاً برای اکثر کدها ارزش پیگیری ندارد.
عناصر اولیه اتمی
نرمافزار بدون قفل اغلب به عناصر اولیه خواندن-اصلاح-نوشتن اتمی که سختافزار ارائه میدهد متکی است.
در CPUهای ARM64 نسل قدیمیتر، از حلقه Load-Link/Store-Conditional (LL/SC) برای اتمیکها استفاده میشد. واحد پردازش مرکزی مقداری را بار میکند و نشانی را علامتگذاری میکند. اگر رشته دیگری در آن نشانی بنویسد، فروشگاه ناموفق میشود و حلقه دوباره تلاش میکند. چون رشتهها میتوانند بدون انتظار برای رشتهای دیگر به تلاش خود ادامه دهند و موفق شوند، این عملیات بدون قفل است.
ARM64 LL/SC loop example
retry:
    ldxr    x0, [x1]        // Load exclusive from address x1 to x0
    add     x0, x0, #1      // Increment value by 1
    stxr    w2, x0, [x1]    // Store exclusive.
                            // w2 gets 0 on success, 1 on failure
cbnz w2, retry // If w2 is non-zero (failed), branch to retrمعماریهای جدیدتر ARM (ARMv8.1) از افزونههای سیستم بزرگ (LSE) پشتیبانی میکنند که شامل دستورالعملهایی در قالب «مقایسه و تعویض» (CAS) یا «بار کردن و افزودن» (که در زیر نشان داده شده است) میشود. در Android 17، پشتیبانی از گردآورنده Android Runtime (ART) را برای تشخیص زمان پشتیبانی از LSE و انتشار دستورالعملهای بهینهسازیشده اضافه کردیم:
/ ARMv8.1 LSE atomic example
ldadd   x0, x1, [x2]    // Atomic load-add.
                        // Faster, no loop required.
در محکهای ما، کد با رقابت بالا که از CAS استفاده میکند، نسبت به گونه LL/SC حدود ۳ برابر سرعت بیشتری دارد.
زبان برنامهنویسی Java ازطریق java.util.concurrent.atomic که به این و دیگر دستورالعملهای تخصصی CPU متکی است، عناصر اولیه اتمی ارائه میدهد.
ساختار داده: DeliQueue
برای حذف رقابت بر سر قفل از MessageQueue، مهندسان ما ساختار داده جدیدی به نام DeliQueue طراحی کردند. DeliQueue درج Message را از پردازش Message جدا میکند:
- فهرست
Messages(پشته Treiber): پشتهای بدون قفل. هر رشتهای میتواند بدون رقابتMessagesجدید را به اینجا ارسال کند. - صف اولویت (Min-heap): پشتهای از
Messagesبرای مدیریت، که منحصراً متعلق به رشته Looper است (بنابراین برای دسترسی به آن نیازی به همگامسازی یا قفل نیست).
در صف قرار دادن: انتقال به پشته Treiber
فهرست Messages در پشته Treiber [۱]، پشتهای بدون قفل که از حلقه CAS برای بهروزرسانی اشارهگر سر استفاده میکند، نگهداری میشود.
public class TreiberStack <E> {
    AtomicReference<Node<E>> top =
            new AtomicReference<Node<E>>();
    public void push(E item) {
        Node<E> newHead = new Node<E>(item);
        Node<E> oldHead;
        do {
            oldHead = top.get();
            newHead.next = oldHead;
        } while (!top.compareAndSet(oldHead, newHead));
    }

    public E pop() {
        Node<E> oldHead;
        Node<E> newHead;
        do {
            oldHead = top.get();
            if (oldHead == null) return null;
            newHead = oldHead.next;
        } while (!top.compareAndSet(oldHead, newHead));
        return oldHead.item;
    }
}
کد منبع براساس «همزمانسازی در عمل با Java» [۲]، دردسترس آنلاین و منتشرشده در حوزه دامنه عمومی
هر تولیدکنندهای میتواند در هر زمانی Messageهای جدید را به پشته اضافه کند. این مانند گرفتن بلیت در پیشخوان اغذیهفروشی است - شماره شما براساس زمانی که حاضر شدهاید تعیین میشود، اما ترتیب دریافت غذا لازم نیست با شماره شما مطابقت داشته باشد. ازآنجاییکه پشته پیوندی است، هر Message یک پشته فرعی است - با ردیابی سر و تکرار به جلو میتوانید ببینید صف Message در هر نقطه زمانی چگونه بوده است - هیچ Message جدیدی را که به بالای پشته اضافه شده باشد نمیبینید، حتی اگر درطول پیمایش شما اضافه شده باشند.
Dequeue: انتقال انبوه به یک min-heap
برای یافتن Message بعدی برای رسیدگی، Looper با پیمایش پشته Treiber از بالا و تکرار تا زمانی که آخرین Message را که قبلاً پردازش کرده است پیدا کند، Messageهای جدید را از پشته Treiber پردازش میکند. همانطور که Looper در پشته پایین میرود، Message را در پشته کمینه مرتبشده براساس مهلت مقرر درج میکند. ازآنجاییکه Looper مالک انحصاری پشته است، Message را بدون قفل یا اتمی مرتب و پردازش میکند.
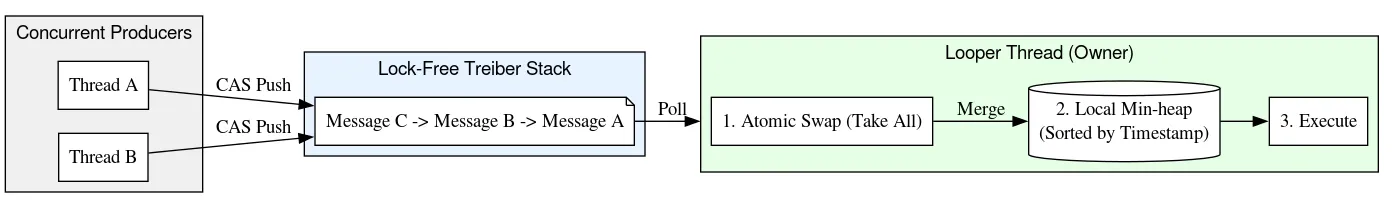
در پیمایش پشته، Looper همچنین پیوندهایی از Messageهای پشتهشده به پیشینیان آنها ایجاد میکند و درنتیجه فهرست پیوندی دوتایی تشکیل میدهد. ایجاد فهرست پیوندی ایمن است زیرا پیوندهای اشارهکننده به پایین پشته ازطریق الگوریتم پشته Treiber با CAS اضافه میشوند و پیوندهای اشارهکننده به بالای پشته فقط توسط رشته Looper خوانده و اصلاح میشوند. سپس از این پیوندهای برگشتی برای حذف Message از نقاط دلخواه در پشته در زمان O(1) استفاده میشود.
این طراحی درج O(1) را برای تولیدکنندگان (رشتههایی که کار را در صف پست میکنند) و پردازش O(log N) را برای مصرفکننده (Looper) فراهم میکند.
استفاده از یک پشته کمینه برای مرتب کردن Messageها همچنین یک نقص اساسی در MessageQueue قدیمی را برطرف میکند، جایی که Messageها در یک فهرست پیوندی (ریشه در بالا) نگهداری میشدند. در پیادهسازی قدیمی، برداشتن از سر O(1) بود، اما درج در بدترین حالت O(N) بود – که برای صفهای بیشازحد بارگذاریشده بهخوبی مقیاسبندی نمیشد! برعکس، درج در و حذف از پشته کمینه بهصورت لگاریتمی مقیاسبندی میشود و عملکرد میانگین رقابتی ارائه میدهد اما در تأخیرهای دنباله واقعاً عالی است.
قدیمی (قفلشده) MessageQueue | DeliQueue | |
| درج کردن | O(N) | O(۱) برای فراخوانی رشته O(logN) برای |
| برداشتن از سر | O(1) | O(logN) |
در پیادهسازی صف قدیمی، تولیدکنندگان و مصرفکننده از قفل برای هماهنگی دسترسی انحصاری به فهرست پیوندی زیرین استفاده میکردند. در DeliQueue، پشته Treiber دسترسی همزمان را مدیریت میکند و مصرفکننده واحد ترتیب صف کار را مدیریت میکند.
برداشتن: یکپارچگی ازطریق سنگ قبر
DeliQueue یک ساختار داده ترکیبی است که پشته Treiber بدون قفل را با یک پشته کمینه تکرشتهای ترکیب میکند. همگام نگه داشتن این دو ساختار بدون قفل جهانی یک چالش منحصربهفرد است: ممکن است پیامی بهصورت فیزیکی در پشته وجود داشته باشد اما بهصورت منطقی از صف حذف شده باشد.
برای حل این مشکل، DeliQueue از تکنیکی به نام «سنگ قبر» استفاده میکند. هر Message موقعیت خود را در پشته ازطریق اشارهگرهای عقب و جلو، شاخص خود در آرایه پشته، و پرچم بولی که نشان میدهد آیا حذف شده است یا نه، ردیابی میکند. وقتی یک Message آماده اجرا است، رشته Looper پرچم برداشتهشده آن را CAS میکند، سپس آن را از پشته و انباشته برمیدارد.
وقتی رشته دیگری نیاز به برداشتن Message دارد، آن را بلافاصله از ساختار داده استخراج نمیکند. درعوض، مراحل زیر را انجام میدهد:
- حذف منطقی: رشته از CAS برای تنظیم اتمی پرچم حذف
Messageاز نادرست به درست استفاده میکند.Messageبهعنوان مدرکی از حذف معلقه آن در ساختار داده باقی میماند، که به آن «سنگ قبر» میگویند. هرگاهMessageبرای حذف پرچمگذاری شود، DeliQueue با آن طوری رفتار میکند که انگار دیگر در صف وجود ندارد. - پاکسازی معوق: حذف واقعی از ساختار دادهها برعهده رشته
Looperاست و تا بعداً بهتعویق میافتد. بهجای اصلاح پشته یا انباشته، رشته حذفکنندهMessageرا به پشته فهرست آزاد بدون قفل دیگری اضافه میکند. - حذف ساختاری: فقط
Looperمیتواند با پشته تعامل داشته باشد یا عناصر را از پشته بردارد. وقتی بیدار میشود، فهرست آزاد را پاک میکند وMessageهای موجود در آن را پردازش میکند. هرMessageسپس از پشته جدا میشود و از انباشه برداشته میشود.
این رویکرد باعث میشود مدیریت پشته تکرشتهای باشد. این کار تعداد عملیات همزمان و موانع حافظه موردنیاز را به حداقل میرساند و مسیر بحرانی را سریعتر و سادهتر میکند.
پیمایش: رقابتهای داده مدل حافظه جاوا بیخطر
اکثر «میاناهای برنامهسازی کاربردی» همزمان، مانند Future در کتابخانه استاندارد جاوا، یا Job و Deferred در Kotlin، سازوکاری برای لغو کار قبلاز تکمیل آن دارند. نمونهای از یکی از این کلاسها با واحد کار زیربنایی مطابقت ۱:۱ دارد و فراخوانی cancel روی یک شیء، عملیات خاص مرتبط با آن را لغو میکند.
دستگاههای Android امروزی دارای CPU چند هستهای و جمعآوری همزمان و نسلی زباله هستند. اما وقتی Android برای اولینبار توسعه داده شد، اختصاص یک شیء برای هر واحد کار بسیار پرهزینه بود. درنتیجه، Android Handler لغو را ازطریق چندین سربار removeMessages پشتیبانی میکند - بهجای برداشتن مشخص Message، همه Messageهایی را که با معیارهای مشخصشده مطابقت دارند برمیدارد. در عمل، این کار مستلزم تکرار کردن همه Messageهایی است که قبلاز فراخوانی removeMessages درج شدهاند و برداشتن مواردی که مطابقت دارند.
هنگام تکرار به جلو، یک رشته فقط به یک عملیات اتمی مرتبشده برای خواندن سر فعلی پشته نیاز دارد. پساز آن، از خواندن فیلدهای معمولی برای یافتن Message بعدی استفاده میشود. اگر رشته Looper فیلدهای next را هنگام برداشتن Messages تغییر دهد، نوشتن Looper و خواندن رشته دیگر همگامسازی نمیشود - این یک مسابقه داده است. معمولاً، مسابقه دادهها یک اشکال جدی است که میتواند مشکلات بزرگی در برنامه شما ایجاد کند - نشت، حلقههای بینهایت، خرابی، انجماد و غیره. بااینحال، تحت شرایط محدود خاصی، مسابقات داده میتواند در «مدل حافظه جاوا» بیخطر باشد. فرض کنید با پشتهای از این موارد شروع کنیم:

یک خواندن اتمی از سر انجام میدهیم و A را میبینیم. اشارهگر بعدی A به B اشاره میکند. همزمان با پردازش B، ممکن است حلقهزن با بهروزرسانی A برای اشاره به C و سپس D، ویدیوهای B و C را بردارد.
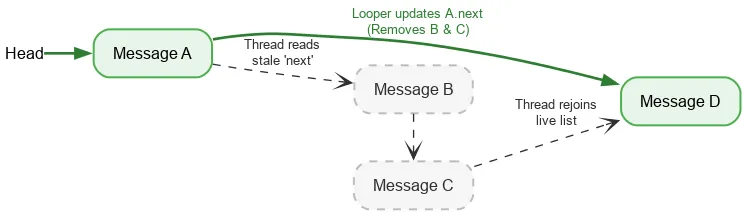
اگرچه B و C ازنظر منطقی حذف شدهاند، B همچنان اشارهگر بعدی خود را به C، و C به D حفظ میکند. رشته خواندن به پیمایش در میان گرههای جداشده برداشتهشده ادامه میدهد و درنهایت در D به پشته زنده میپیوندد.
با طراحی DeliQueue برای مدیریت رقابت بین پیمایش و برداشتن، امکان تکرار ایمن و بدون قفل را فراهم میکنیم.
خروج: شمارش مرجع بومی
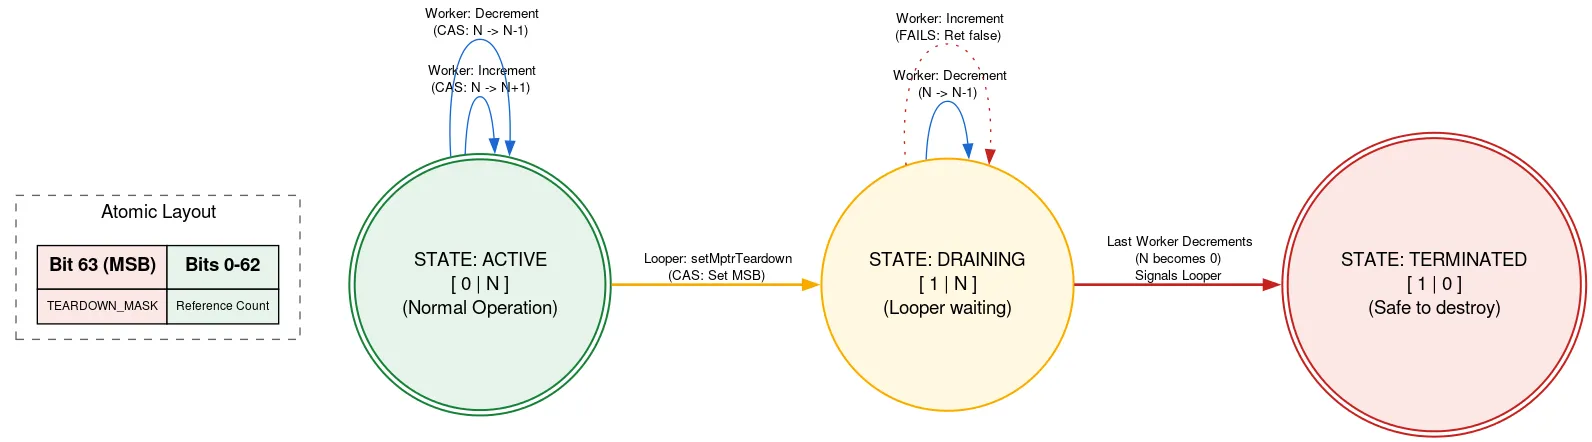
Looper با تخصیص بومی پشتیبانی میشود که پساز خروج Looper باید بهصورت دستی آزاد شود. اگر رشته دیگری درحین خروج Looper درحال افزودن Message باشد، میتواند پساز آزاد شدن از تخصیص بومی استفاده کند که این کار نقض ایمنی حافظه است. ما بااستفاده از یک refcount برچسبگذاریشده از این اتفاق جلوگیری میکنیم، جایی که یک بیت از اتم برای نشان دادن اینکه آیا Looper درحال خروج است یا نه استفاده میشود.
پیشاز استفاده از تخصیص بومی، یک رشته مقدار اتمی refcount را میخواند. اگر بیت خروج تنظیم شده باشد، برمیگرداند که Looper در حال خروج است و تخصیص بومی نباید استفاده شود. اگر نه، بااستفاده از تخصیص بومی، تلاش میکند تا بااستفاده از CAS تعداد رشتههای فعال را افزایش دهد. پساز انجام آنچه نیاز است، شمارش را کاهش میدهد. اگر بیت خروج پساز افزایش آن اما قبلاز کاهش آن تنظیم شده باشد، و شمارش اکنون صفر باشد، آنگاه رشته Looper را بیدار میکند.
وقتی رشته Looper آماده خروج است، از CAS برای تنظیم بیت خروج در اتمی استفاده میکند. اگر refcount برابر با ۰ باشد، میتواند به آزاد کردن تخصیص بومی خود ادامه دهد. درغیراینصورت، خود را پارک میکند و میداند که وقتی آخرین کاربر تخصیص بومی refcount را کاهش دهد، بیدار خواهد شد. این رویکرد به این معنی است که رشته Looper منتظر پیشرفت رشتههای دیگر میماند، اما فقط زمانی که درحال خروج است. این کار فقط یکبار انجام میشود و به عملکرد حساس نیست، و کد دیگر را برای استفاده از تخصیص بومی کاملاً بدون قفل نگه میدارد.
پیادهسازی شامل ترفندها و پیچیدگیهای دیگری نیز میشود. با بررسی کد منبع میتوانید درباره DeliQueue بیشتر بدانید.
بهینهسازی: برنامهنویسی بدون شاخه
تیم توسعهدهنده درحین توسعه و آزمایش DeliQueue، معیار سنجشهای زیادی را اجرا کرد و کد جدید را بهدقت نمایهبندی کرد. یکی از مشکلات شناساییشده بااستفاده از ابزار simpleperf، تخلیه خط لوله ناشی از کد مقایسهگر Message بود.
مقایسهگر استاندارد از پرشهای شرطی استفاده میکند، با شرطی که برای تصمیمگیری درباره اینکه کدام Message اول میآید در زیر ساده شده است:
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    if (m1 == m2) {
        return 0;
    }

    // Primary queue order is by when.
    // Messages with an earlier when should come first in the queue.
    final long whenDiff = m1.when - m2.when;
    if (whenDiff > 0) return 1;
    if (whenDiff < 0) return -1;

    // Secondary queue order is by insert sequence.
    // If two messages were inserted with the same `when`, the one inserted
    // first should come first in the queue.
    final long insertSeqDiff = m1.insertSeq - m2.insertSeq;
    if (insertSeqDiff > 0) return 1;
    if (insertSeqDiff < 0) return -1;

    return 0;
}
این کد به پرشهای شرطی (دستورات b.le و cbnz) ترجمه میشود. وقتی واحد پردازش مرکزی با شاخه شرطی مواجه میشود، تا زمانی که شرط محاسبه نشود نمیتواند بفهمد که شاخه گرفته شده است یا نه، بنابراین نمیداند که دستور بعدی را بخواند یا نه و باید بااستفاده از تکنیکی به نام پیشبینی شاخه حدس بزند. در مواردی مثل جستجوی دودویی، جهت شاخه در هر مرحله بهطور غیرقابل پیشبینی متفاوت خواهد بود، بنابراین احتمالاً نیمی از پیشبینیها اشتباه خواهند بود. پیشبینی شاخه اغلب در الگوریتمهای جستجو و مرتبسازی (مانند الگوریتم استفادهشده در یک پشته کوچک) بیاثر است، زیرا هزینه حدس اشتباه بیشتر از بهبود ناشی از حدس درست است. وقتی پیشبینیکننده شاخه اشتباه حدس میزند، باید کاری را که پساز فرض کردن مقدار پیشبینیشده انجام داده است دور بریزد و از مسیری که درواقع طی شده است دوباره شروع کند - این کار تخلیه خط لوله نامیده میشود.
برای یافتن این مشکل، ما معیارهای سنجش خود را بااستفاده از branch-misses شمارنده عملکرد نمایهبندی کردیم که ردپای پشته را در جایی که پیشبینیکننده شاخه اشتباه حدس میزند ثبت میکند. سپس نتایج را با Google pprof بهتصویر کشیدیم، همانطور که در زیر نشان داده شده است:
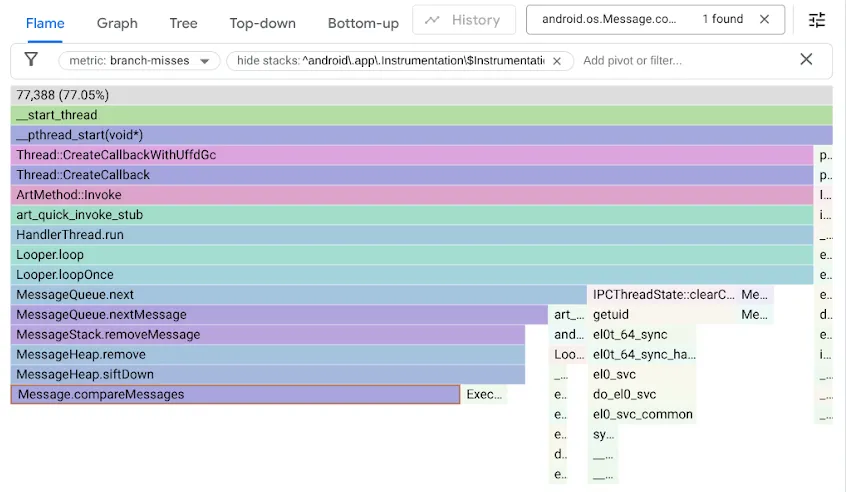
بهیاد داشته باشید که کد اصلی MessageQueue از فهرست پیوندی تکی برای صف مرتبشده استفاده میکرد. درج کردن فهرست را بهترتیب مرتبشده بهعنوان جستجوی خطی پیمایش میکند و در اولین عنصری که از نقطه درج فراتر رفته است متوقف میشود و Message جدید را قبلاز آن پیوند میدهد. برای برداشتن سر، کافی بود پیوند سر را لغو کنید. درحالیکه DeliQueue از یک پشته کمینه استفاده میکند، که در آن جهشها نیازمند مرتبسازی مجدد برخیاز عناصر (غربال کردن به بالا یا پایین) با پیچیدگی لگاریتمی در یک ساختار داده متوازن هستند، جایی که هر مقایسه شانس یکسانی برای هدایت پیمایش به فرزند چپ یا فرزند راست دارد. الگوریتم جدید بهصورت مجانبی سریعتر است، اما گلوگاه جدیدی را آشکار میکند زیرا کد جستجو نیمی از زمان را در شاخههای ازدسترفته متوقف میکند.
با درک اینکه ازدست دادن شاخه باعث کند شدن کد پشته ما میشود، کد را بااستفاده از برنامهنویسی بدون شاخه بهینهسازی کردیم:
// Branchless Logic
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    final long when1 = m1.when;
    final long when2 = m2.when;
    final long insertSeq1 = m1.insertSeq;
    final long insertSeq2 = m2.insertSeq;

    // signum returns the sign (-1, 0, 1) of the argument,
    // and is implemented as pure arithmetic:
    // ((num >> 63) | (-num >>> 63))
    final int whenSign = Long.signum(when1 - when2);
    final int insertSeqSign = Long.signum(insertSeq1 - insertSeq2);

    // whenSign takes precedence over insertSeqSign,
    // so the formula below is such that insertSeqSign only matters
    // as a tie-breaker if whenSign is 0.
    return whenSign * 2 + insertSeqSign;
}
برای درک بهینهسازی، دو مثال را در Compiler Explorer ازهم باز کنید و از LLVM-MCA، شبیهساز واحد پردازش مرکزی که میتواند جدول زمانی تخمینی از چرخههای واحد پردازش مرکزی تولید کند، استفاده کنید.
The original code:
Index     01234567890123
[0,0]     DeER .    .  .   sub  x0, x2, x3
[0,1]     D=eER.    .  .   cmp  x0, #0
[0,2]     D==eER    .  .   cset w0, ne
[0,3]     .D==eER   .  .   cneg w0, w0, lt
[0,4]     .D===eER  .  .   cmp  w0, #0
[0,5]     .D====eER .  .   b.le #12
[0,6]     . DeE---R .  .   mov  w1, #1
[0,7]     . DeE---R .  .   b    #48
[0,8]     . D==eE-R .  .   tbz  w0, #31, #12
[0,9]     .  DeE--R .  .   mov  w1, #-1
[0,10]    .  DeE--R .  .   b    #36
[0,11]    .  D=eE-R .  .   sub  x0, x4, x5
[0,12]    .   D=eER .  .   cmp  x0, #0
[0,13]    .   D==eER.  .   cset w0, ne
[0,14]    .   D===eER  .   cneg w0, w0, lt
[0,15]    .    D===eER .   cmp  w0, #0
[0,16]    .    D====eER.   csetm        w1, lt
[0,17]    .    D===eE-R.   cmp  w0, #0
[0,18]    .    .D===eER.   csinc        w1, w1, wzr, le
[0,19]    .    .D====eER   mov  x0, x1
[0,20]    .    .DeE----R   ret
به شاخه شرطی b.le توجه کنید که درصورت مشخص بودن نتیجه از مقایسه فیلدهای when، از مقایسه فیلدهای insertSeq جلوگیری میکند.
The branchless code:
Index     012345678
[0,0]     DeER .  .   sub       x0, x2, x3
[0,1]     DeER .  .   sub       x1, x4, x5
[0,2]     D=eER.  .   cmp       x0, #0
[0,3]     .D=eER  .   cset      w0, ne
[0,4]     .D==eER .   cneg      w0, w0, lt
[0,5]     .DeE--R .   cmp       x1, #0
[0,6]     . DeE-R .   cset      w1, ne
[0,7]     . D=eER .   cneg      w1, w1, lt
[0,8]     . D==eeER   add       w0, w1, w0, lsl #1
[0,9]     .  DeE--R   ret
در اینجا، پیادهسازی بدون شاخه نسبتبه کوتاهترین مسیر در کد شاخهدار، به چرخههای کمتر و دستورالعملهای کمتری نیاز دارد - در همه موارد بهتر است. پیادهسازی سریعتر بهعلاوه حذف شاخههای پیشبینینشده منجر به بهبود ۵ برابری در برخیاز معیارهای سنجش ما شد!
بااینحال، این تکنیک همیشه قابلاجرا نیست. رویکردهای بدون شاخه معمولاً نیازمند انجام کاری هستند که دور انداخته خواهد شد، و اگر شاخه بیشتر اوقات قابلپیشبینی باشد، آن کار هدررفته میتواند سرعت کد شما را کاهش دهد. علاوهبراین، برداشتن شاخه اغلب وابستگی داده را معرفی میکند. «واحد پردازش مرکزی» مدرن در هر چرخه چندین عملیات را اجرا میکند، اما نمیتواند دستورالعمل را تا زمانی که ورودیهای آن از دستورالعمل قبلی آماده نشده است اجرا کند. درمقابل، واحد پردازش مرکزی میتواند درباره دادههای شاخهها حدس بزند و اگر شاخهای بهدرستی پیشبینی شود، ازقبل کار کند.
آزمایش و اعتبارسنجی
تأیید صحت الگوریتمهای بدون قفل بهطور قابلتوجهی دشوار است!
علاوهبر آزمونهای واحد استاندارد برای اعتبارسنجی مداوم درطول توسعه، آزمونهای فشار دقیقی نیز نوشتیم تا ناورداهای صف را درستیسنجی کنیم و درصورت وجود، سعی کنیم شرایط مسابقه دادهای را القا کنیم. در آزمایشگاههای آزمایشی خود میتوانستیم میلیونها نمونه آزمایشی را روی دستگاههای شبیهسازیشده و سختافزار واقعی اجرا کنیم.
با ابزار Java ThreadSanitizer (JTSan)، میتوانیم از همان آزمایشها برای شناسایی برخیاز مسابقههای داده در کد خود استفاده کنیم. JTSan هیچگونه مسابقه دادهای مشکلداری در DeliQueue پیدا نکرد، اما - بهطور شگفتانگیزی - در چارچوب Robolectric دو اشکال همزمانسازی را شناسایی کرد که بلافاصله آنها را برطرف کردیم.
برای بهبود قابلیتهای اشکالزدایی، ابزارهای تحلیل جدیدی ساختیم. در زیر نمونهای از مشکل در کد پلاتفرم Android نشان داده شده است که در آن یک رشته رشته دیگر را با Messageها سرریز میکند و باعث ایجاد انباشتگی بزرگ میشود که بهلطف ویژگی ابزار دقیق MessageQueue که اضافه کردهایم در Perfetto قابلمشاهده است.
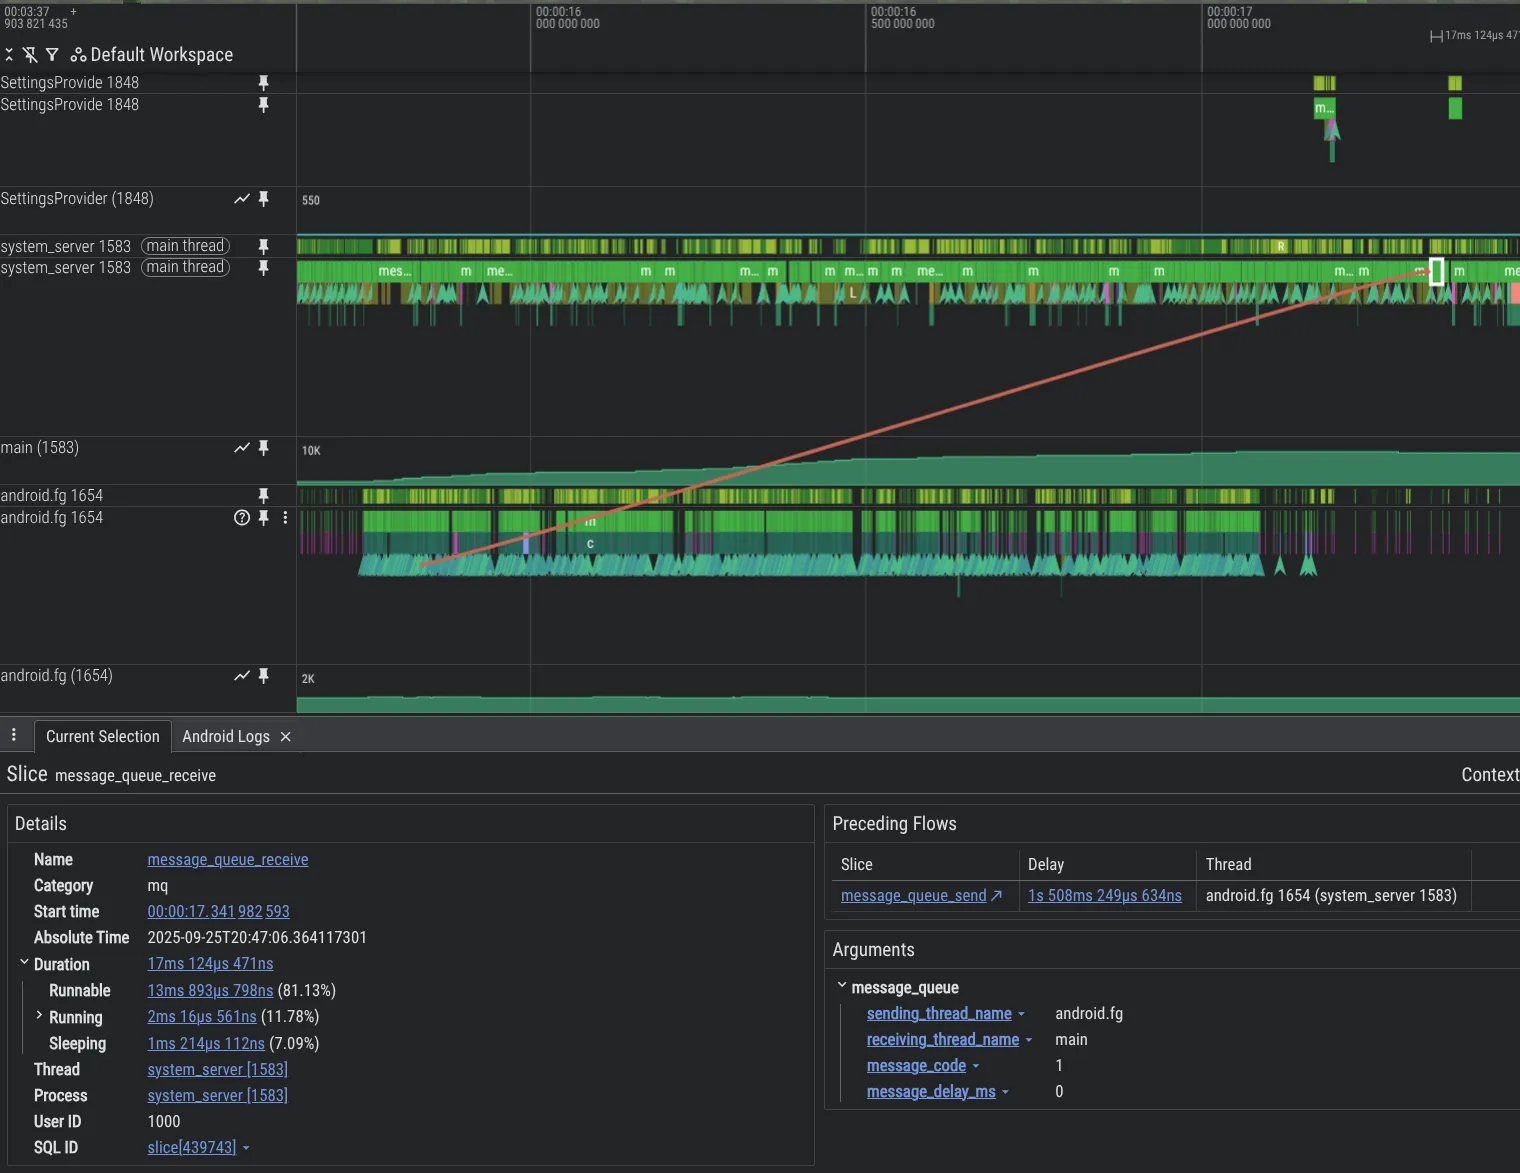
برای فعال کردن ردیابی MessageQueue در فرایند system_server، موارد زیر را در پیکربندی Perfetto خود اضافه کنید:
data_sources {
  config {
    name: "track_event"
    target_buffer: 0  # Change this per your buffers configuration
    track_event_config {
      enabled_categories: "mq"
    }
  }
}
تأثیر
DeliQueue با حذف قفلها از MessageQueue، عملکرد سیستم و برنامه را بهبود میبخشد.
- معیارهای سنجش مصنوعی: درج چندرشتهای در صفهای شلوغ تا ۵٬۰۰۰ برابر سریعتر از
MessageQueueقدیمی است، که این امر بهدلیل بهبود همزمانسازی (پشته Treiber) و درجهای سریعتر (انبوهه کوچک) است. - در ردیابیهای Perfetto که از آزمایشکنندگان بتا داخلی بهدست آمده است، شاهد کاهش ۱۵٪ در زمان رشته اصلی برنامه صرفشده در رقابت قفل هستیم.
- در همان دستگاههای آزمایشی، کاهش رقابت برای قفل منجر به بهبود قابلتوجه تجربه کاربری میشود، ازجمله:
- ٪۴ قاب ازدسترفته در برنامهها.
- ٪۷٫۷ قاب ازدسترفته در تعاملات «میانای کاربر سیستم» و «راهانداز».
- ٪۹٫۱ کاهش در مدتزمان از راهاندازی برنامه تا رسم اولین قاب، در صدک ۹۵.
مراحل بعدی
DeliQueue درحال عرضه شدن برای برنامههای Android 17 است. توسعهدهندگان برنامه باید «آماده کردن برنامه برای MessageQueue جدید بدون قفل» را در وبلاگ «توسعهدهندگان Android» مرور کنند تا با نحوه آزمایش برنامههایشان آشنا شوند.
مرجعها
[1] Treiber, R.K., ۱۹۸۶. برنامهنویسی سیستم: مقابله با موازیسازی. International Business Machines Incorporated, Thomas J. مرکز پژوهش واتسون.
[۲] Goetz, B., Peierls, T., Bloch, J., Bowbeer, J., Holmes, D., & Lea, D. (۲۰۰۶). Java Concurrency in Practice. Addison-Wesley Professional.
-

 اخبار محصول
بهعنوان توسعهدهندگان Android، وقتی نوبت به انتخاب عاملها، مدلهای زبانی بزرگ، ابزارها، و میاناهای خط فرمان (CLI) میرسد که برای توسعه نرمافزار استفاده میکنید، گزینههای زیادی دارید. هدف ما این است که به شما کمک کنیم برنامههای Android زیبا و با کیفیت بالا بسازید، مهم نیست که چگونه میخواهید بسازید.
Simona Milanovic • ۴ دقیقه خواندن -
 اخبار محصول
در Google Play، ما بهطور مداوم پلاتفرم اشتراک خود را گسترش میدهیم تا به شما کمک کنیم رشد کنید، با مدلهای کسبوکار جدید سازگار شوید، و دقیقاً در جایی که کاربران شما هستند با آنها ارتباط برقرار کنید.
Sheenam Mittal • ۴ دقیقه خواندن -
 اخبار محصول
سال گذشته، Android Studio برای هر مدل هوش مصنوعی باز شد. امروز، با معرفی پشتیبانی از انتخاب شما برای عاملهای کدنویسی، گام بعدی را برمیداریم.
Matthew Warner • ۳ دقیقه خواندن
هر هفته جدیدترین اطلاعات آماری توسعه Android را در صندوق ورودیتان دریافت کنید.