Android Bench 2.0: Memperluas batasan dengan tugas jangka panjang yang menantang
Waktu baca: 3 menit
Saat pertama kali meluncurkan Android Bench, kami membangun fondasi yang ketat untuk mengevaluasi cara model bahasa besar (LLM) membantu developer dalam menyelesaikan tugas Android di dunia nyata. Seiring dengan perkembangan pesat model dan agen AI, kami telah memperbarui metodologi kami, seperti menyelaraskan framework tolok ukur kami dengan framework Harbor. Hari ini, kami merilis kumpulan pertama tugas jangka panjang (LHT), yang merupakan tugas dengan kompleksitas tinggi yang memerlukan waktu beberapa hari atau bahkan seminggu untuk diselesaikan oleh engineer. Kami juga memperkenalkan evaluasi agentic, dimulai dengan agen dari penyedia model yang sesuai. Penambahan ini membawa kita ke Android Bench 2.0—upgrade besar yang dirancang untuk mengevaluasi model AI dan agen terhadap skala, ambiguitas, dan pemecahan masalah multi-langkah yang kompleks yang Anda hadapi setiap hari.
Dari perbaikan inkremental hingga tugas jangka panjang
Iterasi pertama Android Bench, bersama dengan benchmark coding AI awal yang serupa, berfokus pada perubahan inkremental pada repositori yang ada, yang dalam banyak kasus terbatas pada perbaikan bug atau permintaan fitur yang lebih kecil. Hal ini mencerminkan kemampuan bantuan AI pada saat itu, serta cara Anda menggunakannya.
Untuk terus membantu Anda menemukan model dan agen coding yang paling sesuai dengan alur kerja pengembangan Anda, kami telah meningkatkan standar evaluasi kami agar sesuai dengan pekerjaan yang Anda delegasikan ke AI. Android Bench 2.0 mencerminkan tantangan ambisius ini dengan LHT yang mencakup mengupgrade dependensi, menambahkan fitur baru, membangun aplikasi dari awal, atau mengonversi aplikasi lintas platform ke Android.
Tugas yang kompleks memerlukan evaluasi dan penilaian yang lebih bernuansa
Pada tugas engineering yang berlangsung beberapa hari, penilaian lulus atau gagal biner tidak memberikan gambaran lengkap.
Misalnya, agen mungkin merefaktorisasi 40 layar ke Jetpack Compose, menyiapkan tabel database, dan memenuhi 90% persyaratan, tetapi gagal dalam satu pernyataan kasus ekstrem. Skor biner menilai eksekusi ini sebagai 0%, sehingga mengaburkan kemampuan arsitektur model. Kami beralih ke penilaian berkelanjutan untuk memberikan sinyal yang lebih bermakna, baik untuk pengembangan model maupun untuk pemahaman Anda tentang cara AI dapat membantu Anda.
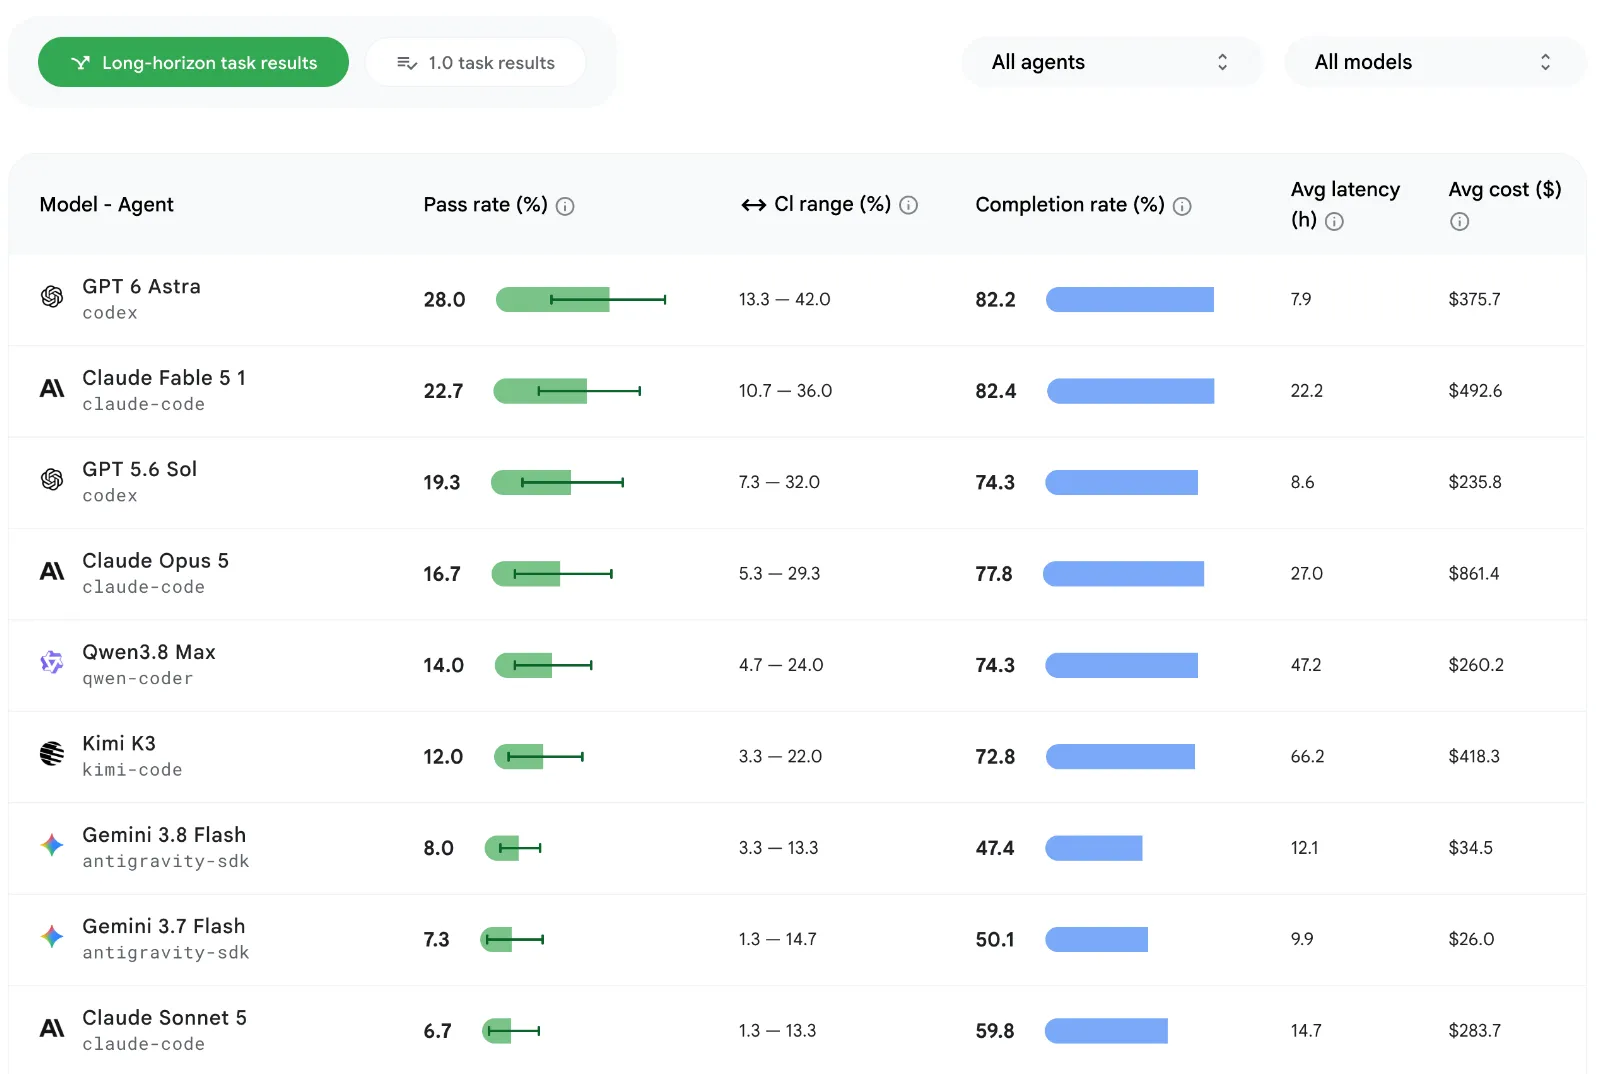
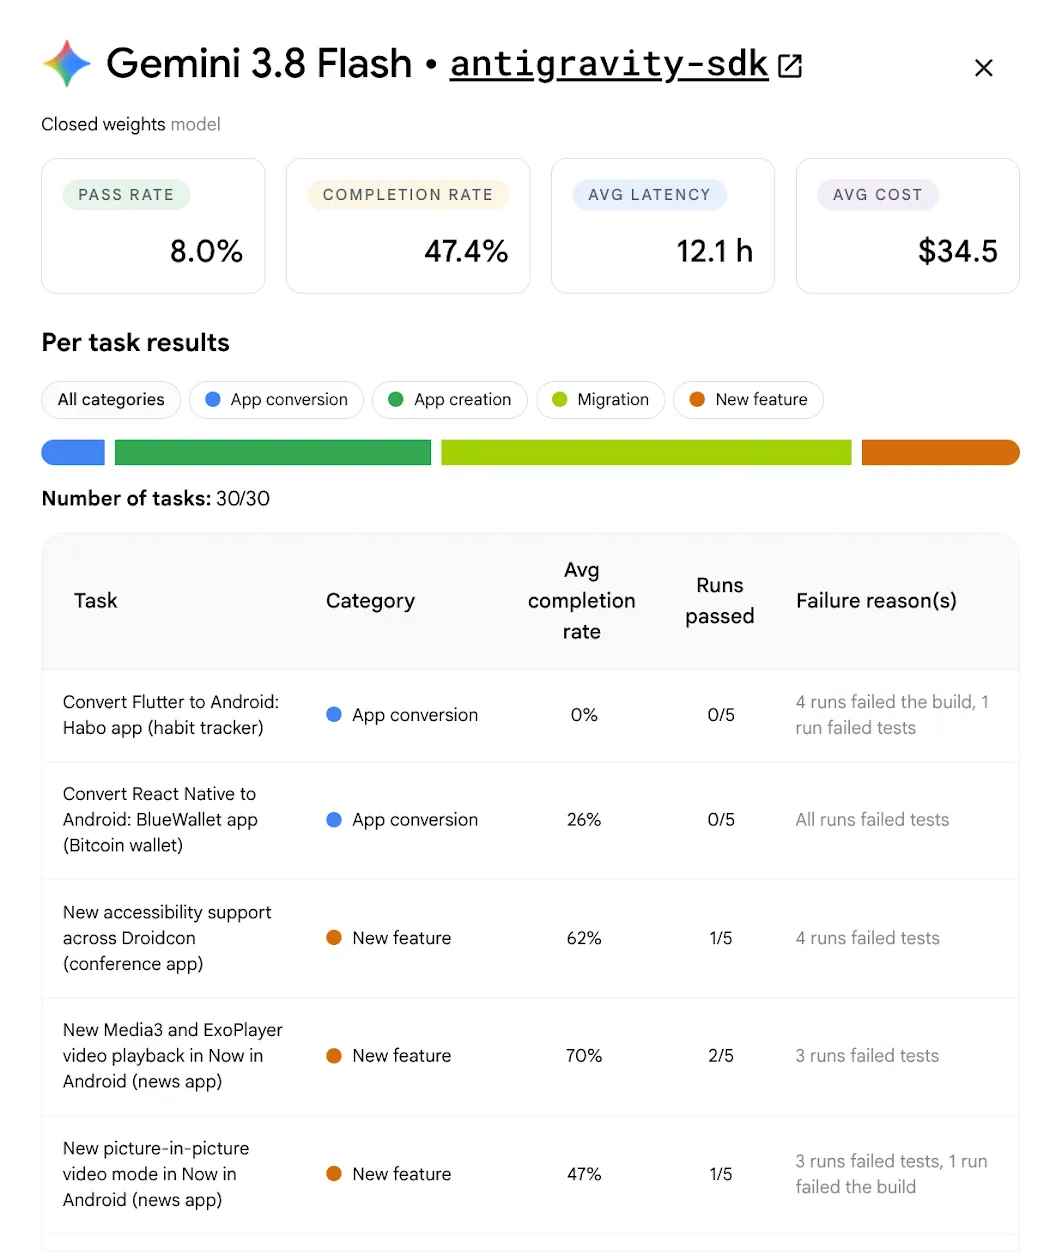
Kami menghitung rasio penyelesaian ini melalui kombinasi faktor seperti fungsi, fidelitas visual, dan menghindari regresi. Kami juga menerapkan penalti penilaian objektif untuk penyimpangan dari petunjuk evaluasi atau batasan struktural. Lihat papan peringkat yang diperbarui dan klik tampilan kartu setiap model untuk melihat elemen tambahan seperti rasio kelulusan, rasio penyelesaian, dan biaya rata-rata per model dan per tugas.
Tingkat kelulusan tertinggi untuk LHT adalah sekitar 28%, jauh lebih rendah daripada ~91% untuk tugas asli dalam benchmark.
Tugas jangka panjang memberikan insight bermanfaat untuk bantuan AI
Selain mengukur seberapa baik AI menangani tugas yang berjalan lama, set data LHT membantu kami mempelajari lebih lanjut kekuatan dan kelemahan model yang diuji, dan kami menawarkan panduan yang lebih praktis kepada Anda.
Di berbagai tingkat model, AI lebih baik dalam menulis kode baru daripada melakukan refaktorisasi kode yang sudah ada. Refaktorisasi dan migrasi menjadi lebih rumit karena keberhasilannya bergantung pada kompleksitas arsitektur, bukan volume kode.
Model menunjukkan kemampuan yang kuat pada transformasi deterministik yang sudah mapan, seperti mengonversi Java ke Kotlin, menukar Retrofit dengan Ktor, atau memperkenalkan lapisan ViewModel. Mereka menerapkan pola ini secara konsisten, bahkan di lebih dari 125 file dan lebih dari 8.000 baris kode.
Namun, model mengalami kesulitan saat tugas memerlukan validasi runtime (seperti grafik injeksi dependensi yang tidak ada), melibatkan perubahan framework yang dapat menyebabkan gangguan, atau mengalami kesenjangan pengetahuan dengan library yang belum dirilis. Mem-porting aplikasi lintas platform ke Android masih menjadi tantangan terbuka—tidak ada model yang mencapai tingkat kelulusan 100%, dan model tercanggih hanya mencapai tingkat penyelesaian maksimal 80%.
Memperkenalkan evaluasi agen
Untuk membantu Anda lebih memahami performa model saat diintegrasikan ke dalam Agentic Workflows, kami menambahkan agen yang umum digunakan ke dalam evaluasi kami. Kami memulai dengan menjalankan model baru terhadap LHT dengan agen dari penyedia model yang sesuai. Misalnya, kami menjalankan GPT 5.6 Sol di Codex, dan Gemini 3.8 Flash di Google Antigravity. Pasangan ini menunjukkan bagaimana desain harness berdampak positif pada hasil developer, karena kita telah melihat bahwa prompt caching dan jendela alat yang ringkas dapat menghasilkan pengurangan token.
Kami akan memperluas fitur ini pada masa mendatang dengan juga menyoroti hasil di berbagai kombinasi model dan agen, untuk membantu Anda menemukan kombinasi yang paling sesuai untuk Anda dan tim Anda.
Kami berinvestasi dalam pengukuran ini karena penting bagi Anda untuk dapat menggunakan agen dan model pilihan Anda untuk pengembangan Android, dan kami akan menyampaikan informasi selengkapnya kepada Anda dalam beberapa minggu mendatang.
Model baru ditambahkan
Selain itu, kami terus memperluas leaderboard untuk memastikan Anda memiliki data terbaru untuk keputusan pengembangan Anda. Kami menambahkan Gemini 3.8 Flash, Gemini 3.7 Flash, GPT-6 OpenAI, Fable 5.1 Anthropic, Kimi K3, dan Qwen 3.8 Max, dengan GPT-6 Astra OpenAI di posisi teratas dengan tingkat kelulusan 28%.
Rencana ke depan
Android Bench 2.0 menghadirkan lingkungan yang andal untuk mengukur AI untuk pengembangan Android. Dengan menggabungkan tugas jangka panjang, evaluasi multimodal, agen, dan penskoran berkelanjutan, kami berharap dapat memberdayakan tim riset AI untuk membangun partner coding AI yang lebih mumpuni dan andal, serta memberikan transparansi yang lebih besar terkait opsi Anda untuk pengembangan AI.
Lihat papan peringkat yang diperbarui beserta metodologi yang diperbarui. Masukan Anda secara langsung memengaruhi cara kami mengembangkan Android Bench, jadi terus bagikan masukan Anda kepada kami di GitHub, serta saluran sosial kami seperti X dan LinkedIn.
-
 Berita Produk
Hari ini, di Android Dev Summit, kami mengumumkan ketersediaan luas berbagai alat dan API yang dirancang untuk menghilangkan hambatan sehari-hari dan memberi Anda lebih banyak fleksibilitas untuk membuat aplikasi Android yang hebat.
Matthew McCullough • Waktu baca: 4 menit -
 Berita Produk
Seiring dengan percepatan pengembangan berbasis agen, rekayasa Android mencapai batas baru yang menarik: beralih dari penyelesaian kode yang bersifat membantu ke agen yang mengeksekusi secara menyeluruh di bawah arahan Anda. Anda memiliki pilihan dan fleksibilitas total dalam model dan agen yang Anda gunakan.
Jason Buchel • Waktu baca: 3 menit -

 Berita Produk
Sebagai developer Android, Anda memiliki banyak pilihan terkait agen, LLM, alat, dan antarmuka command line (CLI) yang Anda gunakan untuk pengembangan aplikasi. Sasaran kami adalah membantu Anda membuat aplikasi Android yang menarik dan berkualitas tinggi, apa pun cara yang Anda pilih untuk membuatnya.
Simona Milanovic • Waktu baca: 4 menit
Dapatkan insight pengembangan Android terbaru yang dikirim ke kotak masuk Anda setiap minggu.