

कोरूटीन में, फ़्लो एक ऐसा टाइप होता है जो क्रम से कई वैल्यू दे सकता है. वहीं, सस्पेंड फ़ंक्शन सिर्फ़ एक वैल्यू देते हैं. उदाहरण के लिए, डेटाबेस से लाइव अपडेट पाने के लिए, फ़्लो का इस्तेमाल किया जा सकता है.
फ़्लो, को-रूटीन के ऊपर बनाए जाते हैं और कई वैल्यू दे सकते हैं.
फ़्लो, कॉन्सेप्ट के तौर पर डेटा की एक स्ट्रीम होती है. इसे एसिंक्रोनस तरीके से कंप्यूट किया जा सकता है. एमिट की गई वैल्यू एक ही टाइप की होनी चाहिए. उदाहरण के लिए, Flow<Int> एक ऐसा फ़्लो है जो पूर्णांक वैल्यू दिखाता है.
फ़्लो, Iterator की तरह ही होता है. यह वैल्यू का क्रम जनरेट करता है. हालांकि, यह वैल्यू जनरेट करने और इस्तेमाल करने के लिए, सस्पेंड फ़ंक्शन का इस्तेमाल करता है. इसका मतलब है कि उदाहरण के लिए, फ़्लो मुख्य थ्रेड को ब्लॉक किए बिना, अगली वैल्यू जनरेट करने के लिए सुरक्षित तरीके से नेटवर्क का अनुरोध कर सकता है.
डेटा की स्ट्रीम में तीन इकाइयां शामिल होती हैं:
- प्रोड्यूसर ऐसा डेटा बनाता है जिसे स्ट्रीम में जोड़ा जाता है. को-रूटीन की मदद से, फ़्लो भी एसिंक्रोनस तरीके से डेटा जनरेट कर सकते हैं.
- (ज़रूरी नहीं) इंटरमीडियरी, स्ट्रीम में भेजी गई हर वैल्यू या स्ट्रीम में बदलाव कर सकते हैं.
- उपयोगकर्ता, स्ट्रीम से वैल्यू इस्तेमाल करता है.
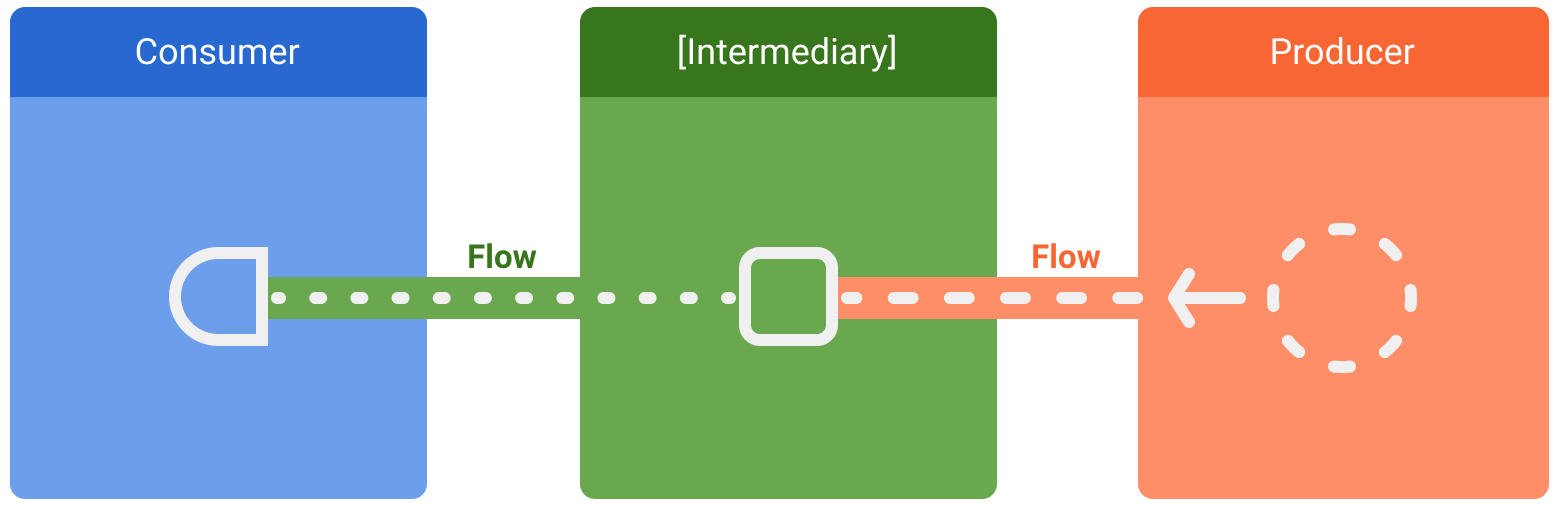
Android में, रिपॉज़िटरी आम तौर पर यूज़र इंटरफ़ेस (यूआई) डेटा का प्रोड्यूसर होता है. इसमें यूज़र इंटरफ़ेस (यूआई) को उपभोक्ता के तौर पर इस्तेमाल किया जाता है, ताकि डेटा को दिखाया जा सके. कभी-कभी, यूज़र इंटरफ़ेस (यूआई) लेयर, उपयोगकर्ता के इनपुट इवेंट जनरेट करती है. साथ ही, क्रम-व्यवस्था की अन्य लेयर उनका इस्तेमाल करती हैं. आम तौर पर, प्रोड्यूसर और उपभोक्ता के बीच की लेयर, इंटरमीडियरी के तौर पर काम करती हैं. ये डेटा की स्ट्रीम में बदलाव करती हैं, ताकि उसे अगली लेयर की ज़रूरतों के हिसाब से अडजस्ट किया जा सके.
फ़्लो बनाना
फ़्लो बनाने के लिए, फ़्लो बिल्डर एपीआई का इस्तेमाल करें. flow बिल्डर फ़ंक्शन, एक नया फ़्लो बनाता है. इसमें emit फ़ंक्शन का इस्तेमाल करके, डेटा की स्ट्रीम में नई वैल्यू मैन्युअल तरीके से जोड़ी जा सकती हैं.
यहां दिए गए उदाहरण में, डेटा सोर्स एक निश्चित समय अंतराल पर अपने-आप नई खबरें फ़ेच करता है. निलंबित फ़ंक्शन, एक साथ कई वैल्यू नहीं दिखा सकता. इसलिए, डेटा सोर्स इस ज़रूरत को पूरा करने के लिए एक फ़्लो बनाता है और उसे दिखाता है. इस मामले में, डेटा सोर्स, प्रोड्यूसर के तौर पर काम करता है.
class NewsRemoteDataSource( private val newsApi: NewsApi, private val refreshIntervalMs: Long = 5000 ) { val latestNews: Flow<List<ArticleHeadline>> = flow { while (true) { val latestNews = newsApi.fetchLatestNews() emit(latestNews) // Emits the result of the request to the flow delay(refreshIntervalMs) // Suspends the coroutine for some time } } } // Interface that provides a way to make network requests with suspend functions interface NewsApi { suspend fun fetchLatestNews(): List<ArticleHeadline> }
flow बिल्डर को कोरूटीन में एक्ज़ीक्यूट किया जाता है. इसलिए, इसे एसिंक्रोनस एपीआई का फ़ायदा मिलता है. हालांकि, कुछ पाबंदियां लागू होती हैं:
- फ़्लो क्रम से होते हैं. प्रड्यूसर, कोरूटीन में होता है. इसलिए, सस्पेंड फ़ंक्शन को कॉल करने पर, प्रड्यूसर तब तक सस्पेंड रहता है, जब तक सस्पेंड फ़ंक्शन वैल्यू नहीं लौटाता. इस उदाहरण में, प्रोड्यूसर
fetchLatestNewsतक निलंबित रहता है, जब तक कि नेटवर्क का अनुरोध पूरा नहीं हो जाता. इसके बाद ही, नतीजे को स्ट्रीम में भेजा जाता है. flowबिल्डर की मदद से, प्रोड्यूसर किसी दूसरेCoroutineContextसेemitवैल्यू नहीं चुन सकता. इसलिए, नई को-रूटीन बनाकर याwithContextकोड ब्लॉक का इस्तेमाल करके,emitको किसी दूसरेCoroutineContextमें कॉल न करें. इन मामलों में,callbackFlowजैसे अन्य फ़्लो बिल्डर का इस्तेमाल किया जा सकता है.
स्ट्रीम में बदलाव करना
इंटरमीडिएट ऑपरेटर, वैल्यू का इस्तेमाल किए बिना डेटा की स्ट्रीम में बदलाव कर सकते हैं. ये ऑपरेटर ऐसे फ़ंक्शन होते हैं जिन्हें डेटा की स्ट्रीम पर लागू करने पर, कार्रवाइयों की एक चेन सेट अप हो जाती है. इन कार्रवाइयों को तब तक लागू नहीं किया जाता, जब तक वैल्यू का इस्तेमाल आने वाले समय में नहीं किया जाता. फ़्लो के रेफ़रंस दस्तावेज़ में, इंटरमीडिएट ऑपरेटर के बारे में ज़्यादा जानें.
यहां दिए गए उदाहरण में, रिपॉज़िटरी लेयर, इंटरमीडिएट ऑपरेटर map का इस्तेमाल करके, View पर दिखाए जाने वाले डेटा को बदलती है:
class NewsRepository( private val newsRemoteDataSource: NewsRemoteDataSource, private val userData: UserData ) { /** * Returns the favorite latest news applying transformations on the flow. * These operations are lazy and don't trigger the flow. They just transform * the current value emitted by the flow at that point in time. */ val favoriteLatestNews: Flow<List<ArticleHeadline>> = newsRemoteDataSource.latestNews // Intermediate operation to filter the list of favorite topics .map { news -> news.filter { userData.isFavoriteTopic(it) } } // Intermediate operation to save the latest news in the cache .onEach { news -> saveInCache(news) } }
इंटरमीडिएट ऑपरेटर को एक के बाद एक लागू किया जा सकता है. इससे ऑपरेशनों की एक चेन बन जाती है. जब कोई आइटम फ़्लो में भेजा जाता है, तब इन ऑपरेशनों को लेज़ी तरीके से लागू किया जाता है. ध्यान दें कि किसी स्ट्रीम पर सिर्फ़ इंटरमीडिएट ऑपरेटर लागू करने से, फ़्लो कलेक्शन शुरू नहीं होता.
किसी फ़्लो से डेटा इकट्ठा करना
वैल्यू सुनने की प्रोसेस को ट्रिगर करने के लिए, टर्मिनल ऑपरेटर का इस्तेमाल करें. स्ट्रीम में मौजूद सभी वैल्यू को उनके हिसाब से पाने के लिए, collect का इस्तेमाल करें.
Flow के आधिकारिक दस्तावेज़ में जाकर, टर्मिनल ऑपरेटर के बारे में ज़्यादा जानें.
collect एक सस्पेंड फ़ंक्शन है. इसलिए, इसे कोरूटीन में ही एक्ज़ीक्यूट किया जाना चाहिए. यह एक पैरामीटर के तौर पर लैंबडा लेता है, जिसे हर नई वैल्यू पर कॉल किया जाता है. यह एक सस्पेंड फ़ंक्शन है. इसलिए, collect को कॉल करने वाली कोरूटीन, फ़्लो बंद होने तक सस्पेंड हो सकती है.
पिछले उदाहरण को जारी रखते हुए, यहां रिपॉज़िटरी लेयर से डेटा इस्तेमाल करने वाले ViewModel को लागू करने का एक सामान्य तरीका बताया गया है:
class LatestNewsViewModel( private val newsRepository: NewsRepository ) : ViewModel() { init { viewModelScope.launch { // Trigger the flow and consume its elements using collect newsRepository.favoriteLatestNews.collect { favoriteNews -> // Update UI with the latest favorite news } } } }
डेटा इकट्ठा करने की प्रोसेस शुरू होने पर, प्रोड्यूसर को ट्रिगर किया जाता है. यह प्रोड्यूसर, ताज़ा खबरों को रीफ़्रेश करता है. साथ ही, नेटवर्क अनुरोध के नतीजे को तय समय पर भेजता है. while(true) लूप के साथ प्रोड्यूसर हमेशा चालू रहता है. इसलिए, ViewModel के बंद होने और viewModelScope के रद्द होने पर, डेटा की स्ट्रीम बंद हो जाएगी.
फ़्लो कलेक्शन इन वजहों से बंद हो सकता है:
- पिछले उदाहरण में दिखाए गए तरीके से, डेटा इकट्ठा करने वाली कोरूटीन को रद्द कर दिया जाता है. इससे, वीडियो बनाने वाले व्यक्ति का खाता भी बंद हो जाता है.
- प्रोड्यूसर, आइटम भेजना बंद कर देता है. इस मामले में, डेटा की स्ट्रीम बंद हो जाती है और
collectको कॉल करने वाला कोराउटीन फिर से काम करना शुरू कर देता है.
फ़्लो कोल्ड और लेज़ी होते हैं. हालांकि, इन्हें इंटरमीडिएट ऑपरेटर के साथ इस्तेमाल किया जा सकता है. इसका मतलब है कि जब भी फ़्लो पर टर्मिनल ऑपरेटर को कॉल किया जाता है, तब प्रोड्यूसर कोड को एक्ज़ीक्यूट किया जाता है. पिछले उदाहरण में, एक से ज़्यादा फ़्लो कलेक्टर होने की वजह से, डेटा सोर्स अलग-अलग तय इंटरवल पर कई बार नई खबरें फ़ेच करता है. जब एक साथ कई उपभोक्ता डेटा इकट्ठा करते हैं, तब फ़्लो को ऑप्टिमाइज़ करने और शेयर करने के लिए, shareIn ऑपरेटर का इस्तेमाल करें.
अनचाहे अपवादों को पकड़ना
प्रोड्यूसर को लागू करने का काम, तीसरे पक्ष की लाइब्रेरी से किया जा सकता है.
इसका मतलब है कि यह उम्मीद से अलग अपवाद दे सकता है. इन अपवादों को हैंडल करने के लिए, catch इंटरमीडिएट ऑपरेटर का इस्तेमाल करें.
class LatestNewsViewModel( private val newsRepository: NewsRepository ) : ViewModel() { init { viewModelScope.launch { newsRepository.favoriteLatestNews // Intermediate catch operator. If an exception is thrown, // catch and update the UI .catch { exception -> notifyError(exception) } .collect { favoriteNews -> // Update UI with the latest favorite news } } } }
पिछले उदाहरण में, जब कोई अपवाद होता है, तो collect लैम्ब्डा को कॉल नहीं किया जाता, क्योंकि कोई नया आइटम नहीं मिला है.
catch को फ़्लो में आइटम emit करने का विकल्प भी मिलता है. उदाहरण के तौर पर दी गई रिपॉज़िटरी लेयर, कैश मेमोरी में सेव की गई वैल्यू को emit कर सकती है:
class NewsRepository( // ... ) { val favoriteLatestNews: Flow<List<ArticleHeadline>> = newsRemoteDataSource.latestNews .map { news -> news.filter { userData.isFavoriteTopic(it) } } .onEach { news -> saveInCache(news) } // If an error happens, emit the last cached values .catch { exception -> emit(lastCachedNews()) } }
इस उदाहरण में, अपवाद होने पर collect लैम्डा को कॉल किया जाता है, क्योंकि अपवाद की वजह से स्ट्रीम में एक नया आइटम जोड़ा गया है.
किसी दूसरे CoroutineContext में एक्ज़ीक्यूट करना
डिफ़ॉल्ट रूप से, flow बिल्डर का प्रोड्यूसर, उस कोरूटीन के CoroutineContext में एक्ज़ीक्यूट होता है जो उससे डेटा इकट्ठा करता है. जैसा कि पहले बताया गया है, यह किसी दूसरे CoroutineContext से emit वैल्यू नहीं कर सकता. कुछ मामलों में, यह व्यवहार सही नहीं हो सकता.
उदाहरण के लिए, इस विषय में इस्तेमाल किए गए उदाहरणों में, रिपॉज़िटरी लेयर को Dispatchers.Main पर ऐसी कार्रवाइयां नहीं करनी चाहिए जिनका इस्तेमाल viewModelScope करता है.
किसी फ़्लो के CoroutineContext को बदलने के लिए, इंटरमीडिएट ऑपरेटर flowOn का इस्तेमाल करें.
flowOn, अपस्ट्रीम फ़्लो के CoroutineContext को बदलता है. इसका मतलब है कि प्रोड्यूसर और flowOn से पहले (या ऊपर) लागू किए गए इंटरमीडिएट ऑपरेटर. डाउनस्ट्रीम फ़्लो (इंटरमीडिएट ऑपरेटर बाद में flowOn
के साथ-साथ उपभोक्ता) पर कोई असर नहीं पड़ता. साथ ही, यह उस CoroutineContext पर काम करता है जिसका इस्तेमाल फ़्लो से collect करने के लिए किया जाता है. अगर एक से ज़्यादा flowOn ऑपरेटर मौजूद हैं, तो हर ऑपरेटर अपनी मौजूदा जगह से अपस्ट्रीम को बदल देता है.
class NewsRepository( private val newsRemoteDataSource: NewsRemoteDataSource, private val userData: UserData, private val defaultDispatcher: CoroutineDispatcher ) { val favoriteLatestNews: Flow<List<ArticleHeadline>> = newsRemoteDataSource.latestNews .map { news -> // Executes on the default dispatcher news.filter { userData.isFavoriteTopic(it) } } .onEach { news -> // Executes on the default dispatcher saveInCache(news) } // flowOn affects the upstream flow ↑ .flowOn(defaultDispatcher) // the downstream flow ↓ is not affected .catch { exception -> // Executes in the consumer's context emit(lastCachedNews()) } }
इस कोड के साथ, onEach और map ऑपरेटर, defaultDispatcher का इस्तेमाल करते हैं. वहीं, catch ऑपरेटर और उपभोक्ता को viewModelScope के इस्तेमाल किए गए Dispatchers.Main पर एक्ज़ीक्यूट किया जाता है.
डेटा सोर्स लेयर, I/O का काम करती है. इसलिए, आपको I/O कार्रवाइयों के लिए ऑप्टिमाइज़ किए गए डिसपैचर का इस्तेमाल करना चाहिए:
class NewsRemoteDataSource( // ... private val ioDispatcher: CoroutineDispatcher ) { val latestNews: Flow<List<ArticleHeadline>> = flow { // Executes on the IO dispatcher // ... } .flowOn(ioDispatcher) }
Jetpack लाइब्रेरी में फ़्लो
फ़्लो को कई Jetpack लाइब्रेरी में इंटिग्रेट किया गया है. साथ ही, यह Android की तीसरे पक्ष की लाइब्रेरी में लोकप्रिय है. लाइव डेटा अपडेट और डेटा की लगातार स्ट्रीम के लिए, Flow सबसे सही विकल्प है.
डेटाबेस में हुए बदलावों के बारे में सूचना पाने के लिए, रूम के साथ फ़्लो का इस्तेमाल किया जा सकता है. डेटा ऐक्सेस ऑब्जेक्ट (डीएओ) का इस्तेमाल करते समय, लाइव अपडेट पाने के लिए Flow टाइप दिखाएं.
@Dao abstract class ExampleDao { @Query("SELECT * FROM Example") abstract fun getExamples(): Flow<List<Example>> }
Example टेबल में बदलाव होने पर, डेटाबेस में मौजूद नए आइटम के साथ एक नई सूची जारी की जाती है.
कॉल बैक पर आधारित एपीआई को फ़्लो में बदलना
callbackFlow एक फ़्लो बिल्डर है. इसकी मदद से, कॉलबैक पर आधारित एपीआई को फ़्लो में बदला जा सकता है.
उदाहरण के लिए, Firebase Firestore के Android API, कॉलबैक का इस्तेमाल करते हैं.
इन एपीआई को फ़्लो में बदलने और Firestore डेटाबेस के अपडेट सुनने के लिए, इस कोड का इस्तेमाल किया जा सकता है:
class FirestoreUserEventsDataSource(
    private val firestore: FirebaseFirestore
) {
    // Method to get user events from the Firestore database
    fun getUserEvents(): Flow<UserEvents> = callbackFlow {

        // Reference to use in Firestore
        var eventsCollection: CollectionReference? = null
        try {
            eventsCollection = FirebaseFirestore.getInstance()
                .collection("collection")
                .document("app")
        } catch (e: Throwable) {
            // If Firebase cannot be initialized, close the stream of data
            // flow consumers will stop collecting and the coroutine will resume
            close(e)
        }

        // Registers callback to firestore, which will be called on new events
        val subscription = eventsCollection?.addSnapshotListener { snapshot, _ ->
            if (snapshot == null) { return@addSnapshotListener }
            // Sends events to the flow! Consumers will get the new events
            try {
                trySend(snapshot.getEvents())
            } catch (e: Throwable) {
                // Event couldn't be sent to the flow
            }
        }

        // The callback inside awaitClose will be executed when the flow is
        // either closed or cancelled.
        // In this case, remove the callback from Firestore
        awaitClose { subscription?.remove() }
    }
}
flow बिल्डर के उलट, callbackFlow send फ़ंक्शन का इस्तेमाल करके, किसी दूसरे CoroutineContext से वैल्यू को एमिट करने की अनुमति देता है. इसके अलावा, trySend फ़ंक्शन का इस्तेमाल करके, कोरूटीन के बाहर से वैल्यू को एमिट करने की अनुमति देता है.
आंतरिक तौर पर, callbackFlow एक चैनल का इस्तेमाल करता है. यह कॉन्सेप्ट के तौर पर, ब्लॉकिंग कतार से काफ़ी मिलता-जुलता है.
चैनल को क्षमता के साथ कॉन्फ़िगर किया जाता है. यह बफ़र किए जा सकने वाले एलिमेंट की ज़्यादा से ज़्यादा संख्या होती है. callbackFlow में बनाए गए चैनल में, डिफ़ॉल्ट रूप से 64 एलिमेंट शामिल किए जा सकते हैं. किसी पूरे चैनल में नया एलिमेंट जोड़ने की कोशिश करने पर, send, प्रोड्यूसर को तब तक निलंबित कर देता है, जब तक नए एलिमेंट के लिए जगह नहीं बन जाती. वहीं, trySend, एलिमेंट को चैनल में नहीं जोड़ता है और तुरंत false दिखाता है.
trySend, चैनल में तय किया गया एलिमेंट तुरंत जोड़ देता है. हालांकि, ऐसा सिर्फ़ तब होता है, जब इससे चैनल की क्षमता से जुड़ी पाबंदियों का उल्लंघन न हो. इसके बाद, यह ऑपरेशन के पूरा होने की जानकारी देता है.