Android Bench 2.0: расширение границ с помощью сложных долгосрочных задач
Время на чтение: 3 минуты
Когда мы только запустили Android Bench, мы создали строгую основу для оценки того, как большие языковые модели (LLM) помогают разработчикам в решении реальных задач Android. По мере развития ИИ-моделей и агентов мы обновляем свою методологию, например согласовываем фреймворк для тестирования с фреймворком Harbor. Сегодня мы выпускаем первый набор долгосрочных задач (LHT). Это задачи высокой сложности, на выполнение которых у инженера уходит несколько дней или даже неделя. Мы также внедряем оценку агентов, начиная с агентов от соответствующих поставщиков моделей. Так появился Android Bench 2.0 – крупное обновление, предназначенное для оценки ИИ-моделей и агентов в условиях масштабируемости, неопределенности и сложных многоэтапных задач, с которыми вы сталкиваетесь каждый день.
От небольших исправлений до долгосрочных задач
Первая итерация Android Bench, как и другие ранние тесты ИИ-кодинга, была сосредоточена на постепенных изменениях в существующих репозиториях, во многих случаях ограничиваясь исправлением ошибок или небольшими запросами на добавление функций. Это отражало возможности ИИ-помощника на тот момент, а также то, как вы его использовали.
Чтобы вы могли находить модели и агенты программирования, которые лучше всего подходят для вашего рабочего процесса, мы повысили требования к оценке. Теперь они соответствуют задачам, которые вы делегируете ИИ. Android Bench 2.0 отражает эти амбициозные задачи с помощью LHT, которые включают обновление зависимостей, добавление новых функций, создание приложений с нуля или преобразование межплатформенного приложения в Android.
Сложные задачи требуют более детальной оценки и подсчета баллов
При оценке многодневных инженерных задач бинарная система (сдал/не сдал) не дает полной картины.
Например, агент может провести рефакторинг 40 экранов на Jetpack Compose, настроить таблицы базы данных и выполнить 90% требований, но не пройти одну проверку в пограничном случае. Бинарная оценка дает этому запуску 0%, скрывая архитектурные возможности модели. Мы переходим на непрерывную оценку, чтобы предоставлять более значимые сигналы как для разработки моделей, так и для вашего понимания того, как ИИ может вам помочь.
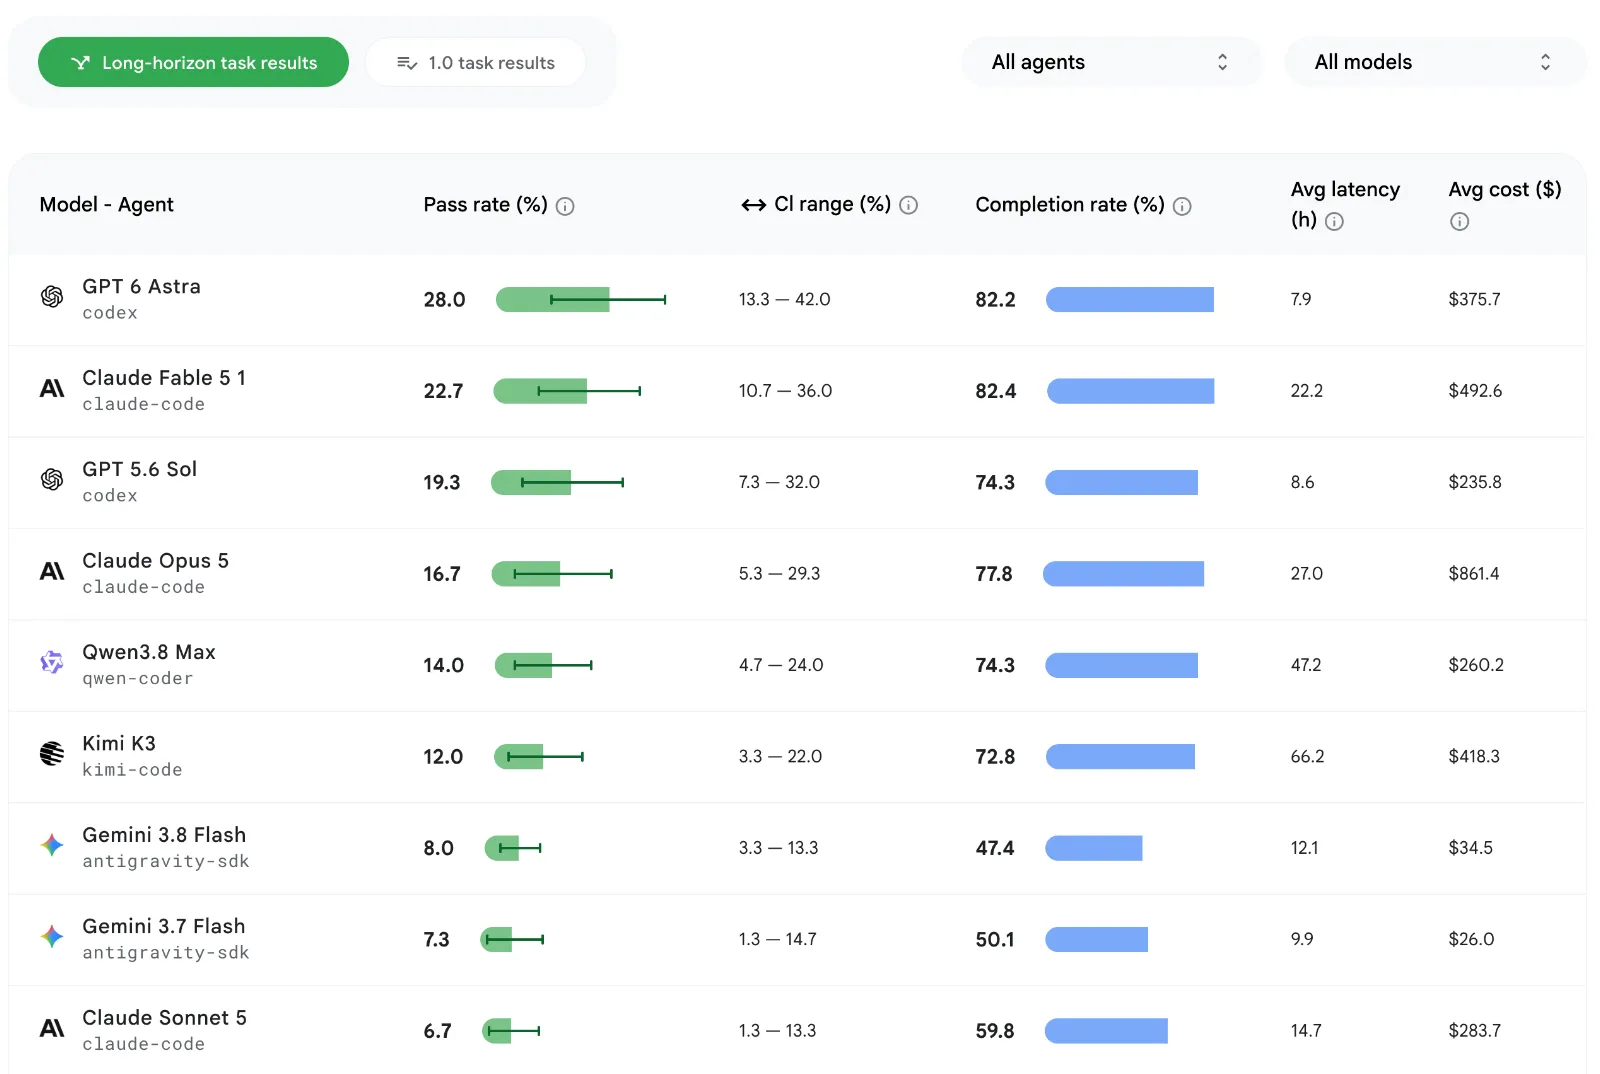
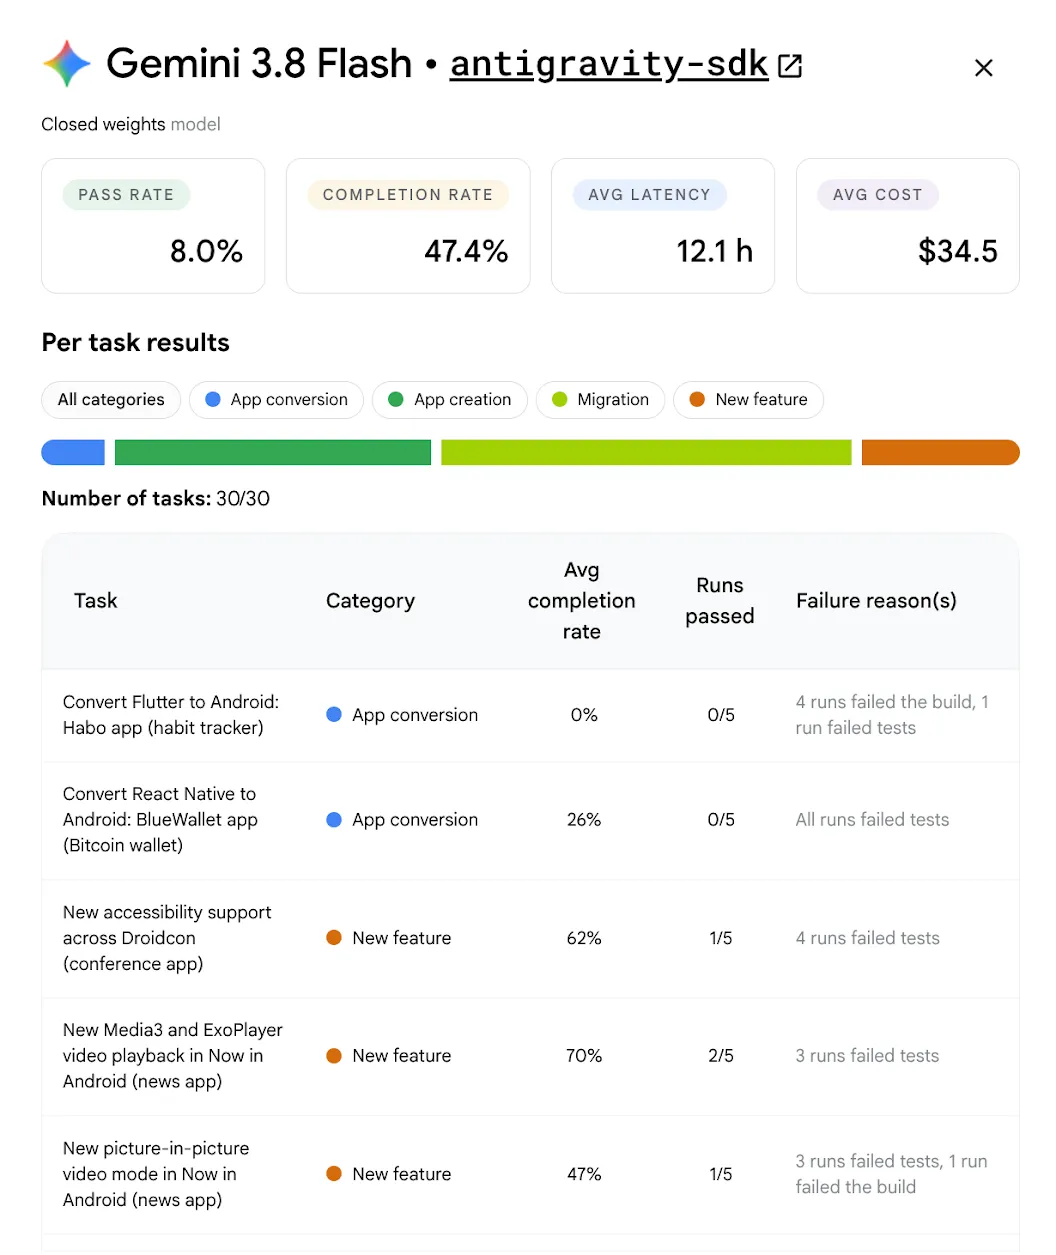
При расчете этого коэффициента завершения учитываются различные факторы, такие как функциональность, визуальная точность и отсутствие регрессий. Мы также применяем объективные штрафы за отклонения от инструкций по оценке или структурных ограничений. Ознакомьтесь с обновленной таблицей лидеров и нажмите на карточку каждой модели, чтобы увидеть дополнительные элементы, такие как процент успешных попыток, коэффициент завершения и средние затраты на модель и на задачу.
Наивысший показатель успешности для LHT составляет около 28%, что намного ниже, чем примерно 91% для исходных задач в тесте.
Долгосрочные задачи помогают ИИ-помощнику находить полезные подсказки
Набор данных LHT не только позволяет оценить, насколько хорошо ИИ справляется с длительными задачами, но и помогает нам больше узнать о сильных и слабых сторонах тестируемых моделей, чтобы мы могли предложить вам более практичные рекомендации.
На всех уровнях ИИ лучше справляется с написанием нового кода, чем с рефакторингом существующего. Рефакторинг и миграция усложняются, поскольку успех зависит от сложности архитектуры, а не от объема кода.
Модели демонстрируют высокую эффективность при выполнении хорошо изученных детерминированных преобразований, таких как конвертация Java в Kotlin, замена Retrofit на Ktor или внедрение слоя ViewModel. Они последовательно применяют эти шаблоны, даже в более чем 125 файлах и 8000 строках кода.
Однако модели испытывают трудности, когда задачи требуют проверки во время выполнения (например, отсутствуют графы внедрения зависимостей), включают критические изменения фреймворка или сталкиваются с пробелами в знаниях о невыпущенных библиотеках. Перенос кросс-платформенных приложений на Android остается сложной задачей. Ни одна модель не достигает 100% успешности, а передовые модели достигают максимум 80% коэффициента завершения.
Представляем оценку агентов
Чтобы вы могли лучше понять, как модели работают в агентных рабочих процессах, мы добавляем в оценку часто используемых агентов. Сначала мы запустим новые модели в LHT с агентами от соответствующего поставщика моделей. Например, мы запустили GPT 5.6 Sol в Codex и Gemini 3.8 Flash в Google Antigravity. Такое сочетание показывает, как дизайн тестового окружения положительно влияет на результаты разработчиков, поскольку мы видели, что кеширование подсказок и компактное окно инструмента могут привести к сокращению количества токенов.
В будущем мы расширим эту функцию, чтобы вы могли сравнивать результаты работы разных моделей и агентов и выбирать наиболее подходящие для вас и вашей команды.
Мы вкладываем средства в эту оценку, потому что для вас важно иметь возможность использовать выбранного вами агента и модель для разработки под Android. В ближайшие недели мы поделимся с вами дополнительной информацией.
Добавлены новые модели
Кроме того, мы продолжаем расширять рейтинг, чтобы у вас были самые актуальные данные для принятия решений о разработке. Мы добавили Gemini 3.8 Flash, Gemini 3.7 Flash, GPT-6 от OpenAI, Fable 5.1 от Anthropic, Kimi K3 и Qwen 3.8 Max. Лучший результат показала GPT-6 Astra от OpenAI, которая справилась с 28% задач.
Перспективы
Android Bench 2.0 – это надежная среда для оценки ИИ в разработке для Android. Мы надеемся, что благодаря сочетанию долгосрочных задач, мультимодальной оценки, агентов и непрерывной оценки исследовательские команды смогут создавать более эффективных и надежных ИИ-партнеров для программирования, а вы получите более прозрачную информацию о возможностях разработки ИИ.
Ознакомьтесь с обновленным рейтингом и обновленной методологией. Ваши отзывы напрямую влияют на то, как мы развиваем Android Bench, поэтому продолжайте делиться ими на GitHub, а также в наших социальных сетях, таких как X и LinkedIn.
-
 Новости о продуктах
Сегодня на Саммите для разработчиков Android мы объявляем о широкой доступности многих инструментов и API, которые помогут вам преодолевать повседневные трудности и дадут больше гибкости при создании отличных приложений для Android.
Matthew McCullough • Время на чтение: 4 минуты -
 Новости о продуктах
По мере развития агентных технологий разработка для Android выходит на новый уровень: от помощи в написании кода до агентов, которые выполняют задачи от начала до конца под вашим руководством. Вы можете выбирать модели и агентов и гибко настраивать их.
Jason Buchel • Время на чтение: 3 минуты -

 Новости о продуктах
Разработчики Android могут выбирать из множества агентов, LLM, инструментов и интерфейсов командной строки (CLI) для разработки приложений. Наша цель – помочь вам создавать красивые и качественные приложения для Android, независимо от того, какой способ разработки вы выберете.
Simona Milanovic • Время на чтение: 4 минуты
Получайте еженедельную рассылку с последними новостями о разработке для Android.