Android Bench 2.0: ampliando as fronteiras com tarefas desafiadoras de longa duração
Leitura de 3 min
Quando lançamos o Android Bench, criamos uma base rigorosa para avaliar como os modelos de linguagem grandes (LLMs) ajudam os desenvolvedores com tarefas reais do Android. À medida que os modelos e agentes de IA evoluem rapidamente, atualizamos nossa metodologia, como o alinhamento do nosso framework de comparativo de mercado com o framework Harbor. Hoje, estamos lançando o primeiro conjunto de tarefas de longo alcance (LHT, na sigla em inglês), que são tarefas de grande complexidade que levam vários dias ou até uma semana para serem concluídas por um engenheiro. Também estamos lançando a avaliação de agentes, começando com os agentes dos provedores de modelos correspondentes. Com essa adição, chegamos ao Android Bench 2.0, um upgrade importante projetado para avaliar modelos e agentes de IA em relação à escala, ambiguidade e resolução de problemas complexos de várias etapas que você enfrenta todos os dias.
De correções incrementais a tarefas de longo alcance
A primeira versão do Android Bench, assim como outros benchmarks de programação de IA, se concentrava em mudanças incrementais em repositórios existentes, muitas vezes limitadas a correções de bugs ou solicitações de recursos menores. Isso refletia os recursos da Assistência de IA na época, bem como a forma como você a usava.
Para continuar ajudando você a encontrar os modelos e agentes de programação mais adequados ao seu fluxo de trabalho de desenvolvimento, elevamos o nível das nossas avaliações para corresponder ao trabalho que você delega à IA. O Android Bench 2.0 reflete esses desafios ambiciosos com LHTs que incluem o upgrade de dependências, a adição de novos recursos, a criação de apps do zero ou a conversão de um app multiplataforma para o Android.
Tarefas complexas exigem uma avaliação e pontuação mais detalhadas
Em tarefas de engenharia de vários dias, a classificação binária de aprovação ou reprovação não captura o panorama completo.
Por exemplo, um agente pode refatorar 40 telas para o Jetpack Compose, configurar tabelas de banco de dados e atender a 90% dos requisitos, mas falhar em uma única declaração de caso extremo. A pontuação binária classifica essa execução como 0%, ocultando os recursos arquitetônicos do modelo. Estamos migrando para a pontuação contínua para fornecer um indicador mais significativo, tanto para o desenvolvimento de modelos quanto para que você entenda como a IA pode ajudar.
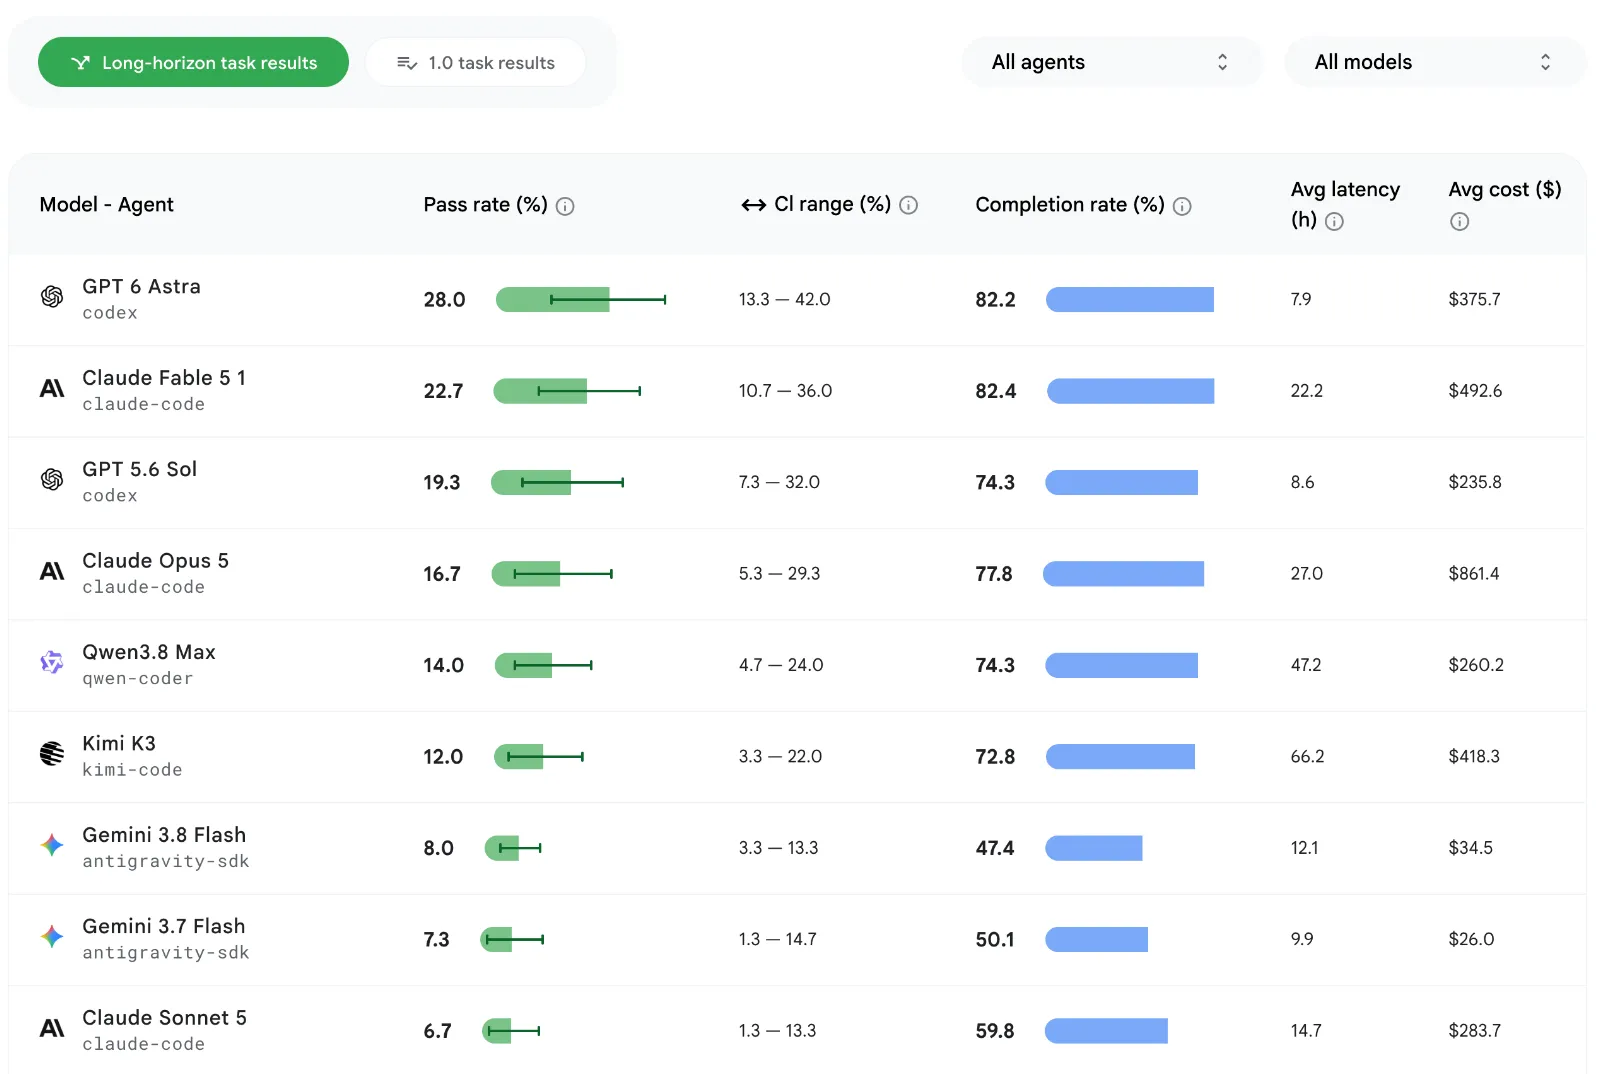
Calculamos essa taxa de conclusão com base em uma combinação de fatores, como funcionalidade, fidelidade visual e prevenção de regressões. Também aplicamos penalidades objetivas de pontuação para desvios das instruções de avaliação ou restrições estruturais. Confira o ranking atualizado e clique na visualização de card de cada modelo para ver outros elementos, como a taxa de aprovação, a taxa de conclusão e os custos médios por modelo e por tarefa.
A maior taxa de aprovação para LHTs é de cerca de 28%, muito menor do que os ~91% das tarefas originais no comparativo de mercado.
Tarefas de longo alcance revelam informações úteis para a assistência de IA
Além de medir o desempenho da IA em tarefas de longa duração, o conjunto de dados LHT nos ajuda a entender melhor os pontos fortes e fracos dos modelos testados, o que nos permite oferecer orientações mais práticas.
Em todos os níveis de modelo, a IA é melhor para escrever códigos novos do que para refatorar códigos existentes. As refatorações e migrações ficam mais complicadas porque o sucesso depende da complexidade da arquitetura, não do volume de código.
Os modelos mostram recursos fortes em transformações determinísticas bem estabelecidas, como converter Java em Kotlin, trocar o Retrofit pelo Ktor ou introduzir uma camada ViewModel. Ele aplica esses padrões de forma consistente, mesmo em mais de 125 arquivos e 8.000 linhas de código.
No entanto, os modelos têm dificuldade quando as tarefas exigem validação de ambiente de execução (como gráficos de injeção de dependência ausentes), envolvem mudanças interruptivas no framework ou encontram lacunas de conhecimento com bibliotecas não lançadas. A portabilidade de apps multiplataforma para o Android continua sendo um desafio em aberto: nenhum modelo atinge uma taxa de aprovação de 100%, e os modelos de fronteira alcançam, no máximo, uma taxa de conclusão de 80%.
Introdução às avaliações de agentes
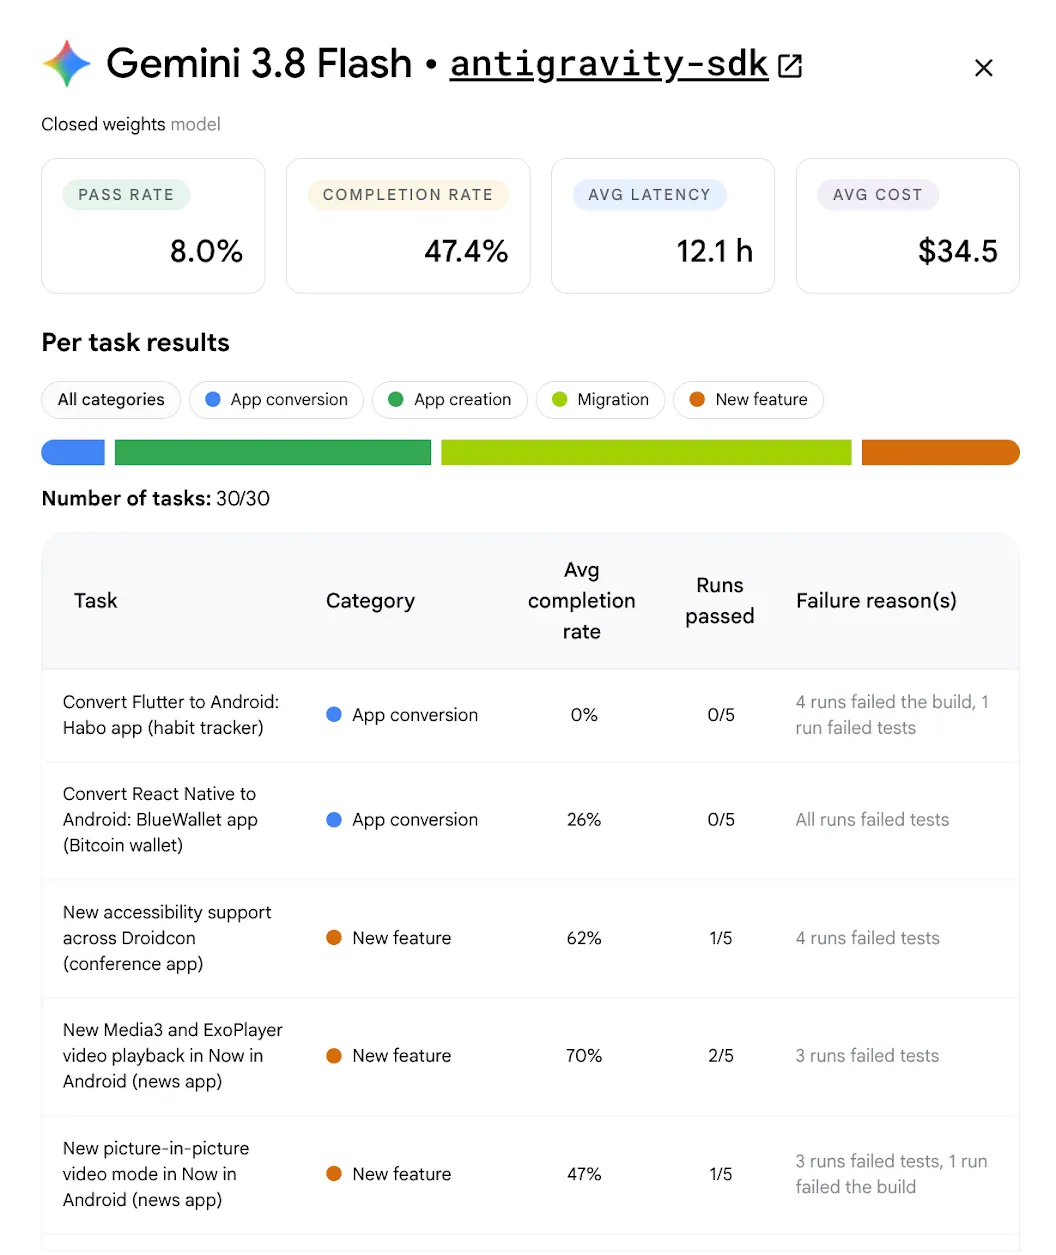
Para ajudar você a entender melhor o desempenho dos modelos quando integrados aos seus Agentic Workflows, estamos adicionando agentes usados com frequência à nossa avaliação. Estamos começando a executar novos modelos em LHTs com agentes do provedor de modelos correspondente. Por exemplo, executamos o GPT 5.6 Sol no Codex e o Gemini 3.8 Flash no Google Antigravity. Essa combinação mostra como o design do harness afeta positivamente os resultados dos desenvolvedores, já que o armazenamento em cache de comandos e as janelas de ferramentas compactas podem resultar em reduções de tokens.
No futuro, vamos expandir esse recurso para destacar os resultados de várias combinações de modelos e agentes, ajudando você a descobrir quais funcionam melhor para você e sua equipe.
Investimos nessa medição porque é importante que você possa usar o agente e o modelo de sua escolha para o desenvolvimento Android. Teremos mais informações para compartilhar com você nas próximas semanas.
Novos modelos adicionados
Além disso, continuamos expandindo nosso ranking para garantir que você tenha os dados mais atualizados para suas decisões de desenvolvimento. Adicionamos o Gemini 3.8 Flash, o Gemini 3.7 Flash, o GPT-6 da OpenAI, o Fable 5.1 da Anthropic, o Kimi K3 e o Qwen 3.8 Max, com o GPT-6 Astra da OpenAI no topo, com uma taxa de aprovação de 28%.
Planos para o futuro
O Android Bench 2.0 oferece um ambiente robusto para medir a IA para desenvolvedor Android. Ao combinar tarefas de longo alcance, avaliação multimodal, agentes e pontuação contínua, esperamos capacitar as equipes de pesquisa de IA a criar parceiros de programação de IA mais capazes e confiáveis, além de oferecer mais transparência sobre as opções de desenvolvimento de IA.
Confira o ranking atualizado e a metodologia atualizada. Seu feedback influencia diretamente a evolução do Android Bench. Por isso, continue compartilhando suas opiniões no GitHub e nos nossos canais sociais, como X e LinkedIn.
-
 Notícias sobre produtos
Hoje, no Android Dev Summit, anunciamos a ampla disponibilidade de muitas ferramentas e APIs projetadas para remover o atrito diário e oferecer mais flexibilidade para criar ótimos apps Android.
Matthew McCullough • Leitura de 4 min -
 Notícias sobre produtos
Com o avanço do desenvolvimento agêntico, a engenharia do Android está alcançando uma nova fronteira: passar do preenchimento automático de código para agentes que executam tarefas de ponta a ponta sob sua orientação. Você tem total liberdade de escolha e flexibilidade nos modelos e agentes que usa.
Jason Buchel • Leitura de 3 min -

 Notícias sobre produtos
Como desenvolvedor Android, você tem muitas opções de agentes, LLMs, ferramentas e interfaces de linha de comando (CLI) para usar no desenvolvimento de apps. Nosso objetivo é ajudar você a criar apps Android bonitos e de alta qualidade, não importa como você escolha fazer isso.
Simona Milanovic • Leitura de 4 min
Receba os insights mais recentes sobre o desenvolvimento para Android na sua caixa de entrada toda semana.