وقتی برای اولینبار Android Bench را راهاندازی کردیم، پایهای دقیق برای ارزیابی نحوه کمک مدلهای زبانی بزرگ (LLM) به توسعهدهندگان در انجام وظایف واقعی Android ایجاد کردیم. با تکامل سریع مدلها و عوامل هوش مصنوعی، ما روششناسی خود را بهروز کردهایم، ازجمله همسو کردن چارچوب محکزنی خود با چارچوب Harbor. امروز اولین مجموعه از تکالیف چندگامی (LHT) را منتشر میکنیم که تکالیفی بسیار پیچیده هستند و تکمیل آنها برای یک مهندس چند روز یا حتی یک هفته طول میکشد. همچنین درحال معرفی ارزیابی عاملگرا هستیم که با نمایندگان ارائهدهندگان مدل مربوطه شروع میشود. این افزودنی ما را به Android Bench 2.0 میرساند—یک ارتقای بزرگ که برای ارزیابی مدلها و عوامل هوش مصنوعی دربرابر مقیاس، ابهام، و حل مسئله چندمرحلهای پیچیدهای که هر روز با آن مواجه میشوید طراحی شده است.
از اصلاحات افزایشی تا تکالیف چندگامی
اولین تکرار Android Bench، همراه با محکهای کدنویسی هوش مصنوعی اولیه مشابه، بر تغییرات افزایشی در مخازن موجود تمرکز داشت که در بسیاری از موارد به رفع اشکال یا درخواستهای ویژگی کوچکتر محدود میشد. این امر بازتابی از تواناییهای کمک هوش مصنوعی در آن زمان و همچنین نحوه استفاده شما از آن بود.
برای اینکه همچنان به شما کمک کنیم مدلها و عاملهای کدنویسی را که برای گردش کار توسعه شما مناسبتر هستند پیدا کنید، سطح ارزیابیهایمان را ارتقا دادهایم تا با کارهایی که به هوش مصنوعی واگذار میکنید مطابقت داشته باشد. Android Bench 2.0 این چالشهای بلندپروازانه را با «تکالیف طولانیمدت» منعکس میکند که شامل ارتقای وابستگیها، افزودن ویژگیهای جدید، ساختن برنامهها از ابتدا، یا تبدیل برنامه چندسکویی به Android است.
تکالیف پیچیده به ارزیابی و امتیازدهی دقیقتری نیاز دارند
در تکالیف مهندسی چندروزه، نمرهدهی دودویی قبولی یا مردودی تصویر کاملی ارائه نمیدهد.
برای مثال، یک عامل ممکن است ۴۰ صفحه را به Jetpack Compose بازسازی کند، جدولهای پایگاه داده را راهاندازی کند، و ۹۰٪ از الزامات را برآورده کند، اما در یک ادعای حالت مرزی واحد شکست بخورد. امتیازدهی دودویی این اجرا را ۰٪ ارزیابی میکند و قابلیتهای معماری مدل را پنهان میکند. ما درحال حرکت بهسمت امتیازدهی مستمر هستیم تا سیگنال معنادارتری را هم برای توسعه مدل و هم برای درک شما از اینکه هوش مصنوعی چگونه میتواند به شما کمک کند ارائه دهیم.
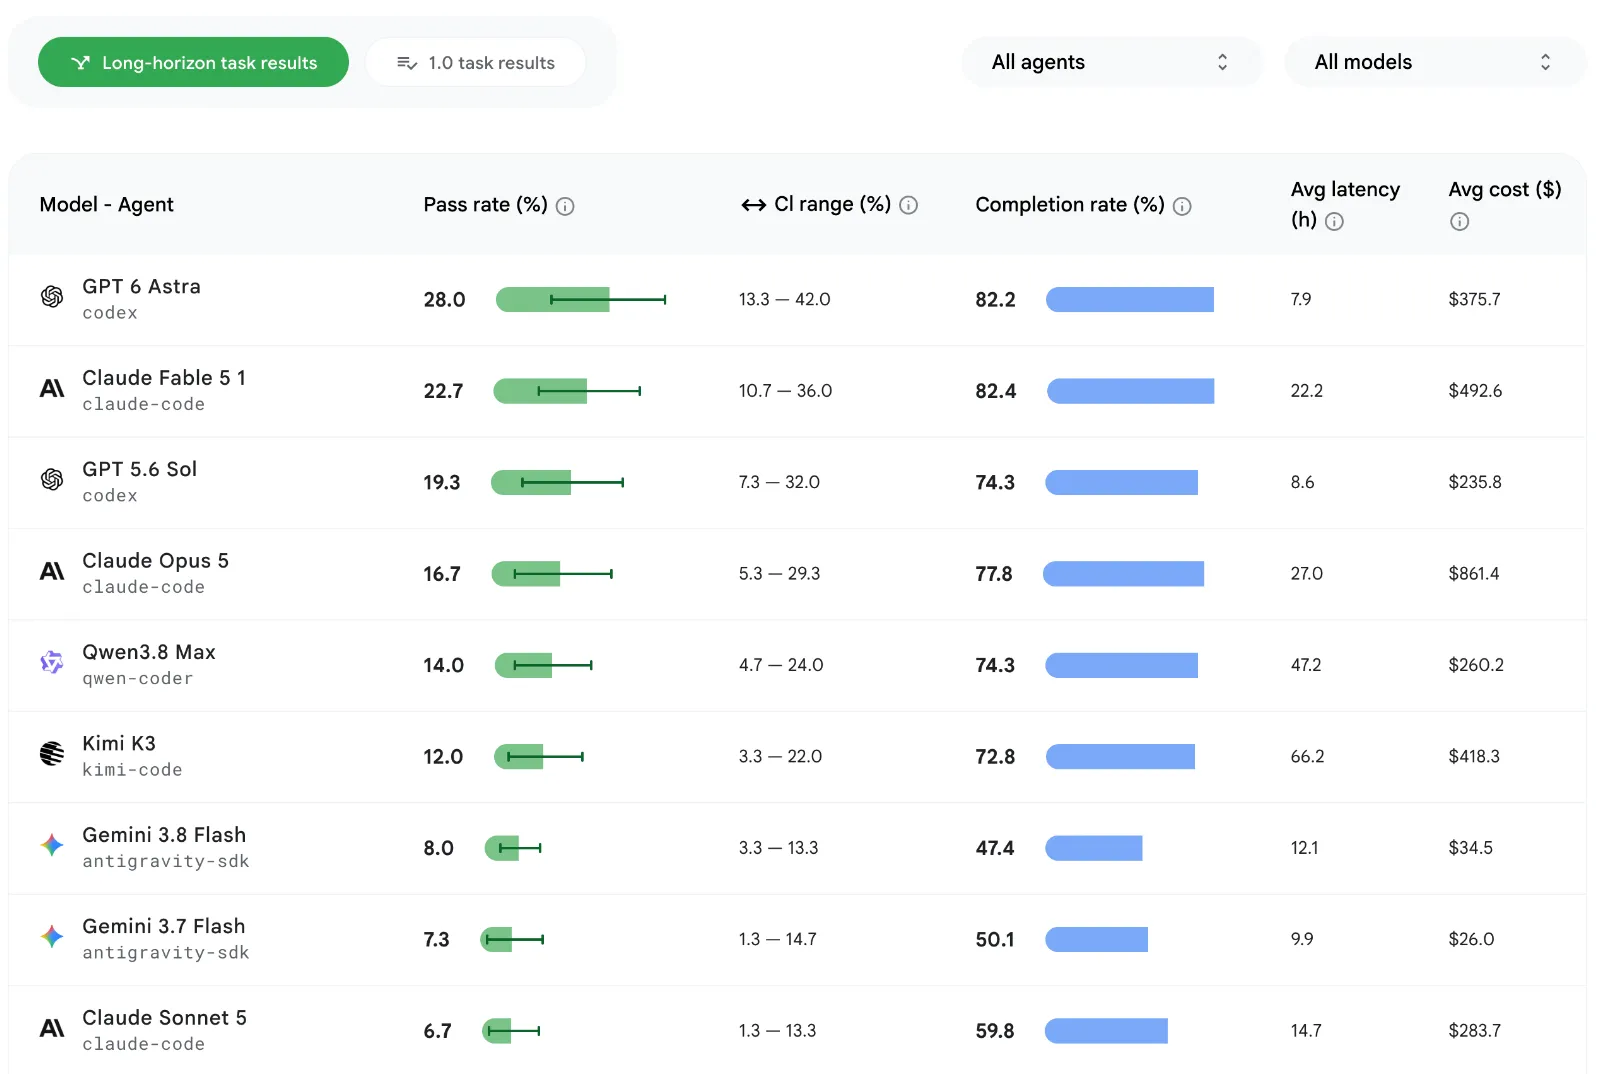
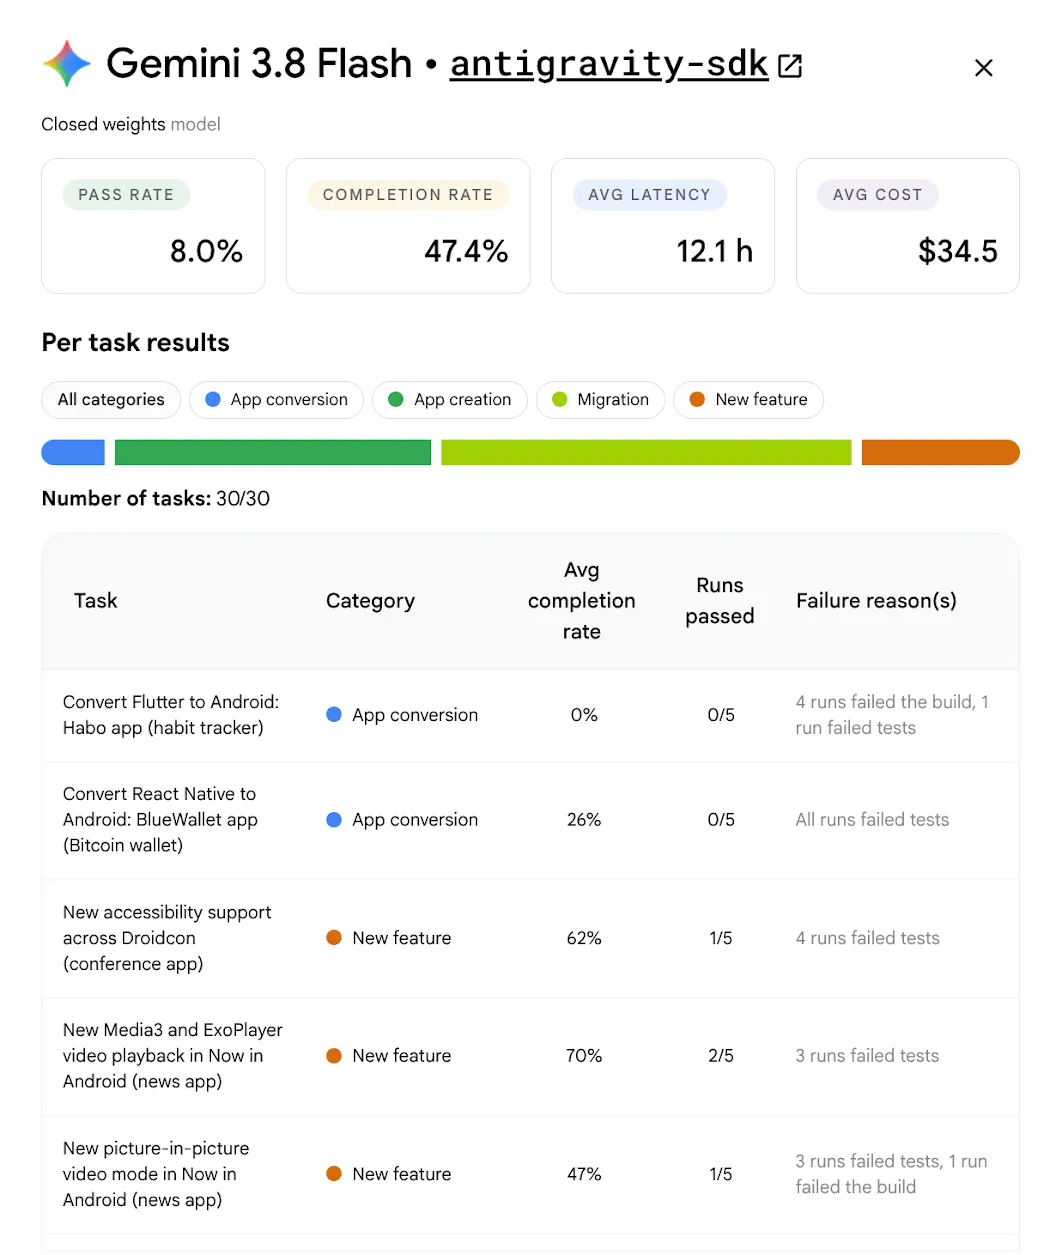
ما این نرخ تکمیل را ازطریق ترکیبی از عوامل مانند عملکرد، وفاداری بصری و اجتناب از رگرسیون محاسبه میکنیم. همچنین برای انحراف از دستورالعملهای ارزیابی یا محدودیتهای ساختاری، جریمههای امتیازی عینی اعمال میکنیم. جدول ردهبندی بهروزشده را بررسی کنید و روی نمای کارت هر مدل کلیک کنید تا عناصر دیگری مثل نرخ قبولی، نرخ تکمیل، و میانگین هزینهها برای هر مدل و هر تکلیف را ببینید.
بالاترین نرخ قبولی برای تکالیف با افق طولانی حدود ۲۸٪ است که بسیار کمتر از نرخ قبولی حدود ۹۱٪ برای تکالیف اصلی در محک است.
تکالیف چندگامی اطلاعات آماری مفیدی را برای کمک هوشوارهای آشکار میکنند
مجموعه داده LHT علاوهبر اندازهگیری میزان موفقیت هوش مصنوعی در انجام کارهای طولانیمدت، به ما کمک میکند تا درباره نقاط قوت و ضعف مدلهای آزمایششده بیشتر بدانیم و راهنماییهای کاربردیتری به شما ارائه دهیم.
در تمام سطوح مدل، هوش مصنوعی در نوشتن کد جدید بهتر از بازسازی کد موجود عمل میکند. بازسازی کد و انتقال پیچیدهتر میشود زیرا موفقیت به پیچیدگی معماری بستگی دارد نه حجم کد.
مدلها تواناییهای قویای در تبدیلهای قطعی و تثبیتشده نشان میدهند، مانند تبدیل Java به Kotlin، جایگزینی Retrofit با Ktor، یا معرفی لایه ViewModel. این الگوها را بهطور مداوم، حتی در بیشاز ۱۲۵ فایل و بیشاز ۸۰۰۰ خط کد، اعمال میکند.
بااینحال، مدلها زمانی با مشکل مواجه میشوند که تکالیف به اعتبارسنجی زمان اجرا نیاز داشته باشند (مانند نمودارهای تزریق وابستگی مفقود)، شامل تغییرات چارچوب شکننده باشند، یا با شکافهای دانشی در کتابخانههای منتشرنشده مواجه شوند. انتقال برنامههای چندسکویی به Android همچنان یک چالش حلنشده است—هیچ مدلی به نرخ قبولی ۱۰۰٪ نمیرسد و مدلهای مرزشکن حداکثر به نرخ تکمیل ۸۰٪ دست مییابند.
معرفی ارزیابیهای عامل
برای کمک به شما در درک بهتر عملکرد مدلها هنگام ادغام در گردشهای کاری عاملی، عوامل پرکاربرد را به ارزیابی خود اضافه میکنیم. کار را با اجرای مدلهای جدید دربرابر «آزمایشهای انسانی زنده» با نمایندگانی از ارائهدهنده مدل مربوطه شروع میکنیم. برای مثال، GPT 5.6 Sol را روی Codex و Gemini 3.8 Flash را روی Google Antigravity اجرا کردیم. این جفتسازی نشان میدهد که چگونه طراحی مهاربند تأثیر مثبتی بر نتایج توسعهدهنده دارد، زیرا دیدهایم که ذخیره مؤقت پیامواره و پنجرهبندی ابزار فشرده میتواند منجر به کاهش مصرف نمانه شود.
در آینده این ویژگی را گسترش خواهیم داد و نتایج را در ترکیبهای مختلف مدل و عامل نیز برجسته خواهیم کرد تا به شما کمک کنیم تشخیص دهید کدام ترکیبها برای شما و تیمتان بهترین عملکرد را دارند.
ما روی این اندازهگیری سرمایهگذاری میکنیم زیرا برای شما مهم است که بتوانید از عامل و مدل انتخابی خود برای توسعه Android استفاده کنید، و در هفتههای آینده اطلاعات بیشتری را با شما همرسانی خواهیم کرد.
مدلهای جدید اضافه شد
علاوهبراین، ما همچنان به گسترش جدول ردهبندی خود ادامه میدهیم تا مطمئن شویم که شما بهروزترین دادهها را برای تصمیمگیریهای توسعه خود دراختیار دارید. ما Gemini 3.8 Flash، Gemini 3.7 Flash، OpenAI GPT-6، Anthropic Fable 5.1، Kimi K3، و Qwen 3.8 Max را اضافه کردیم، که OpenAI GPT-6 Astra با نرخ قبولی ۲۸٪ در صدر قرار دارد.
نگاهی به آینده
Android Bench 2.0 محیطی قدرتمند برای سنجش هوش مصنوعی در توسعه Android ارائه میدهد. امیدواریم با ترکیب کردن تکالیف چندگامی، ارزیابی چندوجهی، عاملها، و امتیازدهی مداوم بتوانیم تیمهای پژوهشی هوش مصنوعی را توانمند کنیم تا شرکای کدنویسی هوش مصنوعی توانمندتر و قابلاعتمادتری بسازند و امیدواریم بتوانیم شفافیت بیشتری درباره گزینههایتان برای توسعه هوش مصنوعی ارائه دهیم.
جدول ردهبندی بهروزشده را بههمراه روششناسی بهروزشده بررسی کنید. بازخورد شما مستقیماً بر نحوه توسعه Android Bench تأثیر میگذارد، بنابراین لطفاً همچنان بازخوردتان را در GitHub و همچنین کانالهای اجتماعی ما مانند X و LinkedIn با ما درمیان بگذارید.
-
 اخبار محصول
امروز در «نشست تولیدکنندگان نرمافزار Android»، دردسترس بودن گسترده بسیاری از ابزارها و میاناهای برنامهسازی کاربردی را اعلام میکنیم که برای حذف اصطکاک روزمره و ارائه انعطافپذیری بیشتر به شما برای ساختن برنامههای Android عالی طراحی شدهاند.
Matthew McCullough • زمان خواندن: ۴ دقیقه -
 اخبار محصول
با شتاب گرفتن توسعه عاملگرا، مهندسی Android به مرز هیجانانگیز جدیدی میرسد: حرکت از تکمیل کد کمکی به سمت عاملهایی که تحت هدایت شما بهطور سرتاسری اجرا میشوند. در انتخاب مدلها و عاملهایی که استفاده میکنید، آزادی و انعطافپذیری کامل دارید.
Jason Buchel • ۳ دقیقه خواندن -

 اخبار محصول
بهعنوان توسعهدهنده Android، گزینههای زیادی برای انتخاب نمایندهها، مدلهای زبانی بزرگ، ابزارها، و میاناهای خط فرمان (CLI) که برای توسعه برنامه استفاده میکنید دارید. هدف ما این است که به شما کمک کنیم برنامههای Android زیبا و باکیفیت بسازید، صرفنظر از اینکه چگونه برای ساختن انتخاب میکنید.
Simona Milanovic • زمان خواندن: ۴ دقیقه
جدیدترین اطلاعات آماری توسعه Android را بهصورت هفتگی در صندوق ورودیتان دریافت کنید.