Android Bench 2.0: लंबे समय तक चलने वाले मुश्किल टास्क के साथ, एआई की क्षमताओं को बेहतर बनाना
पढ़ने में लगने वाला समय: 3 मिनट
जब हमने Android Bench को पहली बार लॉन्च किया था, तब हमने एक मज़बूत फ़ाउंडेशन तैयार किया था. इससे यह आकलन किया जा सकता था कि लार्ज लैंग्वेज मॉडल (एलएलएम), Android से जुड़े असल टास्क में डेवलपर की मदद कैसे करते हैं. एआई मॉडल और एजेंट तेज़ी से बेहतर हो रहे हैं. इसलिए, हम अपनी कार्यप्रणाली को अपडेट कर रहे हैं. जैसे, अपने मानदंड फ़्रेमवर्क को Harbor फ़्रेमवर्क के साथ अलाइन करना. आज हम लंबे समय तक चलने वाले टास्क (एलएचटी) का पहला सेट रिलीज़ कर रहे हैं. ये ऐसे मुश्किल टास्क होते हैं जिन्हें पूरा करने में किसी इंजीनियर को कई दिन या एक हफ़्ता भी लग सकता है. हम एजेंटिक इवैलुएशन की सुविधा भी लॉन्च कर रहे हैं. इसकी शुरुआत, मॉडल उपलब्ध कराने वाली कंपनियों के एजेंट से की जाएगी. इस नए बेंचमार्क के साथ, अब हम Android Bench 2.0 पर पहुंच गए हैं. यह एक बड़ा अपग्रेड है. इसे एआई मॉडल और एजेंट की परफ़ॉर्मेंस का आकलन करने के लिए डिज़ाइन किया गया है. इससे यह पता चलता है कि वे बड़े पैमाने पर, अस्पष्ट, और कई चरणों वाली मुश्किल समस्याओं को हल करने में कितने सक्षम हैं. ये ऐसी समस्याएं हैं जिनका सामना आपको हर दिन करना पड़ता है.
इंक्रीमेंटल फ़िक्स से लेकर लंबे समय तक चलने वाले टास्क तक
Android Bench के पहले वर्शन के साथ-साथ, एआई कोडिंग के शुरुआती मानदंड, मौजूदा रिपॉज़िटरी में होने वाले छोटे-छोटे बदलावों पर फ़ोकस करते थे. कई मामलों में, ये बदलाव गड़बड़ियां ठीक करने या छोटी-मोटी सुविधाओं के अनुरोधों तक ही सीमित थे. यह उस समय एआई असिस्टेंस की क्षमताओं और आपके इस्तेमाल करने के तरीके पर निर्भर करता था.
हम आपके डेवलपमेंट वर्कफ़्लो के लिए सबसे सही मॉडल और कोडिंग एजेंट ढूंढने में आपकी मदद करना जारी रखना चाहते हैं. इसलिए, हमने अपने आकलन के स्टैंडर्ड को और बेहतर बनाया है, ताकि आपको एआई से बेहतर नतीजे मिल सकें. Android Bench 2.0 में, एलएचटी के साथ इन चुनौतियों को शामिल किया गया है. इनमें डिपेंडेंसी अपग्रेड करना, नई सुविधाएं जोड़ना, ऐप्लिकेशन को नए सिरे से बनाना या क्रॉस-प्लैटफ़ॉर्म ऐप्लिकेशन को Android पर माइग्रेट करना शामिल है.
मुश्किल टास्क के लिए, ज़्यादा बारीकी से मूल्यांकन और स्कोरिंग की ज़रूरत होती है
इंजीनियरिंग से जुड़े कई दिनों तक चलने वाले टास्क में, बाइनरी पास या फ़ेल ग्रेडिंग से पूरी जानकारी नहीं मिलती.
उदाहरण के लिए, कोई एजेंट 40 स्क्रीन को Jetpack Compose में फिर से फ़ैक्टर कर सकता है, डेटाबेस टेबल सेट अप कर सकता है, और 90% ज़रूरी शर्तें पूरी कर सकता है. हालांकि, वह किसी एक एज-केस दावे को पूरा नहीं कर पाता. बाइनरी स्कोरिंग इस रन को 0% के तौर पर रेट करती है. इससे मॉडल के आर्किटेक्चर की क्षमताओं का पता नहीं चलता. हम लगातार स्कोरिंग की सुविधा उपलब्ध कराने जा रहे हैं, ताकि आपको ज़्यादा काम की जानकारी मिल सके. इससे मॉडल को डेवलप करने और यह समझने में मदद मिलेगी कि एआई आपकी मदद कैसे कर सकता है.
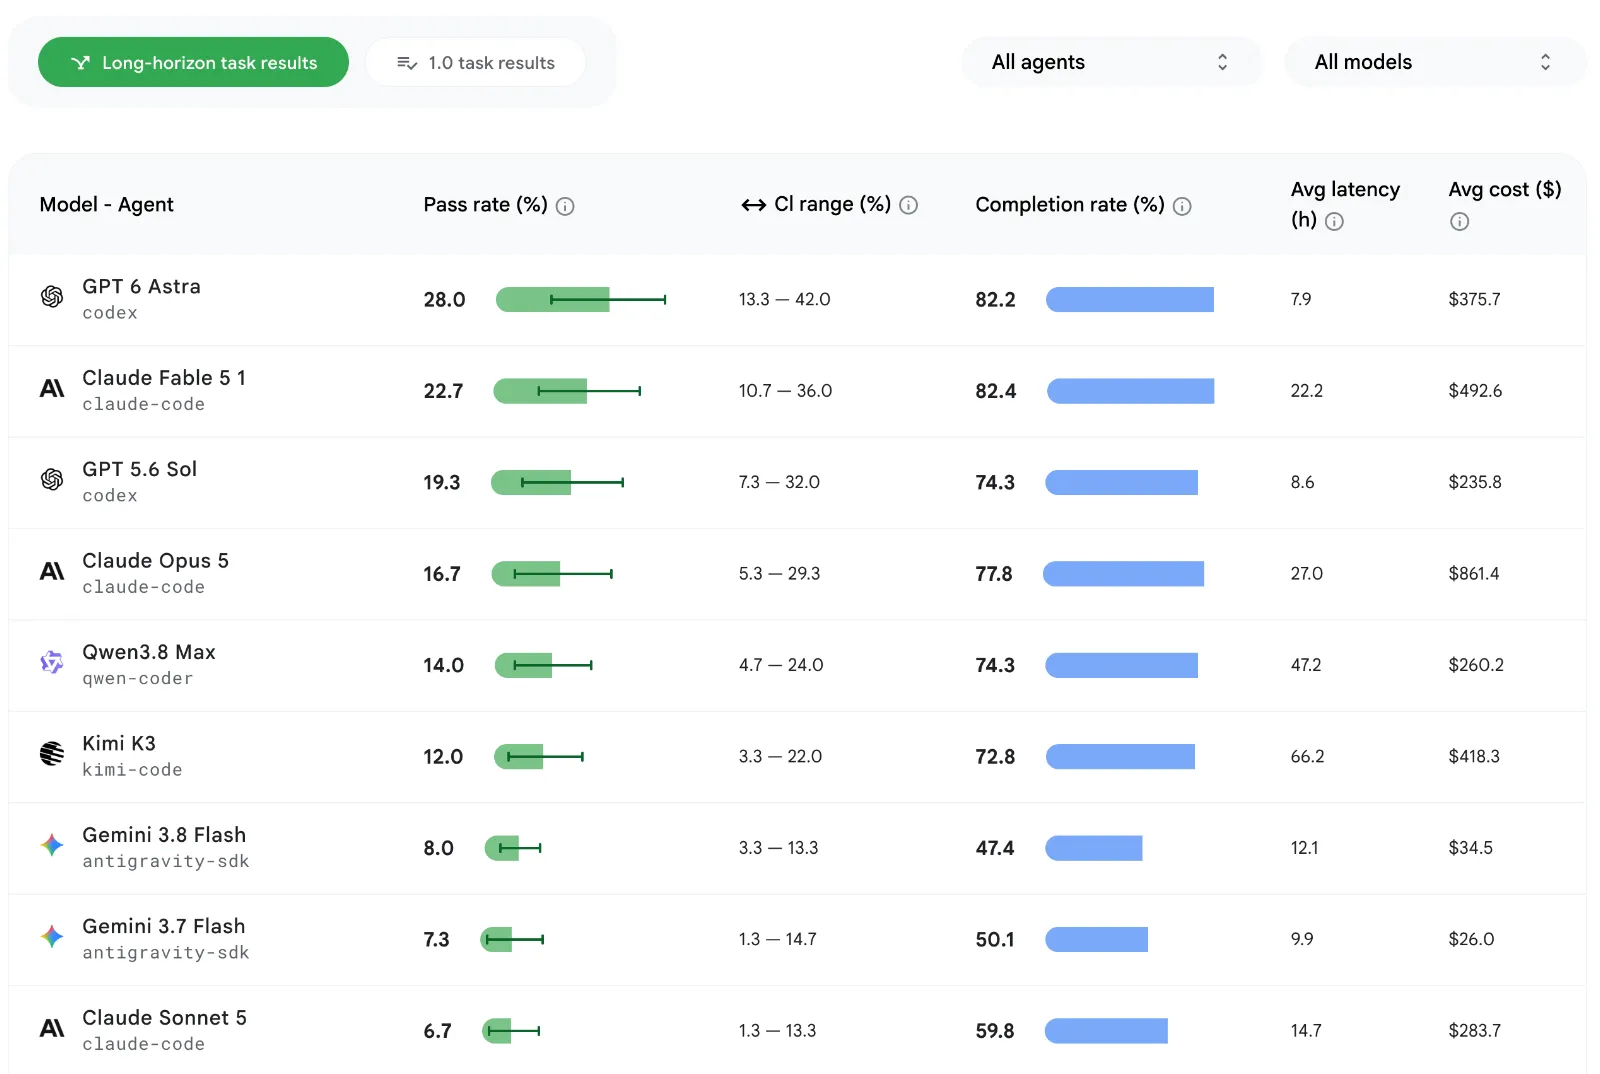
हम इस पूरा होने की दर का हिसाब लगाने के लिए, कई चीज़ों को ध्यान में रखते हैं. जैसे, फ़ंक्शन, विज़ुअल फ़िडेलिटी, और रिग्रेशन से बचना. हम समीक्षा के निर्देशों या स्ट्रक्चर से जुड़ी पाबंदियों का पालन न करने पर, ऑब्जेक्टिव स्कोरिंग पेनल्टी भी लगाते हैं. अपडेट किया गया लीडरबोर्ड देखें और हर मॉडल के कार्ड व्यू पर क्लिक करके, अन्य एलिमेंट देखें. जैसे, पास रेट, पूरा होने की दर, और हर मॉडल और हर टास्क की औसत लागत.
एलएचटी के लिए सबसे ज़्यादा पास रेट करीब 28% है. यह बेंचमार्क में मौजूद ओरिजनल टास्क के लिए करीब 91% से काफ़ी कम है.
लंबे समय तक चलने वाले टास्क से, एआई असिस्टेंट के लिए अहम जानकारी मिलती है
एलएचटी डेटासेट से, हमें यह पता चलता है कि एआई, लंबे समय तक चलने वाले टास्क को कितनी अच्छी तरह मैनेज करता है. इसके अलावा, इससे हमें टेस्ट किए गए मॉडल की खूबियों और कमियों के बारे में ज़्यादा जानने में मदद मिलती है. साथ ही, हम आपको ज़्यादा व्यावहारिक दिशा-निर्देश दे पाते हैं.
मॉडल के सभी टियर में, एआई मौजूदा कोड को रीफ़ैक्टर करने के बजाय, नया कोड लिखने में बेहतर काम करता है. रीफ़ैक्टर और माइग्रेशन करना मुश्किल हो जाता है, क्योंकि सफलता कोड की संख्या के बजाय आर्किटेक्चर की जटिलता पर निर्भर करती है.
मॉडल, पहले से तय और डिटरमिनिस्टिक ट्रांसफ़ॉर्मेशन में बेहतरीन परफ़ॉर्मेंस दिखाते हैं. जैसे, Java को Kotlin में बदलना, Retrofit को Ktor से बदलना या ViewModel लेयर को शामिल करना. ये पैटर्न, 125 से ज़्यादा फ़ाइलों और 8,000 से ज़्यादा लाइनों वाले कोड में भी एक जैसे लागू होते हैं.
हालांकि, मॉडल को तब समस्या आती है, जब टास्क के लिए रनटाइम वैलिडेशन की ज़रूरत होती है. जैसे, डिपेंडेंसी इंजेक्शन ग्राफ़ मौजूद न होना, फ़्रेमवर्क में बदलाव करना या रिलीज़ न की गई लाइब्रेरी के बारे में जानकारी न होना. क्रॉस-प्लैटफ़ॉर्म ऐप्लिकेशन को Android पर पोर्ट करना अब भी एक चुनौती है. कोई भी मॉडल 100% पास रेट हासिल नहीं कर पाता. साथ ही, फ़्रंटियर मॉडल भी ज़्यादा से ज़्यादा 80% पूरा होने की दर तक पहुंचते हैं.
एजेंट की परफ़ॉर्मेंस का आकलन करने की सुविधा के बारे में जानकारी
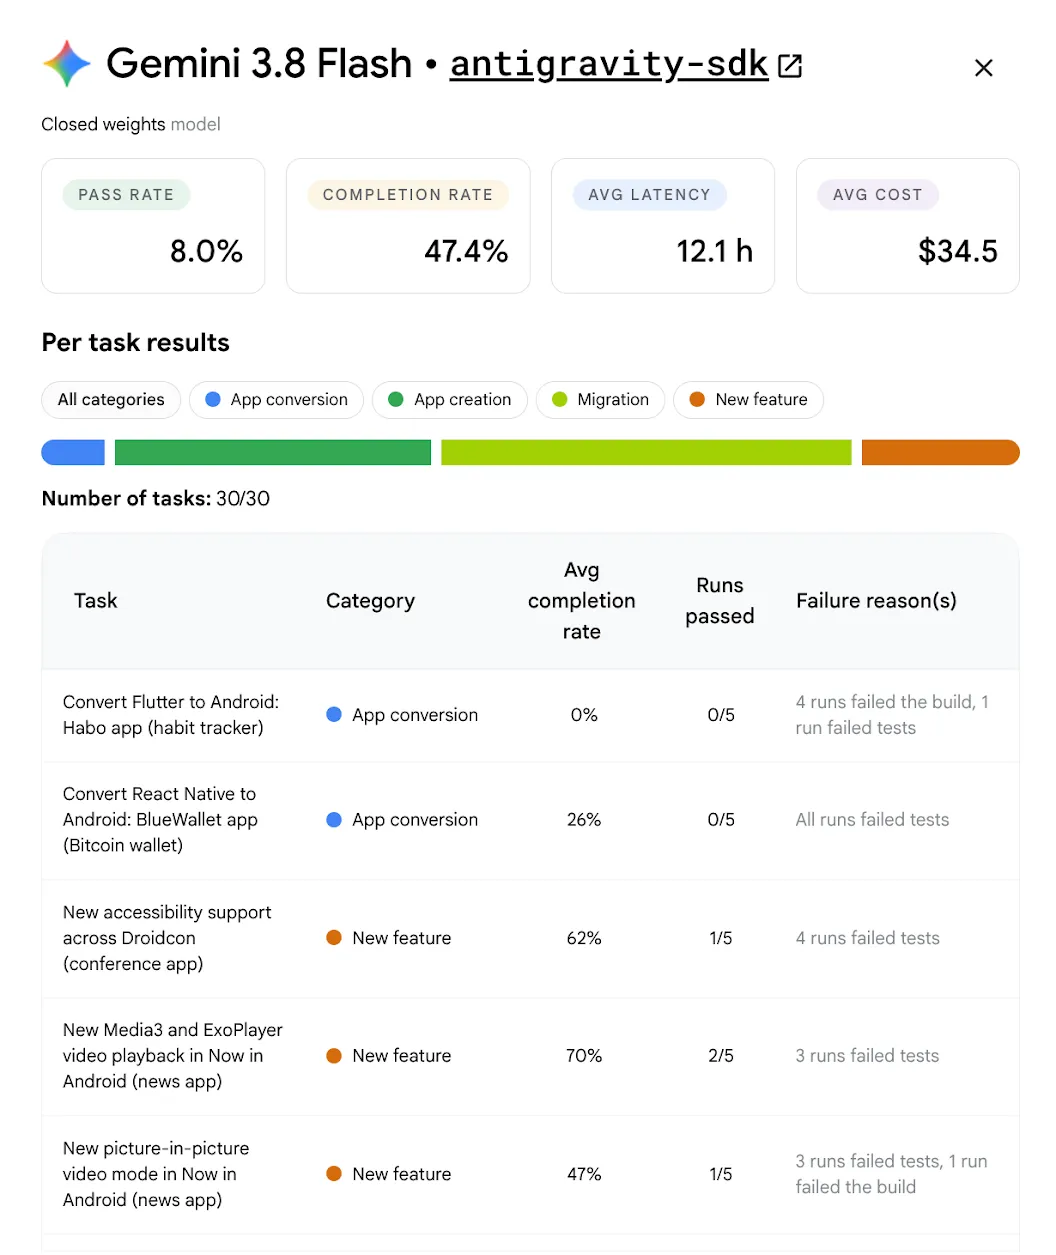
एजेंटिक वर्कफ़्लो में इंटिग्रेट किए जाने पर मॉडल कैसा परफ़ॉर्म करते हैं, यह बेहतर तरीके से समझने में आपकी मदद करने के लिए, हम आम तौर पर इस्तेमाल किए जाने वाले एजेंट को अपने आकलन में शामिल कर रहे हैं. हम एलएचटी के लिए नए मॉडल चलाकर शुरुआत कर रहे हैं. इसके लिए, हम मॉडल उपलब्ध कराने वाली कंपनी के एजेंट की मदद ले रहे हैं. उदाहरण के लिए, हमने Codex पर GPT 5.6 Sol और Google Antigravity पर Gemini 3.8 Flash को चलाया. इस पेयरिंग से पता चलता है कि हार्नेस डिज़ाइन, डेवलपर के नतीजों पर किस तरह से पॉज़िटिव असर डालता है. हमने देखा है कि प्रॉम्प्ट कैश मेमोरी और कॉम्पैक्ट टूल विंडो की मदद से, टोकन की संख्या कम की जा सकती है.
आने वाले समय में, हम इस सुविधा को और बेहतर बनाएंगे. इसके लिए, हम अलग-अलग मॉडल और एजेंट के कॉम्बिनेशन के नतीजे भी हाइलाइट करेंगे. इससे आपको यह जानने में मदद मिलेगी कि आपके और आपकी टीम के लिए कौनसे कॉम्बिनेशन सबसे सही हैं.
हम इस मेज़रमेंट में निवेश करते हैं, क्योंकि आपके लिए यह ज़रूरी है कि आप Android डेवलपमेंट के लिए, अपनी पसंद के एजेंट और मॉडल का इस्तेमाल कर सकें. आने वाले हफ़्तों में, हम आपके साथ और जानकारी शेयर करेंगे.
नए मॉडल जोड़े गए
इसके अलावा, हम लीडरबोर्ड को लगातार बेहतर बना रहे हैं, ताकि आपको अपने ऐप्लिकेशन को डेवलप करने से जुड़े फ़ैसले लेने के लिए, अप-टू-डेट डेटा मिल सके. हमने Gemini 3.8 Flash, Gemini 3.7 Flash, OpenAI का GPT-6, Anthropic का Fable 5.1, Kimi K3, और Qwen 3.8 Max जोड़ा. इनमें OpenAI का GPT-6 Astra, 28% पास रेट के साथ सबसे ऊपर रहा.
आगे की योजनाएं
Android Bench 2.0, Android डेवलपमेंट के लिए एआई की क्षमता को मापने के लिए एक बेहतर प्लैटफ़ॉर्म उपलब्ध कराता है. लंबे समय तक चलने वाले टास्क, मल्टीमोडल इवैलुएशन, एजेंट, और लगातार स्कोरिंग को जोड़कर, हम एआई रिसर्च टीमों को ज़्यादा सक्षम और भरोसेमंद एआई कोडिंग पार्टनर बनाने में मदद करना चाहते हैं. साथ ही, हम आपको एआई डेवलपमेंट के विकल्पों के बारे में ज़्यादा पारदर्शिता देना चाहते हैं.
अपडेट किया गया लीडरबोर्ड और अपडेट किया गया तरीका देखें. आपके सुझाव, शिकायत या राय से हमें Android Bench को बेहतर बनाने में मदद मिलती है. इसलिए, कृपया GitHub के साथ-साथ X और LinkedIn जैसे हमारे सोशल चैनलों पर अपने सुझाव, शिकायत या राय शेयर करते रहें.
-
 प्रॉडक्ट से जुड़ी खबरें
आज Android डेवलपर समिट में, हम कई टूल और एपीआई की उपलब्धता का एलान कर रहे हैं. इन्हें रोज़मर्रा की समस्याओं को दूर करने और आपको बेहतरीन Android ऐप्लिकेशन बनाने के लिए ज़्यादा सुविधाएं देने के लिए डिज़ाइन किया गया है.
Matthew McCullough • पढ़ने में लगने वाला समय: 4 मिनट -
 प्रॉडक्ट से जुड़ी खबरें
एजेंटिक डेवलपमेंट में तेज़ी आने के साथ-साथ, Android इंजीनियरिंग एक रोमांचक नए दौर में पहुंच रही है. इसमें, कोड पूरा करने में मदद करने वाले टूल से लेकर, आपके निर्देश पर एंड-टू-एंड काम करने वाले एजेंट तक शामिल हैं. आपके पास यह चुनने का पूरा विकल्प है कि आपको कौनसे मॉडल और एजेंट इस्तेमाल करने हैं.
Jason Buchel • तीन मिनट में पढ़ा जा सकता है -

 प्रॉडक्ट से जुड़ी खबरें
Android डेवलपर के तौर पर, आपके पास ऐप्लिकेशन डेवलपमेंट के लिए इस्तेमाल किए जाने वाले एजेंट, एलएलएम, टूल, और कमांड-लाइन इंटरफ़ेस (सीएलआई) के कई विकल्प होते हैं. हमारा मकसद, अच्छी क्वालिटी वाले शानदार Android ऐप्लिकेशन बनाने में आपकी मदद करना है. इससे कोई फ़र्क़ नहीं पड़ता कि आपने ऐप्लिकेशन बनाने के लिए कौनसा तरीका चुना है.
Simona Milanovic • पढ़ने में लगने वाला समय: 4 मिनट
Android डेवलपमेंट से जुड़ी ताज़ा अहम जानकारी, हर हफ़्ते अपने इनबॉक्स में पाएं.