Android Runtime (ART) টিম কম্পাইল করা কোড বা কোনও পিক মেমরি রিগ্রেশন ছাড়াই কম্পাইল করার সময় ১৮% কমিয়েছে। এই উন্নতি আমাদের ২০২৫-এর উদ্যোগের অংশ ছিল, যার লক্ষ্য ছিল মেমরির ব্যবহার বা কম্পাইল করা কোডের কোয়ালিটি বজায় রেখে কম্পাইল করার সময় উন্নত করা।
ART-এর জন্য কম্পাইল-টাইম স্পিড অপ্টিমাইজ করা অত্যন্ত গুরুত্বপূর্ণ। যেমন, জাস্ট-ইন-টাইম (JIT) কম্পাইল করার সময় এটি সরাসরি অ্যাপ্লিকেশনের দক্ষতা এবং সামগ্রিক ডিভাইসের পারফর্ম্যান্সকে প্রভাবিত করে। দ্রুত কম্পাইলেশন অপ্টিমাইজেশন শুরু হওয়ার আগে সময় কমায়, যার ফলে ব্যবহারকারীর অভিজ্ঞতা আরও মসৃণ ও রেসপন্সিভ হয়। এছাড়াও, JIT এবং সময়ের আগে (AOT) দুটির ক্ষেত্রেই, কম্পাইল-টাইম স্পিড উন্নত করার অর্থ হল কম্পাইলেশন প্রসেসের সময় রিসোর্স কম খরচ হওয়া, যার ফলে ব্যাটারির আয়ু এবং ডিভাইসের থার্মাল উন্নত হয়, বিশেষ করে কম দামের ডিভাইসে।
কম্পাইল-টাইম স্পিড সংক্রান্ত এইসব উন্নতির কিছু জুন ২০২৫-এর Android রিলিজে লঞ্চ করা হয়েছে এবং বাকিগুলি বছরের শেষে Android রিলিজে উপলভ্য হবে। এছাড়াও, Android 12 ও তার পরবর্তী ভার্সন ব্যবহারকারী সব ব্যক্তি মেনলাইন আপডেট-এর মাধ্যমে এইসব উন্নতি পাবেন।
অপ্টিমাইজিং কম্পাইলার অপ্টিমাইজ করা হচ্ছে
কম্পাইলার অপ্টিমাইজ করা সবসময়ই একটি ট্রেড-অফ গেম। আপনি শুধু ফ্রিতে স্পিড পাবেন না; আপনাকে কিছু ছাড়তে হবে। আমরা নিজেদের জন্য একটি খুব স্পষ্ট এবং চ্যালেঞ্জিং লক্ষ্য সেট করেছি: কম্পাইলারকে আরও দ্রুত করুন, তবে মেমরি রিগ্রেশন প্রবর্তন না করে এবং সবচেয়ে গুরুত্বপূর্ণভাবে, এটি যে কোড তৈরি করে তার কোয়ালিটি না কমিয়ে এটি করুন। কম্পাইলার দ্রুত কাজ করলেও অ্যাপ যদি ধীরে চলে, তাহলে আমরা ব্যর্থ হয়েছি।
আমরা একটি রিসোর্স খরচ করতে ইচ্ছুক ছিলাম, সেটি হল আমাদের নিজস্ব ডেভেলপমেন্টের সময়, যাতে আমরা গভীরভাবে অনুসন্ধান, তদন্ত করতে পারি এবং এই কঠোর মানদণ্ড পূরণ করে এমন চতুর সমাধান খুঁজে পেতে পারি। উন্নতি করার জায়গা খুঁজে বের করার জন্য আমরা কীভাবে কাজ করি এবং বিভিন্ন সমস্যার সঠিক সমাধান খুঁজে বের করার ব্যাপারে আরও ভালোভাবে জেনে নেওয়া যাক।
সম্ভাব্য অপ্টিমাইজেশন খুঁজে দেখা
কোনও মেট্রিক অপ্টিমাইজ করা শুরু করার আগে, আপনাকে সেটি পরিমাপ করতে পারতে হবে। অন্যথায়, আপনি এটি উন্নত করেছেন কিনা তা কখনই নিশ্চিত হতে পারবেন না। আমাদের জন্য সৌভাগ্যবশত, কম্পাইল টাইম স্পিড মোটামুটি সামঞ্জস্যপূর্ণ থাকে, যতক্ষণ না আপনি কিছু সতর্কতা অবলম্বন করেন, যেমন পরিবর্তনের আগে এবং পরে পরিমাপ করার জন্য একই ডিভাইস ব্যবহার করা এবং আপনার ডিভাইস যাতে থার্মাল থ্রটল না করে তা নিশ্চিত করা। এছাড়াও, আমাদের কাছে কম্পাইলার পরিসংখ্যানের মতো নির্ধারক পরিমাপ রয়েছে যা আমাদের বুঝতে সাহায্য করে যে ব্যাকগ্রাউন্ডে কী চলছে।
এইসব উন্নতির জন্য আমরা যে রিসোর্সটি ত্যাগ করছিলাম তা হল আমাদের ডেভেলপমেন্টের সময়, আমরা যত দ্রুত সম্ভব ইটারেট করতে চেয়েছিলাম। এর অর্থ হল, আমরা প্রোটোটাইপ সমাধানের জন্য কিছু প্রতিনিধিত্বমূলক অ্যাপ (ফার্স্ট-পার্টি অ্যাপ, থার্ড-পার্টি অ্যাপ এবং Android অপারেটিং সিস্টেমের মিশ্রণ) বেছে নিয়েছি। পরে, আমরা ম্যানুয়াল এবং অটোমেটেড টেস্টিংয়ের মাধ্যমে যাচাই করেছি যে চূড়ান্ত ইমপ্লিমেন্টেশনটি কার্যকর ছিল।
হাতে বেছে নেওয়া APK-র সেই সেট দিয়ে আমরা লোকালি ম্যানুয়াল কম্পাইল ট্রিগার করব, কম্পাইলেশনের প্রোফাইল পাব এবং কোথায় সময় ব্যয় হচ্ছে তা ভিজ্যুয়ালাইজ করতে pprof ব্যবহার করব।
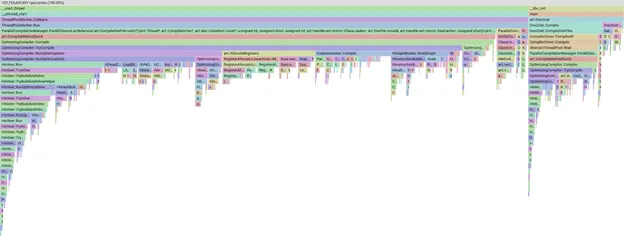
pprof-এ প্রোফাইলের ফ্লেম গ্রাফের উদাহরণ
pprof টুলটি খুবই শক্তিশালী এবং এটি আমাদের ডেটা স্লাইস, ফিল্টার এবং সাজানোর অনুমতি দেয়, উদাহরণস্বরূপ, কোন কম্পাইলার ফেজ বা পদ্ধতিগুলি সবচেয়ে বেশি সময় নিচ্ছে। আমরা pprof সম্পর্কে বিস্তারিত আলোচনা করব না; শুধু জেনে রাখুন যে বারটি বড় হলে এর অর্থ হল কম্পাইলেশনে আরও বেশি সময় লেগেছে।
এইসব ভিউয়ের মধ্যে একটি হল "নিচ থেকে উপরে" ভিউ, যেখানে আপনি দেখতে পাবেন কোন পদ্ধতিগুলি সবচেয়ে বেশি সময় নিচ্ছে। নিচের ছবিতে আমরা Kill নামের একটি মেথড দেখতে পাচ্ছি, যা কম্পাইল টাইমের ১%-এর বেশি সময় নেয়। অন্যান্য কিছু সেরা পদ্ধতিও পরে ব্লগ পোস্টে আলোচনা করা হবে।
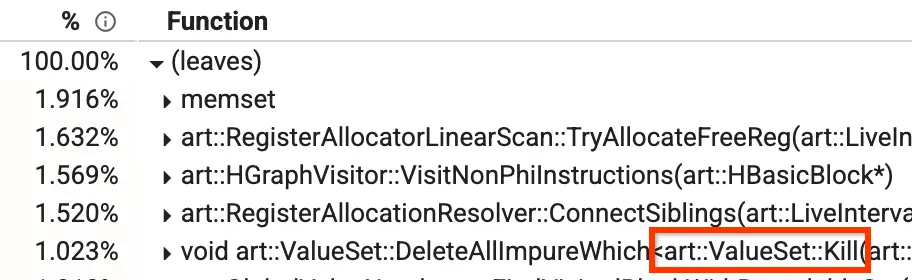
প্রোফাইলের বটম-আপ ভিউ
আমাদের অপ্টিমাইজ করা কম্পাইলারে, গ্লোবাল ভ্যালু নাম্বারিং (GVN) নামে একটি ফেজ আছে। এটি সামগ্রিকভাবে কী করে তা নিয়ে আপনাকে চিন্তা করতে হবে না, তবে প্রাসঙ্গিক অংশটি হল এটি জানা যে এতে `Kill` নামে একটি মেথড আছে যা ফিল্টার অনুযায়ী কিছু নোড মুছে দেবে। এতে অনেক সময় লাগে কারণ এটি সব নোড এক এক করে চেক করে। আমরা লক্ষ্য করেছি যে কিছু ক্ষেত্রে আমরা আগে থেকেই জানি যে চেকটি ভুল হবে, সেই মুহূর্তে আমাদের কাছে যতগুলি নোডই থাকুক না কেন। এইসব ক্ষেত্রে, আমরা একসাথে ইটারেশন এড়িয়ে যেতে পারি, এটি ১.০২৩% থেকে কমিয়ে ~০.৩% করতে পারি এবং GVN-এর রানটাইম ~১৫% উন্নত করতে পারি।
উপযুক্ত অপ্টিমাইজেশন প্রয়োগ করা
আমরা কভার করেছি কীভাবে পরিমাপ করতে হয় এবং কীভাবে শনাক্ত করতে হয় যে কোথায় সময় ব্যয় হচ্ছে, তবে এটি কেবল শুরু। পরবর্তী ধাপ হল কম্পাইল করার জন্য ব্যয় করা সময় কীভাবে অপ্টিমাইজ করা যায়।
সাধারণত, উপরে উল্লেখ করা `Kill` সংক্রান্ত উদাহরণের মতো ক্ষেত্রে, আমরা কীভাবে নোডের মাধ্যমে ইটারেট করি তা দেখব এবং আরও দ্রুত করব, যেমন, সমান্তরালভাবে কাজ করা বা অ্যালগরিদম উন্নত করা। আসলে, আমরা প্রথমে সেটাই করার চেষ্টা করেছিলাম এবং যখন কিছুই করার মতো খুঁজে পাইনি, তখন আমরা "এক মিনিট অপেক্ষা করুন..." বলে থেমে গিয়েছিলাম এবং দেখেছিলাম যে সমাধানটি ছিল (কিছু ক্ষেত্রে) একেবারেই পুনরাবৃত্তি না করা! এই ধরনের অপ্টিমাইজেশন করার সময়, মূল লক্ষ্য থেকে সরে যাওয়া খুব সহজ।
অন্যান্য ক্ষেত্রে, আমরা বেশ কিছু আলাদা কৌশল ব্যবহার করেছি, যার মধ্যে রয়েছে:
- কোনও অপ্টিমাইজেশন উপযুক্ত ফলাফল দেখাতে পারবে কিনা তা নির্ধারণ করতে হিউরিস্টিক ব্যবহার করা এবং তাই এটি এড়িয়ে যাওয়া যেতে পারে
- গণনা করা ডেটা ক্যাশে করতে অতিরিক্ত ডেটা স্ট্রাকচার ব্যবহার করা
- স্পিড বুস্ট পেতে বর্তমান ডেটা স্ট্রাকচার পরিবর্তন করা হচ্ছে
- কিছু ক্ষেত্রে চক্র এড়াতে অলসভাবে ফলাফল গণনা করা হচ্ছে
- সঠিক অ্যাবস্ট্রাকশন ব্যবহার করুন - অপ্রয়োজনীয় ফিচার কোডকে স্লো করে দিতে পারে
- avoid chasing a frequently used pointer through many loads
অপ্টিমাইজেশনগুলি অনুসরণ করার যোগ্য কিনা তা আমরা কীভাবে জানব?
এটাই তো মজার ব্যাপার, আপনাকে কিছু করতে হবে না। কোনও একটি অংশ কম্পাইল করতে অনেক সময় লাগছে বলে শনাক্ত করার পরে এবং সেটি উন্নত করার জন্য ডেভেলপমেন্টের সময় দেওয়ার পরেও, কখনও কখনও আপনি কোনও সমাধান খুঁজে পান না। হতে পারে যে কিছুই করার নেই, এটি প্রয়োগ করতে অনেক সময় লাগবে, এটি অন্য মেট্রিককে উল্লেখযোগ্যভাবে রিগ্রেস করবে, কোড বেসের জটিলতা বাড়াবে ইত্যাদি। এই ব্লগ পোস্টে আপনি যে প্রতিটি সফল অপ্টিমাইজেশন দেখতে পাচ্ছেন, তার জন্য জেনে রাখুন যে আরও অসংখ্য অপ্টিমাইজেশন আছে যা ফলপ্রসূ হয়নি।
আপনিও যদি একই পরিস্থিতিতে থাকেন, তাহলে যতটা সম্ভব কম কাজ করে মেট্রিক কতটা উন্নত করতে পারবেন তা অনুমান করার চেষ্টা করুন। এর অর্থ হল, এই ক্রমে:
- আপনার আগে থেকে সংগ্রহ করা মেট্রিক্সের সাহায্যে অনুমান করা, অথবা শুধু অনুমান করা
- দ্রুত ও রাফ প্রোটোটাইপ দিয়ে অনুমান করা
- সমাধান প্রয়োগ করুন।
আপনার সমাধানের ত্রুটিগুলি অনুমান করার কথা বিবেচনা করতে ভুলবেন না। যেমন, আপনি যদি অতিরিক্ত ডেটা স্ট্রাকচারের উপর নির্ভর করতে চান, তাহলে আপনি কতটা মেমরি ব্যবহার করতে ইচ্ছুক?
আরও গভীরে গিয়ে জানা
আর দেরি না করে, আমরা যেসব পরিবর্তন করেছি তার মধ্যে কয়েকটি দেখে নেওয়া যাক।
FindReferenceInfoOf নামক একটি পদ্ধতি অপ্টিমাইজ করার জন্য আমরা পরিবর্তন করেছি। এই পদ্ধতিটি কোনও এন্ট্রি খুঁজে পেতে ভেক্টরের লিনিয়ার সার্চ করছিল। আমরা সেই ডেটা স্ট্রাকচার আপডেট করেছি যাতে নির্দেশের আইডি অনুযায়ী ইন্ডেক্স করা যায়, যাতে FindReferenceInfoOf, O(n)-এর পরিবর্তে O(1) হয়। এছাড়াও, ছোট বড় করা এড়াতে আমরা ভেক্টরটি আগে থেকেই বরাদ্দ করেছি। আমরা মেমরি সামান্য বাড়িয়েছি কারণ আমাদের একটি অতিরিক্ত ফিল্ড যোগ করতে হয়েছে যা ভেক্টরে আমরা কতগুলি এন্ট্রি যোগ করেছি তা গণনা করে, তবে এটি একটি ছোট ত্যাগ ছিল কারণ পিক মেমরি বাড়েনি। এটি আমাদের LoadStoreAnalysis ফেজকে ৩৪-৬৬% দ্রুত করেছে, যার ফলে কম্পাইল করার সময় ~০.৫-১.৮% উন্নত হয়েছে।
আমাদের HashSet-এর একটি কাস্টম ইমপ্লিমেন্টেশন আছে যা আমরা বিভিন্ন জায়গায় ব্যবহার করি। এই ডেটা স্ট্রাকচার তৈরি করতে অনেক সময় লাগছিল এবং আমরা তার কারণ খুঁজে পেয়েছি। অনেক বছর আগে, এই ডেটা স্ট্রাকচার শুধুমাত্র কয়েকটি জায়গায় ব্যবহার করা হত যেখানে খুব বড় HashSet ব্যবহার করা হত এবং সেটির জন্য অপ্টিমাইজ করার জন্য এটি টুইক করা হয়েছিল। তবে, আজকাল এটি বিপরীত দিকে ব্যবহার করা হয়, যেখানে মাত্র কয়েকটি এন্ট্রি থাকে এবং এর আয়ুষ্কালও কম হয়। এর অর্থ হল, এই বিশাল HashSet তৈরি করে আমরা সাইকেল নষ্ট করছিলাম, কিন্তু এটি বাতিল করার আগে আমরা শুধুমাত্র কয়েকটি এন্ট্রির জন্য এটি ব্যবহার করেছি। এই পরিবর্তন করার ফলে, আমরা কম্পাইল করার সময় ~১.৩-২% উন্নত করেছি। অতিরিক্ত সুবিধা হিসেবে, মেমরির ব্যবহার ~০.৫-১% কমে গেছে কারণ আমরা আগের মতো বড় ডেটা স্ট্রাকচার ব্যবহার করছিলাম না।
আমরা কম্পাইল করার সময় ~০.৫-১% উন্নত করেছি, এর জন্য ল্যাম্বডাতে রেফারেন্সের মাধ্যমে ডেটা স্ট্রাকচার পাস করা হয়েছে যাতে সেগুলি কপি করতে না হয়। এটি এমন একটি বিষয় যা আসল রিভিউতে মিস হয়ে গিয়েছিল এবং আমাদের কোডবেসে বছরের পর বছর ধরে ছিল। pprof-এ প্রোফাইলগুলি দেখার জন্য ধন্যবাদ যে আমরা লক্ষ্য করেছি যে এই পদ্ধতিগুলি প্রচুর ডেটা স্ট্রাকচার তৈরি এবং ধ্বংস করছে, যা আমাদের সেগুলি তদন্ত এবং অপ্টিমাইজ করতে পরিচালিত করেছে।
আমরা গণনা করা ভ্যালু ক্যাশে করার মাধ্যমে কম্পাইল করা আউটপুট লেখার ফেজটি দ্রুত করেছি, যার ফলে মোট কম্পাইল করার সময় ~১.৩-২.৮% উন্নত হয়েছে। দুঃখের বিষয় হল, অতিরিক্ত বুককিপিংয়ের পরিমাণ অনেক বেশি ছিল এবং আমাদের অটোমেটিক টেস্টিং মেমরি রিগ্রেশন সম্পর্কে আমাদের সতর্ক করেছে। পরে, আমরা একই কোড আবার পর্যালোচনা করে একটি নতুন ভার্সন প্রয়োগ করেছি যা মেমরি রিগ্রেশন সংক্রান্ত সমস্যার সমাধান করার পাশাপাশি কম্পাইল করার সময় আরও ~০.৫-১.৮% কমিয়েছে! এই দ্বিতীয় পরিবর্তনের ক্ষেত্রে, দুটি ডেটা স্ট্রাকচারের মধ্যে একটি থেকে মুক্তি পেতে, এই ফেজ কীভাবে কাজ করবে তা আমাদের রিফ্যাক্টর ও নতুন রূপ দিতে হয়েছে।
আমাদের অপ্টিমাইজ করা কম্পাইলারে একটি ফেজ আছে যা আরও ভালো পারফর্ম্যান্সের জন্য ফাংশন কল ইনলাইন করে। কোন পদ্ধতি ইনলাইন করতে হবে তা বেছে নিতে, আমরা কোনও গণনা করার আগে হিউরিস্টিক এবং কাজ করার পরে কিন্তু ইনলাইনিং চূড়ান্ত করার ঠিক আগে চূড়ান্ত চেক, এই দুটিই ব্যবহার করি। এর মধ্যে কোনওটি যদি শনাক্ত করে যে ইনলাইনিং করা ঠিক নয় (যেমন, অনেক নতুন নির্দেশ যোগ করা হবে), তাহলে আমরা মেথড কল ইনলাইন করি না।
আমরা "চূড়ান্ত চেক" বিভাগ থেকে "হিউরিস্টিক" বিভাগে দুটি চেক সরিয়ে দিয়েছি যাতে কোনও সময়সাপেক্ষ গণনা করার আগে ইনলাইনিং সফল হবে কিনা তা অনুমান করা যায়। এটি একটি অনুমান, তাই এটি নিখুঁত নয়, তবে আমরা যাচাই করেছি যে আমাদের নতুন হিউরিস্টিক পারফর্ম্যান্সকে প্রভাবিত না করেই আগে ইনলাইন করা কোডের ৯৯.৯% কভার করে। এইসব নতুন হিউরিস্টিকের মধ্যে একটি ছিল প্রয়োজনীয় DEX রেজিস্টার (~০.২-১.৩% উন্নতি) এবং অন্যটি ছিল নির্দেশের সংখ্যা (~২% উন্নতি)।
আমাদের কাছে BitVector-এর একটি কাস্টম ইমপ্লিমেন্টেশন আছে যা আমরা বিভিন্ন জায়গায় ব্যবহার করি। আমরা নির্দিষ্ট কিছু ফিক্সড-সাইজ বিট ভেক্টরের জন্য ছোট-বড় করা যায় এমন BitVector ক্লাসকে আরও সহজ BitVectorView দিয়ে পরিবর্তন করেছি। এটি কিছু ইনডিরেকশন ও রান-টাইম রেঞ্জ চেক বাদ দেয় এবং বিট ভেক্টর অবজেক্টের কনস্ট্রাকশন দ্রুত করে।
এছাড়াও, BitVectorView ক্লাসটি অন্তর্নিহিত স্টোরেজ টাইপে টেমপ্লেটাইজ করা হয়েছিল (পুরানো BitVector-এর মতো সবসময় uint32_t ব্যবহার করার পরিবর্তে)। এটি কিছু অপারেশনকে, যেমন Union(), ৬৪-বিট প্ল্যাটফর্মে একসাথে দ্বিগুণ বিট প্রসেস করার অনুমতি দেয়। Android OS কম্পাইল করার সময় প্রভাবিত ফাংশনের স্যাম্পেল মোট ১%-এর বেশি কমে গেছে। এটি একাধিক পরিবর্তনের মাধ্যমে করা হয়েছে [1, 2, 3, 4, 5, 6]
আমরা যদি সমস্ত অপ্টিমাইজেশন সম্পর্কে বিস্তারিতভাবে কথা বলি তবে আমরা সারাদিন এখানে থাকব! আপনি যদি আরও কিছু অপ্টিমাইজেশন করতে চান, তাহলে আমাদের করা অন্যান্য কিছু পরিবর্তন দেখুন:
- কম্পাইলেশন সময় ~০.৬-১.৬% উন্নত করতে বুককিপিং যোগ করুন।
- সম্ভব হলে, সাইকেল এড়াতে লেজিলি কম্পিউট ডেটা।
- প্রি-কম্পিউটিং কাজ ব্যবহার করা না হলে তা এড়িয়ে যেতে আমাদের কোড রিফ্যাক্টর করুন।
- অন্যান্য জায়গা থেকে অ্যালোকেটর সহজেই পাওয়া গেলে, কিছু নির্ভরশীল লোড চেইন এড়িয়ে চলুন।
- অপ্রয়োজনীয় কাজ এড়ানোর জন্য চেক যোগ করার আরেকটি উদাহরণ।
- রেজিস্টার অ্যালোকেটরে রেজিস্টার টাইপে (কোর/FP) ঘন ঘন ব্রাঞ্চিং এড়িয়ে চলুন।
- কম্পাইল করার সময় কিছু অ্যারে ইনিশিয়ালাইজ করা হয়েছে কিনা তা নিশ্চিত করুন। এটি করার জন্য clang-এর উপর নির্ভর করবেন না।
- কিছু লুপ ক্লিন-আপ করুন। রেঞ্জ লুপ ব্যবহার করুন যা ক্ল্যাং আরও ভালভাবে অপ্টিমাইজ করতে পারে কারণ লুপের সাইড এফেক্টের কারণে কন্টেনারের ইন্টার্নাল পয়েন্টার রিলোড করার প্রয়োজন হয় না। প্রতিটি ইনপুটের জন্য ইনলাইনড `InputAt(.)`-এর মাধ্যমে লুপে ভার্চুয়াল ফাংশন `HInstruction::GetInputRecords()` কল করা এড়িয়ে চলুন।
- কম্পাইলার অপ্টিমাইজেশন ব্যবহার করে ভিজিটর প্যাটার্নের জন্য Accept() ফাংশন এড়িয়ে চলুন।
সিদ্ধান্ত
ART-এর কম্পাইল-টাইম স্পিড উন্নত করার জন্য আমাদের প্রচেষ্টা উল্লেখযোগ্য উন্নতি করেছে, যা Android-কে আরও মসৃণ এবং দক্ষ করে তুলেছে এবং একই সাথে ব্যাটারির আয়ু এবং ডিভাইসের থার্মাল উন্নত করতে অবদান রেখেছে। সতর্কতার সাথে অপ্টিমাইজেশন শনাক্ত ও প্রয়োগ করে আমরা দেখিয়েছি যে মেমরির ব্যবহার বা কোডের কোয়ালিটির সাথে আপোষ না করেই কম্পাইল-টাইম উল্লেখযোগ্যভাবে কমানো সম্ভব।
আমাদের এই যাত্রায় pprof-এর মতো টুল ব্যবহার করে প্রোফাইলিং করা, বারবার চেষ্টা করার ইচ্ছা এবং কখনও কখনও কম ফলপ্রসূ পথ পরিত্যাগ করার মতো বিষয়গুলি অন্তর্ভুক্ত ছিল। ART টিমের সম্মিলিত প্রচেষ্টার ফলে কম্পাইল করার সময় উল্লেখযোগ্য শতাংশে কমেছে এবং ভবিষ্যতের উন্নতির জন্য ভিত্তিপ্রস্তর স্থাপন করা হয়েছে।
এইসব উন্নতি ২০২৫-এর শেষে Android আপডেটে এবং Android 12 ও তার পরবর্তী ভার্সনের জন্য মেনলাইন আপডেটের মাধ্যমে উপলভ্য। আমরা আশা করি যে আমাদের অপ্টিমাইজেশন প্রসেসের এই ডিপ ডাইভ কম্পাইলার ইঞ্জিনিয়ারিংয়ের জটিলতা এবং পুরস্কার সম্পর্কে মূল্যবান ইনসাইট প্রদান করবে!
-
 প্রোডাক্ট সংক্রান্ত খবর
ইন্ডাস্ট্রি লিডার, আঞ্চলিক পার্টনার, অ্যাপ ডিস্ট্রিবিউটর এবং Android কমিউনিটির সাথে এক বছরেরও বেশি সময় ধরে যৌথ প্রস্তুতির পর, ৩০ সেপ্টেম্বর থেকে ব্রাজিল, ইন্দোনেশিয়া, সিঙ্গাপুর এবং থাইল্যান্ড জুড়ে অংশগ্রহণকারী স্টোরগুলির জন্য আমাদের ব্যবহারকারী সুরক্ষা সফলভাবে লাইভ হয়েছে।
Matthew Forsythe • পড়তে ২ মিনিট লাগবে -
 প্রোডাক্ট সংক্রান্ত খবর
প্লেয়ারদের এই অভিজ্ঞতা দিতে এবং আপনার গেম যাতে সব স্ক্রিন সাইজে ভালভাবে চলে তা নিশ্চিত করতে, Google Play গেমের জন্য নতুন বড় স্ক্রিন কোয়ালিটি সংক্রান্ত প্রয়োজনীয়তা চালু করছে
Aurash Mahbod • ৪ মিনিট লাগবে পড়তে -
 প্রোডাক্ট সংক্রান্ত খবর
Jetpack Compose-এর নভেম্বর ‘২৬ রিলিজ স্থিতিশীল! এই রিলিজে মূল Compose মডিউল জুড়ে (সম্পূর্ণ BOM ম্যাপিং দেখুন) ভার্সন 1.13 নিয়ে আসা হয়েছে, যার মাধ্যমে টেক্সট, গ্রাফিক্স, লেআউট, পারফর্ম্যান্স ও আরও অনেক কিছুতে আপডেট করা হয়েছে—এর সাথে কিছু গুরুত্বপূর্ণ ডেপ্রিকেশন ও আচরণগত পরিবর্তন করা হয়েছে যেগুলি সম্পর্কে সচেতন থাকা প্রয়োজন।
Meghan Mehta • পড়তে ১০ মিনিট লাগবে
সরাসরি আপনার ইনবক্সে লেটেস্ট Android ডেভেলপমেন্ট ইনসাইট পান সাপ্তাহিক।