התפתחות באופן המדידה של מודלים גדולים של שפה (LLM) ב-Android: העידן הבא של Android Bench
משך הקריאה: 3 דקות

במרץ השקנו את Android Bench – טבלת ההשוואה של מודלי LLM למשימות פיתוח של Android בעולם האמיתי. המטרה שלנו הייתה לספק שקיפות לגבי יכולות המודלים בפיתוח ל-Android ולעודד שיפורים במודלים, כדי לתת לכם אפשרויות מבוססות-AI שיעזרו לכם בתהליך העבודה היומיומי. מאז, שיפרנו את ההשוואה לשוק על סמך המשוב שלכם, כולל הערכה של מודלים עם משקלים פתוחים והוספה של מאפייני עלות ויעילות לטבלת ההשוואה.
אבל היכולות של ה-AI כל הזמן מתפתחות, וגם המדידה צריכה להתפתח בהתאם. במסגרת הגרסה שפרסמנו ביולי, אימצנו את מסגרת Harbor, שכוללת גרסה מעודכנת של סוכן ההשוואה שמשמש להערכת מודלים.
בנוסף לשינוי הזה בשיטת ההערכה, בגרסה של יולי אנחנו מוסיפים לטבלת ההשוואה 8 מודלים חדשים (Claude Fable 5, Claude Sonnet 5, Claude Opus 4.8, GLM 5.2, Kimi K2.7 Code, MiniMax M3, Qwen 3.7 Plus ו-Qwen 3.7 Max). אנחנו גם משתפים הזדמנויות לקהילת מפתחי Android לתרום למדד ההשוואה.
שדרוג המתודולוגיה באמצעות מסגרת Harbor
כשעיצבנו את Android Bench, ביססנו את המתודולוגיה שלנו על סטנדרטים מובילים בתחום שהיו זמינים באותה תקופה. השתמשנו ב-mini-swe-agent v1, סוכן לשימוש כללי להערכת ביצועים, והתאמנו אותו לניואנסים של פיתוח ל-Android כדי לספק מדידת בסיס ליכולות של מודלים למשימות נפוצות בפיתוח ל-Android.
כדי להמשיך לספק לכם הערכות מתקדמות שמודדות בצורה מדויקת את היכולות של המודלים העדכניים בפיתוח ל-Android, אנחנו מתקננים את מדד ההשוואה שלנו ל-Harbor framework. פרויקט Harbor מגדיר סטנדרטים ואינטגרציות שמאפשרים לכל אחד להריץ את נקודת ההשוואה, להעריך את ההגדרה המועדפת או לשתף תוצאות – וכך מספק שקיפות ונראות נוספות.
השדרוג הזה מאפשר לנו להעריך את המודלים והיכולות שלהם בצורה מדויקת יותר, והרצנו מחדש את הבדיקה בכל המודלים כדי ליצור בסיס מעודכן. המשמעות היא שיהיה שינוי קל בניקוד, אבל עדיין תוכלו לראות את הניקוד ההיסטורי בארכיון באתר שלנו.
אנחנו רוצים לוודא ש-Android Bench מועיל לכם, ולכן נמשיך לעדכן אותו ככל שההערכות שלנו והתחום יתפתחו.
הרחבת טבלת ההשוואה עם 8 מודלים חדשים
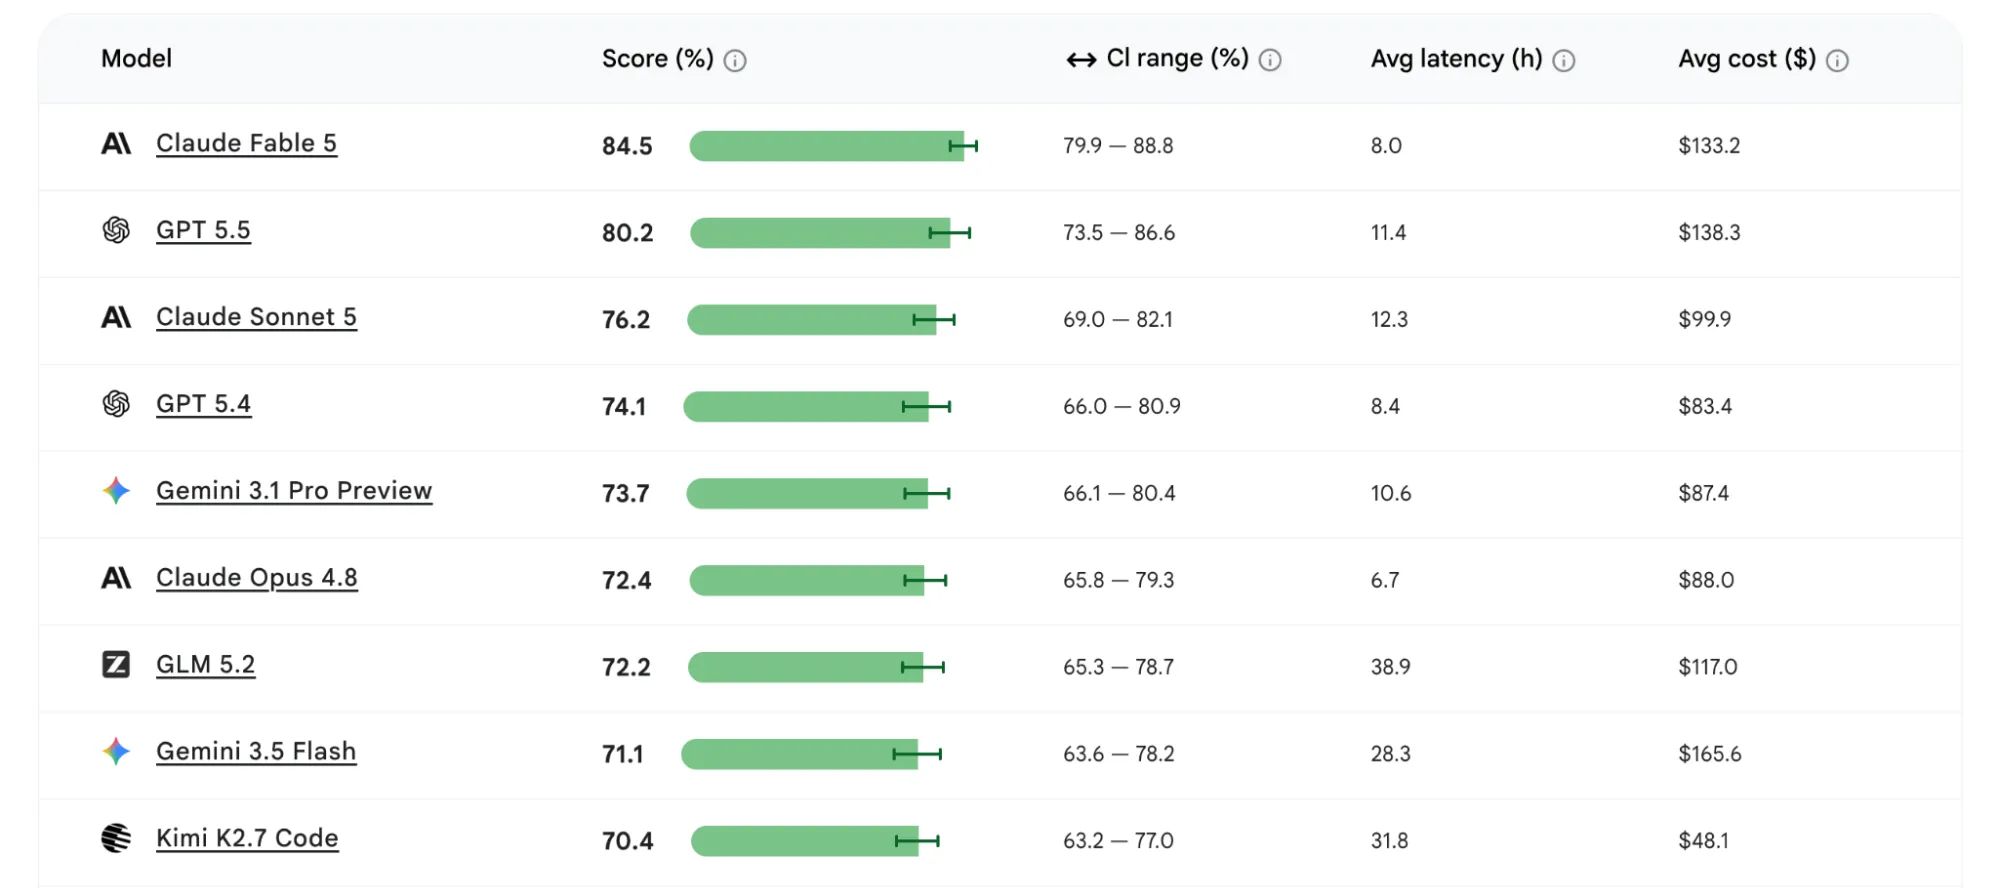
כחלק מהמחויבות שלנו לשמור על עדכניות טבלת ההשוואה, הוספנו את המודלים הבאים לטבלת ההשוואה של Android Bench: Claude Fable 5, Claude Sonnet 5, Claude Opus 4.8, GLM 5.2, Kimi K2.7 Code, MiniMax M3, Qwen 3.7 Plus ו-Qwen 3.7 Max.
אפשר לראות ש-Claude Fable 5 נמצא בראש טבלת ההשוואה עם ציון של 84.5, אחריו GPT 5.5 עם ציון של 80.2, ו-Claude Sonnet 5 במקום השלישי עם ציון של 76.2.
כשמשווים רק מודלים במשקל פתוח, GLM 5.2 נמצא בראש עם 72.2, ואחריו Kimi K2.7 Code עם ציון של 70.4.
כדי לראות איך המודלים החדשים והקודמים מתמודדים עם אתגרים ספציפיים ל-Android, כמו העברות של Jetpack Compose, רשתות של מכשירים לבישים ועדכוני API של הפלטפורמה, אתם יכולים לעיין במדדים של ביצועי המודלים והיעילות שלהם בטבלת ההשוואה המעודכנת.
פתיחת Android Bench לתרומות מהקהילה
מההתחלה, הקפדנו על גישה פתוחה ושקופה, ולכן פרסמנו את המתודולוגיה המקורית ואת מערכת הבדיקה שלנו ב-GitHub. קיבלנו בקשות לספק דרך להעביר משוב על מערך הנתונים שלנו, ועכשיו אנחנו עושים צעד נוסף בשיתוף הפעולה ומאפשרים לכם, קהילת מפתחי Android, לעצב את Android Bench.
החל מהיום, יש שתי דרכים לתרום ל-Android Bench:
- אתם יכולים לתכנן ולשלוח משימות פיתוח משלכם ל-Android כדי להעריך איך המודלים מתמודדים עם התרחישים שחשובים לכם.
- תוכלו להריץ ולשתף הערכות השוואתיות בעצמכם, ולבדוק את המודלים המועדפים שלכם מול מערך הנתונים שלנו או מול משימות מותאמות אישית משלכם.
נבדוק את המשימות שנשלחו ונחליט אם להוסיף אותן למדד ההשוואה. אנחנו מקווים ליצור מדד השוואה שבאמת משקף את המציאות המגוונת של קהילת מפתחי Android העולמית.
מה צפוי בהמשך
ככל שיש יותר ויותר אפשרויות לפיתוח אקטיבי, שמירה על מדד מתקדם מבטיחה שהעזרה מבוססת-AI שאתם מסתמכים עליה תהיה חכמה יותר, מועילה יותר ויעילה יותר. אפשר לעבור אל המאגר שלנו ב-GitHub כדי לעיין במשימות. אתם מוזמנים לשלוח לצוות שלנו משימה לבדיקה, ולעיין בHarbor Hub כדי לבדוק את מערך הנתונים או לשלוח הערכות.
כמו תמיד, אפשר לעיין בטבלת המובילים המעודכנת או לקרוא על המתודולוגיה באתר שלנו.
-
 חדשות על מוצרים
למפתחי Android יש הרבה אפשרויות בכל הנוגע לסוכנים, למודלים גדולים של שפה (LLM), לכלים ולממשקי שורת פקודה (CLI) שבהם הם משתמשים לפיתוח אפליקציות. המטרה שלנו היא לעזור לכם לפתח אפליקציות יפות ואיכותיות ל-Android, לא משנה איך תבחרו לפתח אותן.
Simona Milanovic • משך הקריאה: 4 דקות -
 חדשות על מוצרים
בשנה שעברה, פתחנו את Android Studio לכל מודל AI. היום אנחנו עושים את הצעד הבא ומשיקים תמיכה בסוכני קידוד לפי בחירתכם.
Matthew Warner • משך הקריאה: 3 דקות -
 חדשות על מוצרים
היום אנחנו משיקים את קבוצת המשימות הראשונה לטווח ארוך (LHT), שהן משימות מורכבות מאוד שמהנדס צריך להקדיש להן כמה ימים או אפילו שבוע כדי להשלים אותן. בנוסף, אנחנו משיקים הערכת תפקוד הסוכנים, ומתחילים עם סוכנים מספקי מודלים תואמים.
Matthew McCullough • משך הקריאה: 3 דקות
רוצים לקבל טיפים עדכניים לפיתוח Android ישירות לאימייל כל שבוע?