Android Bench 2.0: توسيع الآفاق من خلال مهام طويلة المدى مليئة بالتحديات
مدّة القراءة: 3 دقائق
عندما أطلقنا Android Bench لأول مرة، وضعنا أساسًا صارمًا لتقييم كيفية مساعدة النماذج اللغوية الكبيرة (LLM) للمطوّرين في مهام Android الواقعية. مع التطوّر السريع لنماذج الذكاء الاصطناعي ووكلائه، نعمل على تعديل منهجيتنا، مثل مواءمة إطار عملنا المرجعي مع إطار عمل Harbor. نطرح اليوم المجموعة الأولى من المهام الطويلة المدى (LHT)، وهي مهام معقّدة للغاية يستغرق المهندس عدة أيام أو حتى أسبوعًا لإكمالها. نقدّم أيضًا تقييمًا مستندًا إلى الوكلاء، بدءًا من الوكلاء من مقدّمي النماذج المعنيين. تأتي هذه الإضافة في إطار Android Bench 2.0، وهو ترقية رئيسية مصمّمة لتقييم نماذج الذكاء الاصطناعي ووكلاءه في مواجهة المشاكل المعقّدة والمتعدّدة الخطوات التي تواجهونها يوميًا.
من الإصلاحات التدريجية إلى المهام الطويلة المدى
ركّز الإصدار الأول من Android Bench، إلى جانب معايير تقييم الترميز المبكرة المماثلة المستندة إلى الذكاء الاصطناعي، على التغييرات المتزايدة في المستودعات الحالية، والتي اقتصرت في كثير من الحالات على إصلاح الأخطاء أو طلبات الميزات الأصغر حجمًا. كان ذلك انعكاسًا لإمكانات المساعد المستند إلى الذكاء الاصطناعي في ذلك الوقت، بالإضافة إلى كيفية استخدامه.
لمواصلة مساعدتك في العثور على النماذج ووكلاء الترميز الأنسب لسير عمل التطوير، رفعنا مستوى تقييماتنا لتتناسب مع العمل الذي تفوّضه إلى الذكاء الاصطناعي. يعكس الإصدار 2.0 من Android Bench هذه التحديات الطموحة من خلال مهام طويلة المدى تشمل ترقية الاعتماديات أو إضافة ميزات جديدة أو إنشاء تطبيقات من الصفر أو تحويل تطبيق من عدّة منصات إلى Android.
تتطلّب المهام المعقّدة تقييمًا ووضع نقاط أكثر دقة
في المهام الهندسية التي تستغرق عدة أيام، لا يعكس التقييم الثنائي (ناجح أو راسب) الصورة الكاملة.
على سبيل المثال، قد يُعيد الوكيل صياغة 40 شاشة في Jetpack Compose، ويُعدّ جداول قاعدة البيانات، ويستوفي% 90 من المتطلبات، ولكنّه يفشل في اختبار حالة استثنائية واحدة. يقيّم نظام التسجيل الثنائي هذه المحاولة بنسبة %0، ما يحجب الإمكانات البنيوية للنموذج. نحن بصدد الانتقال إلى نظام التقييم المستمر لتقديم إشارة أكثر فائدة، سواء لتطوير النماذج أو لفهمك لكيفية مساعدة الذكاء الاصطناعي لك.
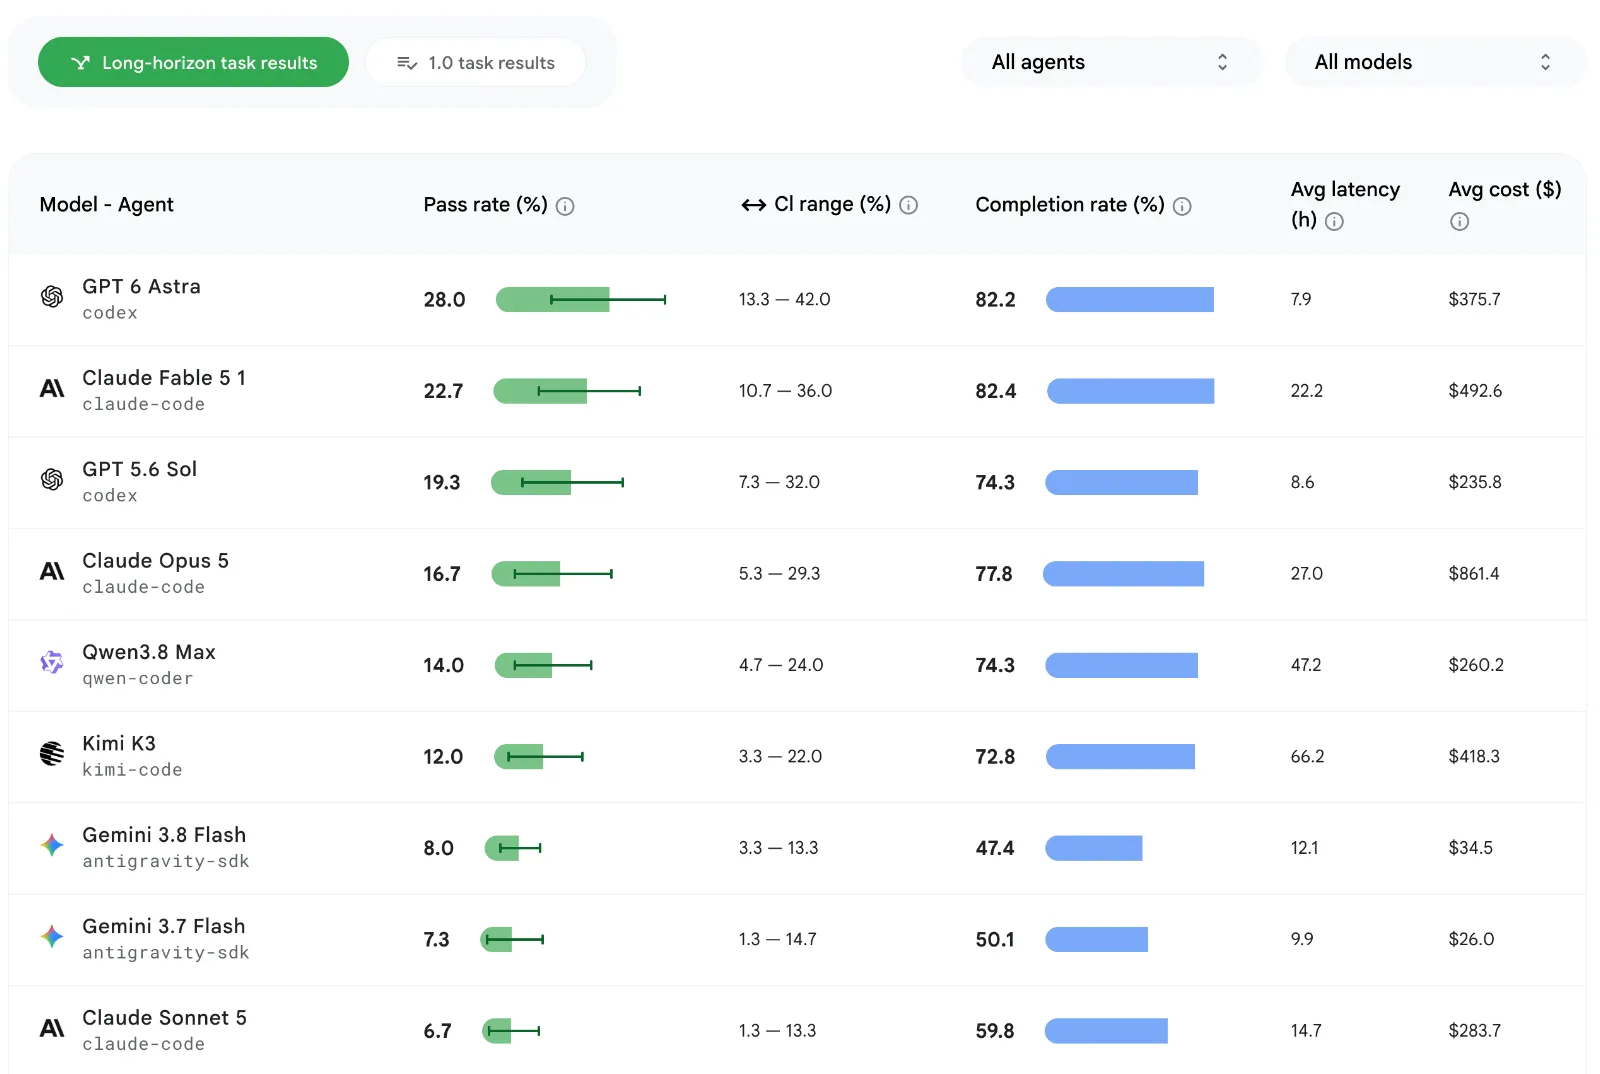
نحتسب معدّل الاكتمال هذا من خلال مجموعة من العوامل، مثل الوظائف والدقة المرئية وتجنُّب التراجعات. ونطبّق أيضًا عقوبات على النقاط الموضوعية في حال عدم الالتزام بتعليمات التقييم أو القيود الهيكلية. اطّلِع على قائمة الصدارة المعدَّلة وانقر على عرض البطاقة لكل نموذج للاطّلاع على عناصر إضافية، مثل معدّل النجاح ومعدّل الإكمال ومتوسط التكاليف لكل نموذج ولكل مهمة.
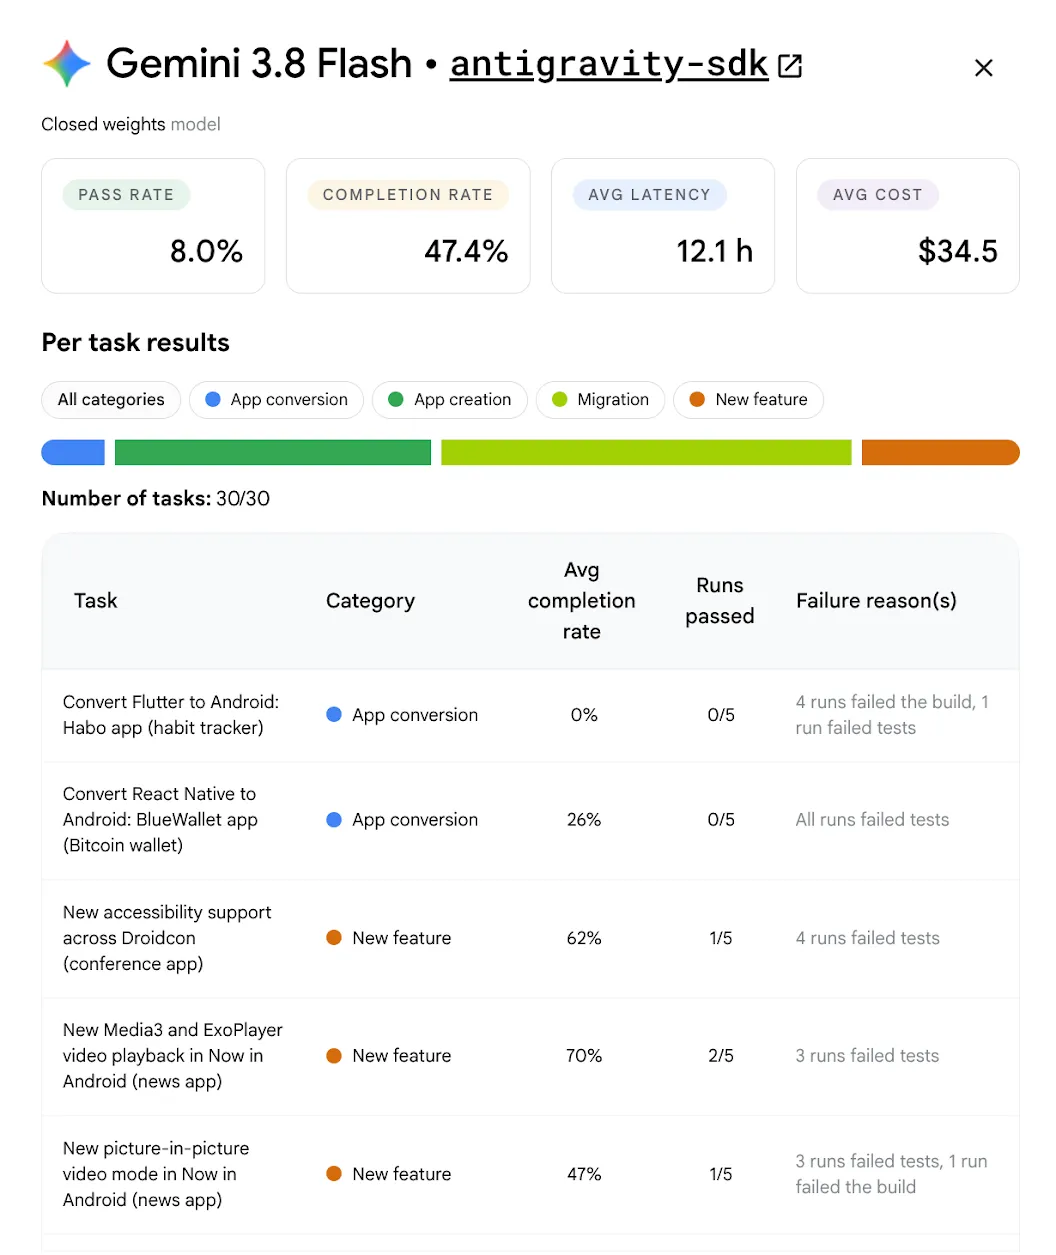
أعلى معدّل نجاح لمهام LHT هو %28 تقريبًا، وهو أقل بكثير من معدّل النجاح الذي يبلغ% 91 تقريبًا للمهام الأصلية في مقياس الأداء.
المهام الطويلة المدى تكشف عن إحصاءات مفيدة للمساعدة المستندة إلى الذكاء الاصطناعي
بالإضافة إلى قياس مدى كفاءة الذكاء الاصطناعي في التعامل مع المهام الطويلة، تساعدنا مجموعة بيانات LHT في معرفة المزيد عن نقاط القوة والضعف في النماذج التي تم اختبارها، ونقدّم لك إرشادات عملية أكثر.
في جميع فئات النماذج، يؤدي الذكاء الاصطناعي أداءً أفضل في كتابة رموز برمجية جديدة مقارنةً بإعادة هيكلة الرموز البرمجية الحالية. تصبح عمليات إعادة التصميم والنقل أكثر صعوبة لأنّ النجاح يعتمد على مدى تعقيد البنية وليس على حجم الرموز البرمجية.
تُظهر النماذج قدرات قوية في عمليات التحويل الراسخة والحتمية، مثل تحويل Java إلى Kotlin، أو استبدال Retrofit بـ Ktor، أو تقديم طبقة ViewModel. ويطبّقون هذه الأنماط باستمرار، حتى على أكثر من 125 ملفًا و8,000 سطر من الرموز البرمجية.
ومع ذلك، تواجه النماذج صعوبة عندما تتطلّب المهام التحقّق من وقت التشغيل (مثل الرسوم البيانية المفقودة لحقن التبعية)، أو تتضمّن تغييرات في إطار العمل تؤدي إلى تعطّله، أو تواجه فجوات في المعرفة مع مكتبات لم يتم إصدارها. لا يزال نقل التطبيقات من عدّة منصات إلى Android يمثّل تحديًا كبيرًا، فلا يوجد نموذج يحقّق معدّل نجاح بنسبة% 100، وتصل النماذج الرائدة إلى معدّل إكمال بنسبة% 80 كحدّ أقصى.
لمحة عن تقييمات الوكلاء
لمساعدتك في فهم أداء النماذج بشكل أفضل عند دمجها في سير العمل المستند إلى الوكلاء، سنضيف الوكلاء الشائعي الاستخدام إلى تقييمنا. سنبدأ بتشغيل نماذج جديدة على LHTs مع وكلاء من مزوّد النموذج المعنيّ. على سبيل المثال، شغّلنا GPT 5.6 Sol على Codex، وGemini 3.8 Flash على Google Antigravity. يوضّح هذا الاقتران كيف يؤثر تصميم بيئة الاختبار بشكل إيجابي في نتائج المطوّرين، حيث رأينا أنّ التخزين المؤقت للطلبات ونافذة الأدوات المدمجة يمكن أن يؤديا إلى تقليل الرموز المميّزة.
سنوسّع نطاق هذه الميزة في المستقبل من خلال إبراز النتائج أيضًا في مختلف النماذج والوكلاء، لمساعدتك في اكتشاف النماذج والوكلاء الأنسب لك ولفريقك.
نحن نستثمر في هذا المقياس لأنّه من المهم أن تتمكّن من استخدام الوكيل والنموذج الذي تختاره لتطوير تطبيقات Android، وسنشارك معك المزيد من المعلومات في الأسابيع المقبلة.
أضفنا نماذج جديدة
بالإضافة إلى ذلك، نواصل توسيع قائمة الصدارة لضمان حصولك على أحدث البيانات لاتخاذ قرارات التطوير. أضفنا Gemini 3.8 Flash وGemini 3.7 Flash وGPT-6 من OpenAI وFable 5.1 من Anthropic وKimi K3 وQwen 3.8 Max، مع تصدُّر GPT-6 Astra من OpenAI للقائمة بمعدّل نجاح% 28.
في المستقبل
يوفّر Android Bench 2.0 بيئة فعّالة لقياس أداء الذكاء الاصطناعي في تطوير تطبيقات Android. من خلال الجمع بين المهام الطويلة المدى والتقييم المتعدّد الوسائط والوكلاء والتقييم المستمر، نأمل أن نتمكّن من تمكين فِرق أبحاث الذكاء الاصطناعي من إنشاء شركاء برمجة أكثر كفاءة وموثوقية مستندين إلى الذكاء الاصطناعي، ونأمل أن نوفّر لك المزيد من الشفافية بشأن خياراتك لتطوير الذكاء الاصطناعي.
يمكنك الاطّلاع على قائمة الصدارة المعدَّلة مع المنهجية المعدَّلة. تؤثر ملاحظاتك بشكل مباشر في طريقة تطويرنا لأداة Android Bench، لذا يُرجى مواصلة مشاركة ملاحظاتك معنا على GitHub، بالإضافة إلى قنواتنا على وسائل التواصل الاجتماعي، مثل X وLinkedIn.
-
 أخبار المنتجات
واليوم، في مؤتمر Android Dev Summit، نعلن عن توفير العديد من الأدوات وواجهات برمجة التطبيقات المصمَّمة لإزالة العقبات اليومية ومنحك المزيد من المرونة لإنشاء تطبيقات Android رائعة.
Matthew McCullough • مدّة القراءة: 4 دقائق -
 أخبار المنتجات
مع تسارع وتيرة تطوير الوكلاء، تصل هندسة Android إلى آفاق جديدة ومثيرة: الانتقال من الإكمال التلقائي للرموز البرمجية إلى الوكلاء الذين ينفّذون المهام من البداية إلى النهاية تحت توجيهك. لديك حرية الاختيار والمرونة الكاملة في النماذج والوكلاء الذين تستخدمهم.
Jason Buchel • مدّة القراءة: 3 دقائق -

 أخبار المنتجات
بصفتك مطوّر برامج Android، لديك العديد من الخيارات عندما يتعلّق الأمر بالوكلاء والنماذج اللغوية الكبيرة والأدوات وواجهات سطر الأوامر (CLI) التي تستخدمها لتطوير التطبيقات. هدفنا هو مساعدتك في إنشاء تطبيقات Android رائعة وعالية الجودة، بغض النظر عن الطريقة التي تختارها لإنشائها.
Simona Milanovic • مدّة القراءة: 4 دقائق
يمكنك الحصول على آخر الإحصاءات حول تطوير تطبيقات Android في بريدك الوارد أسبوعيًا.