Android 17-এ, SDK 37 বা তার পরের যেকোনও ভার্সনকে টার্গেট করা অ্যাপগুলি MessageQueue-এর একটি নতুন প্রয়োগ পাবে যেখানে প্রয়োগটি লক-ফ্রি। নতুন প্রয়োগ পারফর্ম্যান্স উন্নত করে এবং মিস করা ফ্রেমের সংখ্যা কমায়, তবে MessageQueue-এর ব্যক্তিগত ফিল্ড ও পদ্ধতিকে রিফ্লেক্ট করে এমন ক্লায়েন্ট ভেঙে যেতে পারে। ব্যবহারের পরিবর্তন এবং কীভাবে আপনি প্রভাব কমাতে পারবেন সেই সম্পর্কে আরও জানতে, MessageQueue ব্যবহারের পরিবর্তন সংক্রান্ত ডকুমেন্ট দেখুন। এই টেকনিক্যাল ব্লগ পোস্টে MessageQueue রি-আর্কিটেকচার সম্পর্কে একটি ওভারভিউ এবং কীভাবে আপনি Perfetto ব্যবহার করে লক কনটেনশন সংক্রান্ত সমস্যা বিশ্লেষণ করতে পারেন তা প্রদান করা হয়েছে।
Looper প্রতিটি Android অ্যাপ্লিকেশনের UI থ্রেড চালায়। এটি MessageQueue থেকে কাজ নেয়, Handler-এ পাঠায় এবং এই প্রসেসটি আবার করে। দু'দশক ধরে, MessageQueue তার স্টেট সুরক্ষিত রাখতে একটি মনিটর লক (অর্থাৎ, একটি synchronized কোড ব্লক) ব্যবহার করেছে।
Android 17 এই কম্পোনেন্টে একটি গুরুত্বপূর্ণ আপডেট নিয়ে এসেছে: DeliQueue নামের একটি লক-ফ্রি ইমপ্লিমেন্টেশন।
এই পোস্টে ব্যাখ্যা করা হয়েছে যে কীভাবে লক UI পারফর্ম্যান্সকে প্রভাবিত করে, কীভাবে Perfetto-এর মাধ্যমে এইসব সমস্যা বিশ্লেষণ করতে হয় এবং Android-এর মূল থ্রেড উন্নত করতে ব্যবহৃত নির্দিষ্ট অ্যালগরিদম ও অপ্টিমাইজেশন।
সমস্যা: লক কনটেনশন ও প্রায়োরিটি ইনভার্সন
লেগ্যাসি MessageQueue ফাংশনটি একটি লক দ্বারা সুরক্ষিত অগ্রাধিকারের সারি হিসেবে কাজ করত। মূল থ্রেড যখন সারি রক্ষণাবেক্ষণ করে, তখন ব্যাকগ্রাউন্ড থ্রেড কোনও মেসেজ পোস্ট করলে, ব্যাকগ্রাউন্ড থ্রেড মূল থ্রেডকে ব্লক করে দেয়।
একই লক এক্সক্লুসিভভাবে ব্যবহার করার জন্য দুই বা তার বেশি থ্রেড প্রতিযোগিতা করলে, এটিকে লক কনটেনশন বলা হয়। এই বিরোধের কারণে অগ্রাধিকারের ইনভার্সন হতে পারে, যার ফলে UI জ্যাঙ্ক এবং অন্যান্য পারফর্ম্যান্স সংক্রান্ত সমস্যা হতে পারে।
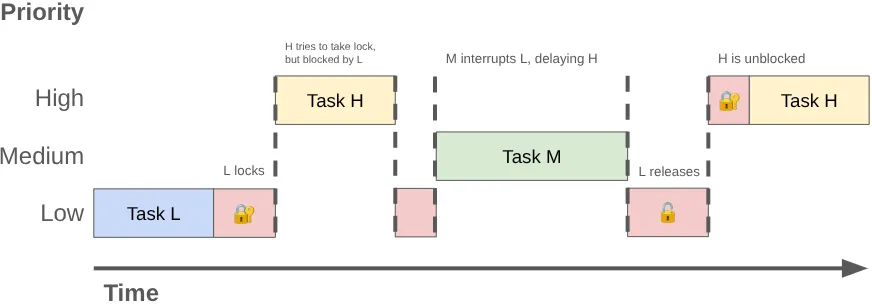
অগ্রাধিকারের ইনভার্সন তখন হতে পারে যখন একটি বেশি অগ্রাধিকার সম্পন্ন থ্রেড (যেমন UI থ্রেড) কম অগ্রাধিকার সম্পন্ন থ্রেডের জন্য অপেক্ষা করে। এই ক্রমটি বিবেচনা করুন:
- একটি নিম্ন অগ্রাধিকার ব্যাকগ্রাউন্ড থ্রেড
MessageQueueলক করে, যাতে এটি নিজের করা কাজের ফলাফল পোস্ট করতে পারে। - একটি মাঝারি অগ্রাধিকার যুক্ত থ্রেড রান করার উপযুক্ত হয়ে যায় এবং কার্নেলের শিডিউলার এটিকে CPU টাইম বরাদ্দ করে, এর ফলে কম অগ্রাধিকার যুক্ত থ্রেডটি প্রিএম্প্ট হয়ে যায়।
- উচ্চ অগ্রাধিকার UI থ্রেড তার বর্তমান টাস্ক সম্পূর্ণ করে এবং সারি থেকে রিড করার চেষ্টা করে, কিন্তু ব্লক হয়ে যায় কারণ নিম্ন অগ্রাধিকার থ্রেড লক হোল্ড করে।
কম অগ্রাধিকারের থ্রেড UI থ্রেডকে ব্লক করে এবং মাঝারি অগ্রাধিকারের কাজ এটিকে আরও বিলম্বিত করে।
Perfetto-এর মাধ্যমে কন্টেনশন বিশ্লেষণ করা
আপনি Perfetto ব্যবহার করে এইসব সমস্যা ডায়াগনসিস করতে পারবেন। স্ট্যান্ডার্ড ট্রেসে, মনিটর লকে ব্লক করা থ্রেড স্লিপিং স্টেটে প্রবেশ করে এবং Perfetto লকের মালিককে নির্দেশ করে এমন একটি স্লাইস দেখায়।
ট্রেস ডেটা কোয়েরি করার সময়, "…-এর সাথে মনিটর কনটেনশন" নামের স্লাইস খুঁজুন, এর পরে সেই থ্রেডের নাম থাকবে যে লকটি হোল্ড করে আছে এবং কোড সাইট থাকবে যেখানে লকটি অ্যাকোয়ার করা হয়েছে।
কেস স্টাডি: লঞ্চার জ্যাঙ্ক
উদাহরণস্বরূপ, আসুন একটি ট্রেস বিশ্লেষণ করি যেখানে কোনও ব্যবহারকারী ক্যামেরা অ্যাপে ছবি তোলার সাথে সাথেই Pixel ফোনে হোম নেভিগেট করার সময় জ্যাঙ্ক অনুভব করেছেন। নিচে আমরা Perfetto-এর একটি স্ক্রিনশট দেখতে পাচ্ছি যা মিস করা ফ্রেমের আগে পর্যন্ত ইভেন্টগুলি দেখাচ্ছে:
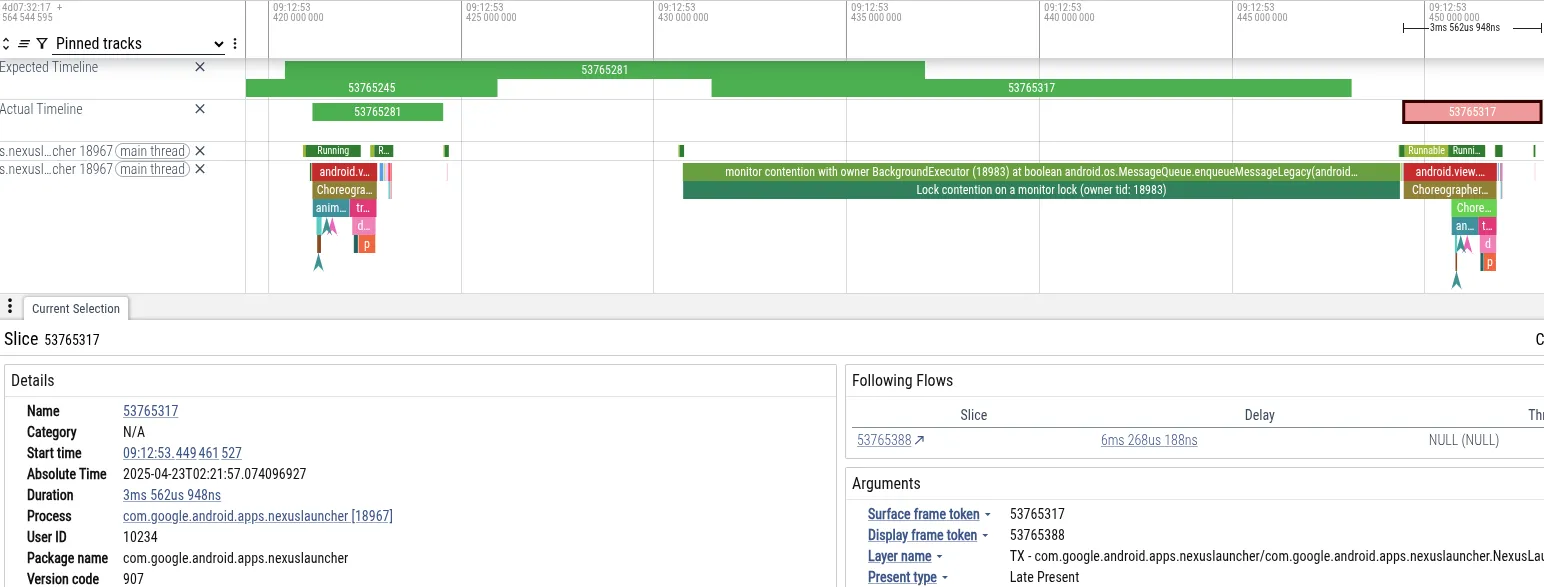
- সমস্যা: লঞ্চারের মূল থ্রেড ফ্রেমের সময়সীমা মিস করেছে। এটি ১৮ms-এর জন্য ব্লক করা হয়েছে, যা 60Hz রেন্ডারিংয়ের জন্য প্রয়োজনীয় ১৬ms সময়সীমার থেকে বেশি।
- রোগ নির্ণয়: Perfetto
MessageQueueলকে ব্লক করা মূল থ্রেড দেখিয়েছে। “BackgroundExecutor” থ্রেড লকটি হোল্ড করে রেখেছিল। - মূল কারণ: BackgroundExecutor Process.THREAD_PRIORITY_BACKGROUND (খুব কম অগ্রাধিকার) লেভেলে চলে। এটি একটি অ-জরুরি টাস্ক (অ্যাপ ব্যবহারের সময়সীমা চেক করা) পারফর্ম করেছে। একই সাথে, মাঝারি অগ্রাধিকারের থ্রেডগুলি ক্যামেরা থেকে ডেটা প্রসেস করার জন্য CPU টাইম ব্যবহার করছিল। ক্যামেরা থ্রেড চালানোর জন্য OS শিডিউলার BackgroundExecutor থ্রেডকে প্রিএম্পট করেছে।
এই সিকোয়েন্সের কারণে লঞ্চারের UI থ্রেড (উচ্চ অগ্রাধিকার) পরোক্ষভাবে ক্যামেরা ওয়ার্কার থ্রেড (মধ্যম অগ্রাধিকার) দ্বারা ব্লক হয়ে যায়, যা লঞ্চারের ব্যাকগ্রাউন্ড থ্রেডকে (নিম্ন অগ্রাধিকার) লক রিলিজ করতে বাধা দেয়।
PerfettoSQL-এর মাধ্যমে ট্রেস কোয়েরি করা
নির্দিষ্ট প্যাটার্নের জন্য ট্রেস ডেটা কোয়েরি করতে PerfettoSQL ব্যবহার করতে পারেন। ব্যবহারকারীর ডিভাইস বা টেস্ট থেকে পাওয়া ট্রেসের একটি বড় ব্যাঙ্ক থাকলে এবং আপনি কোনও সমস্যা ডেমোনস্ট্রেট করে এমন নির্দিষ্ট ট্রেস খুঁজলে এটি কাজে লাগে।
যেমন, এই কোয়েরি MessageQueue ড্রপ করা ফ্রেমের (জ্যাঙ্ক) সাথে মিলে যাওয়া কনটেনশন খুঁজে পায়:
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.frames.jank_type;

SELECT
  process_name,
  -- Convert duration from nanoseconds to milliseconds
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM android_monitor_contention
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"

-- Only look at app processes that had jank
AND upid IN (
  SELECT DISTINCT(upid)
  FROM actual_frame_timeline_slice
  WHERE android_is_app_jank_type(jank_type) = TRUE
)
GROUP BY process_name
ORDER BY SUM(dur) DESC;
এই আরও জটিল উদাহরণে, অ্যাপ চালু হওয়ার সময় MessageQueue প্রতিযোগিতা শনাক্ত করতে একাধিক টেবিল জুড়ে থাকা জয়েন ট্রেস ডেটা ব্যবহার করুন:
INCLUDE PERFETTO MODULE android.monitor_contention;
INCLUDE PERFETTO MODULE android.startup.startups;

-- Join package and process information for startups
DROP VIEW IF EXISTS startups;
CREATE VIEW startups AS
SELECT startup_id, ts, dur, upid
FROM android_startups
JOIN android_startup_processes USING(startup_id);

-- Intersect monitor contention with startups in the same process.
DROP TABLE IF EXISTS monitor_contention_during_startup;
CREATE VIRTUAL TABLE monitor_contention_during_startup
USING SPAN_JOIN(android_monitor_contention PARTITIONED upid, startups PARTITIONED upid);

SELECT
  process_name,
  SUM(dur) / 1000000 AS sum_dur_ms,
  COUNT(*) AS count_contention
FROM monitor_contention_during_startup
WHERE is_blocked_thread_main
AND short_blocked_method LIKE "%MessageQueue%"
GROUP BY process_name
ORDER BY SUM(dur) DESC;
অন্যান্য প্যাটার্ন খুঁজে পেতে PerfettoSQL কোয়েরি লেখার জন্য আপনি নিজের পছন্দের LLM ব্যবহার করতে পারেন।
Google-এ, আমরা লক্ষ লক্ষ ট্রেস জুড়ে PerfettoSQL কোয়েরি চালানোর জন্য BigTrace ব্যবহার করি। এটি করার মাধ্যমে, আমরা নিশ্চিত করেছি যে আমরা যা দেখেছিলাম তা আসলে একটি সিস্টেম সংক্রান্ত সমস্যা। ডেটা থেকে জানা গেছে যে MessageQueue লক কনটেনশন সমগ্র ইকোসিস্টেম জুড়ে ব্যবহারকারীদের প্রভাবিত করে, যা মৌলিক স্থাপত্যগত পরিবর্তনের প্রয়োজনীয়তাকে প্রমাণ করে।
সমাধান: লক-ফ্রি কনকারেন্সি
শেয়ার করা স্টেটে অ্যাক্সেস সিঙ্ক্রোনাইজ করার জন্য এক্সক্লুসিভ লকের পরিবর্তে অ্যাটমিক মেমরি অপারেশন ব্যবহার করে আমরা লক-ফ্রি ডেটা স্ট্রাকচার প্রয়োগ করে MessageQueue বিরোধ সংক্রান্ত সমস্যার সমাধান করেছি। অন্যান্য থ্রেডের শিডিউলিং আচরণ নির্বিশেষে, অন্তত একটি থ্রেড যদি সবসময় প্রগ্রেস করতে পারে, তাহলে ডেটা স্ট্রাকচার বা অ্যালগরিদম লক-ফ্রি হয়। এই প্রপার্টি সাধারণত অর্জন করা কঠিন এবং বেশিরভাগ কোডের ক্ষেত্রে এটি অর্জন করার চেষ্টা করা উচিত নয়।
অ্যাটমিক প্রিমিটিভ
লক-ফ্রি সফ্টওয়্যার প্রায়শই হার্ডওয়্যার দ্বারা প্রদত্ত অ্যাটমিক রিড-মডিফাই-রাইট প্রিমিটিভের উপর নির্ভর করে।
পুরনো জেনারেশনের ARM64 CPU-তে, অ্যাটমিক একটি Load-Link/Store-Conditional (LL/SC) লুপ ব্যবহার করে। CPU একটি ভ্যালু লোড করে এবং অ্যাড্রেস চিহ্নিত করে। অন্য কোনও থ্রেড সেই অ্যাড্রেসে লিখলে, স্টোরটি ব্যর্থ হয় এবং লুপ আবার চেষ্টা করে। যেহেতু থ্রেডগুলি অন্য থ্রেডের জন্য অপেক্ষা না করেই চেষ্টা চালিয়ে যেতে এবং সফল হতে পারে, তাই এই অপারেশনটি লক-ফ্রি।
ARM64 LL/SC loop example
retry:
    ldxr    x0, [x1]        // Load exclusive from address x1 to x0
    add     x0, x0, #1      // Increment value by 1
    stxr    w2, x0, [x1]    // Store exclusive.
                            // w2 gets 0 on success, 1 on failure
cbnz w2, retry // If w2 is non-zero (failed), branch to retrনতুন ARM আর্কিটেকচার (ARMv8.1) লার্জ সিস্টেম এক্সটেনশন (LSE) সাপোর্ট করে, যার মধ্যে Compare-And-Swap (CAS) বা Load-And-Add (নিচে দেখানো হয়েছে) ফর্মের নির্দেশাবলী অন্তর্ভুক্ত। Android 17-এ, LSE কাজ করে কিনা তা শনাক্ত করতে এবং অপ্টিমাইজ করা নির্দেশাবলী নির্গত করতে আমরা Android Runtime (ART) কম্পাইলারের জন্য সহায়তা যোগ করেছি:
/ ARMv8.1 LSE atomic example
ldadd   x0, x1, [x2]    // Atomic load-add.
                        // Faster, no loop required.
আমাদের বেঞ্চমার্কে, CAS ব্যবহার করে এমন হাই-কন্টেনশন কোড LL/SC ভ্যারিয়েন্টের তুলনায় ~৩ গুণ বেশি স্পিড-আপ অর্জন করে।
Java প্রোগ্রামিং ল্যাঙ্গুয়েজ java.util.concurrent.atomic এর মাধ্যমে অ্যাটমিক প্রিমিটিভ অফার করে যা এগুলি ও অন্যান্য বিশেষ CPU নির্দেশাবলীর উপর নির্ভর করে।
ডেটা স্ট্রাকচার: DeliQueue
MessageQueue থেকে লক কনটেনশন সরানোর জন্য, আমাদের ইঞ্জিনিয়াররা DeliQueue নামে একটি নতুন ডেটা স্ট্রাকচার ডিজাইন করেছেন। DeliQueue Message ইনসার্শনকে Message প্রসেসিং থেকে আলাদা করে:
Messages(Treiber stack)-এর তালিকা: লক-ফ্রি স্ট্যাক। যেকোনও থ্রেড এখানে কোনও বিরোধ ছাড়াই নতুনMessagesপুশ করতে পারে।- অগ্রাধিকারের সারি (মিনিট-হিপ):
Messages-এর একটি হিপ যা হ্যান্ডেল করতে হয় এবং এটি লুপার থ্রেডের এক্সক্লুসিভ মালিকানাধীন (তাই অ্যাক্সেস করার জন্য কোনও সিঙ্ক্রোনাইজেশন বা লক করার প্রয়োজন নেই)।
এনকিউ: Treiber স্ট্যাকে পুশ করা
Messages-এর তালিকা Treiber স্ট্যাক [১]-এ রাখা হয়, এটি একটি লক-ফ্রি স্ট্যাক যা হেড পয়েন্টার আপডেট করার জন্য CAS লুপ ব্যবহার করে।
public class TreiberStack <E> {
    AtomicReference<Node<E>> top =
            new AtomicReference<Node<E>>();
    public void push(E item) {
        Node<E> newHead = new Node<E>(item);
        Node<E> oldHead;
        do {
            oldHead = top.get();
            newHead.next = oldHead;
        } while (!top.compareAndSet(oldHead, newHead));
    }

    public E pop() {
        Node<E> oldHead;
        Node<E> newHead;
        do {
            oldHead = top.get();
            if (oldHead == null) return null;
            newHead = oldHead.next;
        } while (!top.compareAndSet(oldHead, newHead));
        return oldHead.item;
    }
}
Java Concurrency in Practice [2]-এর উপর ভিত্তি করে সোর্স কোড, অনলাইনে উপলভ্য এবং সর্বজনীন ডোমেনে রিলিজ করা হয়েছে
যেকোনও প্রযোজক যেকোনও সময় স্ট্যাকে নতুন Message পুশ করতে পারেন। এটি অনেকটা ডেলি কাউন্টারে টিকিট কাটার মতো - আপনি কখন এসেছেন তার উপর নির্ভর করে আপনার নম্বর নির্ধারণ করা হয়, তবে আপনি যে ক্রমে খাবার পাবেন তা মিলতে হবে না। এটি একটি লিঙ্ক করা স্ট্যাক হওয়ার কারণে, প্রতিটি Message হল একটি সাব-স্ট্যাক - আপনি হেড ট্র্যাক করে এবং ফরওয়ার্ড ইটারেট করে যেকোনও সময়ে Message কিউ কেমন ছিল তা দেখতে পাবেন - উপরে কোনও নতুন Message পুশ করা হবে না, এমনকি আপনার ট্রাভার্স করার সময় সেগুলি যোগ করা হলেও।
ডিকিউ: মিনি-হিপে বাল্ক ট্রান্সফার করা
হ্যান্ডেল করার জন্য পরবর্তী Message খুঁজতে, Looper প্রসেসটি Treiber স্ট্যাক থেকে নতুন Message খুঁজে নেয়। এটি স্ট্যাকের সবচেয়ে উপরের আইটেম থেকে শুরু করে সেই Message না পাওয়া পর্যন্ত আইটেমগুলি চেক করে যায় যেটি এটি আগে প্রসেস করেছে। Looper স্ট্যাকের নিচের দিকে নামার সময়, এটি Messages-কে ডেডলাইন-অর্ডার করা মিনি-হিপে ইনসার্ট করে। যেহেতু Looper-এর কাছেই হিপের এক্সক্লুসিভ মালিকানা থাকে, তাই এটি লক বা অ্যাটমিক ছাড়াই Messages অর্ডার ও প্রসেস করে।
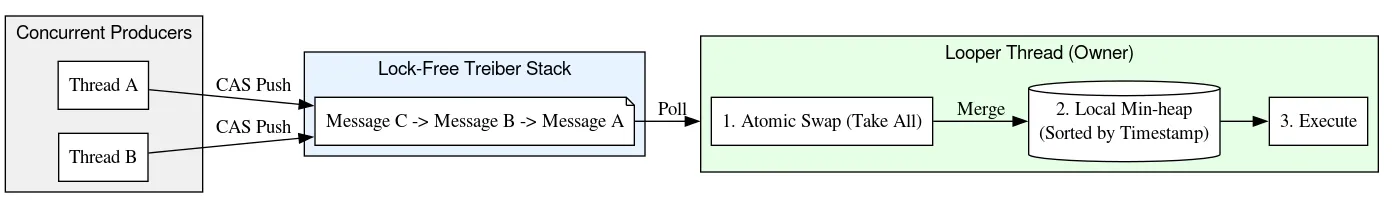
স্ট্যাকের নিচের দিকে যাওয়ার সময়, Looper স্ট্যাক করা Message-এর থেকে তাদের পূর্বসূরীদের লিঙ্কও তৈরি করে, এইভাবে একটি ডবল-লিঙ্ক করা তালিকা তৈরি হয়। লিঙ্ক করা তালিকা তৈরি করা নিরাপদ কারণ স্ট্যাকের নিচের দিকে নির্দেশ করে এমন লিঙ্কগুলি CAS সহ Treiber স্ট্যাক অ্যালগরিদমের মাধ্যমে যোগ করা হয় এবং স্ট্যাকের উপরের দিকে নির্দেশ করে এমন লিঙ্কগুলি শুধুমাত্র Looper থ্রেড দ্বারা পড়া এবং পরিবর্তন করা হয়। এইসব ব্যাক লিঙ্কগুলি তারপর O(1) সময়ে স্ট্যাকের Messages-কে নির্বিচারে পয়েন্ট থেকে সরিয়ে দিতে ব্যবহার করা হয়।
এই ডিজাইন প্রোডিউসারদের(কিউতে থ্রেড পোস্ট করা) জন্য O (১) ইনসার্শন এবং কনজিউমারদের(Looper) জন্য অ্যামর্টাইজড O (log N) প্রসেসিং প্রদান করে।
Messages-কে সাজানোর জন্য একটি মিনি-হিপ ব্যবহার করা MessageQueue-এর লিগ্যাসি ভার্সনের একটি মৌলিক ত্রুটির সমাধান করে, যেখানে Messages-কে একটি সিঙ্গেল-লিঙ্কড লিস্টে (উপরে রুট করা) রাখা হত। পুরনো ইমপ্লিমেন্টেশনে, হেড থেকে সরানো O(১) ছিল, কিন্তু ইনসার্শনের সবচেয়ে খারাপ কেস O(N) ছিল – ওভারলোড হওয়া কিউয়ের জন্য খারাপভাবে স্কেল করা হয়েছে! অন্যদিকে, মিন-হিপে ডেটা যোগ করা ও তা থেকে ডেটা সরানো লগারিদমিক স্কেলে হয়, এর ফলে প্রতিযোগিতামূলক গড় পারফর্ম্যান্স পাওয়া যায়, তবে লেটেন্সি কমানোর ক্ষেত্রে এটি খুবই ভাল কাজ করে।
লিগ্যাসি (লক করা) MessageQueue | DeliQueue | |
| যোগ করুন | O(N) | থ্রেড কল করার জন্য O(1)
|
| মাথা থেকে সরিয়ে দিন | O(১) | O(logN) |
পুরনো কিউ প্রয়োগ করার পদ্ধতিতে, প্রযোজক ও গ্রাহক, অন্তর্নিহিত এককভাবে লিঙ্ক করা তালিকার এক্সক্লুসিভ অ্যাক্সেস কোঅর্ডিনেট করার জন্য একটি লক ব্যবহার করতেন। DeliQueue-এ, Treiber স্ট্যাক একই সাথে অ্যাক্সেস ম্যানেজ করে এবং সিঙ্গেল কনজিউমার তার ওয়ার্ক কিউয়ের অর্ডার ম্যানেজ করে।
সরানো: টোমস্টোনের মাধ্যমে ধারাবাহিকতা
DeliQueue হল একটি হাইব্রিড ডেটা স্ট্রাকচার, যা একটি সিঙ্গেল-থ্রেডেড মিনি-হিপের সাথে লক-ফ্রি Treiber স্ট্যাককে একত্রিত করে। গ্লোবাল লক ছাড়া এই দুটি স্ট্রাকচার সিঙ্ক করে রাখা একটি অনন্য চ্যালেঞ্জ: কোনও মেসেজ হয়ত স্ট্যাকে ফিজিক্যালি উপস্থিত থাকতে পারে, কিন্তু লজিক্যালি তা কিউ থেকে সরিয়ে দেওয়া হয়েছে।
এটি সমাধান করতে, DeliQueue "টমবস্টোনিং" নামক একটি টেকনিক ব্যবহার করে। প্রতিটি Message ব্যাকওয়ার্ড ও ফরওয়ার্ড পয়েন্টারের মাধ্যমে স্ট্যাকে এটির পজিশন, হিপের অ্যারেতে এটির ইন্ডেক্স এবং এটি সরানো হয়েছে কিনা তা নির্দেশ করে এমন একটি বুলিয়ান ফ্ল্যাগ ট্র্যাক করে। কোনও Message রান করার জন্য রেডি হলে, Looper থ্রেডটি এর সরানো ফ্ল্যাগ CAS করবে, তারপর এটি হিপ ও স্ট্যাক থেকে সরিয়ে দেবে।
অন্য কোনও থ্রেডকে Message সরাতে হলে, এটি ডেটা স্ট্রাকচার থেকে অবিলম্বে তা এক্সট্র্যাক্ট করে না। পরিবর্তে, এটি নিম্নলিখিত ধাপগুলি সম্পাদন করে:
- লজিক্যাল সরানো: থ্রেডটি CAS ব্যবহার করে
Message-এর সরানোর ফ্ল্যাগকে অ্যাটমিক্যালি false থেকে true হিসেবে সেট করে।Messageমুছে দেওয়ার প্রসেস সম্পূর্ণ না হওয়া পর্যন্তMessageডেটা স্ট্রাকচারে থাকে, একে "টমস্টোন" বলা হয়। কোনওMessageমুছে দেওয়ার জন্য ফ্ল্যাগ করা হলে, DeliQueue এটিকে এমনভাবে ট্রিট করে যেন এটি আর কিউতে নেই। - বিলম্বিত ক্লিন-আপ: ডেটা স্ট্রাকচার থেকে প্রকৃত অর্থে সরানোর দায়িত্ব
Looperথ্রেডের এবং এটি পরে পর্যন্ত বিলম্বিত করা হয়। স্ট্যাক বা হিপ পরিবর্তন করার পরিবর্তে, রিমুভার থ্রেড অন্য লক-ফ্রি ফ্রিলিস্ট স্ট্যাকেMessageযোগ করে। - স্ট্রাকচারাল রিমুভাল: শুধুমাত্র
Looperহিপের সাথে ইন্টার্যাক্ট করতে বা স্ট্যাক থেকে এলিমেন্ট সরাতে পারে। এটি জেগে উঠলে, এটি ফ্রিলিস্ট মুছে দেয় এবং এতে থাকাMessages প্রসেস করে। তারপরে, প্রতিটিMessageস্ট্যাক থেকে আনলিঙ্ক করা হয় এবং হিপ থেকে সরিয়ে দেওয়া হয়।
এই পদ্ধতিতে, হিপের সমস্ত ম্যানেজমেন্ট সিঙ্গেল-থ্রেডেড থাকে। এটি প্রয়োজনীয় কনকারেন্ট অপারেশন ও মেমরি সংক্রান্ত বাধা কমিয়ে দেয়, ফলে গুরুত্বপূর্ণ পাথ আরও দ্রুত ও সহজ হয়ে যায়।
ট্রাভার্সাল: ক্ষতিকর নয় এমন Java মেমরি মডেল ডেটা রেস
বেশিরভাগ কনকারেন্সি API, যেমন Java স্ট্যান্ডার্ড লাইব্রেরিতে Future বা Kotlin-এর Job ও Deferred, কাজ সম্পূর্ণ হওয়ার আগে তা বাতিল করার একটি মেকানিজম অন্তর্ভুক্ত করে। এইসব ক্লাসের কোনও একটির ইনস্ট্যান্স, অন্তর্নিহিত কাজের একটি ইউনিটের সাথে ১:১ ম্যাচ করে এবং কোনও অবজেক্টে cancel কল করলে, সেটির সাথে যুক্ত নির্দিষ্ট অপারেশন বাতিল হয়ে যায়।
বর্তমান Android ডিভাইসে মাল্টি-কোর CPU এবং কনকারেন্ট, জেনারেশনাল গার্বেজ কালেকশন আছে। কিন্তু Android যখন প্রথম ডেভেলপ করা হয়, তখন কাজের প্রতিটি ইউনিটের জন্য একটি করে অবজেক্ট অ্যাসাইন করা খুবই ব্যয়বহুল ছিল। এর ফলে, Android Handler removeMessages-এর অসংখ্য ওভারলোডের মাধ্যমে বাতিল করার সুবিধা দেয় - নির্দিষ্ট Message সরানোর পরিবর্তে, এটি নির্দিষ্ট মানদণ্ড পূরণ করে এমন সব Message সরিয়ে দেয়। বাস্তবে, এর জন্য removeMessages কল করার আগে Message-এ যোগ করা সব removeMessages ইটারেট করতে হবে এবং মিলে যাওয়াগুলি সরিয়ে দিতে হবে।
এগিয়ে যাওয়ার সময়, কোনও থ্রেডকে স্ট্যাকের বর্তমান হেড রিড করার জন্য শুধুমাত্র একটি অর্ডারে থাকা অ্যাটমিক অপারেশন করতে হয়। এর পরে, পরবর্তী Message খুঁজে পেতে সাধারণ ফিল্ড রিড ব্যবহার করা হয়। Message সরানোর সময় Looper থ্রেড next ফিল্ড পরিবর্তন করলে, Looper-এর লেখা এবং অন্য থ্রেডের পড়া আনসিঙ্ক্রোনাইজড হয়ে যায় - এটি একটি ডেটা রেস। সাধারণত, ডেটা রেস হল একটি গুরুতর বাগ যা আপনার অ্যাপে বড় সমস্যা সৃষ্টি করতে পারে - ডেটা লিক, অসীম লুপ, ক্র্যাশ, ফ্রিজ এবং আরও অনেক কিছু। তবে, নির্দিষ্ট কিছু শর্তের অধীনে, জাভা মেমরি মডেলের মধ্যে ডেটা রেস ক্ষতিকর নাও হতে পারে। ধরা যাক, আমরা এগুলি দিয়ে শুরু করছি:

আমরা হেডের একটি অ্যাটমিক রিড পারফর্ম করি এবং A দেখতে পাই। A-এর পরবর্তী পয়েন্টার B-কে নির্দেশ করে। আমরা যখন B প্রসেস করছি, ঠিক সেই সময় লুপার B ও C সরিয়ে দিতে পারে, A-কে আপডেট করে C ও তারপর D-তে পয়েন্ট করার মাধ্যমে এটি করা হয়।
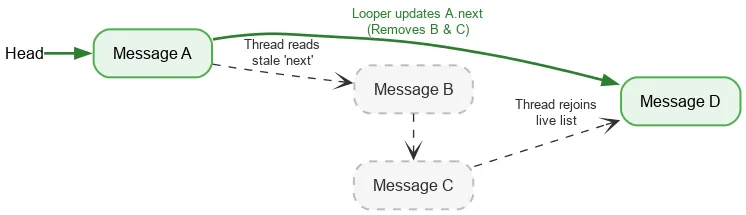
B ও C লজিক্যালি সরিয়ে দেওয়া হলেও, B-এর নেক্সট পয়েন্টার C-এর দিকেই থাকে এবং C-এর D-এর দিকে। রিডিং থ্রেডটি বিচ্ছিন্ন করা মুছে ফেলা নোডের মাধ্যমে ট্রাভার্স করা চালিয়ে যায় এবং অবশেষে D-এ লাইভ স্ট্যাকে আবার যোগ দেয়।
ট্রাভার্সাল ও রিমুভালের মধ্যে রেস হ্যান্ডেল করার জন্য DeliQueue ডিজাইন করার মাধ্যমে, আমরা নিরাপদ, লক-ফ্রি ইটারেশন করার অনুমতি দিই।
বেরিয়ে আসা: নেটিভ রেফারেন্স কাউন্ট
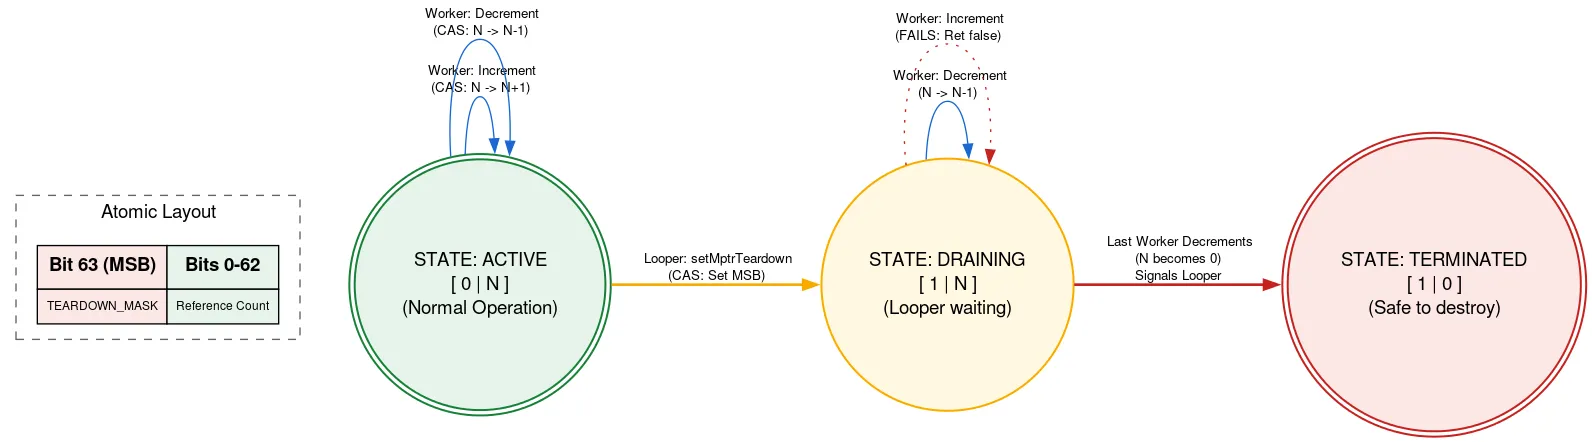
Looper একটি নেটিভ অ্যালোকেশন দ্বারা ব্যাক-আপ করা হয় যা Looper বন্ধ হয়ে গেলে ম্যানুয়ালি ফ্রি করতে হবে। Looper বন্ধ হয়ে যাওয়ার সময় অন্য কোনও থ্রেড Messages যোগ করলে, এটি ফ্রি হওয়ার পরে নেটিভ অ্যালোকেশন ব্যবহার করতে পারে, এটি মেমরি সুরক্ষা লঙ্ঘন। আমরা ট্যাগ করা refcount ব্যবহার করে এটি প্রতিরোধ করি, যেখানে Looper বন্ধ হচ্ছে কিনা তা বোঝাতে অ্যাটমিকের একটি বিট ব্যবহার করা হয়।
নেটিভ অ্যালোকেশন ব্যবহার করার আগে, একটি থ্রেড refcount অ্যাটমিক পড়ে। কুইটিং বিট সেট করা থাকলে, এটি রিটার্ন করে যে Looper বন্ধ হয়ে যাচ্ছে এবং নেটিভ অ্যালোকেশন ব্যবহার করা যাবে না। যদি না হয়, তাহলে নেটিভ অ্যালোকেশন ব্যবহার করে অ্যাক্টিভ থ্রেডের সংখ্যা বাড়ানোর জন্য CAS চেষ্টা করে। প্রয়োজনীয় কাজ করার পরে, এটি সংখ্যাটি এক করে কমিয়ে দেয়। যদি ইনক্রিমেন্ট করার পরে কিন্তু ডিক্রিমেন্ট করার আগে কুইটিং বিট সেট করা হয় এবং কাউন্ট এখন শূন্য হয়, তাহলে এটি Looper থ্রেডকে জাগিয়ে তোলে।
Looper থ্রেড বন্ধ করার জন্য রেডি হলে, অ্যাটমিক ভেরিয়েবলে বন্ধ করার বিট সেট করতে এটি CAS ব্যবহার করে। refcount ০ হলে, এটি নেটিভ অ্যালোকেশন ফ্রি করার প্রসেস শুরু করতে পারে। অন্যথায়, এটি নিজেই পার্ক হয়ে যায়, কারণ এটি জানে যে নেটিভ অ্যালোকেশনের শেষ ব্যবহারকারী refcount কমালে এটি আবার জেগে উঠবে। এই পদ্ধতির অর্থ হল, Looper থ্রেড অন্যান্য থ্রেডের প্রগ্রেসের জন্য অপেক্ষা করে, তবে শুধুমাত্র তখনই যখন এটি বন্ধ হয়ে যায়। এটি শুধুমাত্র একবারই ঘটে এবং পারফর্ম্যান্সের উপর এর কোনও প্রভাব পড়ে না এবং এটি নেটিভ অ্যালোকেশন ব্যবহার করার জন্য অন্যান্য কোডকে সম্পূর্ণ লক-ফ্রি রাখে।
প্রয়োগ করার সময় আরও অনেক কৌশল ও জটিলতা থাকে। আপনি সোর্স কোড পর্যালোচনা করে DeliQueue সম্পর্কে আরও জানতে পারবেন।
অপ্টিমাইজেশন: ব্রাঞ্চলেস প্রোগ্রামিং
DeliQueue ডেভেলপ ও পরীক্ষা করার সময়, টিম অনেক বেঞ্চমার্ক রান করেছে এবং নতুন কোডটি যত্ন সহকারে প্রোফাইল করেছে। simpleperf টুল ব্যবহার করে শনাক্ত করা একটি সমস্যা হল Message তুলনাকারী কোডের কারণে পাইপলাইন ফ্ল্যাশ।
একটি স্ট্যান্ডার্ড তুলনাকারী কন্ডিশনাল জাম্প ব্যবহার করে, কোন Message প্রথমে আসবে তা নির্ধারণ করার শর্ত নিচে সরলীকৃত করা হয়েছে:
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    if (m1 == m2) {
        return 0;
    }

    // Primary queue order is by when.
    // Messages with an earlier when should come first in the queue.
    final long whenDiff = m1.when - m2.when;
    if (whenDiff > 0) return 1;
    if (whenDiff < 0) return -1;

    // Secondary queue order is by insert sequence.
    // If two messages were inserted with the same `when`, the one inserted
    // first should come first in the queue.
    final long insertSeqDiff = m1.insertSeq - m2.insertSeq;
    if (insertSeqDiff > 0) return 1;
    if (insertSeqDiff < 0) return -1;

    return 0;
}
এই কোড কন্ডিশনাল জাম্পে (b.le ও cbnz নির্দেশাবলী) কম্পাইল করে। সিপিইউ কোনও কন্ডিশনাল ব্রাঞ্চের সম্মুখীন হলে, কন্ডিশনটি গণনা না করা পর্যন্ত এটি জানতে পারে না যে ব্রাঞ্চটি নেওয়া হয়েছে কিনা, তাই এটি জানে না যে পরবর্তী কোন নির্দেশাবলী পড়তে হবে এবং ব্রাঞ্চ প্রেডিকশন নামক একটি টেকনিক ব্যবহার করে অনুমান করতে হয়। বাইনারি সার্চের মতো ক্ষেত্রে, প্রতিটি ধাপে ব্রাঞ্চের দিকনির্দেশনা অপ্রত্যাশিতভাবে আলাদা হবে, তাই এটি সম্ভব যে অর্ধেক পূর্বাভাস ভুল হবে। সার্চ ও সর্টিং অ্যালগরিদমে (যেমন, মিন-হিপে ব্যবহৃত অ্যালগরিদম) ব্রাঞ্চ প্রিডিকশন প্রায়ই অকার্যকর হয়, কারণ ভুল অনুমান করার খরচ সঠিক অনুমান করার ফলে হওয়া উন্নতির চেয়ে বেশি হয়। ব্রাঞ্চ প্রেডিক্টর ভুল অনুমান করলে, সেটিকে অনুমান করা ভ্যালু ধরে নিয়ে করা কাজ বাতিল করে দিতে হয় এবং আসলে যে পাথ নেওয়া হয়েছে সেটি থেকে আবার শুরু করতে হয় - এটিকে পাইপলাইন ফ্ল্যাশ বলা হয়।
এই সমস্যা খুঁজে পেতে, আমরা branch-misses পারফর্ম্যান্স কাউন্টার ব্যবহার করে আমাদের বেঞ্চমার্ক প্রোফাইল করেছি, যা এমন স্ট্যাক ট্রেস রেকর্ড করে যেখানে ব্রাঞ্চ প্রেডিক্টর ভুল অনুমান করে। তারপর, আমরা Google pprof-এর মাধ্যমে ফলাফলগুলি ভিজ্যুয়ালাইজ করেছি, যেমনটি নিচে দেখানো হয়েছে:
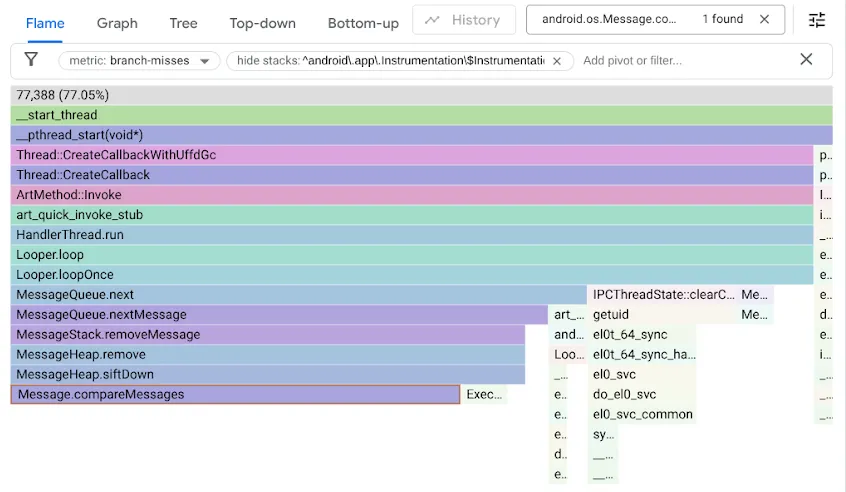
মনে রাখবেন, আসল MessageQueue কোডটি সাজানো সারির জন্য একটি সিঙ্গেল-লিঙ্কড তালিকা ব্যবহার করে। ইনসার্শনের ক্ষেত্রে, সর্ট করা ক্রমে লিনিয়ার সার্চ হিসেবে তালিকাটি ট্রাভার্স করা হবে, ইনসার্শনের পয়েন্টের পরে থাকা প্রথম এলিমেন্টে গিয়ে থামবে এবং নতুন Message সেটির আগে লিঙ্ক করা হবে। মাথা থেকে সরানোর জন্য শুধু মাথাটি আনলিঙ্ক করতে হবে। অন্যদিকে, DeliQueue একটি মিনি-হিপ ব্যবহার করে, যেখানে মিউটেশনের জন্য ব্যালেন্সড ডেটা স্ট্রাকচারে কিছু এলিমেন্ট (উপর বা নিচে শিফ্ট করা) আবার সাজাতে হয়, যেখানে যেকোনও তুলনার ক্ষেত্রে ট্রাভার্সালকে বামদিকের চাইল্ড বা ডানদিকের চাইল্ডে ডাইরেক্ট করার সমান সুযোগ থাকে। নতুন অ্যালগরিদম অ্যাসিপটোটিক্যালি দ্রুততর, কিন্তু এটি একটি নতুন বাধা তৈরি করে কারণ সার্চ কোড অর্ধেক সময় ব্রাঞ্চ মিস করে।
আমরা বুঝতে পারলাম যে ব্রাঞ্চ মিসের কারণে আমাদের হিপ কোড ধীরে ধীরে কাজ করছে, তাই আমরা ব্রাঞ্চ-ফ্রি প্রোগ্রামিং ব্যবহার করে কোড অপ্টিমাইজ করেছি:
// Branchless Logic
static int compareMessages(@NonNull Message m1, @NonNull Message m2) {
    final long when1 = m1.when;
    final long when2 = m2.when;
    final long insertSeq1 = m1.insertSeq;
    final long insertSeq2 = m2.insertSeq;

    // signum returns the sign (-1, 0, 1) of the argument,
    // and is implemented as pure arithmetic:
    // ((num >> 63) | (-num >>> 63))
    final int whenSign = Long.signum(when1 - when2);
    final int insertSeqSign = Long.signum(insertSeq1 - insertSeq2);

    // whenSign takes precedence over insertSeqSign,
    // so the formula below is such that insertSeqSign only matters
    // as a tie-breaker if whenSign is 0.
    return whenSign * 2 + insertSeqSign;
}
অপ্টিমাইজেশন বুঝতে, Compiler Explorer-এ দুটি উদাহরণ ডিসঅ্যাসেম্বল করুন এবং LLVM-MCA ব্যবহার করুন, এটি একটি CPU সিমুলেটর যা CPU চক্রের আনুমানিক টাইমলাইন তৈরি করতে পারে।
The original code:
Index     01234567890123
[0,0]     DeER .    .  .   sub  x0, x2, x3
[0,1]     D=eER.    .  .   cmp  x0, #0
[0,2]     D==eER    .  .   cset w0, ne
[0,3]     .D==eER   .  .   cneg w0, w0, lt
[0,4]     .D===eER  .  .   cmp  w0, #0
[0,5]     .D====eER .  .   b.le #12
[0,6]     . DeE---R .  .   mov  w1, #1
[0,7]     . DeE---R .  .   b    #48
[0,8]     . D==eE-R .  .   tbz  w0, #31, #12
[0,9]     .  DeE--R .  .   mov  w1, #-1
[0,10]    .  DeE--R .  .   b    #36
[0,11]    .  D=eE-R .  .   sub  x0, x4, x5
[0,12]    .   D=eER .  .   cmp  x0, #0
[0,13]    .   D==eER.  .   cset w0, ne
[0,14]    .   D===eER  .   cneg w0, w0, lt
[0,15]    .    D===eER .   cmp  w0, #0
[0,16]    .    D====eER.   csetm        w1, lt
[0,17]    .    D===eE-R.   cmp  w0, #0
[0,18]    .    .D===eER.   csinc        w1, w1, wzr, le
[0,19]    .    .D====eER   mov  x0, x1
[0,20]    .    .DeE----R   ret
একটি কন্ডিশনাল ব্রাঞ্চ b.le লক্ষ্য করুন, when ফিল্ডের তুলনা করে ফলাফল আগেই জানা থাকলে এটি insertSeq ফিল্ডের তুলনা করা এড়িয়ে যায়।
The branchless code:
Index     012345678
[0,0]     DeER .  .   sub       x0, x2, x3
[0,1]     DeER .  .   sub       x1, x4, x5
[0,2]     D=eER.  .   cmp       x0, #0
[0,3]     .D=eER  .   cset      w0, ne
[0,4]     .D==eER .   cneg      w0, w0, lt
[0,5]     .DeE--R .   cmp       x1, #0
[0,6]     . DeE-R .   cset      w1, ne
[0,7]     . D=eER .   cneg      w1, w1, lt
[0,8]     . D==eeER   add       w0, w1, w0, lsl #1
[0,9]     .  DeE--R   ret
এখানে, ব্রাঞ্চলেস কোড প্রয়োগ করলে, ব্রাঞ্চযুক্ত কোডের সবচেয়ে ছোট পাথের থেকেও কম সাইকেল ও নির্দেশ লাগে - এটি সব ক্ষেত্রেই ভালো। দ্রুত প্রয়োগ করা এবং ভুলভাবে অনুমান করা ব্রাঞ্চ বাদ দেওয়ার ফলে আমাদের কিছু বেঞ্চমার্কে ৫ গুণ উন্নতি হয়েছে!
তবে, এই কৌশল সবসময় প্রযোজ্য নয়। ব্রাঞ্চলেস অ্যাপ্রোচে সাধারণত এমন কাজ করতে হয় যা পরে আর কাজে লাগে না এবং বেশিরভাগ সময় ব্রাঞ্চ যদি অনুমানযোগ্য হয়, তাহলে সেইসব অপ্রয়োজনীয় কাজ আপনার কোডকে ধীরগতির করে দিতে পারে। এছাড়াও, কোনও শাখা সরিয়ে দিলে প্রায়ই ডেটা নির্ভরতা তৈরি হয়। আধুনিক সিপিইউ প্রতি সাইকেলে একাধিক অপারেশন এক্সিকিউট করে, কিন্তু আগের নির্দেশাবলী থেকে ইনপুট রেডি না হওয়া পর্যন্ত কোনও নির্দেশাবলী এক্সিকিউট করতে পারে না। অন্যদিকে, কোনও ব্রাঞ্চ সম্পর্কে CPU অনুমান করতে পারে এবং কোনও ব্রাঞ্চ সঠিকভাবে অনুমান করা হলে, আগে থেকেই কাজ করতে পারে।
পরীক্ষা ও যাচাইকরণ
লক-ফ্রি অ্যালগরিদম সঠিক কিনা তা যাচাই করা খুবই কঠিন!
ডেভেলপমেন্ট চলাকালীন ক্রমাগত যাচাইকরণের জন্য স্ট্যান্ডার্ড ইউনিট টেস্ট ছাড়াও, আমরা কিউ ইনভেরিয়েন্ট যাচাই করতে এবং ডেটা রেস থাকলে তা প্ররোচিত করার চেষ্টা করতে কঠোর স্ট্রেস টেস্ট লিখেছি। আমাদের টেস্ট ল্যাবে, আমরা এমুলেটেড ডিভাইস এবং আসল হার্ডওয়্যারে লক্ষ লক্ষ টেস্ট ইনস্ট্যান্স চালাতে পারি।
Java ThreadSanitizer (JTSan) ইনস্ট্রুমেন্টেশনের সাহায্যে, আমাদের কোডে কিছু ডেটা রেস শনাক্ত করতেও আমরা একই পরীক্ষা ব্যবহার করতে পারি। JTSan DeliQueue-এ কোনও সমস্যাজনক ডেটা রেস খুঁজে পায়নি, কিন্তু - আশ্চর্যজনকভাবে - Robolectric ফ্রেমওয়ার্কে দুটি কনকারেন্সি বাগ শনাক্ত করেছে, যা আমরা অবিলম্বে সমাধান করেছি।
আমাদের ডিবাগ করার ক্ষমতা উন্নত করতে, আমরা নতুন বিশ্লেষণ টুল তৈরি করেছি। নিচে Android প্ল্যাটফর্ম কোডে একটি সমস্যার উদাহরণ দেখানো হল যেখানে একটি থ্রেড অন্য থ্রেডকে Messages দিয়ে ওভারলোড করছে, এর ফলে একটি বড় ব্যাকলগ তৈরি হচ্ছে যা আমাদের যোগ করা MessageQueue ইনস্ট্রুমেন্টেশন ফিচারের জন্য Perfetto-তে দেখা যাচ্ছে।
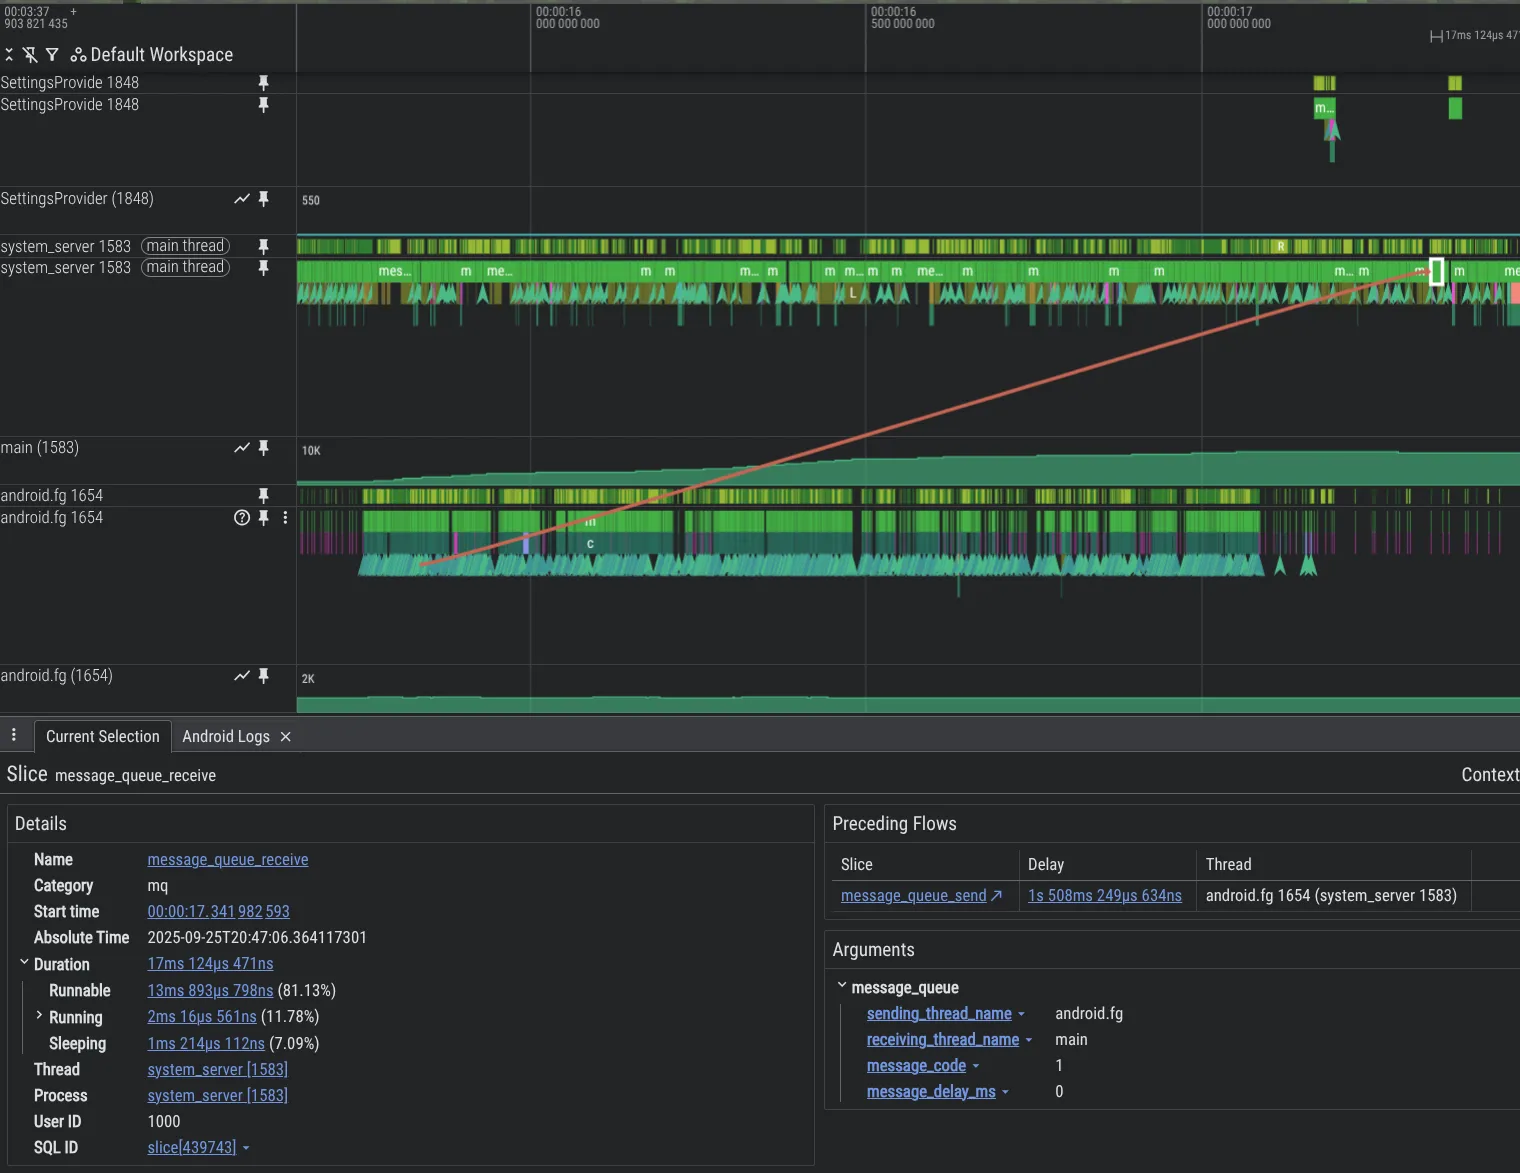
system_server প্রসেসে MessageQueue ট্রেসিং চালু করতে, আপনার Perfetto কনফিগারেশনে নিম্নলিখিত বিষয়গুলি অন্তর্ভুক্ত করুন:
data_sources {
  config {
    name: "track_event"
    target_buffer: 0  # Change this per your buffers configuration
    track_event_config {
      enabled_categories: "mq"
    }
  }
}
প্রভাব
DeliQueue MessageQueue থেকে লক সরিয়ে সিস্টেম ও অ্যাপ পারফর্ম্যান্স উন্নত করে।
- সিন্থেটিক বেঞ্চমার্ক: উন্নত কনকারেন্সি (Treiber stack) এবং দ্রুত ইনসার্শনের (min-heap) কারণে ব্যস্ত সারিতে মাল্টি-থ্রেডেড ইনসার্শন,লিগ্যাসি
MessageQueue-এর তুলনায় ৫, ০০০ গুণ দ্রুত হয়। - ইন্টার্নাল বিটা টেস্টারদের থেকে পাওয়া Perfetto ট্রেসে আমরা লক কনটেনশনে অ্যাপের মূল থ্রেডে কাটানো সময়ের ১৫% হ্রাস দেখতে পাই।
- একই টেস্ট ডিভাইসে, লক কনটেনশন কমানোর ফলে ব্যবহারকারীর অভিজ্ঞতায় উল্লেখযোগ্য উন্নতি হয়েছে, যেমন:
- অ্যাপে -৪% ফ্রেম মিস হয়েছে।
- সিস্টেম UI ও লঞ্চার ইন্টার্যাকশনে -৭.৭% মিস করা ফ্রেম।
- -9.1% in time from app startup to the first frame drawn, at the 95%ile.
পরবর্তী ধাপ
DeliQueue Android 17-এর অ্যাপে রিলিজ করা হচ্ছে। অ্যাপ ডেভেলপারদের Android Developers ব্লগে নতুন লক-ফ্রি MessageQueue ফিচারের জন্য অ্যাপ প্রস্তুত করা সংক্রান্ত তথ্য পর্যালোচনা করে দেখতে হবে যাতে তারা জানতে পারেন কীভাবে অ্যাপ পরীক্ষা করতে হয়।
রেফারেন্স
[১] Treiber, R.K., ১৯৮৬. সিস্টেম প্রোগ্রামিং: প্যারালাল প্রসেসিংয়ের সাথে মানিয়ে নেওয়া। International Business Machines Incorporated, Thomas J. Watson Research Center.
[২] Goetz, B., Peierls, T., Bloch, J., Bowbeer, J., Holmes, D., & Lea, D. (2006). Java Concurrency in Practice. Addison-Wesley Professional.
-

 প্রোডাক্ট সম্পর্কিত খবর
Android ডেভেলপার হিসেবে, অ্যাপ ডেভেলপমেন্টের জন্য আপনি যেসব এজেন্ট, LLM, টুল ও কমান্ড-লাইন ইন্টারফেস (CLI) ব্যবহার করেন, সেই ব্যাপারে আপনার কাছে অনেক বিকল্প আছে। আপনি যেভাবে তৈরি করতে চান না কেন, আমাদের লক্ষ্য হল আপনাকে সুন্দর, হাই-কোয়ালিটি Android অ্যাপ তৈরি করতে সাহায্য করা।
Simona Milanovic • ৪ মিনিট রিডিং টাইম -
 প্রোডাক্ট সম্পর্কিত খবর
Google Play-তে, আমরা ক্রমাগত আমাদের সাবস্ক্রিপশন প্ল্যাটফর্মের পরিধি বাড়াচ্ছি যাতে আপনি ব্যবসা বাড়াতে, নতুন বিজনেস মডেলের সাথে মানিয়ে নিতে এবং ব্যবহারকারীদের ঠিক যেখানে প্রয়োজন সেখানে তাদের চাহিদা পূরণ করতে পারেন।
Sheenam Mittal • ৪ মিনিট রিডিং টাইম -
 প্রোডাক্ট সম্পর্কিত খবর
গত বছর, Android Studio যেকোনও AI মডেলের জন্য খুলে দেওয়া হয়েছে। আজ, আমরা আপনার পছন্দের কোডিং এজেন্টদের জন্য সহায়তা প্রদান করে পরবর্তী পদক্ষেপ নিচ্ছি।
Matthew Warner • ৩ মিনিট রিডিং
আপনার ইনবক্সে প্রতি সপ্তাহে Android ডেভেলপমেন্ট সংক্রান্ত লেটেস্ট ইনসাইট পান।