Android Bench 2.0: চ্যালেঞ্জিং লং-হরাইজন টাস্কের মাধ্যমে ফ্রন্টিয়ারকে পুশ করা
৩ মিনিট রিডিং
আমরা যখন প্রথম Android Bench লঞ্চ করি, তখন আমরা একটি কঠোর ভিত্তি তৈরি করেছিলাম যাতে মূল্যায়ন করা যায় যে লার্জ ল্যাঙ্গুয়েজ মডেল (LLM) কীভাবে ডেভেলপারদের বাস্তব-জগতের Android টাস্কে সহায়তা করে। AI মডেল ও এজেন্ট দ্রুত উন্নত হওয়ার সাথে সাথে আমরা আমাদের পদ্ধতি আপডেট করছি, যেমন Harbor ফ্রেমওয়ার্ক-এর সাথে আমাদের বেঞ্চমার্ক ফ্রেমওয়ার্ক অ্যালাইন করা। আজ আমরা লং-হরাইজন টাস্কের (LHT) প্রথম সেট রিলিজ করছি, এগুলি অত্যন্ত জটিল টাস্ক যা সম্পূর্ণ করতে একজন ইঞ্জিনিয়ারের একাধিক দিন বা এমনকি এক সপ্তাহও সময় লাগে। আমরা এজেন্টিক মূল্যায়নও চালু করছি, যা সংশ্লিষ্ট মডেল প্রদানকারীর এজেন্টদের দিয়ে শুরু হবে। এই সংযোজনের ফলে আমরা Android Bench 2.0-এ পৌঁছেছি—এটি একটি বড় আপগ্রেড যা AI মডেল এবং এজেন্টদের স্কেল, অস্পষ্টতা এবং জটিল মাল্টি-স্টেপ সমস্যা সমাধানের ক্ষমতা মূল্যায়ন করার জন্য ডিজাইন করা হয়েছে যা আপনি প্রতিদিন মোকাবিলা করেন।
ইনক্রিমেন্টাল সমাধান থেকে শুরু করে লং-হরাইজন টাস্ক পর্যন্ত
Android Bench-এর প্রথম ইটারেশন, একই ধরনের প্রাথমিক AI কোডিং বেঞ্চমার্কের সাথে, বিদ্যমান রিপোজিটরিতে ক্রমবর্ধমান পরিবর্তনের উপর ফোকাস করে, অনেক ক্ষেত্রে বাগ ফিক্স বা ছোট ফিচার অনুরোধের মধ্যে সীমাবদ্ধ। এটি সেই সময়ে AI অ্যাসিস্ট্যান্সের ক্ষমতা এবং আপনি কীভাবে এটি ব্যবহার করছিলেন তার প্রতিফলন ছিল।
আপনার ডেভেলপমেন্ট ওয়ার্কফ্লোর জন্য সবচেয়ে উপযুক্ত মডেল ও কোডিং এজেন্ট খুঁজে পেতে আপনাকে সাহায্য করা চালিয়ে যেতে, আপনি AI-কে যে কাজ ডেলিগেট করেন তার সাথে ম্যাচ করার জন্য আমরা আমাদের মূল্যায়নের মান আরও উন্নত করেছি। Android Bench 2.0 এই উচ্চাকাঙ্ক্ষী চ্যালেঞ্জগুলিকে LHT-এর মাধ্যমে প্রতিফলিত করে, যার মধ্যে রয়েছে ডিপেন্ডেন্সি আপগ্রেড করা, নতুন ফিচার যোগ করা, স্ক্র্যাচ থেকে অ্যাপ তৈরি করা বা ক্রস-প্ল্যাটফর্ম অ্যাপকে Android-এ রূপান্তর করা।
জটিল টাস্কের ক্ষেত্রে আরও সূক্ষ্ম মূল্যায়ন এবং স্কোরিং প্রয়োজন
একাধিক দিন ধরে চলা ইঞ্জিনিয়ারিং টাস্কের ক্ষেত্রে, বাইনারি পাস বা ফেল গ্রেডিংয়ের মাধ্যমে সম্পূর্ণ ছবিটা বোঝা যায় না।
যেমন, কোনও এজেন্ট ৪০টি স্ক্রিন Jetpack Compose-এ রিফ্যাক্টর করতে পারে, ডেটাবেস টেবিল সেট-আপ করতে পারে এবং ৯০% প্রয়োজনীয়তা পূরণ করতে পারে, কিন্তু একটি এজ-কেস অ্যাসারশন পূরণ করতে ব্যর্থ হতে পারে। বাইনারি স্কোরিং এই রানকে ০% হিসেবে রেট করে, যা মডেলের আর্কিটেকচারাল ক্ষমতাকে অস্পষ্ট করে। মডেল ডেভেলপমেন্ট এবং AI কীভাবে আপনাকে সাহায্য করতে পারে সেই সম্পর্কে আপনার বোঝার জন্য আরও অর্থপূর্ণ সিগন্যাল প্রদান করতে আমরা ক্রমাগত স্কোরিংয়ের দিকে এগিয়ে চলেছি।
আমরা কার্যকারিতা, ভিজ্যুয়াল ফিডেলিটি এবং রিগ্রেশন এড়ানোর মতো বিভিন্ন ফ্যাক্টরের সমন্বয়ে এই সম্পূর্ণতার হার গণনা করি। এছাড়াও, মূল্যায়ন সংক্রান্ত নির্দেশাবলী বা কাঠামোগত সীমাবদ্ধতা থেকে বিচ্যুতি ঘটলে আমরা অবজেক্টিভ স্কোরিং পেনাল্টি প্রয়োগ করি। আপডেট করা লিডারবোর্ড চেক করুন এবং প্রতিটি মডেলের কার্ড ভিউতে ক্লিক করে অতিরিক্ত এলিমেন্ট দেখুন, যেমন পাস রেট, সম্পূর্ণ করার রেট এবং মডেল ও টাস্ক প্রতি গড় খরচ।
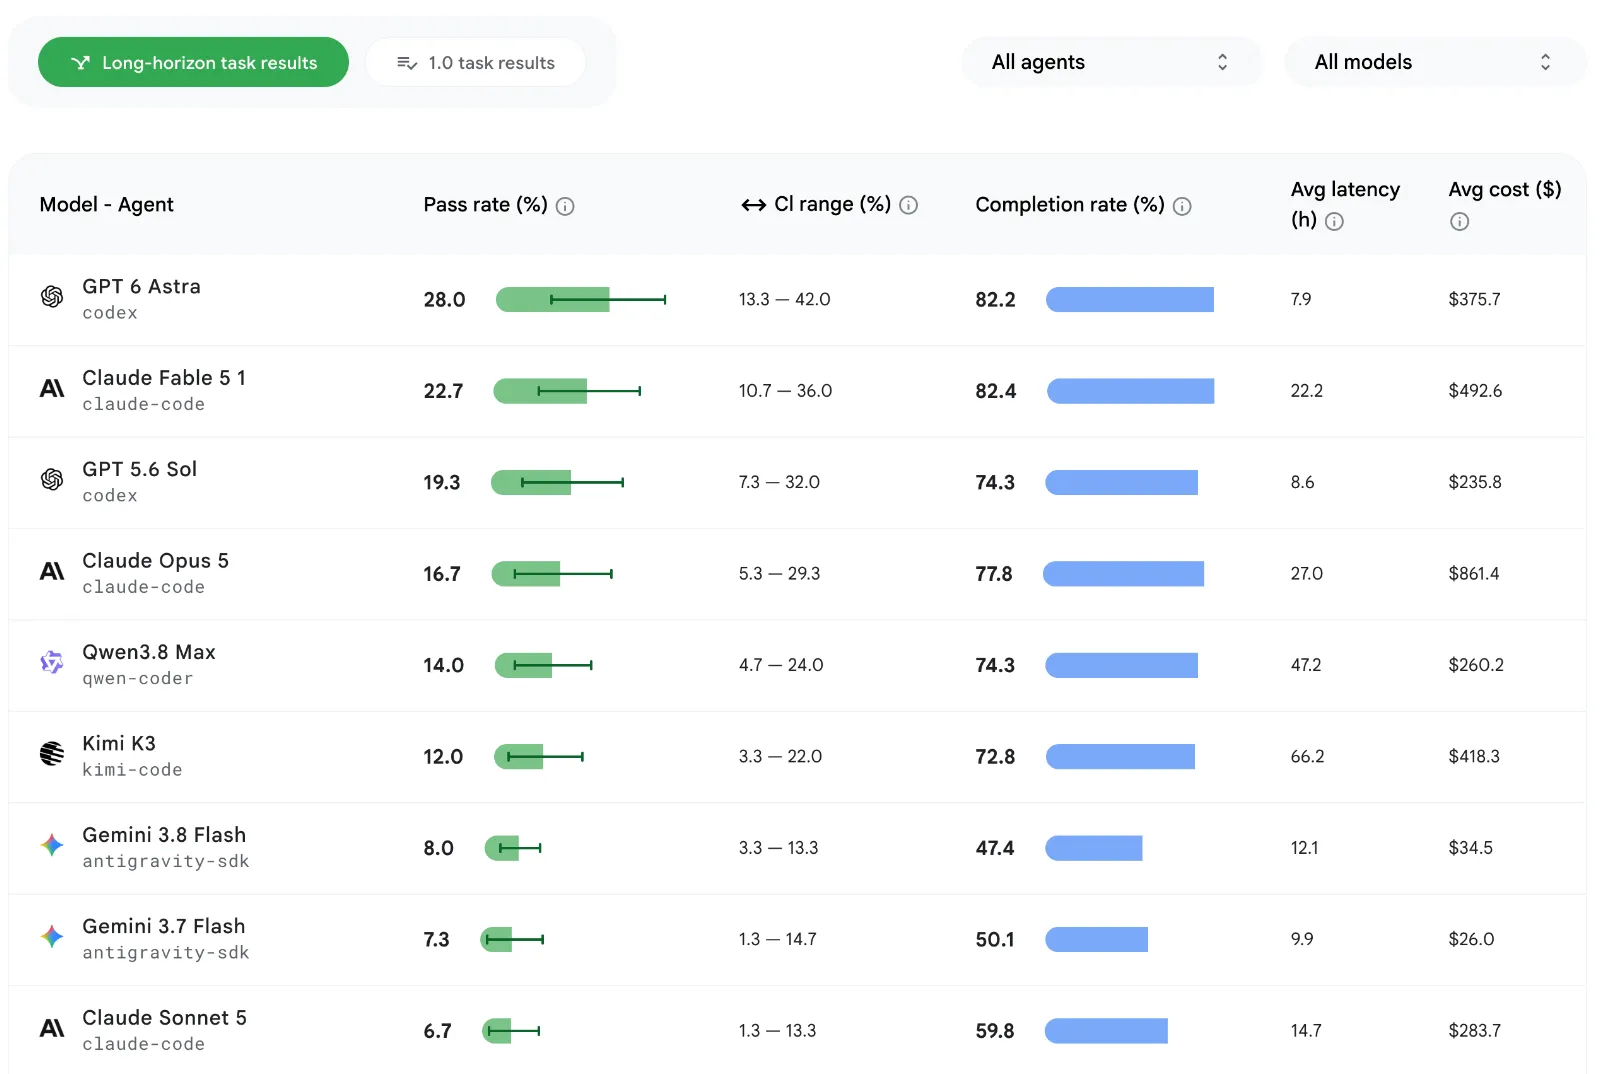
LHT-এর জন্য সর্বোচ্চ পাস রেট হল প্রায় ২৮%, যা বেঞ্চমার্কে আসল টাস্কের জন্য ~৯১% থেকে অনেক কম।
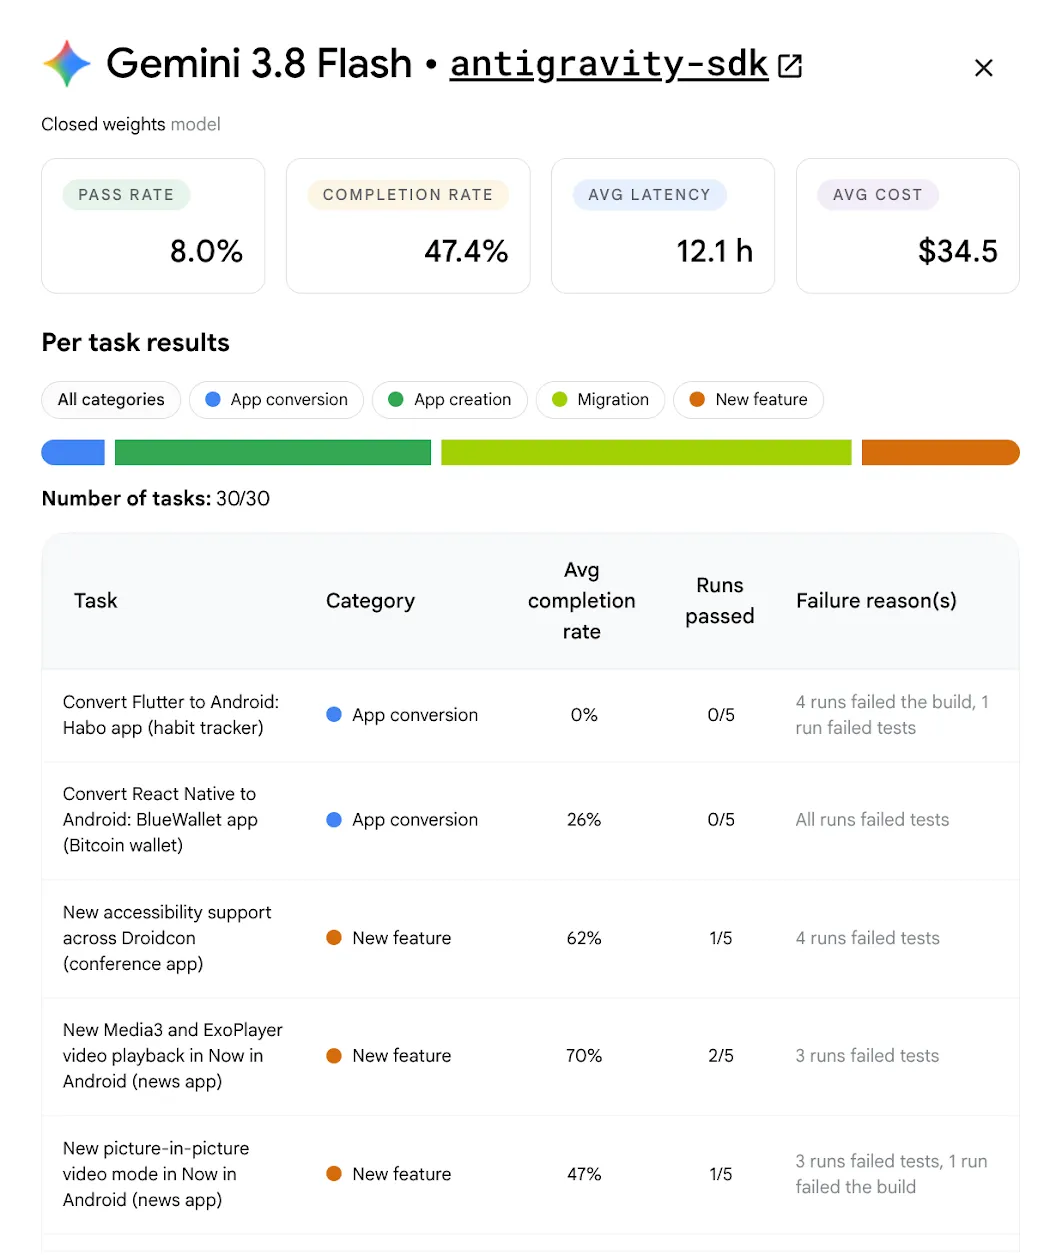
লং-হরাইজন টাস্ক AI অ্যাসিস্ট্যান্সের জন্য সহায়ক ইনসাইট প্রকাশ করে
AI কত ভালোভাবে দীর্ঘ সময় ধরে চলা টাস্ক ম্যানেজ করে তা পরিমাপ করার পাশাপাশি, LHT ডেটাসেট আমাদের পরীক্ষিত মডেলের শক্তি ও দুর্বলতা সম্পর্কে আরও জানতে সাহায্য করে এবং আমরা আপনাকে আরও ব্যবহারিক নির্দেশিকা অফার করি।
মডেলের বিভিন্ন টিয়ার জুড়ে, AI আগে থেকে থাকা কোড রিফ্যাক্টর করার চেয়ে নতুন কোড লেখার ক্ষেত্রে আরও ভালো কাজ করে। রিফ্যাক্টর ও মাইগ্রেশন আরও জটিল হয়ে যায় কারণ সাফল্য কোডের পরিমাণের চেয়ে আর্কিটেকচারাল জটিলতার উপর নির্ভর করে।
মডেলগুলি সুপ্রতিষ্ঠিত, নির্ধারক রূপান্তরে শক্তিশালী ক্ষমতা দেখায়, যেমন জাভাকে কোটলিনে রূপান্তর করা, Ktor-এর জন্য রেট্রোফিট অদলবদল করা বা একটি ভিউমডেল লেয়ার চালু করা। এমনকি ১২৫টির বেশি ফাইল এবং ৮, ০০০-এর বেশি লাইনের কোড জুড়েও,তারা এই প্যাটার্নগুলি ধারাবাহিকভাবে প্রয়োগ করে।
তবে, টাস্কের জন্য রানটাইম যাচাইকরণ (যেমন, মিসিং ডিপেন্ডেন্সি ইনজেকশন গ্রাফ) প্রয়োজন হলে, ফ্রেমওয়ার্ক পরিবর্তনের ক্ষেত্রে সমস্যা হলে বা রিলিজ না হওয়া লাইব্রেরির ক্ষেত্রে নলেজ গ্যাপ থাকলে, মডেলের পক্ষে কাজ করা কঠিন হয়ে পড়ে। Android-এ ক্রস-প্ল্যাটফর্ম অ্যাপ পোর্ট করা এখনও একটি বড় চ্যালেঞ্জ—কোনও মডেলই ১০০% পাস রেট অর্জন করতে পারেনি এবং ফ্রন্টিয়ার মডেলগুলি সর্বাধিক ৮০% সম্পূর্ণতা রেটে পৌঁছায়।
এজেন্ট মূল্যায়ন ফিচার চালু করা হচ্ছে
আপনার এজেন্টিক ওয়ার্কফ্লোতে ইন্টিগ্রেট করা হলে মডেলগুলি কীভাবে পারফর্ম করে তা আরও ভালোভাবে বুঝতে আপনাকে সাহায্য করার জন্য, আমরা আমাদের মূল্যায়নে সাধারণত ব্যবহৃত এজেন্ট যোগ করছি। আমরা সংশ্লিষ্ট মডেল প্রদানকারীর এজেন্টদের সাথে LHT-এর বিপরীতে নতুন মডেল চালানোর মাধ্যমে শুরু করছি। যেমন, আমরা Codex-এ GPT 5.6 Sol এবং Google Antigravity-তে Gemini 3.8 Flash রান করেছি। এই পেয়ারিং থেকে বোঝা যায় যে হার্নেস ডিজাইন কীভাবে ডেভেলপারদের আউটকামকে ইতিবাচকভাবে প্রভাবিত করে, কারণ আমরা দেখেছি যে প্রম্পট ক্যাশিং এবং কম্প্যাক্ট টুল উইন্ডোইংয়ের ফলে টোকেন কমে যেতে পারে।
আমরা ভবিষ্যতে বিভিন্ন মডেল এবং এজেন্ট কম্বিনেশন জুড়ে ফলাফল হাইলাইট করে এটি আরও প্রসারিত করব, যাতে আপনি এবং আপনার টিমের জন্য কোন কম্বিনেশন সবচেয়ে ভালো কাজ করে তা খুঁজে পেতে সাহায্য করতে পারি।
আমরা এই পরিমাপে বিনিয়োগ করি কারণ Android ডেভেলপমেন্টের জন্য আপনার পছন্দের এজেন্ট এবং মডেল ব্যবহার করতে পারা আপনার জন্য গুরুত্বপূর্ণ এবং আগামী সপ্তাহে আপনার সাথে শেয়ার করার জন্য আমাদের কাছে আরও অনেক কিছু থাকবে।
নতুন মডেল যোগ করা হয়েছে
এছাড়াও, আপনার ডেভেলপমেন্ট সংক্রান্ত সিদ্ধান্ত নেওয়ার জন্য যাতে সবচেয়ে আপ-টু-ডেট ডেটা পান তা নিশ্চিত করতে আমরা লিডারবোর্ড আরও প্রসারিত করছি। আমরা Gemini 3.8 Flash, Gemini 3.7 Flash, OpenAI-এর GPT-6, Anthropic-এর Fable 5.1, Kimi K3 এবং Qwen 3.8 Max যোগ করেছি, যার মধ্যে OpenAI-এর GPT-6 Astra ২৮% পাস রেট সহ শীর্ষে রয়েছে।
ভবিষ্যতের কথা ভেবে প্ল্যান করা
Android Bench 2.0, Android ডেভেলপমেন্টের জন্য AI পরিমাপ করার একটি শক্তিশালী পরিবেশ প্রদান করে। লং-হরাইজন টাস্ক, মাল্টিমোডাল মূল্যায়ন, এজেন্ট ও ক্রমাগত স্কোরিংয়ের মাধ্যমে আমরা আশা করি যে AI রিসার্চ টিমকে আরও দক্ষ, নির্ভরযোগ্য AI কোডিং পার্টনার তৈরি করার জন্য ক্ষমতায়ন করতে পারব এবং AI ডেভেলপমেন্টের জন্য আপনার বিকল্প সম্পর্কে আরও স্বচ্ছতা প্রদান করতে পারব।
আপডেট করা পদ্ধতি সহ আপডেট করা লিডারবোর্ড চেক করে দেখুন। আপনার মতামত সরাসরি Android Bench-এর উন্নতিতে প্রভাব ফেলে, তাই GitHub-এর পাশাপাশি X এবং LinkedIn-এর মতো আমাদের সোশ্যাল চ্যানেলে আপনার মতামত শেয়ার করা চালিয়ে যান।
-
 প্রোডাক্ট সংক্রান্ত খবর
আজ, Android Dev Summit-এ, আমরা অনেক টুল এবং API-এর ব্যাপক উপলভ্যতা ঘোষণা করছি যা প্রতিদিনের ঘর্ষণ দূর করতে এবং আপনাকে দুর্দান্ত Android অ্যাপ তৈরি করার জন্য আরও নমনীয়তা দেওয়ার জন্য ডিজাইন করা হয়েছে।
Matthew McCullough • ৪ মিনিট লাগবে -
 প্রোডাক্ট সংক্রান্ত খবর
এজেন্টিক ডেভেলপমেন্টের গতি বাড়ার সাথে সাথে, Android ইঞ্জিনিয়ারিং একটি নতুন দিগন্তে পৌঁছাচ্ছে: সহায়ক কোড সম্পূর্ণ করা থেকে শুরু করে আপনার নির্দেশনায় এন্ড-টু-এন্ড এক্সিকিউট করা এজেন্ট পর্যন্ত। আপনি কোন মডেল ও এজেন্ট ব্যবহার করবেন তা বেছে নেওয়ার সম্পূর্ণ স্বাধীনতা ও সুবিধা আপনার আছে।
Jason Buchel • ৩ মিনিট রিডিং -

 প্রোডাক্ট সংক্রান্ত খবর
Android ডেভেলপার হিসেবে, অ্যাপ ডেভেলপমেন্টের জন্য আপনি যে এজেন্ট, LLM, টুল এবং কমান্ড-লাইন ইন্টারফেস (CLI) ব্যবহার করেন, তার ক্ষেত্রে আপনার কাছে অনেক বিকল্প রয়েছে। আপনি যেভাবে তৈরি করার সিদ্ধান্ত নিন না কেন, আমাদের লক্ষ্য হল আপনাকে সুন্দর, খুব ভাল কোয়ালিটির Android অ্যাপ তৈরি করতে সাহায্য করা।
Simona Milanovic • ৪ মিনিট লাগবে
আপনার ইনবক্সে প্রতি সপ্তাহে Android ডেভেলপমেন্ট সংক্রান্ত লেটেস্ট ইনসাইট পান।