L'équipe Android Runtime (ART) a réduit le temps de compilation de 18% sans compromettre le code compilé ni entraîner de régression de la mémoire de pointe. Cette amélioration s'inscrit dans le cadre de notre initiative de 2025 visant à améliorer le temps de compilation sans sacrifier l'utilisation de la mémoire ni la qualité du code compilé.
L'optimisation de la vitesse de compilation est essentielle pour ART. Par exemple, lors de la compilation juste-à-temps (JIT), cela a un impact direct sur l'efficacité des applications et les performances globales de l'appareil. Des compilations plus rapides réduisent le temps nécessaire avant que les optimisations ne prennent effet, ce qui se traduit par une expérience utilisateur plus fluide et plus réactive. De plus, pour les compilations JIT et AOT, l'amélioration de la vitesse de compilation se traduit par une réduction de la consommation de ressources pendant le processus de compilation, ce qui est bénéfique pour l'autonomie de la batterie et la température de l'appareil, en particulier sur les appareils d'entrée de gamme.
Certaines de ces améliorations de la vitesse de compilation ont été lancées dans la version Android de juin 2025, et les autres seront disponibles dans la version Android de fin d'année. De plus, tous les utilisateurs d'Android 12 ou version ultérieure peuvent bénéficier de ces améliorations grâce aux mises à jour Mainline.
Optimiser le compilateur d'optimisation
L'optimisation d'un compilateur est toujours une question de compromis. Vous ne pouvez pas simplement obtenir de la vitesse sans frais ; vous devez renoncer à quelque chose. Nous nous sommes fixé un objectif très clair et ambitieux : accélérer le compilateur, mais sans introduire de régressions de mémoire et, surtout, sans dégrader la qualité du code qu'il produit. Si le compilateur est plus rapide, mais que les applications s'exécutent plus lentement, nous avons échoué.
La seule ressource que nous étions prêts à dépenser était notre propre temps de développement pour approfondir, étudier et trouver des solutions intelligentes répondant à ces critères stricts. Examinons de plus près comment nous procédons pour identifier les points à améliorer et trouver les solutions adaptées aux différents problèmes.
Trouver des optimisations possibles intéressantes
Avant de pouvoir commencer à optimiser une métrique, vous devez être en mesure de la mesurer. Sinon, vous ne pourrez jamais savoir si vous l'avez amélioré ou non. Heureusement, la vitesse de compilation est assez constante, à condition de prendre certaines précautions, comme utiliser le même appareil pour mesurer avant et après une modification, et vous assurer de ne pas limiter thermiquement votre appareil. En outre, nous disposons de mesures déterministes, telles que les statistiques du compilateur, qui nous aident à comprendre ce qui se passe en arrière-plan.
Comme la ressource que nous sacrifiions pour ces améliorations était notre temps de développement, nous voulions pouvoir effectuer des itérations aussi rapidement que possible. Nous avons donc sélectionné un certain nombre d'applications représentatives (un mélange d'applications propriétaires, d'applications tierces et du système d'exploitation Android lui-même) pour créer des prototypes de solutions. Ensuite, nous avons vérifié que l'implémentation finale en valait la peine, en effectuant des tests manuels et automatisés à grande échelle.
Avec cet ensemble d'APK triés sur le volet, nous déclenchons une compilation manuelle en local, obtenons un profil de la compilation et utilisons pprof pour visualiser où nous passons notre temps.

Exemple de graphique de type "flamme" d'un profil dans pprof
L'outil pprof est très puissant et nous permet de segmenter, de filtrer et de trier les données pour voir, par exemple, quelles phases ou méthodes du compilateur prennent le plus de temps. Nous n'entrerons pas dans les détails de pprof. Sachez simplement que plus la barre est grande, plus la compilation a pris du temps.
L'une de ces vues est la vue "Bottom Up" (Ascendante), qui vous permet de voir quelles méthodes prennent le plus de temps. Dans l'image ci-dessous, nous pouvons voir une méthode appelée "Kill", qui représente plus de 1% du temps de compilation. Certaines des autres méthodes principales seront également abordées plus loin dans l'article de blog.
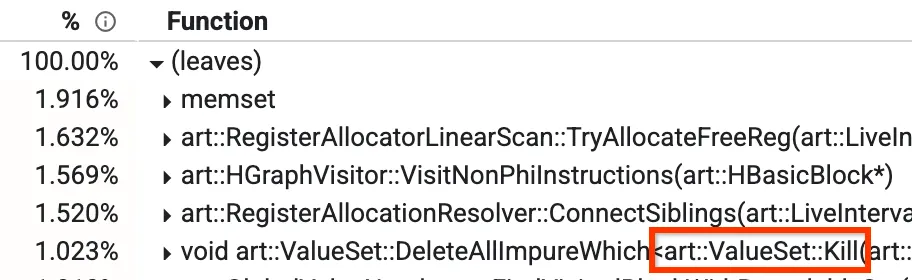
Vue de profil de bas en haut
Dans notre compilateur d'optimisation, il existe une phase appelée "Global Value Numbering" (GVN). Vous n'avez pas à vous soucier de ce qu'il fait dans son ensemble, mais il est important de savoir qu'il dispose d'une méthode appelée "Kill" qui supprime certains nœuds en fonction d'un filtre. Cette opération prend du temps, car elle doit parcourir tous les nœuds et les vérifier un par un. Nous avons remarqué que, dans certains cas, nous savons à l'avance que la vérification sera fausse, quels que soient les nœuds actifs à ce moment-là. Dans ce cas, nous pouvons ignorer complètement l'itération, ce qui réduit le taux de 1,023% à environ 0,3% et améliore l'exécution de GVN d'environ 15%.
Implémenter des optimisations utiles
Nous avons vu comment mesurer et détecter où le temps est passé, mais ce n'est que le début. L'étape suivante consiste à optimiser le temps consacré à la compilation.
En général, dans un cas comme celui de "Kill" ci-dessus, nous examinons la façon dont nous itérons sur les nœuds et nous accélérons le processus, par exemple en effectuant des opérations en parallèle ou en améliorant l'algorithme lui-même. En fait, c'est ce que nous avons essayé de faire au début. Ce n'est que lorsque nous n'avons rien trouvé à faire que nous avons eu un moment de réflexion et que nous avons compris que la solution consistait (dans certains cas) à ne pas itérer du tout. Lorsque vous effectuez ce type d'optimisation, il est facile de passer à côté de l'essentiel.
Dans d'autres cas, nous avons utilisé plusieurs techniques différentes, y compris :
- Utiliser des heuristiques pour déterminer si une optimisation ne produira pas de résultats intéressants et peut donc être ignorée
- en utilisant des structures de données supplémentaires pour mettre en cache les données calculées
- modifier les structures de données actuelles pour accélérer le traitement ;
- Calculer les résultats de manière différée pour éviter les cycles dans certains cas
- Utilisez la bonne abstraction : les fonctionnalités inutiles peuvent ralentir le code.
- éviter de suivre un pointeur fréquemment utilisé via de nombreux chargements
Comment savoir si les optimisations valent la peine d'être poursuivies ?
C'est là que ça devient intéressant : vous n'avez pas besoin de le faire. Après avoir détecté qu'une zone consomme beaucoup de temps de compilation et après avoir consacré du temps de développement à essayer de l'améliorer, il arrive que vous ne trouviez pas de solution. Peut-être qu'il n'y a rien à faire, que l'implémentation prendra trop de temps, qu'elle entraînera une régression significative d'une autre métrique, qu'elle augmentera la complexité de la base de code, etc. Pour chaque optimisation réussie que vous pouvez voir dans cet article de blog, sachez qu'il y en a d'innombrables autres qui n'ont tout simplement pas abouti.
Si vous vous trouvez dans une situation similaire, essayez d'estimer l'amélioration que vous pouvez apporter à la métrique en effectuant le moins de travail possible. Cela signifie, dans l'ordre :
- Estimer à l'aide de métriques que vous avez déjà collectées ou simplement d'une intuition
- Estimer avec un prototype rapide et approximatif
- Implémenter une solution.
N'oubliez pas d'estimer les inconvénients de votre solution. Par exemple, si vous allez vous appuyer sur des structures de données supplémentaires, quelle quantité de mémoire êtes-vous prêt à utiliser ?
Explorer en détail
Sans plus attendre, examinons quelques-unes des modifications que nous avons apportées.
Nous avons modifié pour optimiser une méthode appelée FindReferenceInfoOf. Cette méthode effectuait une recherche linéaire d'un vecteur pour trouver une entrée. Nous avons mis à jour cette structure de données pour qu'elle soit indexée par l'ID de l'instruction, de sorte que FindReferenceInfoOf soit O(1) au lieu de O(n). Nous avons également pré-alloué le vecteur pour éviter le redimensionnement. Nous avons légèrement augmenté la mémoire, car nous avons dû ajouter un champ supplémentaire qui comptait le nombre d'entrées insérées dans le vecteur, mais c'était un petit sacrifice à faire, car la mémoire maximale n'a pas augmenté. Cela a permis d'accélérer notre phase LoadStoreAnalysis de 34 à 66 %, ce qui a permis d'améliorer le temps de compilation d'environ 0,5 à 1,8 %.
Nous avons une implémentation personnalisée de HashSet que nous utilisons à plusieurs endroits. La création de cette structure de données prenait beaucoup de temps, et nous avons découvert pourquoi. Il y a de nombreuses années, cette structure de données n'était utilisée que dans quelques endroits qui utilisaient de très grands HashSets, et elle a été modifiée pour être optimisée pour cela. Cependant, de nos jours, il est utilisé dans le sens inverse, avec seulement quelques entrées et une courte durée de vie. Cela signifie que nous gaspillions des cycles en créant cet énorme HashSet, mais que nous ne l'utilisions que pour quelques entrées avant de le supprimer. Grâce à ce changement, nous avons amélioré le temps de compilation d'environ 1,3 à 2 %. En prime, l'utilisation de la mémoire a diminué d'environ 0,5 à 1 %, car nous n'utilisions plus des structures de données aussi volumineuses qu'auparavant.
Nous avons amélioré le temps de compilation d'environ 0,5 à 1% en transmettant les structures de données par référence au lambda pour éviter de les copier. Cette erreur n'avait pas été détectée lors de l'examen initial et est restée dans notre codebase pendant des années. C'est en examinant les profils dans pprof que nous avons remarqué que ces méthodes créaient et détruisaient de nombreuses structures de données, ce qui nous a amenés à les examiner et à les optimiser.
Nous avons accéléré la phase d'écriture de la sortie compilée en mettant en cache les valeurs calculées, ce qui a permis d'améliorer le temps de compilation total d'environ 1,3 à 2,8 %. Malheureusement, la comptabilité supplémentaire était trop importante et nos tests automatisés nous ont alertés de la régression de la mémoire. Plus tard, nous avons réexaminé le même code et implémenté une nouvelle version qui a non seulement résolu la régression de la mémoire, mais a également amélioré le temps de compilation d'environ 0,5 à 1,8%! Pour ce deuxième changement, nous avons dû repenser et réimaginer le fonctionnement de cette phase afin de nous débarrasser de l'une des deux structures de données.
Notre compilateur d'optimisation comporte une phase qui intègre les appels de fonction afin d'améliorer les performances. Pour choisir les méthodes à intégrer, nous utilisons à la fois des heuristiques avant d'effectuer tout calcul et des vérifications finales après avoir effectué le travail, mais juste avant de finaliser l'intégration. Si l'un d'eux détecte que l'alignement n'en vaut pas la peine (par exemple, si trop de nouvelles instructions sont ajoutées), nous n'alignons pas l'appel de méthode.
Nous avons déplacé deux vérifications de la catégorie "vérifications finales" vers la catégorie "heuristique" afin d'estimer si une intégration réussira ou non avant d'effectuer des calculs chronophages. Comme il s'agit d'une estimation, elle n'est pas parfaite, mais nous avons vérifié que nos nouvelles heuristiques couvrent 99,9% de ce qui était intégré auparavant sans affecter les performances. L'une de ces nouvelles heuristiques concernait les registres DEX nécessaires (amélioration d'environ 0,2 à 1,3 %), et l'autre le nombre d'instructions (amélioration d'environ 2 %).
Nous avons une implémentation personnalisée d'un BitVector que nous utilisons à plusieurs endroits. Nous avons remplacé la classe BitVector redimensionnable par une classe BitVectorView plus simple pour certains vecteurs de bits de taille fixe. Cela élimine certaines indirections et vérifications de plage d'exécution, et accélère la construction des objets de vecteur de bits.
De plus, la classe BitVectorView a été modélisée sur le type de stockage sous-jacent (au lieu de toujours utiliser uint32_t comme l'ancien BitVector). Cela permet à certaines opérations, par exemple Union(), de traiter deux fois plus de bits ensemble sur les plates-formes 64 bits. Les échantillons des fonctions concernées ont été réduits de plus de 1% au total lors de la compilation de l'OS Android. Cette opération a été effectuée en plusieurs modifications [1, 2, 3, 4, 5, 6].
Si nous devions parler en détail de toutes les optimisations, nous y passerions la journée ! Si vous souhaitez en savoir plus sur les optimisations, voici d'autres modifications que nous avons apportées :
- Ajout de la comptabilité pour améliorer les temps de compilation d'environ 0,6 à 1,6%.
- Calculez les données de manière différée pour éviter les cycles, si possible.
- Refactoriser notre code pour ignorer le travail de précalcul lorsqu'il n'est pas utilisé.
- Évitez certaines chaînes de chargement dépendantes lorsque l'allocateur peut être facilement obtenu à partir d'autres emplacements.
- Un autre cas d'ajout d'une vérification pour éviter un travail inutile.
- Évitez les branchements fréquents sur le type de registre (core/FP) dans l'allocateur de registres.
- Assurez-vous que certains tableaux sont initialisés au moment de la compilation. Ne comptez pas sur clang pour le faire.
- Nettoyez certaines boucles. Utilisez des boucles de plage que clang peut mieux optimiser, car il n'a pas besoin de recharger les pointeurs internes du conteneur en raison des effets secondaires de la boucle. Évitez d'appeler la fonction virtuelle "HInstruction::GetInputRecords()" dans la boucle via la fonction intégrée "InputAt(.)" pour chaque entrée.
- Évitez les fonctions Accept() pour le modèle de visiteur en exploitant une optimisation du compilateur.
Conclusion
Nos efforts pour améliorer la vitesse de compilation d'ART ont porté leurs fruits, rendant Android plus fluide et plus efficace, tout en contribuant à améliorer l'autonomie de la batterie et la température de l'appareil. En identifiant et en implémentant des optimisations avec soin, nous avons démontré qu'il est possible d'obtenir des gains substantiels en termes de temps de compilation sans compromettre l'utilisation de la mémoire ni la qualité du code.
Notre parcours a impliqué l'utilisation d'outils de profilage comme pprof, une volonté d'itérer et parfois même d'abandonner des pistes moins fructueuses. Les efforts collectifs de l'équipe ART ont non seulement réduit le temps de compilation d'un pourcentage notable, mais ont également jeté les bases de futures avancées.
Toutes ces améliorations sont disponibles dans la mise à jour Android de fin d'année 2025, et pour Android 12 et versions ultérieures via les mises à jour Mainline. Nous espérons que cette présentation détaillée de notre processus d'optimisation vous aura permis de mieux comprendre la complexité et les avantages de l'ingénierie des compilateurs.
-
 Actualités sur les produits
À mesure que le développement agentique s'accélère, l'ingénierie Android atteint une nouvelle frontière passionnante : passer de la complétion de code assistée à des agents qui s'exécutent de bout en bout sous votre direction. Vous disposez d'un choix et d'une flexibilité totaux concernant les modèles et les agents que vous utilisez.
Jason Buchel • Temps de lecture : 3 min -

 Actualités sur les produits
Aujourd'hui, nous avons expliqué comment nous faisions évoluer notre vision "plus qu'un magasin". De l'onglet "Vous", qui sert désormais d'espace personnel à plus de 250 millions d'utilisateurs actifs par mois, à notre plate-forme de jeux unifiée qui connecte plus de 700 millions de profils de joueurs, Google Play répond aux besoins des utilisateurs où qu'ils se trouvent.
Paul Feng • Temps de lecture : 3 min -
 Actualités sur les produits
Avec Googlebook, nous sommes ravis d'aider les utilisateurs à s'exprimer et à accéder à ces outils.
Cyrus Stoller • Temps de lecture : 2 min
Recevez chaque semaine les dernières informations sur le développement Android dans votre boîte de réception.