

כשפיתחנו את Android Bench, בנינו בסיס קפדני להערכת האופן שבו מודלים גדולים של שפה (LLM) עוזרים למפתחים במשימות אמיתיות ב-Android. מודלים וסוכני AI מתפתחים במהירות, ולכן אנחנו מעדכנים את המתודולוגיה שלנו. למשל, אנחנו מתאימים את מסגרת ההשוואה שלנו למסגרת Harbor. היום אנחנו משיקים את קבוצת המשימות הראשונה לטווח ארוך (LHT). אלה משימות מורכבות מאוד שמהנדס צריך להקדיש להן כמה ימים או אפילו שבוע כדי להשלים אותן. בנוסף, אנחנו משיקים הערכה באמצעות סוכן, ומתחילים עם סוכנים מספקי מודלים תואמים. התוספת הזו מביאה אותנו אל Android Bench 2.0 – שדרוג משמעותי שנועד להעריך מודלים וסוכנים של AI בהתאם לקנה המידה, לדו-משמעות ולפתרון בעיות מורכבות רב-שלביות שאתם מתמודדים איתן מדי יום.
מתיקונים מצטברים ועד למשימות לטווח ארוך
האיטרציה הראשונה של Android Bench, יחד עם מדדי ביצועים דומים מוקדמים של AI לקידוד, התמקדה בשינויים מצטברים במאגרים קיימים, ובמקרים רבים הוגבלה לתיקוני באגים או לבקשות קטנות יותר של תכונות. הסיכום הזה שיקף את היכולות של העזרה מ-AI באותו זמן, וגם את אופן השימוש שלכם בה.
כדי להמשיך לעזור לכם למצוא את המודלים ואת סוכני התכנות שהכי מתאימים לתהליך הפיתוח שלכם, העלינו את הרף של ההערכות שלנו כך שיתאימו לעבודה שאתם מעבירים ל-AI. Android Bench 2.0 משקף את האתגרים האלה עם משימות LHT שכוללות שדרוג של תלות, הוספה של תכונות חדשות, בניית אפליקציות מאפס או המרה של אפליקציה בפלטפורמות שונות ל-Android.
משימות מורכבות דורשות הערכה ודירוג מדויקים יותר
במשימות הנדסיות שנמשכות כמה ימים, ציון בינארי של עובר או נכשל לא משקף את התמונה המלאה.
לדוגמה, סוכן יכול לשכתב 40 מסכים ל-Jetpack Compose, להגדיר טבלאות של מסד נתונים ולעמוד ב-90% מהדרישות, אבל להיכשל בטענה אחת של מקרה קצה. הניקוד הבינארי מדרג את ההרצה הזו ב-0%, ומסתיר את היכולות הארכיטקטוניות של המודל. אנחנו עוברים לשיטת ניקוד רציפה כדי לספק אות משמעותי יותר, גם לפיתוח המודלים וגם להבנה שלכם לגבי האופן שבו AI יכול לעזור לכם.
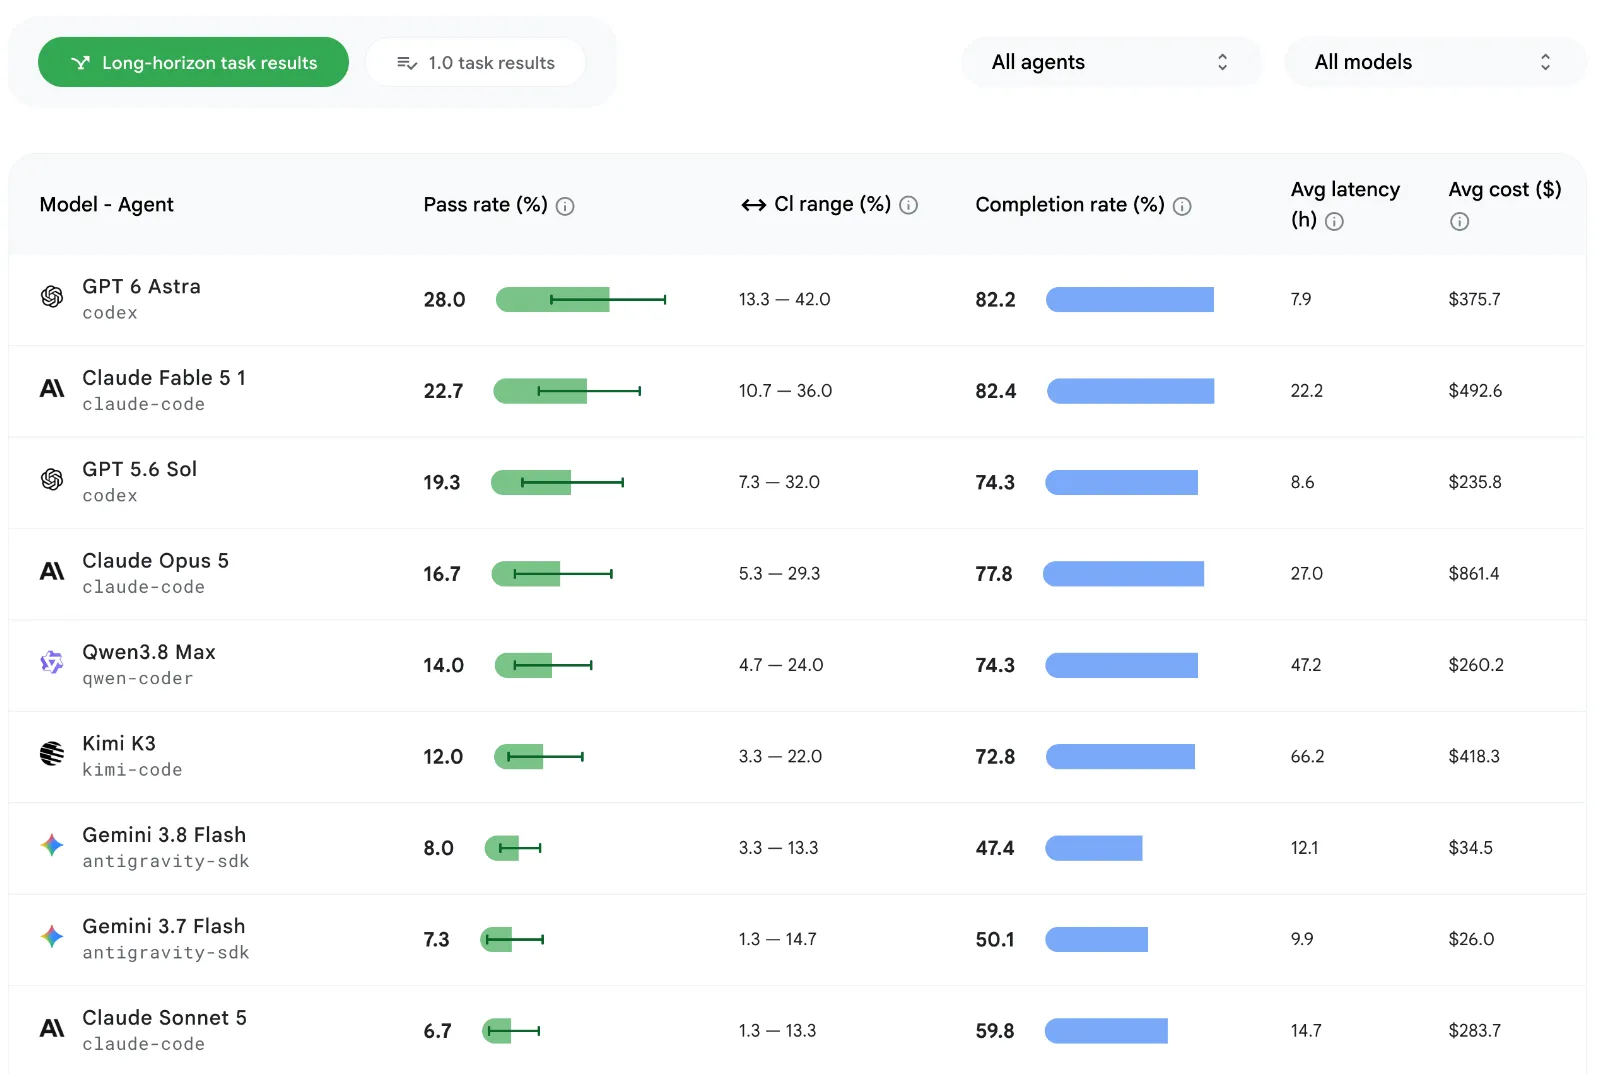
אנחנו מחשבים את שיעור ההשלמה הזה באמצעות שילוב של גורמים כמו פונקציונליות, נאמנות חזותית והימנעות מרגרסיות. אנחנו גם מטילים עונשים על סטיות מההוראות להערכה או ממגבלות מבניות. כדאי לעיין בטבלת ההשוואה המעודכנת וללחוץ על תצוגת הכרטיס של כל מודל כדי לראות רכיבים נוספים כמו שיעור ההצלחה, שיעור ההשלמה והעלויות הממוצעות לכל מודל ולכל משימה.
שיעור ההצלחה הגבוה ביותר במבחני LHT הוא כ-28%, הרבה יותר נמוך משיעור ההצלחה של כ-91% במשימות המקוריות במדד ההשוואה.

משימות לטווח ארוך מאפשרות לקבל תובנות מועילות לעזרה מ-AI
מעבר למדידת היעילות של ה-AI בטיפול במשימות ארוכות טווח, מערך הנתונים LHT עוזר לנו ללמוד יותר על החוזקות והחולשות של המודלים שנבדקו, ואנחנו מציעים לכם הדרכה מעשית יותר.
בכל רמות המודלים, ה-AI מצליח יותר בכתיבת קוד חדש מאשר בשיפור קוד קיים. העברת נתונים ושינוי מבנה הקוד הופכים למסובכים יותר כי ההצלחה תלויה במורכבות הארכיטקטונית ולא בנפח הקוד.
המודלים מציגים יכולות חזקות בטרנספורמציות מבוססות-כללים ומבוססות-דטרמיניזם, כמו המרה של Java ל-Kotlin, החלפה של Retrofit ב-Ktor או הוספה של שכבת ViewModel. הם מיישמים את הדפוסים האלה באופן עקבי, גם ב-125 קבצים ומעלה ו-8,000 שורות קוד ומעלה.
עם זאת, המודלים מתקשים כשמשימות דורשות אימות בזמן ריצה (למשל, כשחסרים גרפים של הזרקת תלות), כשמדובר בשינויים במסגרת או כשנתקלים בפערים בידע עם ספריות שלא פורסמו. היסב של אפליקציות בפלטפורמות שונות ל-Android הוא עדיין אתגר פתוח – אף מודל לא מגיע לשיעור הצלחה של 100%, ומודלים פורצי דרך מגיעים לשיעור השלמה של 80% לכל היותר.
השקה: הערכת תפקוד הסוכנים
כדי לעזור לכם להבין טוב יותר את הביצועים של המודלים כשהם משולבים בתהליכי עבודה מבוססי-סוכנים, אנחנו מוסיפים להערכה שלנו סוכנים הכי רווחיים. אנחנו מתחילים בהרצת מודלים חדשים מול LHT עם סוכנים מספק המודל המתאים. לדוגמה, הפעלנו את GPT 5.6 Sol ב-Codex ואת Gemini 3.8 Flash ב-Google Antigravity. השילוב הזה מראה איך עיצוב של ממשק משפיע באופן חיובי על התוצאות של מפתחים, כי ראינו שמטמון של הנחיות וחלונות כלים קומפקטיים יכולים להוביל להפחתה בשימוש בטוקנים.
בעתיד נרחיב את התכונה הזו ונספק גם הדגשה של תוצאות בשילובים שונים של מודלים וסוכנים, כדי לעזור לכם לגלות אילו שילובים מתאימים לכם ולצוות שלכם בצורה הטובה ביותר.
אנחנו משקיעים במדידה הזו כי חשוב לכם להשתמש בסוכן ובמודל שתבחרו לפיתוח ל-Android, ובשבועות הקרובים נשתף אתכם במידע נוסף.
הוספנו מודלים חדשים
בנוסף, אנחנו ממשיכים להרחיב את טבלת ההשוואה כדי לוודא שיש לכם את הנתונים העדכניים ביותר שיעזרו לכם לקבל החלטות לגבי הפיתוח. הוספנו את Gemini 3.8 Flash, Gemini 3.7 Flash, GPT-6 של OpenAI, Fable 5.1 של Anthropic, Kimi K3 ו-Qwen 3.8 Max, כאשר GPT-6 Astra של OpenAI מוביל עם שיעור הצלחה של 28%.
במבט קדימה
Android Bench 2.0 מספק סביבה חזקה למדידת AI לצורך פיתוח ל-Android. אנחנו מקווים ששילוב של משימות ארוכות טווח, הערכה מולטי-מודאלית, סוכנים ודירוג רציף יעזור לצוותי מחקר בתחום ה-AI ליצור שותפים אמינים ובעלי יכולות גבוהות יותר בתחום ה-AI, וגם לספק לכם שקיפות רבה יותר לגבי האפשרויות שלכם לפיתוח AI.
מומלץ לעיין בטבלת ההייפ המעודכנת ובמתודולוגיה המעודכנת. המשוב שלכם משפיע ישירות על האופן שבו אנחנו מפתחים את Android Bench, ולכן נשמח שתמשיכו לשתף איתנו משוב ב-GitHub ובערוצים שלנו ברשתות החברתיות, כמו X ו-LinkedIn.
-

 חדשות על מוצרים
בחודש מרץ, השקנו את Android Bench – טבלת ההשוואה של מודלים גדולים של שפה (LLM) למשימות פיתוח אמיתיות ל-Android. מאז, שיפרנו את ההשוואה לשוק על סמך המשוב שלכם, כולל הערכה של מודלים עם משקלים פתוחים והוספה של מדדי עלות ויעילות לטבלת ההשוואה.
Zoe Lopez-Latorre • משך הקריאה: 3 דקות -

 חדשות על מוצרים
היום אנחנו משיקים את Android 17 ומאפשרים להשתמש בו ברוב מכשירי Pixel הנתמכים. בחודשים הקרובים יושקו מכשירים חדשים עם Android 17.
Matthew McCullough • 13 min read -
 חדשות על מוצרים
ב-Google I/O 26, נציג 17 הכרזות חשובות למפתחי Android, שיתמקדו בפרודוקטיביות מבוססת-סוכנים, ב-Compose First כסטנדרט ממשק המשתמש שלנו, ובפיתוח מדיה בעלת ביצועים גבוהים ופיתוח אדפטיבי עבור המערכת האקולוגית המתפתחת.
Matthew McCullough • משך הקריאה: 8 דקות
רוצים לקבל טיפים עדכניים לפיתוח Android ישירות לאימייל כל שבוע?
