

Android Bench 2.0: Herausfordernde Aufgaben mit langem Horizont
Lesezeit: 3 Minuten

Als wir Android Bench zum ersten Mal auf den Markt brachten, haben wir eine solide Grundlage für die Bewertung geschaffen, wie Large Language Models (LLMs) Entwickler bei realen Android-Aufgaben unterstützen. Da sich KI-Modelle und ‑Agents schnell weiterentwickeln, haben wir unsere Methodik aktualisiert und unser Benchmark-Framework an das Harbor-Framework angepasst. Heute veröffentlichen wir die ersten Aufgaben mit langem Zeithorizont (Long-Horizon Tasks, LHT). Das sind Aufgaben von großer Komplexität, für die ein Entwickler mehrere Tage oder sogar eine Woche benötigt. Außerdem führen wir die agentische Bewertung ein, beginnend mit Agents von entsprechenden Modellanbietern. Mit dieser Ergänzung sind wir bei Android Bench 2.0 angekommen – einem wichtigen Upgrade, das darauf ausgelegt ist, KI-Modelle und ‑Agents anhand der Skalierung, Mehrdeutigkeit und komplexen mehrstufigen Problemlösung zu bewerten, mit denen Sie sich täglich auseinandersetzen.

Von inkrementellen Korrekturen bis hin zu langfristigen Aufgaben
Die erste Version von Android Bench und ähnliche frühe Benchmarks für KI-Programmierung konzentrierten sich auf inkrementelle Änderungen an vorhandenen Repositories, die in vielen Fällen auf Fehlerkorrekturen oder kleinere Funktionsanfragen beschränkt waren. Das lag an den damaligen Möglichkeiten der KI-Unterstützung und daran, wie Sie sie genutzt haben.
Damit wir Ihnen weiterhin helfen können, die Modelle und Coding-Agents zu finden, die am besten zu Ihrem Entwicklungs-Workflow passen, haben wir die Messlatte für unsere Bewertungen höher gelegt, um der Arbeit gerecht zu werden, die Sie an KI delegieren. Android Bench 2.0 spiegelt diese anspruchsvollen Herausforderungen mit LHTs wider, die das Aktualisieren von Abhängigkeiten, das Hinzufügen neuer Funktionen, das Erstellen von Apps von Grund auf oder das Konvertieren einer plattformübergreifenden App in eine Android-App umfassen.
Komplexe Aufgaben erfordern eine differenziertere Bewertung und Punktvergabe
Bei mehrtägigen Engineering-Aufgaben wird durch die binäre Bewertung „Bestanden“ oder „Nicht bestanden“ nicht das vollständige Bild erfasst.
Ein Agent kann beispielsweise 40 Bildschirme in Jetpack Compose umgestalten, Datenbanktabellen einrichten und 90% der Anforderungen erfüllen, aber bei einer einzelnen Edge-Case-Assertion scheitern. Bei der binären Bewertung wird dieser Lauf mit 0 % bewertet, wodurch die architektonischen Fähigkeiten des Modells nicht sichtbar werden. Wir stellen auf kontinuierliche Bewertungen um, um sowohl für die Modellentwicklung als auch für Ihr Verständnis davon, wie KI Ihnen helfen kann, ein aussagekräftigeres Signal zu liefern.
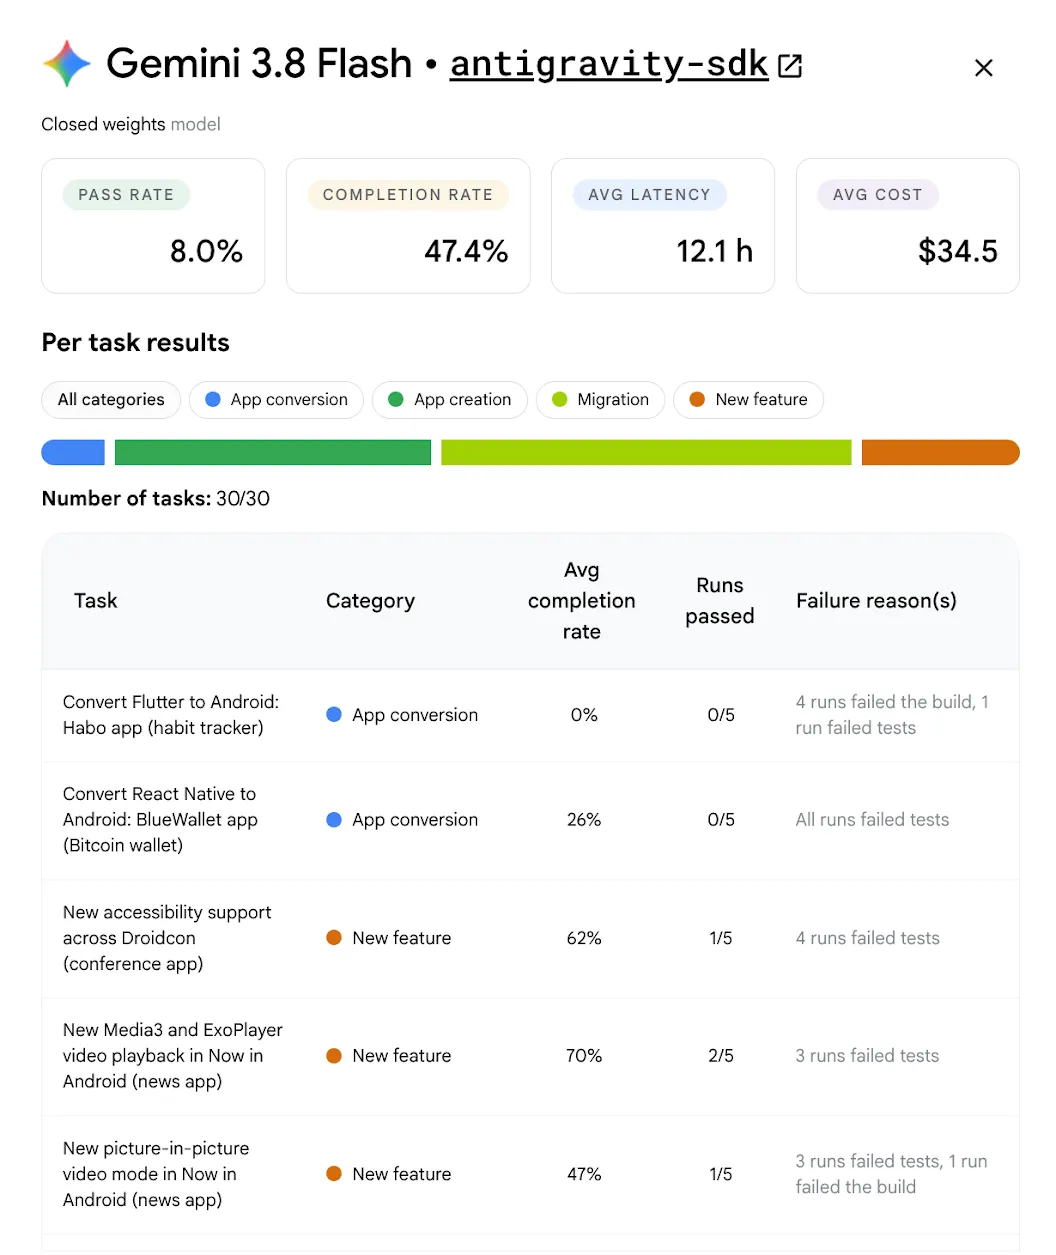
Wir berechnen diese Abschlussrate anhand einer Kombination von Faktoren wie Funktionalität, visueller Qualität und Vermeidung von Regressionen. Außerdem werden objektive Punktabzüge für Abweichungen von den Bewertungsanweisungen oder strukturellen Einschränkungen vorgenommen. Sehen Sie sich die aktualisierte Bestenliste an und klicken Sie auf die Kartenansicht der einzelnen Modelle, um zusätzliche Elemente wie die Erfolgsrate, die Abschlussrate und die durchschnittlichen Kosten pro Modell und pro Aufgabe zu sehen.
Die höchste Bestehensrate für LHTs liegt bei etwa 28% und damit deutlich niedriger als die etwa 91% für die ursprünglichen Aufgaben im Benchmark.
Langfristige Aufgaben liefern hilfreiche Informationen für die KI-Unterstützung
Das LHT-Dataset hilft uns nicht nur, zu messen, wie gut KI mit langwierigen Aufgaben umgeht, sondern auch, mehr über die Stärken und Schwächen der getesteten Modelle zu erfahren. So können wir Ihnen praktischere Anleitungen geben.
Unabhängig von der Modellstufe ist KI besser darin, neuen Code zu schreiben, als vorhandenen Code umzugestalten. Refaktorierungen und Migrationen werden schwieriger, da der Erfolg von der architektonischen Komplexität und nicht vom Codevolumen abhängt.
Die Modelle zeigen eine hohe Leistungsfähigkeit bei etablierten, deterministischen Transformationen, z. B. bei der Konvertierung von Java zu Kotlin, dem Ersetzen von Retrofit durch Ktor oder der Einführung einer ViewModel-Ebene. Sie wenden diese Muster konsistent an, auch bei mehr als 125 Dateien und 8.000 Codezeilen.
Modelle haben jedoch Schwierigkeiten, wenn für Aufgaben eine Laufzeitvalidierung erforderlich ist (z. B. fehlende Dependency Injection-Diagramme), wenn Framework-Änderungen vorgenommen werden oder wenn Wissenslücken bei nicht veröffentlichten Bibliotheken auftreten. Die Portierung von plattformübergreifenden Apps auf Android ist weiterhin eine offene Herausforderung. Kein Modell erreicht eine Erfolgsrate von 100% und die leistungsstärksten Modelle erreichen höchstens eine Abschlussrate von 80 %.
Bewertung von KI-Agenten
Damit Sie besser nachvollziehen können, wie sich Modelle verhalten, wenn sie in Ihre Agent-Workflows eingebunden werden, fügen wir unserer Bewertung häufig verwendete Agents hinzu. Zuerst werden neue Modelle mit LHTs mit Kundenservicemitarbeitern des entsprechenden Modellanbieters verglichen. So haben wir beispielsweise GPT 5.6 Sol auf Codex und Gemini 3.8 Flash auf Google Antigravity ausgeführt. Dieses Beispiel zeigt, wie sich das Design von Harness positiv auf die Ergebnisse von Entwicklern auswirkt. Wir haben gesehen, dass das Zwischenspeichern von Prompts und die kompakte Tool-Fensterung zu einer Reduzierung der Tokens führen können.
Wir werden diese Funktion in Zukunft erweitern und auch Ergebnisse für verschiedene Modell- und Agentenkombinationen hervorheben, damit Sie herausfinden können, welche Kombinationen für Sie und Ihr Team am besten geeignet sind.
Wir investieren in diese Messung, weil es wichtig ist, dass Sie den Agenten und das Modell Ihrer Wahl für die Android-Entwicklung verwenden können. In den kommenden Wochen werden wir weitere Informationen dazu veröffentlichen.
Neue Modelle hinzugefügt
Außerdem erweitern wir unsere Bestenliste kontinuierlich, damit Sie immer die aktuellsten Daten für Ihre Entwicklungsentscheidungen haben. Wir haben Gemini 3.8 Flash, Gemini 3.7 Flash, GPT-6 von OpenAI, Fable 5.1 von Anthropic, Kimi K3 und Qwen 3.8 Max hinzugefügt. GPT-6 Astra von OpenAI liegt mit einer Bestehensrate von 28% an der Spitze.
Zukunftspläne
Android Bench 2.0 bietet eine robuste Umgebung zum Messen von KI für die Android-Entwicklung. Durch die Kombination von Aufgaben mit langem Horizont, multimodaler Bewertung, Agents und kontinuierlicher Bewertung möchten wir KI-Forschungsteams in die Lage versetzen, leistungsfähigere und zuverlässigere KI-Coding-Partner zu entwickeln. Außerdem möchten wir Ihnen mehr Transparenz bei Ihren Optionen für die KI-Entwicklung bieten.
Aktualisierte Bestenliste und aktualisierte Methodik Ihr Feedback hat direkten Einfluss darauf, wie wir Android Bench weiterentwickeln. Teilen Sie uns Ihr Feedback daher bitte weiterhin auf GitHub sowie über unsere sozialen Kanäle wie X und LinkedIn mit.
-

 Produktneuheiten
Im März haben wir Android Bench eingeführt, unsere LLM-Bestenliste für reale Android-Entwicklungsaufgaben. Seitdem haben wir den Benchmark auf Grundlage Ihres Feedbacks weiterentwickelt. Dazu gehört die Bewertung von Open-Weight-Modellen und das Hinzufügen von Kosten- und Effizienzdimensionen zur Bestenliste.
Zoe Lopez-Latorre • Lesezeit: 3 Minuten -
 Produktneuheiten
Heute veröffentlichen wir Android 17 und stellen es auf den meisten unterstützten Pixel-Geräten zur Verfügung. In den kommenden Monaten werden neue Geräte mit Android 17 auf den Markt kommen.
Matthew McCullough • Lesezeit: 13 Minuten -
 Produktneuheiten
Auf der Google I/O 2026 wurden 17 wichtige Neuerungen für Android-Entwickler angekündigt, die sich auf agentengesteuerte Produktivität, Compose First als UI-Standard sowie leistungsstarke Medien und adaptive Entwicklung für das wachsende Ökosystem konzentrieren.
Matthew McCullough • Lesezeit: 8 Minuten
Lassen Sie sich Woche für Woche die neuesten Informationen zur Android-Entwicklung zusenden.
